SAM 2: Segment Anything Model 2

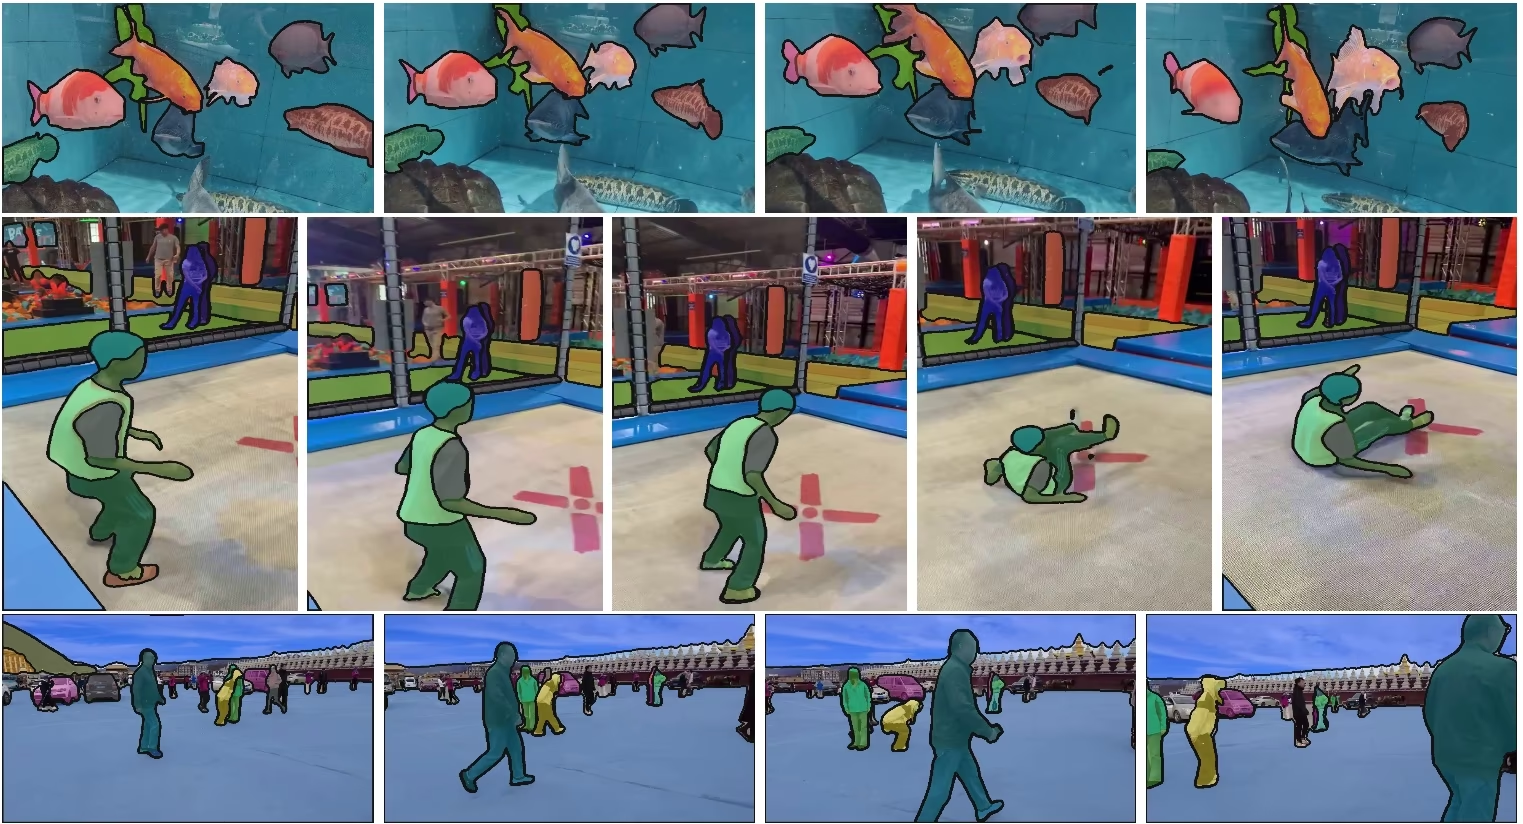
SAM 2, sucesor del Modelo Segment Anything (SAM) de Meta, es un modelo unificado para segmentar objetos mediante indicaciones tanto en imágenes como en vídeos. Su arquitectura única con indicaciones admite el procesamiento en tiempo real y la generalización sin ejemplos.
Los modelos SAM 2.1 impulsan la función de anotación inteligente de la plataforma Ultralytics, que permite segmentar mediante clics para etiquetar conjuntos de datos rápidamente. Consulta la guía de anotación para obtener más información.
Características principales#
Ver: Cómo ejecutar inferencias con SAM2 de Meta usando Ultralytics | Guía paso a paso
Arquitectura de modelo unificada#
SAM 2 combina las capacidades de segmentación de imágenes y vídeos en un único modelo. Esta unificación simplifica la implementación y permite mantener un rendimiento uniforme en distintos tipos de contenido. Utiliza una interfaz flexible basada en indicaciones, que permite especificar los objetos de interés mediante distintos tipos de indicaciones, como puntos, cajas delimitadoras o máscaras.
Rendimiento en tiempo real#
El modelo alcanza velocidades de inferencia en tiempo real y procesa aproximadamente 44 fotogramas por segundo. Esto hace que SAM 2 sea adecuado para aplicaciones que requieren una respuesta inmediata, como la edición de vídeo y la realidad aumentada.
Generalización sin ejemplos#
SAM 2 puede segmentar objetos que nunca ha encontrado, lo que demuestra una gran capacidad de generalización sin ejemplos. Esto resulta especialmente útil en dominios visuales diversos o cambiantes, donde las categorías predefinidas pueden no abarcar todos los objetos posibles.
Refinamiento interactivo#
Los usuarios pueden perfeccionar iterativamente los resultados de segmentación proporcionando indicaciones adicionales, lo que permite controlar con precisión el resultado. Esta interactividad es esencial para mejorar los resultados en aplicaciones como la anotación de vídeo o el diagnóstico por imagen.
Gestión avanzada de los retos visuales#
SAM 2 incluye mecanismos para gestionar problemas habituales de la segmentación de vídeo, como la oclusión y reaparición de objetos. Utiliza un mecanismo de memoria para seguir los objetos entre fotogramas y garantizar la continuidad, incluso cuando los objetos quedan ocultos temporalmente o salen y vuelven a entrar en escena.
Para comprender mejor la arquitectura y las capacidades de SAM 2, consulta el artículo de investigación de SAM 2.
Rendimiento y detalles técnicos#
Según Meta, SAM 2 supera a los modelos anteriores en varias métricas:
| Métrica | SAM 2 | Mejor resultado anterior |
|---|---|---|
| Segmentación interactiva de vídeo | El mejor | - |
| Interacciones humanas necesarias | 3 veces menos | Referencia |
| Precisión de la segmentación de imágenes | Mejorada | SAM |
| Velocidad de inferencia | 6 veces más rápido | SAM |
Arquitectura del modelo#
Componentes principales#
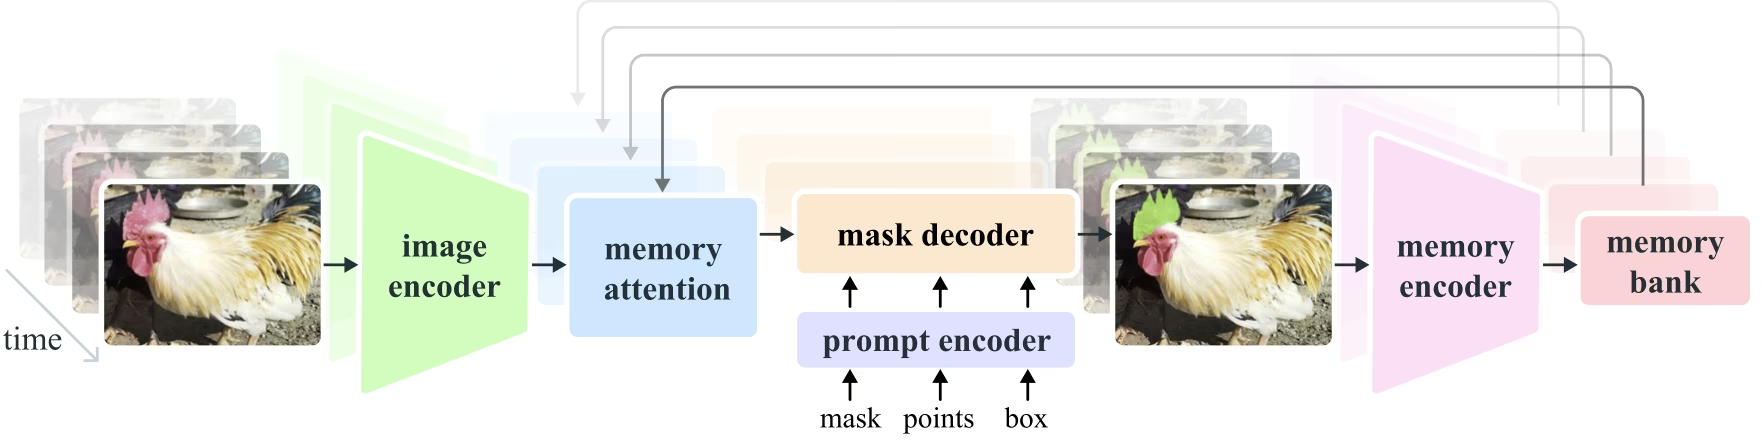
- Codificador de imágenes y vídeo: utiliza una arquitectura basada en Transformer para extraer características de alto nivel tanto de imágenes como de fotogramas de vídeo. Este componente se encarga de comprender el contenido visual en cada instante.
- Codificador de indicaciones: procesa las indicaciones que proporciona el usuario (puntos, cuadros y máscaras) para orientar la tarea de segmentación. Esto permite que SAM 2 se adapte a las entradas del usuario y se centre en objetos específicos de una escena.
- Mecanismo de memoria: Incluye un codificador de memoria, un banco de memoria y un módulo de atención de memoria. En conjunto, estos componentes almacenan y aprovechan la información de fotogramas anteriores, lo que permite al modelo mantener un seguimiento de objetos coherente a lo largo del tiempo.
- Decodificador de máscaras: genera las máscaras de segmentación finales a partir de las características de imagen codificadas y de las indicaciones. En vídeo, también utiliza el contexto de memoria para garantizar un seguimiento preciso entre fotogramas.
Mecanismo de memoria y gestión de oclusiones#
El mecanismo de memoria permite que SAM 2 gestione las dependencias temporales y las oclusiones en los datos de vídeo. A medida que los objetos se mueven e interactúan, SAM 2 registra sus características en un banco de memoria. Cuando un objeto queda ocluido, el modelo puede recurrir a esta memoria para predecir su posición y apariencia cuando reaparezca. El cabezal de oclusión gestiona específicamente las situaciones en las que los objetos no están visibles y predice la probabilidad de que un objeto esté ocluido.
Resolución de la ambigüedad con varias máscaras#
En situaciones ambiguas (p. ej., con objetos superpuestos), SAM 2 puede generar varias predicciones de máscaras. Esto ayuda a representar escenas complejas en las que una sola máscara podría no captar el objeto deseado.
Conjunto de datos SA-V#
El conjunto de datos SA-V, desarrollado para entrenar SAM 2, es uno de los conjuntos de datos de segmentación de vídeo más grandes y diversos disponibles. Incluye:
- Más de 51 000 vídeos: capturados en 47 países, ofrecen una amplia variedad de situaciones del mundo real.
- Más de 600 000 anotaciones de máscaras: anotaciones espaciotemporales detalladas de máscaras, denominadas «masklets», que abarcan objetos completos y partes de estos.
- Tamaño del conjunto de datos: Incluye 4,5 veces más vídeos y 53 veces más anotaciones que los conjuntos de datos de segmentación de vídeo más grandes anteriores.
Pruebas de rendimiento#
Segmentación de objetos en vídeo#
SAM 2 obtiene los siguientes resultados en las principales pruebas de referencia de segmentación de vídeo:
| Conjunto de datos | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
Segmentación interactiva#
En tareas de segmentación interactiva, SAM 2 obtiene los siguientes resultados:
| Conjunto de datos | NoC@90 | AUC |
|---|---|---|
| DAVIS interactivo | 1.54 | 0.872 |
Instalación#
SAM 2 está incluido en el paquete ultralytics. Instálalo con el siguiente comando; los pesos de SAM 2 se descargan automáticamente la primera vez que se usa.
pip install ultralyticsCómo usar SAM 2: versatilidad en la segmentación de imágenes y vídeo#
La siguiente tabla detalla los modelos SAM 2 disponibles, sus pesos preentrenados, las tareas admitidas y la compatibilidad con distintos modos de funcionamiento, como entrenamiento, validación, inferencia y exportación.
| Tipo de modelo | Pesos preentrenados | Tareas compatibles | Entrenamiento | Validación | Inferencia | Exportar |
|---|---|---|---|---|---|---|
| SAM 2 pequeño | sam2_t.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
| SAM 2 pequeño | sam2_s.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
| SAM 2 base | sam2_b.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
| SAM 2 grande | sam2_l.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 pequeño | sam2.1_t.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 pequeño | sam2.1_s.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 base | sam2.1_b.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 grande | sam2.1_l.pt | Segmentación de instancias | ❌ | ❌ | ✅ | ❌ |
Ejemplos de predicción de SAM 2#
SAM 2 puede utilizarse en una amplia variedad de tareas, como la edición de vídeo en tiempo real, el diagnóstico por imagen y los sistemas autónomos. Su capacidad para segmentar datos visuales tanto estáticos como dinámicos lo convierte en una herramienta versátil para investigadores y desarrolladores.
Segmentar con indicaciones#
Utiliza indicaciones para segmentar objetos específicos en imágenes o vídeos.
from ultralytics import SAM

# Cargar un modelo
model = SAM("sam2.1_b.pt")

# Mostrar información del modelo (opcional)
model.info()

# Ejecutar inferencia con una indicación de cuadros delimitadores
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Ejecutar inferencia con un único punto
results = model(points=[900, 370], labels=[1])

# Ejecutar inferencia con varios puntos
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])

# Ejecutar inferencia con una indicación de varios puntos por objeto
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Ejecutar inferencia con una indicación de puntos negativos
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Segmentar todo#
Segmenta todo el contenido de la imagen o el vídeo sin indicaciones específicas.
from ultralytics import SAM

# Cargar un modelo
model = SAM("sam2.1_b.pt")

# Mostrar información del modelo (opcional)
model.info()

# Ejecutar inferencia
model("path/to/video.mp4")- Este ejemplo muestra cómo puede utilizarse SAM 2 para segmentar todo el contenido de una imagen o un vídeo si no se proporcionan indicaciones (cuadros delimitadores, puntos o máscaras).
Segmentar vídeo y realizar un seguimiento de objetos#
Segmenta todo el contenido del vídeo con indicaciones específicas y realiza un seguimiento de los objetos.
from ultralytics.models.sam import SAM2VideoPredictor

# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)

# Ejecutar inferencia con un único punto
results = predictor(source="test.mp4", points=[920, 470], labels=[1])

# Ejecutar inferencia con varios puntos
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])

# Ejecutar inferencia con una indicación de varios puntos por objeto
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])

# Ejecutar inferencia con una indicación de puntos negativos
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])
Segmentación interactiva dinámica y seguimiento#
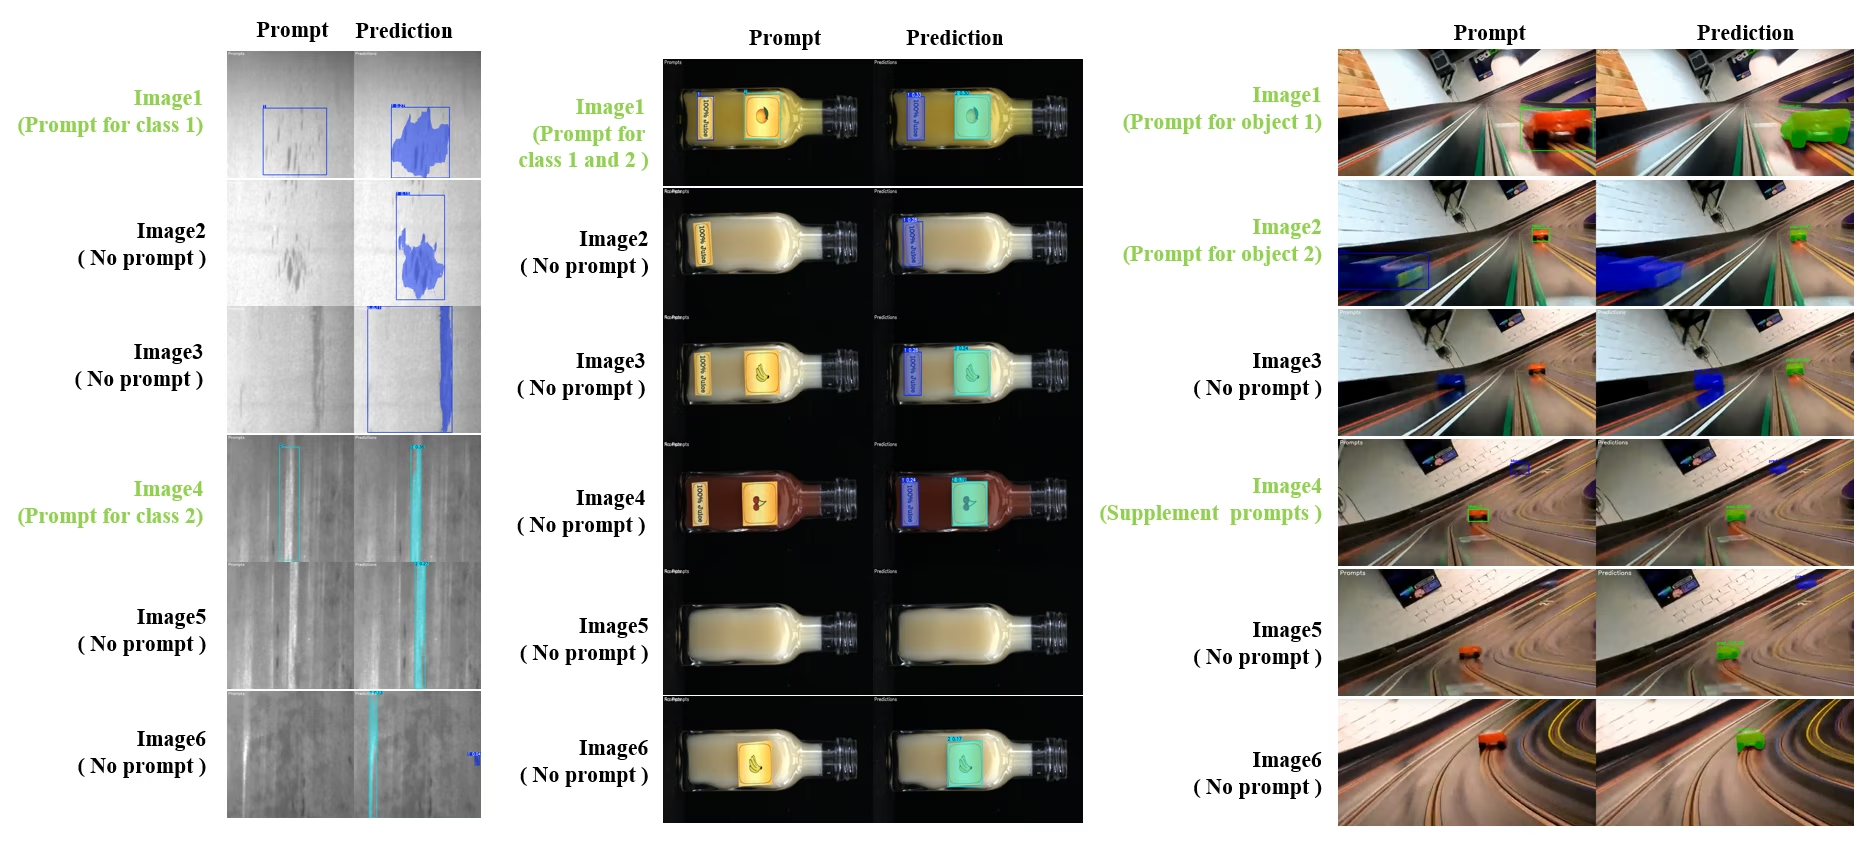
SAM2DynamicInteractivePredictor es una extensión de SAM 2 que no requiere entrenamiento y permite la interacción dinámica con varios fotogramas y capacidades de aprendizaje continuo. Este predictor admite actualizaciones de indicaciones en tiempo real y gestión de memoria para mejorar el rendimiento del seguimiento a lo largo de una secuencia de imágenes. En comparación con el SAM 2 original, SAM2DynamicInteractivePredictor reconstruye el flujo de inferencia para aprovechar al máximo los modelos SAM 2 preentrenados sin necesidad de entrenamiento adicional.
Características principales#
Ofrece tres mejoras:
- Interacción dinámica: Añade indicaciones para instancias nuevas que no se estén siguiendo en fotogramas posteriores, en cualquier momento durante el procesamiento del vídeo
- Aprendizaje continuo: añade indicaciones para las instancias existentes y mejora el rendimiento del modelo con el tiempo.
- Compatibilidad con varias imágenes independientes: procesa varias imágenes independientes (que no tienen por qué proceder de una secuencia de vídeo) compartiendo la memoria y realizando un seguimiento de objetos entre imágenes.
Funciones principales#
- Flexibilidad de las indicaciones: admite cuadros delimitadores, puntos y máscaras como indicaciones.
- Gestión del banco de memoria: mantiene un banco de memoria dinámico para almacenar los estados de los objetos entre fotogramas.
- Seguimiento de varios objetos: permite realizar el seguimiento simultáneo de varios objetos con identificadores individuales.
- Actualizaciones en tiempo real: permite añadir nuevas indicaciones durante la inferencia sin volver a procesar los fotogramas anteriores.
- Procesamiento de imágenes independientes: procesa imágenes independientes con un contexto de memoria compartido para mantener la coherencia de los objetos entre imágenes.
from ultralytics.models.sam import SAM2DynamicInteractivePredictor

# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)

# Definir una categoría mediante una indicación de cuadro delimitador
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)

# Detectar este objeto concreto en una imagen nueva
results = predictor(source="image2.jpg")

# Añadir una categoría nueva con un ID de objeto nuevo
results = predictor(
    source="image4.jpg",
    bboxes=[[300, 300, 400, 400]],  # Objeto nuevo
    obj_ids=[1],  # ID de objeto nuevo
    update_memory=True,  # Añadir a la memoria
)
# Realizar inferencia
results = predictor(source="image5.jpg")

# Añade prompts de refinamiento a la misma categoría para mejorar el rendimiento
# Esto resulta útil cuando la apariencia de los objetos cambia significativamente
results = predictor(
    source="image6.jpg",
    points=[[150, 150]],  # Punto de refinamiento
    labels=[1],  # Punto positivo
    obj_ids=[1],  # Mismo ID de objeto
    update_memory=True,  # Actualizar la memoria con información nueva
)
# Realizar inferencia sobre una imagen nueva
results = predictor(source="image7.jpg")SAM2DynamicInteractivePredictor está diseñado para funcionar con modelos SAM 2 y admite añadir y refinar categorías con todos los prompts de caja, punto y máscara que SAM 2 admite de forma nativa. Resulta especialmente útil en situaciones en las que los objetos aparecen o cambian con el tiempo, como la anotación de vídeo o las tareas de edición interactiva.
Argumentos#
| Nombre | Valor predeterminado | Tipo de datos | Descripción |
|---|---|---|---|
max_obj_num | 3 | int | Número máximo de categorías preestablecido |
update_memory | False | bool | Indica si se debe actualizar la memoria con prompts nuevos |
obj_ids | None | List[int] | Lista de ID de objeto correspondientes a los prompts |
Casos de uso#
SAM2DynamicInteractivePredictor es ideal para:
- Flujos de trabajo de anotación de vídeo en los que aparecen objetos nuevos durante la secuencia
- Edición interactiva de vídeo que requiere añadir y refinar objetos en tiempo real
- Aplicaciones de vigilancia que necesitan un seguimiento dinámico de objetos
- Diagnóstico por imagen para seguir estructuras anatómicas a lo largo de series temporales
- Sistemas autónomos que requieren detección y seguimiento adaptativos de objetos
- Conjuntos de datos con varias imágenes para segmentar objetos de forma coherente en imágenes independientes
- Análisis de colecciones de imágenes en el que es necesario seguir objetos en distintas escenas
- Segmentación entre dominios que aprovecha la memoria de diversos contextos de imagen
- Anotación semiautomática para crear conjuntos de datos de forma eficiente con una intervención manual mínima
Comparación de SAM frente a YOLO#
Aquí comparamos los modelos SAM 2 de Meta, incluida la variante SAM2-t más pequeña, con los modelos de segmentación de Ultralytics, incluido YOLO26:
| Modelo | Tamaño (MB) | Parámetros (M) | Velocidad (CPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s con backbone YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (11.0x más pequeño) | 3.4 (11.4x menos) | 24.8 (945x más rápido) |
| Ultralytics YOLO11n-seg | 6.2 (12.6x más pequeño) | 2.9 (13.4x menos) | 24.3 (964x más rápido) |
| Ultralytics YOLO26n-seg | 6.7 (11.7x más pequeño) | 2.7 (14.4x menos) | 25.2 (930x más rápido) |
Esta comparación muestra las diferencias considerables de tamaño y velocidad entre las variantes de SAM y los modelos de segmentación YOLO. Aunque SAM ofrece capacidades únicas de segmentación automática, los modelos YOLO, en particular YOLOv8n-seg, YOLO11n-seg y YOLO26n-seg, son mucho más pequeños, rápidos y eficientes desde el punto de vista computacional.
Las velocidades de SAM se han medido con PyTorch y las de YOLO, con ONNX Runtime. Las pruebas se han realizado en un Apple M4 Air de 2025 con 16 GB de RAM usando torch==2.10.0, ultralytics==8.4.31 y onnxruntime==1.24.4. Para reproducir esta prueba:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Perfilar SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Perfilar FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Perfilar modelos YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Cabezal sin NMS de YOLO26; no hace nada con YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Anotación automática: creación eficiente de conjuntos de datos#
La anotación automática combina SAM 2 con un modelo de detección preentrenado para generar rápidamente conjuntos de datos de segmentación, sin necesidad de etiquetar manualmente de forma exhaustiva. Ultralytics Platform también ofrece anotación automática en el navegador con modelos de visión alojados; compara su precisión de detección, coste y velocidad en la clasificación de modelos VLM.
Cómo anotar automáticamente con SAM 2#
Ver: Anotación automática con Segment Anything 2 de Meta mediante Ultralytics | Etiquetado de datos
Para anotar automáticamente tu conjunto de datos con un detector YOLO26x y SAM 2, sigue este ejemplo:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
data | str | obligatorio | Ruta al directorio que contiene las imágenes de destino que se van a anotar o segmentar. |
det_model | str | 'yolo26x.pt' | Ruta al modelo de detección YOLO para la detección inicial de objetos. |
sam_model | str | 'sam_b.pt' | Ruta al modelo SAM para la segmentación (admite los pesos de SAM, SAM 2, MobileSAM y SAM 3). |
device | str | '' | Dispositivo de cálculo (p. ej., 'cuda:0', 'cpu' o '' para detectar automáticamente el dispositivo). |
conf | float | 0.25 | Umbral de confianza de detección YOLO para filtrar las detecciones poco fiables. |
iou | float | 0.5 | Umbral de IoU para la supresión no máxima (NMS) y el filtrado de cajas superpuestas. |
imgsz | int | 640 | Tamaño de entrada para cambiar el tamaño de las imágenes (se redondea al múltiplo de 32 más cercano por exceso si es necesario). |
max_det | int | 300 | Número máximo de detecciones por imagen para optimizar el uso de memoria. |
classes | list[int] | None | Lista de índices de clase que se van a detectar (p. ej., [0, 1] para persona y bicicleta). |
output_dir | str | None | Directorio donde se guardan las anotaciones (por defecto: directorio hermano de <data>_auto_annotate_labels). |
Esta función convierte una carpeta de imágenes sin etiquetar en un conjunto de datos de segmentación con un esfuerzo manual mínimo.
Limitaciones#
A pesar de sus puntos fuertes, SAM 2 tiene ciertas limitaciones:
- Estabilidad del seguimiento: SAM 2 puede perder el rastro de los objetos durante secuencias largas o ante cambios importantes del punto de vista.
- Confusión entre objetos: A veces, el modelo puede confundir objetos de aspecto similar, especialmente en escenas concurridas.
- Eficiencia con varios objetos: La eficiencia de la segmentación disminuye al procesar varios objetos a la vez debido a la falta de comunicación entre ellos.
- Precisión de los detalles de precisión: Puede pasar por alto detalles pequeños, sobre todo con objetos que se mueven rápido. Los prompts adicionales pueden ayudar a resolver parcialmente este problema, pero no se garantiza la suavidad temporal.
Citas y agradecimientos#
Si utilizas SAM 2 en tu trabajo de investigación o desarrollo, cita el modelo con la siguiente referencia:
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
Agradecemos a Meta AI que haya publicado este modelo y este conjunto de datos para la comunidad de IA.
Preguntas frecuentes#
SAM 2, sucesor del Segment Anything Model (SAM) de Meta, es un modelo unificado que admite indicaciones y permite segmentar objetos tanto en imágenes como en vídeos. SAM 2 ofrece varias mejoras respecto al SAM original, entre ellas:
- Arquitectura de modelo unificada: Combina las capacidades de segmentación de imágenes y vídeos en un solo modelo.
- Rendimiento en tiempo real: Procesa aproximadamente 44 fotogramas por segundo, por lo que resulta adecuado para aplicaciones que requieren respuesta inmediata.
- Generalización de cero disparos: Segmenta objetos que nunca ha encontrado, algo útil en diversos dominios visuales.
- Refinamiento interactivo: Permite refinar los resultados de segmentación de forma iterativa mediante prompts adicionales.
- Gestión avanzada de desafíos visuales: Gestiona desafíos habituales de la segmentación de vídeo, como la oclusión y la reaparición de objetos.
Para obtener más información sobre la arquitectura y las capacidades de SAM 2, consulta el artículo de investigación de SAM 2.
SAM 2 permite segmentar vídeos en tiempo real mediante su interfaz que admite indicaciones y su rápida inferencia. Aquí tienes un ejemplo básico:
Segmentar con indicacionesUtiliza indicaciones para segmentar objetos específicos en imágenes o vídeos.
from ultralytics import SAM

# Cargar un modelo
model = SAM("sam2_b.pt")

# Mostrar información del modelo (opcional)
model.info()

# Segmentar con un prompt de caja delimitadora
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Segmentar con un prompt de punto
results = model("path/to/image.jpg", points=[150, 150], labels=[1])
Para obtener instrucciones más completas, consulta la sección Cómo usar SAM 2.
SAM 2 se entrena con el conjunto de datos SA-V, uno de los conjuntos de datos de segmentación de vídeo más grandes y diversos disponibles. El conjunto de datos SA-V incluye:
- Más de 51 000 vídeos: capturados en 47 países, ofrecen una amplia variedad de situaciones del mundo real.
- Más de 600 000 anotaciones de máscaras: anotaciones espaciotemporales detalladas de máscaras, denominadas «masklets», que abarcan objetos completos y partes de estos.
- Escala del conjunto de datos: Incluye 4.5 veces más vídeos y 53 veces más anotaciones que los conjuntos de datos más grandes anteriores, lo que ofrece una diversidad y complejidad sin precedentes.
Este conjunto de datos permite a SAM 2 lograr resultados sólidos en los principales benchmarks de segmentación de vídeo y mejora sus capacidades de generalización de cero disparos.
SAM 2 incluye un mecanismo de memoria para gestionar las dependencias temporales y las oclusiones en los datos de vídeo. El mecanismo de memoria consta de:
- Codificador de memoria y banco de memoria: Almacena características de fotogramas anteriores.
- Módulo de atención de memoria: Utiliza la información almacenada para mantener un seguimiento coherente de los objetos a lo largo del tiempo.
- Cabezal de oclusión: Gestiona específicamente las situaciones en las que los objetos no son visibles y predice la probabilidad de que un objeto esté ocluido.
Este mecanismo garantiza la continuidad incluso cuando los objetos quedan ocultos temporalmente o salen de la escena y vuelven a entrar en ella. Para obtener más información, consulta la sección Mecanismo de memoria y gestión de oclusiones.
Los modelos SAM 2, como SAM2-t y SAM2-b de Meta, ofrecen potentes capacidades de segmentación de cero disparos, pero son considerablemente más grandes y lentos que los modelos YOLO. Por ejemplo, YOLO26n-seg es aproximadamente 24 veces más pequeño y más de 1145 veces más rápido que SAM2-b en CPU. Aunque SAM 2 destaca en situaciones de segmentación versátil, basada en prompts y de cero disparos, YOLO26 está optimizado para la velocidad, la eficiencia y las aplicaciones en tiempo real gracias a la inferencia integral sin NMS, por lo que resulta más adecuado para implementarse en entornos con recursos limitados.


Comentarios150
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(editado)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(editado)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(editado)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(editado)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.