YOLO12: detección de objetos centrada en la atención
Descripción general#
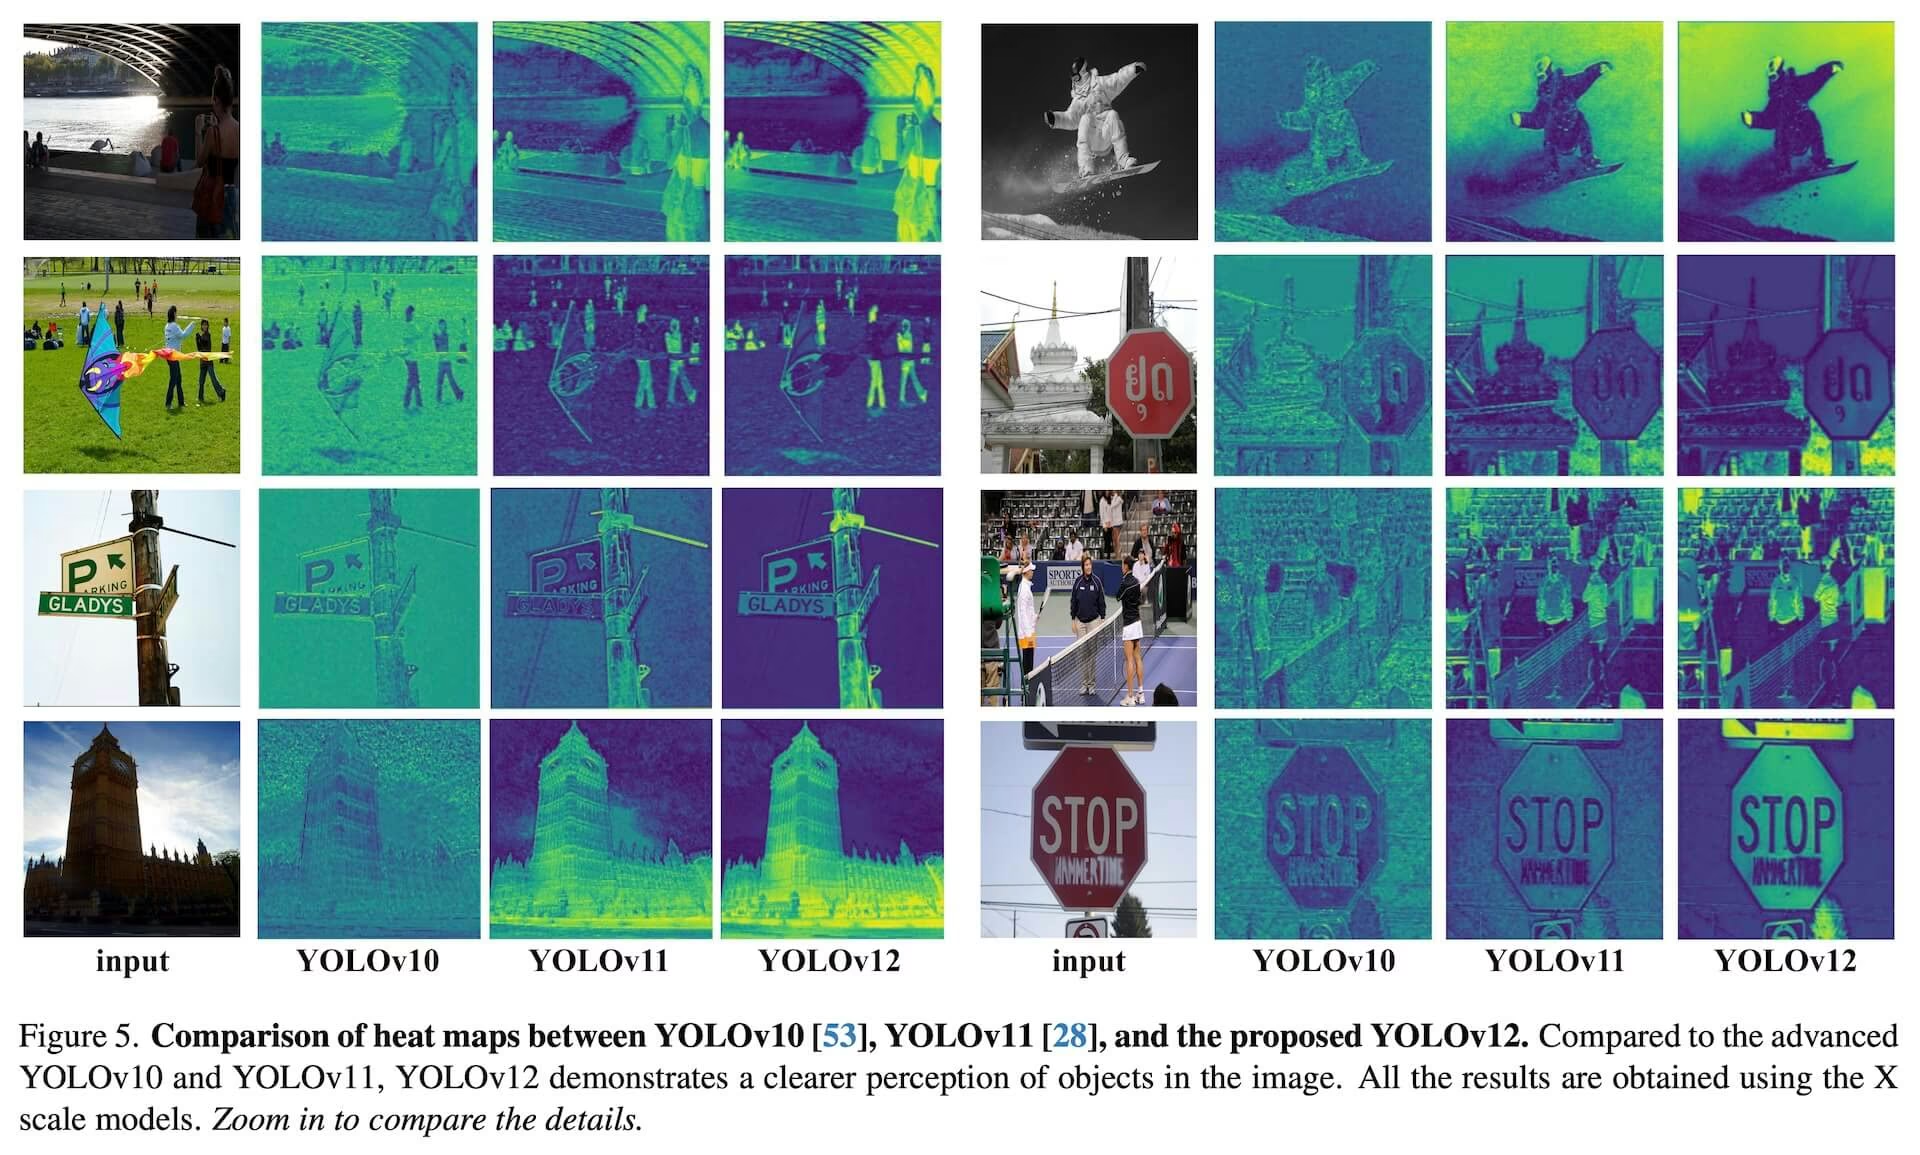
YOLO12, lanzado a principios de 2025, introduce una arquitectura centrada en la atención que se aleja de los enfoques tradicionales basados en CNN utilizados en modelos YOLO anteriores, pero conserva la velocidad de inferencia en tiempo real esencial para muchas aplicaciones. Alcanza una gran precisión en la detección de objetos gracias a cambios en sus mecanismos de atención y en la arquitectura general de la red. A pesar de estas ventajas, YOLO12 sigue siendo un lanzamiento impulsado por la comunidad que puede presentar inestabilidad durante el entrenamiento, un consumo elevado de memoria y un rendimiento más lento en CPU debido a sus pesados bloques de atención, por lo que Ultralytics recomienda YOLO11 o YOLO26 para la mayoría de las cargas de trabajo de producción.
YOLO12 se mantiene principalmente para realizar comparativas y para la investigación. Si necesitas un entrenamiento estable, un uso de memoria predecible y una inferencia optimizada en CPU, elige YOLO11 o YOLO26 para la implementación.
Ver: Cómo usar YOLO12 para la detección de objetos con el paquete Ultralytics | ¿YOLO12 es rápido o lento?
Características principales#
- Mecanismo de atención por áreas: un nuevo enfoque de autoatención que procesa de forma eficiente grandes campos receptivos. Divide los mapas de características en l regiones del mismo tamaño (cuatro por defecto), ya sea horizontal o verticalmente, y evita operaciones complejas a la vez que mantiene un campo receptivo efectivo amplio. Esto reduce significativamente el coste computacional en comparación con la autoatención estándar.
- Redes residuales eficientes de agregación de capas (R-ELAN): un módulo de agregación de características mejorado, basado en ELAN y diseñado para resolver los retos de optimización, especialmente en modelos de mayor escala centrados en la atención. R-ELAN introduce:
- Conexiones residuales a nivel de bloque con escalado (similar al escalado de capas).
- Un método de agregación de características rediseñado que crea una estructura similar a un cuello de botella.
- Arquitectura de atención optimizada: YOLO12 simplifica el mecanismo de atención estándar para aumentar la eficiencia y la compatibilidad con el marco YOLO. Esto incluye:
- Uso de FlashAttention para reducir al mínimo la sobrecarga del acceso a memoria.
- La eliminación de la codificación posicional para obtener un modelo más sencillo y rápido.
- El ajuste de la proporción de MLP (de 4, el valor habitual, a 1,2 o 2) para equilibrar mejor el cálculo entre las capas de atención y las capas de propagación hacia delante.
- La reducción de la profundidad de los bloques apilados para mejorar la optimización.
- Uso de operaciones de convolución (cuando procede) por su eficiencia computacional.
- La incorporación de una convolución separable de 7x7 (el «perceptor de posición») al mecanismo de atención para codificar implícitamente la información posicional.
- Compatibilidad completa con tareas: YOLO12 admite una variedad de tareas esenciales de visión artificial: detección de objetos, segmentación de instancias, clasificación de imágenes, estimación de pose y detección de objetos orientados (OBB).
- Mayor eficiencia: logra una mayor precisión con menos parámetros que muchos modelos anteriores, lo que demuestra un mejor equilibrio entre velocidad y precisión.
- Despliegue flexible: diseñado para desplegarse en distintas plataformas, desde dispositivos periféricos hasta infraestructura en la nube.
Tareas y modos compatibles#
YOLO12 admite diversas tareas de visión artificial. La tabla siguiente muestra la compatibilidad con las tareas y los modos operativos (entrenamiento, validación, inferencia y exportación) disponibles para cada una:
En ultralytics/assets solo se publican pesos de detección (yolo12n.pt, yolo12s.pt, yolo12m.pt, yolo12l.pt, yolo12x.pt). Las arquitecturas de segmentación, clasificación, pose y OBB están definidas en ultralytics/cfg/models/12/, por lo que estas variantes admiten el entrenamiento desde cero a partir de la configuración .yaml, pero actualmente no hay disponibles archivos .pt preentrenados para ellas. Para obtener puntos de control preentrenados de segmentación, pose, clasificación u OBB, Ultralytics recomienda YOLO11 o YOLO26.
| Tipo de modelo | Tarea | Pesos preentrenados | Entrenamiento | Validación | Inferencia | Exportar |
|---|---|---|---|---|---|---|
| YOLO12 | Detección | ✅ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-seg | Segmentación | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-cls | Clasificación | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-pose | Pose | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-obb | OBB | ❌ | ✅ | ✅ | ✅ | ✅ |
Todas las arquitecturas YOLO12 admiten todos los modos cuando se dispone de un punto de control entrenado. La columna Pretrained Weights indica únicamente si Ultralytics publica un .pt preentrenado oficial en ultralytics/assets: para segmentación, pose, clasificación y OBB, debes entrenar tu propio punto de control a partir de la configuración .yaml correspondiente antes de ejecutar la inferencia, la validación o la exportación.
Métricas de rendimiento#
YOLO12 mejora la precisión en todas las escalas de modelo, con ciertas concesiones en velocidad en comparación con los modelos YOLO anteriores más rápidos. A continuación se muestran los resultados cuantitativos de detección de objetos en el conjunto de validación de COCO:
Rendimiento de detección (COCO val2017)#
| Modelo | tamaño (píxeles) | mAPval50-95 | Velocidad CPU ONNX (ms) | Velocidad T4 TensorRT (ms) | parámetros (M) | FLOPs (B) | Comparación (mAP/Velocidad) |
|---|---|---|---|---|---|---|---|
| YOLO12n | 640 | 40.6 | - | 1.64 | 2.6 | 7.5 | +2,1 %/-9 % (frente a YOLOv10n) |
| YOLO12s | 640 | 48.0 | - | 2.61 | 9.3 | 23.3 | +0,1 %/+42 % (frente a RT-DETRv2) |
| YOLO12m | 640 | 52.5 | - | 4.86 | 20.2 | 70.7 | +1,0 %/-3 % (frente a YOLO11m) |
| YOLO12l | 640 | 53.7 | - | 6.77 | 26.4 | 95.4 | +0,4 %/-8 % (frente a YOLO11l) |
| YOLO12x | 640 | 55.2 | - | 11.79 | 59.1 | 208.9 | +0,6 %/-4 % (frente a YOLO11x) |
- Velocidad de inferencia medida en una GPU NVIDIA T4 con precisión FP16 de TensorRT.
- Las comparaciones muestran la mejora relativa en mAP y el cambio porcentual en velocidad (un valor positivo indica mayor velocidad; uno negativo, menor velocidad). Se comparan con los resultados publicados de YOLOv10, YOLO11 y RT-DETR cuando están disponibles.
Ejemplos de uso#
Esta sección ofrece ejemplos de entrenamiento e inferencia con YOLO12.
Los ejemplos siguientes se centran en los modelos YOLO12 Detect (para la detección de objetos). Para otras tareas compatibles (segmentación, clasificación, estimación de pose y detección de objetos orientados), consulta la documentación específica de cada tarea: Segment, Classify, Pose y OBB.
Los modelos *.pt preentrenados (con PyTorch) y los archivos de configuración *.yaml se pueden pasar a la clase YOLO() para crear una instancia del modelo en Python:
from ultralytics import YOLO

# Cargar un modelo YOLO12n preentrenado con COCO
model = YOLO("yolo12n.pt")

# Entrena el modelo durante 100 épocas con el conjunto de datos de ejemplo COCO8
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Ejecutar la inferencia con el modelo YOLO12n en la imagen 'bus.jpg'
results = model("path/to/bus.jpg")
Mejoras principales#
-
Mejora de la extracción de características:
- Atención por áreas: gestiona eficazmente campos receptivos amplios y reduce el coste computacional.
- Equilibrio optimizado: mejora el equilibrio entre los cálculos de atención y los de la red de propagación hacia delante.
- R-ELAN: mejora la agregación de características mediante la arquitectura R-ELAN.
-
Innovaciones de optimización:
- Conexiones residuales: introduce conexiones residuales con escalado para estabilizar el entrenamiento, especialmente en modelos de mayor tamaño.
- Integración de características refinada: implementa un método mejorado para integrar características dentro de R-ELAN.
- FlashAttention: incorpora FlashAttention para reducir la sobrecarga del acceso a memoria.
-
Eficiencia arquitectónica:
- Menos parámetros: logra un recuento menor de parámetros y mantiene o mejora la precisión respecto a muchos modelos anteriores.
- Atención simplificada: utiliza una implementación simplificada de la atención que prescinde de la codificación posicional.
- Proporciones de MLP optimizadas: ajusta las proporciones de MLP para asignar los recursos computacionales de forma más eficaz.
Requisitos#
De forma predeterminada, la implementación de Ultralytics YOLO12 no requiere FlashAttention. Sin embargo, FlashAttention se puede compilar y utilizar opcionalmente con YOLO12. Para compilar FlashAttention, se necesita una de las siguientes GPU de NVIDIA:
- GPU Turing (p. ej., T4, serie Quadro RTX)
- GPU Ampere (p. ej., serie RTX30, A30/40/100)
- GPU Ada Lovelace (p. ej., serie RTX40)
- GPU Hopper (p. ej., H100/H200)
Citas y agradecimientos#
Si utilizas YOLO12 en tu investigación, cita el trabajo original de la Universidad de Buffalo y la Universidad de la Academia China de Ciencias:
@inproceedings{tian2025yolov12,
  title={YOLOv12: Attention-Centric Real-Time Object Detectors},
  author={Tian, Yunjie and Ye, Qixiang and Doermann, David},
  booktitle={Advances in Neural Information Processing Systems},
  volume={38},
  pages={78433--78457},
  year={2025},
  url={https://proceedings.neurips.cc/paper_files/paper/2025/file/7103444259031cc58051f8c9a4868533-Paper-Conference.pdf}
}

@software{yolo12,
  author = {Tian, Yunjie and Ye, Qixiang and Doermann, David},
  title = {YOLO12: Attention-Centric Real-Time Object Detectors},
  year = {2025},
  url = {https://github.com/sunsmarterjie/yolov12},
  license = {AGPL-3.0}
}
El artículo de YOLO12 se publicó en las actas de NeurIPS 2025, con una prepublicación en arXiv.
Preguntas frecuentes#
YOLO12 incorpora varias innovaciones clave para equilibrar la velocidad y la precisión. El mecanismo de atención por áreas procesa eficazmente campos receptivos amplios y reduce el coste computacional en comparación con la autoatención estándar. Las redes de agregación de capas eficientes residuales (R-ELAN) mejoran la agregación de características y abordan los retos de optimización de los modelos de atención de mayor tamaño. La arquitectura de atención optimizada, que incluye el uso de FlashAttention y la eliminación de la codificación posicional, mejora aún más la eficiencia. Estas características permiten a YOLO12 alcanzar una gran precisión y mantener la velocidad de inferencia en tiempo real que necesitan muchas aplicaciones.
YOLO12 admite una amplia gama de tareas básicas de visión artificial: detección de objetos, segmentación de instancias, clasificación de imágenes, estimación de pose y detección de objetos orientados (OBB). Esto hace que YOLO12 sea aplicable a campos diversos, desde la robótica y la conducción autónoma hasta la imagen médica y la inspección industrial. Ten en cuenta que actualmente solo se publican pesos
.ptpreentrenados para la detección; las arquitecturas de segmentación, pose, clasificación y OBB se proporcionan como configuraciones.yamlpara entrenar desde cero.YOLO12 mejora la precisión en todas las escalas de modelo respecto a modelos YOLO anteriores como YOLOv10 y YOLO11, aunque con ciertas contrapartidas en velocidad frente a los modelos anteriores más rápidos. Por ejemplo, YOLO12n consigue una mejora de mAP del +2,1 % respecto a YOLOv10n y del +1,2 % respecto a YOLO11n en el conjunto de datos COCO val2017. Frente a modelos como RT-DETR, YOLO12s ofrece una mejora de mAP del +1,5 % y un aumento de velocidad del +42 %. Estas métricas ponen de manifiesto el sólido equilibrio de YOLO12 entre precisión y eficiencia.
De forma predeterminada, la implementación de Ultralytics YOLO12 no requiere FlashAttention. Sin embargo, FlashAttention se puede compilar y usar opcionalmente con YOLO12 para reducir al mínimo la sobrecarga del acceso a memoria. Para compilar FlashAttention, se necesita una de las siguientes GPU NVIDIA: GPU Turing (p. ej., T4 y la serie Quadro RTX), GPU Ampere (p. ej., la serie RTX30 y A30/40/100), GPU Ada Lovelace (p. ej., la serie RTX40) o GPU Hopper (p. ej., H100/H200). Así, los usuarios pueden aprovechar FlashAttention cuando su hardware lo admita.
Esta página ofrece ejemplos básicos de uso para el entrenamiento y la inferencia. YOLO12 utiliza las mismas interfaces de modos Train, Val, Predict y Export, así como de tareas Segment, Classify, Pose y OBB, que otros modelos de Ultralytics.


Comentarios69
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
Zixuan-He
I try use the YOLO12-seg, but with update to lastest version (> pip install -U ultralytics) it is still showing (No such file or directory: 'YOLO12n-seg.pt) with code (yolo segment train data=data.yaml model=YOLO12n-seg.pt epochs=200 batch=16 imgsz=640 patience=25 ). theYOLO12n.pt for obj is good. Is the code changed or need other input?
1 Glenn JocherUltralytics
@Zixuan-He Answer:
The YOLO12-seg model requires using its specific configuration file. Trymodel=yolo12-seg.yamlinstead of the.ptfile to initialize training. The segmentation weights are not yet released as pretrained.ptfiles, but you can train from scratch using the YAML configuration. For details, see the YOLO12-seg documentation.2LucasGenoud
Hello, thank you for your answer ! Do you have any date estimation of when the pretrained segmentation models for YOLO12 will be available ? Thanks
- Glenn JocherUltralytics
We don't have an official release date for YOLO12-seg pretrained weights yet, but you can train segmentation models from scratch using the YOLO12-seg.yaml configuration. For updates, please monitor the YOLO12 documentation.
Thank you for your response. Great work :)
- Glenn JocherUltralytics
Thank you for your kind words! We don't have a specific release date for YOLO12-seg pretrained weights yet, but you can monitor the YOLO12 documentation for updates. The team typically announces new model releases there first. For now, training from scratch using the YOLO12-seg.yaml configuration remains the recommended approach.
dolokbutarbutar24
Here are some sample images for the healthy class. I also attached some "results" images, hopefully can give more information so you guys can help me with the project.
Pada Sen, 30 Mar 2026 pukul 15.58 Glenn Jocher @.***> menulis:
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune weight_decay, momentum, warmup_epochs, lrf, translate, shear, perspective, fliplr, and close_mosaic using the hyperparameter tuning guide https://docs.ultralytics.com/guides/hyperparameter-tuning/ and performance metrics guide https://docs.ultralytics.com/guides/yolo-performance-metrics/. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 https://docs.ultralytics.com/models/yolo26/ since YOLO12 is mainly maintained as a community research model.
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/19360?email_source=notifications&email_token=A23CVICPPIXOD6F3LMBB52T4TIZKDA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRTG44DGNRZUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16378369, or unsubscribe https://github.com/notifications/unsubscribe-auth/A23CVIG2PM2BD5335IFZQXT4TIZKDAVCNFSM6AAAAABXS26SR6VHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMMZXHAZTMOI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
Thanks, that helps; from those samples I’d next verify that the
healthylabels are fully consistent and that the class counts are not skewed, then please attach a few matching image/label.txtpairs plusresults.csvandconfusion_matrix_normalized.pngso we can check whether this is a data issue rather than a YOLO12 training issue, and if you recently fixed labels please delete anylabels/*.cachefiles before retraining.
I am currently working on a project to detect cassava leaf diseases using YOLOv12. The focus of this research is to perform hyperparameter tuning and also determine the most suitable augmentation configuration to improve model performance. So far, the trained model is still hovering around the 0.5 range for the mAP@50-95 evaluation metric. Here are the hyperparameters I have used for tuning so far: epochs=100, patience=20, imgsz=1024, batch=8, optimizer='auto', lr0=0.00511, box=6.32971, cls=2.87957, dfl=2.12658, mosaic=0.25, scale=0.15, mixup=0.0, copy_paste=0.0, degrees=10.0, hsv_h=0.015, hsv_s=0.7, hsv_v=0.4.
What other strategies can I do to improve my model's performance, especially on the mAP@50-95 evaluation metric? Do you have any suggestions for other hyperparameters that need to be added to this project for tuning? I'm sure your experience and skills can answer that and help me hahaha.
- Glenn JocherUltralytics
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune
weight_decay,momentum,warmup_epochs,lrf,translate,shear,perspective,fliplr, andclose_mosaicusing the hyperparameter tuning guide and performance metrics guide. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 since YOLO12 is mainly maintained as a community research model.
 Clousy
在5090 32G上使用yolo12l训练模型的时候,数据量大概7万左右,batch_size=24 内存占用在24G左右,为啥速度只有2-3it/s 是哪里设置有问题?下面是训练参数: rain_args = dict( data="data.yaml", epochs=500, imgsz=640, batch=24, device=device, workers=16,
cache=False, amp=True, # --- 减少 CPU 负担 --- mosaic=0.0, # 暂时关掉 Mosaic 看看速度是否飙升 mixup=0.0, # 同上 )- Glenn JocherUltralytics
yolo12l本身是重注意力结构,吞吐会比同尺度的 CNN 系列低不少,所以你看到的2–3 it/s在batch=24下未必异常(折算大约是48–72 img/s);如果你目标是更高训练/CPU 端速度,建议直接换到更稳更快的 Ultralytics YOLO26(YOLO12 更偏研究/基准用途,见 YOLO12 文档)。想确认是不是环境/数据读取瓶颈的话,请把yolo checks输出和完整文本训练日志(含第一轮的进度条行、CUDA:/显卡名、DataLoader相关信息)贴在这里;另外你现在cache=False可能会被磁盘 IO 卡住、workers=16在部分系统上也会造成额外调度开销,建议先用下面这组参数做一次对照测试(同一数据/同一imgsz),看it/s是否明显变化:yolo checks yolo train model=yolo12l.pt data=data.yaml epochs=2 imgsz=640 batch=24 device=0 workers=8 cache=True mosaic=0.0 mixup=0.0
is there any video (tutorial) about how to classify plant disease? i'm confused about how to do it because i need guidance to do classify task
- Glenn JocherUltralytics(editado)
Yes—plant disease is just a standard image classification workflow; please follow the Ultralytics YOLO classification guide (and drop any follow-up questions here in this discussion so the Ultralytics team can see them), then try:
from ultralytics import YOLO

# ImageNet-pretrained classifier backbone (recommended starting point)
model = YOLO("yolo26n-cls.pt")

# Your dataset folder should contain train/ and val/ with one subfolder per class
model.train(data="path/to/plant_disease_dataset", epochs=50, imgsz=224)
If you share your dataset folder layout (just the directory tree) and what’s confusing you, I can point you to the exact next step.
asad121101
Hello , this new yolo12 is using what architecture in neck ? pan or fpn ? or some thing else ?
Sourabh0052
while working on classification model using YOLO12-cls and i do not make any .yaml file, just simply provide the data source path then will it work same or not
radadiavasu
I faced a problem that recently I put my model on training with yolo12x but at 98/100 epoch it stopped due to units are over on colab pro but when I start again and expect to start from 98 but it start from 1/100 instead of 98 even in results.csv I couldn't get anything. Why this problem occurs?
deldanr
When resuming a training session started with Yolov12, after the AMP check, the training session downloads a Yolov11 model to continue, which I assume is an error.
Attached is part of the log: YOLOv12l summary: 488 layers, 26,389,875 parameters, 26,389,859 gradients, 89.4 GFLOPs
Transferred 1245/1245 items from pretrained weights Freezing layer 'model.21.dfl.conv.weight' AMP: Running Automatic Mixed Precision (AMP) checks... Downloading https://github.com/ultralytics/assets/releases/download/v8.3.0/yolo11n.pt to 'yolo11n.pt'... <-- Here's the error
pvurda
Has anyone found a low-cost, low-latency way to generate a short semantic scene caption (e.g., “two people loading a van”) on top of YOLO12 detections in real time?