YOLOE: detección y segmentación de vocabulario abierto en tiempo real
Ultralytics YOLOE (verlo todo en tiempo real) es un modelo de detección de vocabulario abierto y segmentación de instancias: en lugar de utilizar una lista de clases fijada durante el entrenamiento, recibe las categorías que quieras en la inferencia, ya sea como solicitud de texto, ejemplo visual o vocabulario integrado de 4585 nombres. Basado en las arquitecturas YOLO de Ultralytics —YOLOv8, YOLO11 y YOLO26— e inspirado en YOLO-World, YOLOE alcanza una gran precisión de cero disparos con una velocidad cercana a la de YOLO de conjunto cerrado.
Ver: Cómo usar Ultralytics YOLOE-26 (nuevo) | Vocabulario abierto y visión de todo en tiempo real
Inicio rápido#
Indica las clases que quieras y ejecútalo. YOLOE-26 devuelve cajas y máscaras de segmentación de instancias para categorías con las que nunca se ha entrenado.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# "autobús de dos pisos" no es una clase de COCO; YOLOE la identifica solo a partir de las palabras
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
La primera llamada a set_classes() descarga un codificador de texto; consulta Instalación y requisitos antes de desplegarlo en una máquina sin acceso a la red.
Elegir un modo de indicaciones#
YOLOE admite tres modos de indicaciones, y la elección determina qué punto de control cargas y qué aspecto tienen las etiquetas de clase. Elige la fila que corresponda a lo que puedes proporcionar durante la inferencia.
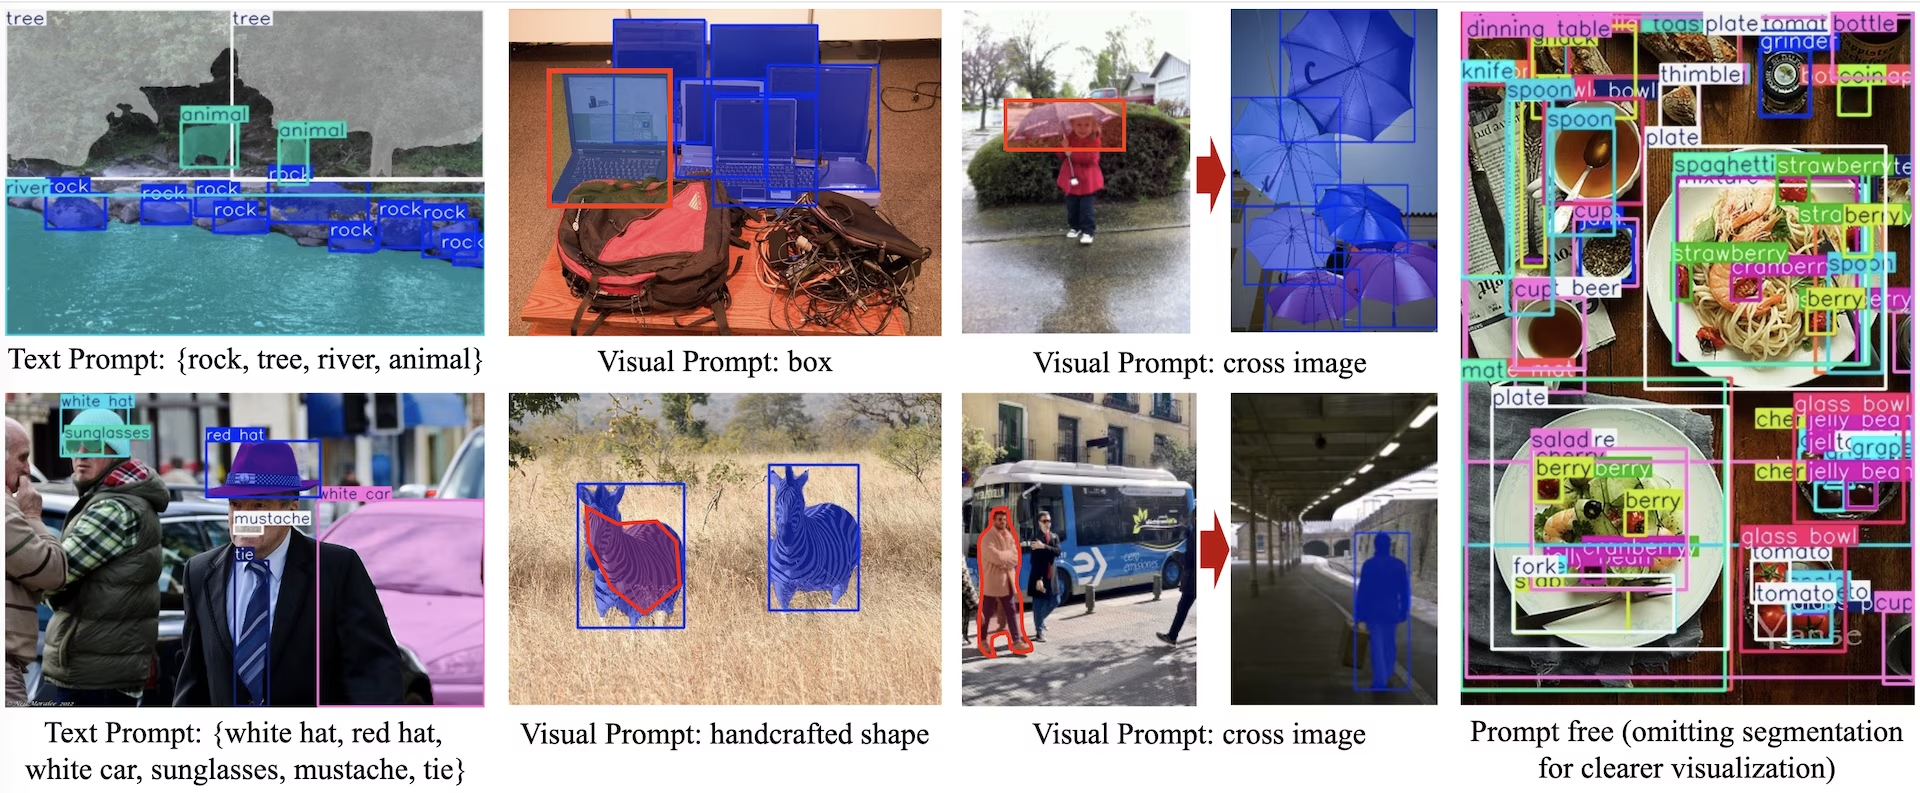
| Modo | Punto de control | Qué proporcionas | Nombres de clase en los resultados | Cuándo usarlo |
|---|---|---|---|---|
| Indicación de texto | *-seg.pt | Nombres de clase como cadenas de texto | Exactamente los nombres que has indicado | Puedes describir el objetivo con palabras: la opción habitual |
| Indicación visual | *-seg.pt | Cajas de ejemplo en una imagen de referencia | Genéricos object0, object1, … | No puedes describir el objetivo con palabras: una pieza concreta, un logotipo o un defecto |
| Sin indicaciones | *-seg-pf.pt | Nada | Nombres del vocabulario integrado de 4585 nombres | Estás catalogando o explorando y no sabes de antemano qué buscar |
- Las indicaciones visuales no conservan tus etiquetas. Los ID de clase de
visual_promptsagrupan los ejemplos; el modelo los devuelve comoobject0,object1, etc. Tienes que asignarles tú tus propios nombres. - Los puntos de control sin indicaciones rechazan
set_classes(). Si lo llamas en un modelo*-seg-pf.pt, se generaAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Carga un punto de control*-seg.pten su lugar cuando necesites tus propias clases.
Instalación y requisitos#
YOLOE está incluido en el paquete principal de Ultralytics:
pip install -U ultralyticsAdemás, las indicaciones de texto necesitan un codificador de texto, que se descarga la primera vez que se usa en lugar de durante la instalación:
- La primera llamada a
set_classes()instala ultralytics/CLIP desde GitHub conpip(que proporciona el tokenizador) y descarga un codificador de texto TorchScript en el directorio de trabajo actual. YOLOE-26 descargamobileclip2_b.ts, unos 254 MB; YOLOE-11 y YOLOE-v8 descarganmobileclip_blt.ts. Ejecuta la descarga una vez desde el directorio desde el que vayas a ejecutar el programa, o copia allí el archivo; de lo contrario, volverá a descargarse. - Ambos pasos necesitan acceso a la red, así que ejecuta una predicción con indicaciones antes de desplegar el modelo en una máquina sin conexión o aislada de la red.
- Los puntos de control con indicaciones visuales y sin indicaciones no necesitan ningún codificador de texto.
Los puntos de control YOLOE-26 requieren ultralytics 8.4.0 o posterior; las familias YOLOE-11 y YOLOE-v8 están disponibles en versiones anteriores. Una predicción con indicación de texto prueba todo el proceso: descarga del punto de control, instalación de CLIP, codificador de texto e inferencia:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Para omitir por completo la descarga del codificador de texto durante la inferencia, integra las indicaciones en los pesos una vez y reutilízalos; consulta Reutilizar incrustaciones de indicaciones.
Descripción general de la arquitectura#

YOLOE conserva la estructura estándar de YOLO —un backbone convolucional para extraer características, un neck para la fusión multiescala y una cabeza desacoplada y sin anclajes que predice clases y cajas— y añade tres módulos, uno por cada modo de indicaciones:
- Alineación región-texto reparametrizable (RepRTA) refina las incrustaciones de texto de CLIP mediante una pequeña red auxiliar. Esta red se ejecuta una vez por llamada a
set_classes()y se elimina al exportar, así que no tiene coste por fotograma. Lo que sí se ejecuta en cada pasada hacia delante es la comparación de las incrustaciones de las solicitudes almacenadas con las características de las regiones; consulta Limitaciones para saber cuánto cuesta con un conjunto grande de solicitudes. - Codificador de indicaciones visuales activadas semánticamente (SAVPE) codifica características semánticas y de activación de una caja de ejemplo, y condiciona el modelo para que detecte objetos de aspecto similar. Esta es la vía de aprendizaje de un solo ejemplo para objetivos difíciles de describir, como un logotipo o una pieza concreta.
- Contraste diferido de indicaciones de región (LRPC) compara las incrustaciones de región con un vocabulario integrado de 4585 nombres, para que los puntos de control sin indicaciones reconozcan objetos sin indicaciones externas ni codificador de texto.
La segmentación de instancias se obtiene mediante una rama de máscaras en la cabecera de detección, como en YOLOv8-Seg, y cada predicción incluye una máscara en results[0].masks. Una vez exportado el modelo, los módulos de mundo abierto se reparametrizan en una cabecera YOLO estándar, de modo que el archivo exportado ejecuta la ruta habitual de detección/segmentación.
Modelos disponibles#
Todos los puntos de control siguientes son modelos de segmentación de instancias y admiten val, predict, export y track. Carga un archivo *-seg.pt para usar solicitudes de texto o visuales y un archivo *-seg-pf.pt para la inferencia sin solicitudes; no son intercambiables. Consulta Elegir un modo de solicitud. Solo los archivos *-seg.pt admiten train; un punto de control sin solicitudes se genera a partir de un modelo entrenado con solicitudes de texto. Consulta Entrenar los modelos oficiales desde cero.
| Modelo | Indicación de texto/visual | Sin indicaciones |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
Rendimiento de YOLOE en LVIS#
Resultados sin ejemplos en LVIS minival a 640 píxeles, extraídos del artículo de Ultralytics YOLO26.
Indicaciones de texto y visuales#
Cada celda de precisión y parámetros muestra indicación de texto/indicación visual; los FLOPs se indican una sola vez. Los parámetros y los FLOPs corresponden a la configuración de detección evaluada en el artículo. La precisión es la cifra Non-E2E del artículo, el único protocolo que incluye para todos los modelos de la comparación; la cabeza end-to-end de YOLOE-26 queda como máximo 1,1 AP por debajo con indicaciones de texto y 2,6 AP con indicaciones visuales.
| Modelo | mAP50-95 | mAPr | mAPc | mAPf | parámetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
Sin indicaciones#
Los puntos de control sin indicaciones responden usando su vocabulario integrado, sin que se les proporcione ninguna indicación. Cada celda de precisión muestra end-to-end/Non-E2E, los dos protocolos con los que el artículo evalúa YOLOE-26; la página de YOLO26 cita la columna Non-E2E.
| Modelo | mAP50-95 | mAPr | mAPc | mAPf | parámetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
Con indicaciones de texto y visuales, los modelos YOLOE-26 superan a sus equivalentes YOLOE-11 y YOLOE-v8 en todas las escalas coincidentes en mAP50-95, y se mantienen por debajo de la línea v8 en parámetros y FLOPs. En la misma partición, el artículo presenta YOLO-Worldv2 con 24.4 (S), 32.4 (M) y 35.5 (L), y los detectores basados en Transformer GLIP-T con 26.0, GDINO-T con 27.4 y DetCLIP-T con 34.4, cada uno con entre 155 y 232 M de parámetros. El artículo original de YOLOE añade dos resultados para los modelos de escala v8 que presentó. En LVIS, YOLOE-v8s supera a YOLO-Worldv2-S en 3.5 AP, con un tercio del coste de entrenamiento y 1.4× la velocidad de inferencia. Al transferirlo a COCO, YOLOE-v8l obtiene 0.6 box AP y 0.4 mask AP más que YOLOv8-L de conjunto cerrado, con casi 4× menos tiempo de entrenamiento.
El artículo de YOLO26 evalúa una configuración de detección. Los pesos publicados son checkpoints de segmentación e incluyen una rama de máscaras, SAVPE y la proyección de texto, por lo que un yoloe-26l-seg.pt cargado indica 35.4 M y 142.0 B, en lugar de los 25.5 M y 89.0 B anteriores. En ambos casos, la cifra de FLOPs excluye la similitud entre regiones y texto, por lo que el coste real aumenta con el tamaño del conjunto de indicaciones, aunque la cifra de la columna no cambie; consulta Limitaciones.
Ejemplos de uso#
Todos los ejemplos de YOLOE que aparecen a continuación se ejecutan desde la API de Python. La predicción con indicaciones de texto, la validación, la exportación, el seguimiento y el entrenamiento normal también funcionan desde la CLI; las recetas de ajuste fino pasan una clase de entrenador y las indicaciones visuales pasan matrices de indicaciones NumPy, que solo acepta la API de Python.
Uso del entrenamiento#
Afina cualquier punto de control publicado de *-seg.pt con tu propio conjunto de datos de YOLO. El proceso sigue en gran medida el procedimiento estándar de entrenamiento de YOLO; la diferencia está en el entrenador que indiques. YOLOEPESegTrainer fusiona los nombres de tus clases con el cabezal y afina el modelo a partir de ahí, que es lo que necesitas para tus propias etiquetas; el entrenador predeterminado no entrena con tus nombres de clase. El punto de control resultante predice directamente las clases de tu conjunto de datos: su cabezal ya no lee prompts, por lo que set_classes() genera un error si cambian las clases, y los prompts visuales también. Usa el punto de control original para indicar otras clases.
Ver: Cómo entrenar YOLOE con el conjunto de datos de segmentación de piezas de automóviles | Modelo de vocabulario abierto, predicción y exportación
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Importante: el entrenador de ajuste fino, no el predeterminado
)Todos los checkpoints publicados son modelos de segmentación. Para entrenar un detector, crea el modelo a partir del YAML correspondiente, carga los pesos de segmentación de la misma escala y sustituye el entrenador por el de detección. Todo lo demás permanece igual.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Uso de la predicción#
La llamada con indicaciones de texto es la que se muestra en Inicio rápido. Las indicaciones visuales añaden un argumento visual_prompts, y la predicción sin indicaciones carga en su lugar un punto de control -pf:
Las indicaciones visuales muestran al modelo un ejemplo en lugar de describirlo. visual_prompts recibe una matriz bboxes de cajas de ejemplo y una matriz cls de identificadores de clase, uno por caja. Los identificadores son agrupaciones temporales, no etiquetas: deben ser secuenciales desde 0, y los resultados se devuelven como object0, object1, … en lugar de usar los nombres que elijas.
Las cajas de ejemplo pueden estar en la imagen sobre la que haces la predicción:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# Una caja de ejemplo por objetivo, cada una con su propio identificador de clase
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # persona, gafas
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
O pueden estar en una imagen de referencia independiente que se pasa como refer_image. En ese caso, bboxes y cls describen objetos de la imagen de referencia, no de la imagen objetivo:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Imagen objetivo
    refer_image="ultralytics/assets/bus.jpg",  # Dónde se encuentran las cajas de ejemplo
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image también fija las clases de forma permanente, así que las llamadas posteriores no necesitan indicaciones
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # Y la exportación las conservaCuando source es un vídeo o una transmisión, el primer fotograma se convierte automáticamente en refer_image, de modo que las indicaciones que pasas se aplican a ese fotograma y se mantienen durante el resto del vídeo. Pasa refer_image explícitamente para elegir otro fotograma.
Tanto source como refer_image aceptan directamente tensores torch, lo que resulta útil si las imágenes ya proceden de una canalización existente. Indica las cajas con las coordenadas de píxel propias del tensor:
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # (1, 3, H, W), tensor float en [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Para hacer predicciones en varias imágenes a la vez, anida las indicaciones un nivel más: una matriz bboxes y una matriz cls por cada imagen de origen, en el mismo orden que las imágenes.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: persona, gafas
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: persona
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Uso de la validación#
La validación se ejecuta como con cualquier otro modelo, usando un conjunto de datos de segmentación:
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # o yoloe-26s/m-seg.pt para otros tamaños

metrics = model.val(data="coco128-seg.yaml")
data también puede ser un archivo NDJSON o un URI de conjunto de datos de la Plataforma ul://; se convierte al formato YOLO antes de crear las indicaciones de texto o visuales.
Dos variantes de la misma llamada cubren los otros modos de indicación:
- Indicaciones visuales —
model.val(data="coco128-seg.yaml", load_vp=True)extrae una incrustación visual por categoría del propio conjunto de datos. Añaderefer_data="coco.yaml"para obtener las incrustaciones de otro conjunto de datos, que debe contener exactamente las mismas categorías. - Sin indicaciones — carga un checkpoint
*-seg-pf.pty pasasingle_cls=True.
Uso de la exportación#
Las incrustaciones de las indicaciones se pueden guardar una vez y reutilizar al generar exportaciones estáticas como ONNX, OpenVINO, TensorRT, CoreML, LiteRT y RKNN. El modelo PyTorch original carga el perfil NPZ antes de la exportación; no es una entrada adicional en tiempo de ejecución y el modelo exportado no necesita el archivo NPZ.
Las clases configuradas con set_classes() (o mediante refer_image para las indicaciones visuales) quedan integradas en los pesos exportados. Una vez exportado, el modelo ya no puede aceptar indicaciones nuevas: si llamas a set_classes() o pasas visual_prompts=... a predict() en una exportación cargada, se producirá un error. Para cambiar las clases detectadas, vuelve a exportar desde el checkpoint .pt original con las nuevas indicaciones configuradas. El archivo exportado funciona como un modelo YOLO estándar y también se puede cargar con YOLO() en lugar de YOLOE().
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# El perfil queda vinculado al checkpoint de origen y se puede reutilizar en exportaciones posteriores.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
El mismo perfil de indicaciones también puede configurar un modelo solo de detección creado a partir de la arquitectura YOLOE correspondiente. Esto elimina la rama de máscaras y conserva las clases indicadas:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
Seguimiento de uso#
Las clases indicadas pasan directamente al seguimiento, para que puedas seguir objetos con los que nunca se entrenó el rastreador:
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True mantiene estables los ID de seguimiento entre fotogramas
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
Comparativa de YOLOE#
YOLOE se sitúa entre un detector de conjunto cerrado y un modelo de vocabulario abierto de gran tamaño. Tres comparaciones determinan si es la opción adecuada:
- Frente a un YOLO de conjunto cerrado. Una vez configuradas las indicaciones, YOLOE predice mediante el flujo normal de detección/segmentación y se exporta como cualquier otro modelo. Lo que añade es la posibilidad de cambiar la lista de clases en tiempo de inferencia en lugar de volver a entrenar; lo que sacrifica es una precisión de cero disparos muy inferior a la de un modelo entrenado con tus propias clases.
- Frente a las familias YOLOE anteriores. YOLOE-26 hereda la cabeza integral sin NMS de YOLO26, admite cinco escalas (n/s/m/l/x) frente a las tres anteriores (s/m/l) y lidera en todas las escalas coincidentes en Rendimiento.
- Frente a los detectores de vocabulario abierto basados en Transformer. GLIP y OWL-ViT ejecutan un Transformer de visión y lenguaje durante la inferencia. YOLOE codifica las indicaciones una sola vez y después las compara con las características de las regiones dentro de una cabeza convolucional.
Las alternativas más parecidas aceptan una indicación de texto, pero solo YOLOE y SAM 3 devuelven máscaras, y cada una responde a preguntas distintas:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Diseñado para | Detección y segmentación en tiempo real de clases con nombre | Segmentación de conceptos y seguimiento mediante indicaciones | Detección de vocabulario abierto en tiempo real |
| Máscaras | Sí, con los checkpoints *-seg.pt | Sí | No, solo cajas |
| Indicaciones visuales | Sí (SAVPE) | Sí | No |
| Modo sin indicaciones | Sí, vocabulario de 4,585 nombres | No | No |
| Elígelo cuando | Necesites rendimiento y puedas nombrar las clases | Necesites la mejor segmentación de conceptos y puedas dedicarle recursos de computación | Ya lo estés usando; consulta la nota de migración a continuación |
¿Vienes de YOLO-World? La estructura de la API es la misma: sustituye YOLOWorld por YOLOE, carga un checkpoint *-seg.pt y mantén tal cual la llamada a set_classes(). Obtienes máscaras e indicaciones visuales; la nota sobre exportación relativa a las clases fijadas se aplica a ambos.
Casos de uso y aplicaciones#
La detección de vocabulario abierto elimina la necesidad de volver a entrenar para cada clase, algo especialmente importante cuando no se conoce de antemano la lista de objetivos:
- Detección en entornos abiertos — robótica y sistemas de seguridad que se encuentran con objetos que nadie enumeró durante el entrenamiento.
- Detección con un solo ejemplo — las indicaciones visuales detectan una pieza, un logotipo o un defecto concretos a partir de una única caja de referencia, algo útil en la inspección industrial.
- Catalogación de categorías poco frecuentes — el vocabulario integrado de 4,585 nombres es lo bastante amplio para realizar análisis de seguimiento de la biodiversidad o inventario minorista.
- Preparación inicial de conjuntos de datos — genera etiquetas preliminares con cajas y máscaras antes de la revisión humana y, después, entrena con esos resultados un modelo rápido de conjunto cerrado.
- Segmentación de objetivos arbitrarios — los checkpoints
*-seg.ptpublicados devuelven una máscara con cada predicción, por lo que la imagen médica y el análisis por satélite obtienen resultados precisos a nivel de píxel sin necesidad de un segundo modelo.
Un patrón habitual combina dos modos: ejecuta una vez el modo sin indicaciones para descubrir qué hay y, después, cambia a las indicaciones de texto para las categorías que te interesan.
Limitaciones#
YOLOE sacrifica precisión a cambio de poder cambiar las clases durante la inferencia. Estas son las consecuencias que conviene conocer antes de decidirte:
- La precisión de cero disparos es muy inferior a la de un modelo entrenado con tus clases. Los checkpoints con indicaciones obtienen aproximadamente entre 22 y 40 mAP en LVIS minival; un YOLO de conjunto cerrado entrenado con tus propios datos los superará en esas clases. Elige YOLOE para cubrir clases con las que no puedes entrenar, no para sustituir el entrenamiento.
- Las categorías poco frecuentes son el punto débil. La columna mAPr de Rendimiento muestra específicamente la precisión en las clases poco frecuentes de LVIS y, con indicaciones de texto, sus valores son inferiores a los de las columnas de clases comunes y frecuentes en todas las filas. Si tus objetivos son poco habituales, fíjate en este dato y no en el mAP principal.
- Una indicación describe el aspecto, no las relaciones. La detección compara las características de las regiones con la incrustación de la indicación, así que las indicaciones que dependen del estado, el contexto o la comparación —«dañado», «el situado más a la izquierda», «el que se está llevando»— no ofrecen una referencia fiable con la que comparar. Utiliza expresiones parecidas a los nombres de categorías habituales.
- Los conjuntos grandes de indicaciones aumentan la latencia. Las incrustaciones de las indicaciones se calculan una sola vez, pero se comparan con las características de las regiones en cada pasada hacia delante. En CPU con
yoloe-26s-seg.pt, el tiempo de una pasada hacia delante aumenta alrededor de un 19 % al pasar de 80 a 1,203 clases y cerca de un 89 % con el vocabulario completo de 4,585 nombres. Los FLOPs indicados no cambian en absoluto, porque no se cuenta la similitud entre regiones y texto, así que el perfil no te avisará. - Los nombres de clase son marcadores de posición hasta que añades indicaciones. Un checkpoint
*-seg.ptrecién cargado devuelvenc=80con nombres numéricos ("0","1", …), así que llama aset_classes()antes de leer las etiquetas. Los checkpoints sin indicaciones ya incluyen todo el vocabulario.
Notas de implementación#
- Hardware. La inferencia necesita una GPU NVIDIA con entre 4 y 8 GB de VRAM; las escalas
nysfuncionan en GPU de borde como Jetson o en CPU con una resolución reducida. El ajuste fino necesita una única GPU. - NMS no distingue clases de forma predeterminada. YOLOE predice con
agnostic_nms=True. De forma predeterminada, esto suprime las cajas solapadas con puntuaciones más bajas entre distintas clases, en lugar de hacerlo solo dentro de la misma clase, lo que evita duplicados cuando un objeto coincide con varias categorías. Connms=False, YOLOE-26 no aplica ninguna supresión por IoU; el modo agnóstico solo conserva la mejor clase por ancla, en lugar de permitir que una ancla emita varias etiquetas de clase. Pasaagnostic_nms=Falsepara cambiar este comportamiento. - Los prompts visuales usan
conf=0.05de forma predeterminada. Las cajas de prompts visuales funcionan correctamente con más frecuencia de lo que indican sus puntuaciones: en LVIS minival, usando una instancia de una clase como prompt,conf=0.25no detecta entre el 44 y el 55 % de las demás instancias que YOLOE-26 detecta conconf=0.05. Las escenas densas con objetos casi idénticos, como estanterías de tiendas o células, pueden necesitar valores más bajos; connms=False, la cabeza uno a uno de YOLOE-26 obtiene puntuaciones aún más bajas, y su mejor umbral se acerca a0.01. Todas las demás llamadas mantienenconf=0.25, incluidas las llamadas posteriores, las incrustaciones guardadas y las exportaciones que reutilizan las clases establecidas porrefer_image. Pasaconfpara sobrescribirlo. - Procesamiento por lotes. La inferencia por lotes funciona directamente y las indicaciones visuales pueden ser distintas para cada imagen de una misma llamada.
Entrenar desde cero los modelos oficiales#
La mayoría de los lectores no necesita hacerlo. Este proceso reproduce los checkpoints de vocabulario abierto publicados a partir de Objects365, GQA y Flickr30k —unos 1.4 M de muestras de entrenamiento en 8× RTX 4090— y no tiene relación con el ajuste fino de tus propios datos, que se explica en Uso del entrenamiento más arriba.
Todos los entrenadores que heredan de YOLOETrainer rechazan compile=True, incluidos el YOLOESegTrainer predeterminado y todos los entrenadores desde cero que se muestran a continuación. Pasa compile=False (el valor predeterminado). Los dos entrenadores de ajuste fino utilizados anteriormente, YOLOEPESegTrainer y YOLOEPETrainer, no tienen esa restricción.
El entrenamiento necesita anotaciones de segmentos. Puedes descargar los archivos procesados que aparecen a continuación o generar los tuyos con el script del equipo oficial, basado en SAM 2.1. La validación utiliza LVIS minival.
| Conjunto de datos | Tipo | Muestras | Cajas | Anotaciones de segmentos procesadas |
|---|---|---|---|---|
| Objects365v1 | Detección | 609k | 9621k | objects365_train_segm.json |
| GQA | Anotación de regiones | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Anotación de regiones | 149k | 641k | final_flickr_separateGT_train_segm.json |
Primero se entrena el modelo con indicaciones de texto; los otros dos modos de indicación son refinamientos de este:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # o la ruta a un archivo YAML con la misma estructura
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
Los puntos de control con indicaciones visuales y sin indicaciones parten de ese modelo entrenado con indicaciones de texto y actualizan un módulo cada uno. YOLOESegVPTrainer es la receta para indicaciones visuales y YOLOEPEFreeTrainer la receta sin indicaciones, pero ninguna de las dos clases congela nada por sí sola: el entrenamiento selectivo depende de la lista freeze que pases junto con ella, que incluye todos los elementos secundarios del cabezal excepto savpe (respectivamente, todas las torres de clasificación), y la ejecución sin indicaciones también necesita single_cls=True. El repositorio original de YOLOE incluye las recetas completas para los modelos de escala v8.
Una ejecución sin indicaciones terminada se reparametriza en un punto de control que informa de sus nombres sin indicaciones durante la inferencia, usando get_vocab y set_vocab:
from ultralytics import YOLOE

# Pesos escritos por la ejecución sin indicaciones y por la ejecución con indicaciones de texto desde la que partió. Cada
# nueva ejecución crea un directorio nuevo (train-2, train-3, ...), así que usa las rutas que hayan mostrado las ejecuciones.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # ejecución sin indicaciones; el cabezal ya está fusionado
text_model = YOLOE("runs/segment/train/weights/best.pt")  # ejecución con indicaciones de texto; el cabezal aún no está fusionado

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # el vocabulario de 4,585 nombres o tu propia lista
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt")  # no sobrescribas nunca el punto de control publicado
get_vocab devuelve la rama que selecciona el indicador end2end del modelo, y set_vocab reparametriza esa rama. Los archivos publicados de YOLOE-26 incluyen, en cambio, un vocabulario por rama, que es lo que permite que nms elija entre ellas; para reproducirlo, toma el segundo vocabulario de otra copia del modelo con indicaciones de texto. YOLOE-11 y YOLOE-v8 tienen una sola rama, así que usan la llamada anterior sin cambios.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab fusiona el cabezal que lee, así que carga una segunda copia
one2one_model.model.end2end = True  # leer la rama sin NMS

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Citas y agradecimientos#
Si YOLOE ha contribuido a tu investigación o proyecto, cita el artículo original de Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han y Guiguang Ding, de la Universidad Tsinghua:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Para obtener más información, el artículo original de YOLOE está disponible en arXiv. Puedes acceder al código fuente del proyecto y a recursos adicionales a través de su repositorio de GitHub.
Preguntas frecuentes#
Ultralytics YOLOE añade dos capacidades que YOLO-World no tiene: indicaciones visuales, donde una caja de ejemplo sustituye al nombre de la clase, y puntos de control sin indicaciones, que responden a partir de un vocabulario integrado de 4,585 nombres sin necesidad de ninguna indicación. Todas las predicciones de los puntos de control publicados de
*-seg.ptincluyen también una máscara de segmentación de instancias. En cuanto a precisión, el artículo original de YOLOE sitúa YOLOE-v8s 3.5 AP por delante de YOLO-Worldv2-S en LVIS, con un tercio del coste de entrenamiento y 1.4× la velocidad de inferencia. La migración requiere cambiar una sola línea: consulta Comparativa de YOLOE.Ultralytics YOLOE admite tres modos de indicación. Una indicación de texto consiste en nombres de clases en forma de cadenas en un punto de control
*-seg.pty es la opción habitual. Una indicación visual consiste en una o varias cajas de ejemplo en una imagen de referencia, para objetos que son difíciles de describir con palabras. La inferencia sin indicaciones usa un punto de control*-seg-pf.ptindependiente, que responde a partir de un vocabulario integrado de 4,585 nombres sin que se le proporcione nada. Las indicaciones de texto y visuales comparten los mismos puntos de control; los puntos de control sin indicaciones son archivos diferentes y rechazanset_classes(). Consulta Cómo elegir un modo de indicación para ver la comparativa completa.Empieza con
yoloe-26s-seg.pt: la familia YOLOE-26 supera a YOLOE-11 y YOLOE-v8 en todas las escalas equivalentes, y la escalases la más pequeña que supera los 30 mAP en LVIS minival. Pasa am,loxcuando la precisión en categorías poco frecuentes importe más que la latencia: compara la columna mAPr de Rendimiento. Baja ansolo para implementaciones en el borde. En su lugar, carga el archivo*-seg-pf.ptde la misma escala cuando quieras usar el vocabulario integrado en vez de tus propios nombres de clase.Etiquetas como
object0yobject1indican que la predicción procede de una indicación visual, que agrupa las cajas de ejemplo en clases numeradas temporales en lugar de conservar tus nombres. Los ID de clase que pasas envisual_prompts["cls"]solo sirven para esa agrupación. El modelo las devuelve comoobject0,object1, etc., en el orden de los ID que hayas asignado, así que vuelve a asociarlas con tus propias etiquetas en el resultado. Si quieres que aparezcan tus nombres en la salida, usa una indicación de texto.Los puntos de control sin prompts (
*-seg-pf.pt) resuelven las clases mediante su propio vocabulario integrado y rechazanset_classes()conAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.. Los prompts visuales generanAssertionError: Visual prompts need an unfused YOLOE model.. Carga un punto de control de*-seg.ptcuando necesites tu propia lista de clases. Consulta Cómo elegir un modo de prompting.La primera indicación de texto hace que Ultralytics YOLOE instale ultralytics/CLIP desde GitHub con
pipy descargue un codificador de texto TorchScript en el directorio de trabajo actual: unos 254 MB para YOLOE-26. Consulta Instalación y requisitos para conocer el recurso exacto de cada familia de modelos. Las indicaciones visuales y los puntos de control sin indicaciones no necesitan ninguno de los dos. Para evitar la descarga en la máquina de destino, configura las indicaciones una vez y guárdalas consave_prompt_embeddings(), o exporta el modelo con las clases ya configuradas.No: YOLOE incorpora las clases indicadas a los pesos durante la exportación, así que un modelo exportado cargado rechaza tanto
set_classes()comovisual_prompts=. Vuelve a exportar desde el punto de control original.ptcon las nuevas indicaciones configuradas. El archivo exportado funciona como un modelo YOLO estándar y se puede cargar conYOLO()y conYOLOE().Usa YOLOE cuando necesites un rendimiento en tiempo real y puedas nombrar las clases, y SAM 3 cuando la calidad de segmentación de un concepto importe más que la velocidad. Ambos admiten ejemplos visuales; solo YOLOE tiene un modo sin indicaciones. La comparativa completa está en Comparativa de YOLOE.


Comentarios60
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(editado)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(editado)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.