Implementa YOLOv5 con DeepSparse de Neural Magic
Neural Magic fue adquirida por Red Hat en enero de 2025 y dejó de mantener las versiones comunitarias de DeepSparse, SparseML, SparseZoo y Sparsify el 2 de junio de 2025. Las herramientas siguen funcionando, pero ya no reciben actualizaciones ni asistencia. Para acelerar la CPU con soluciones mantenidas, consulta las integraciones de OpenVINO y ONNX.
Esta guía explica cómo desplegar YOLOv5 con DeepSparse de Neural Magic. En el paquete ultralytics, la integración con Neural Magic hace lo mismo.
DeepSparse es un entorno de ejecución de inferencias optimizado para CPU. En los benchmarks siguientes, YOLOv5s podado y cuantizado funciona 5,8 veces más rápido en DeepSparse que el modelo denso en ONNX Runtime, en la misma máquina.
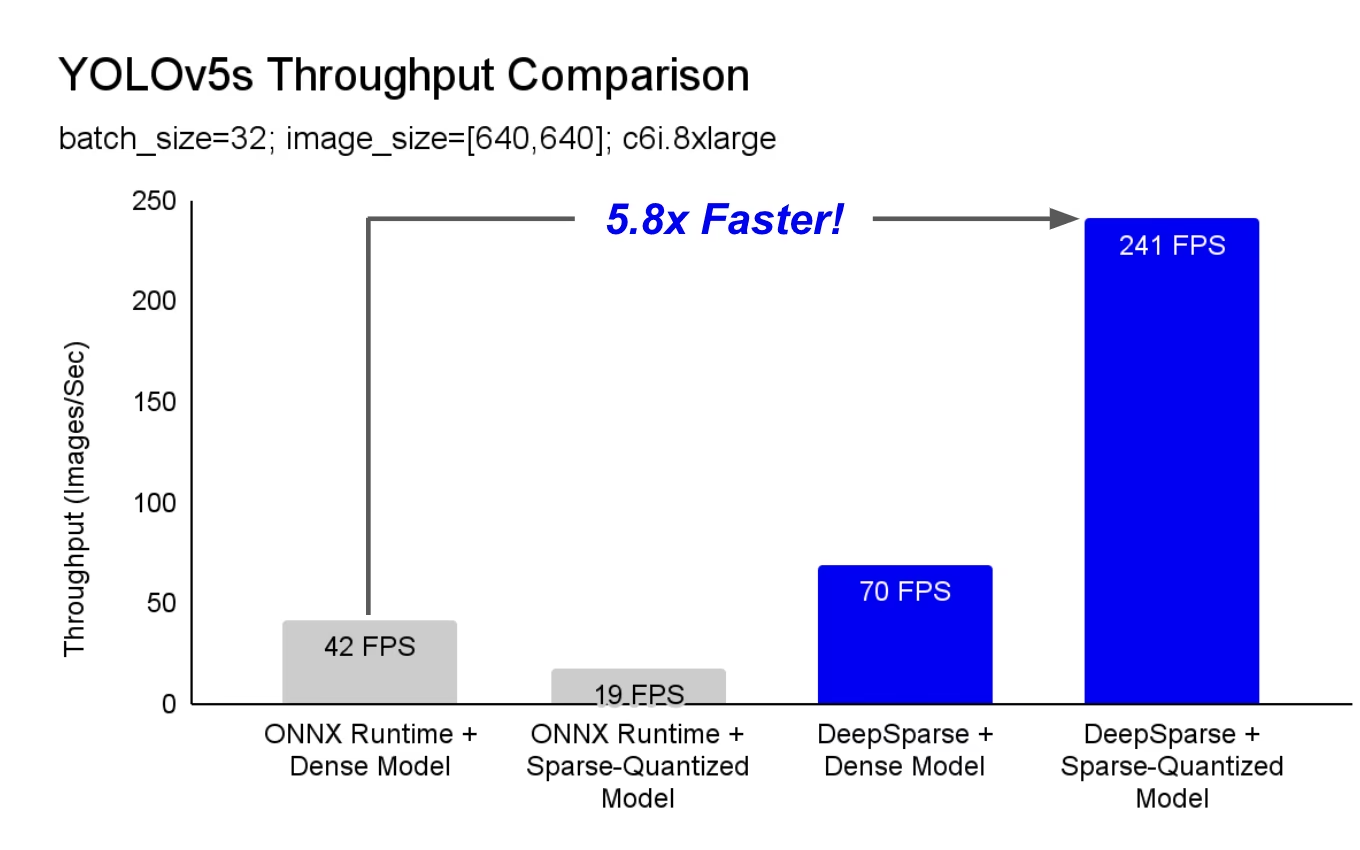
DeepSparse busca que las cargas de trabajo de aprendizaje profundo cumplan los requisitos de rendimiento de producción en CPU, sin la complejidad ni el coste de los aceleradores de hardware dedicados:
- Implementaciones flexibles: Ejecuta tus cargas de trabajo de forma coherente en la nube, el centro de datos y el edge, con cualquier proveedor de hardware, desde Intel hasta AMD o ARM.
- Escalabilidad: escala verticalmente hasta cientos de núcleos, horizontalmente con Kubernetes estándar o con abstracción completa mediante funciones sin servidor.
- Integración sencilla: API para integrar tu modelo en una aplicación y supervisarlo en producción.
¿Cómo consigue DeepSparse un rendimiento comparable al de las GPU?#
DeepSparse aprovecha la dispersión del modelo para acelerar el rendimiento.
La reducción de la dispersión mediante la poda y la cuantización es una técnica ampliamente estudiada que permite reducir en órdenes de magnitud el tamaño y el cálculo necesarios para ejecutar una red, manteniendo una precisión elevada. DeepSparse tiene en cuenta la dispersión, es decir, omite los parámetros puestos a cero y reduce el cálculo en una pasada hacia delante. Como ahora el cálculo disperso está limitado por la memoria, DeepSparse ejecuta la red en profundidad y divide el problema en columnas tensoriales, franjas verticales de cálculo que caben en la caché.
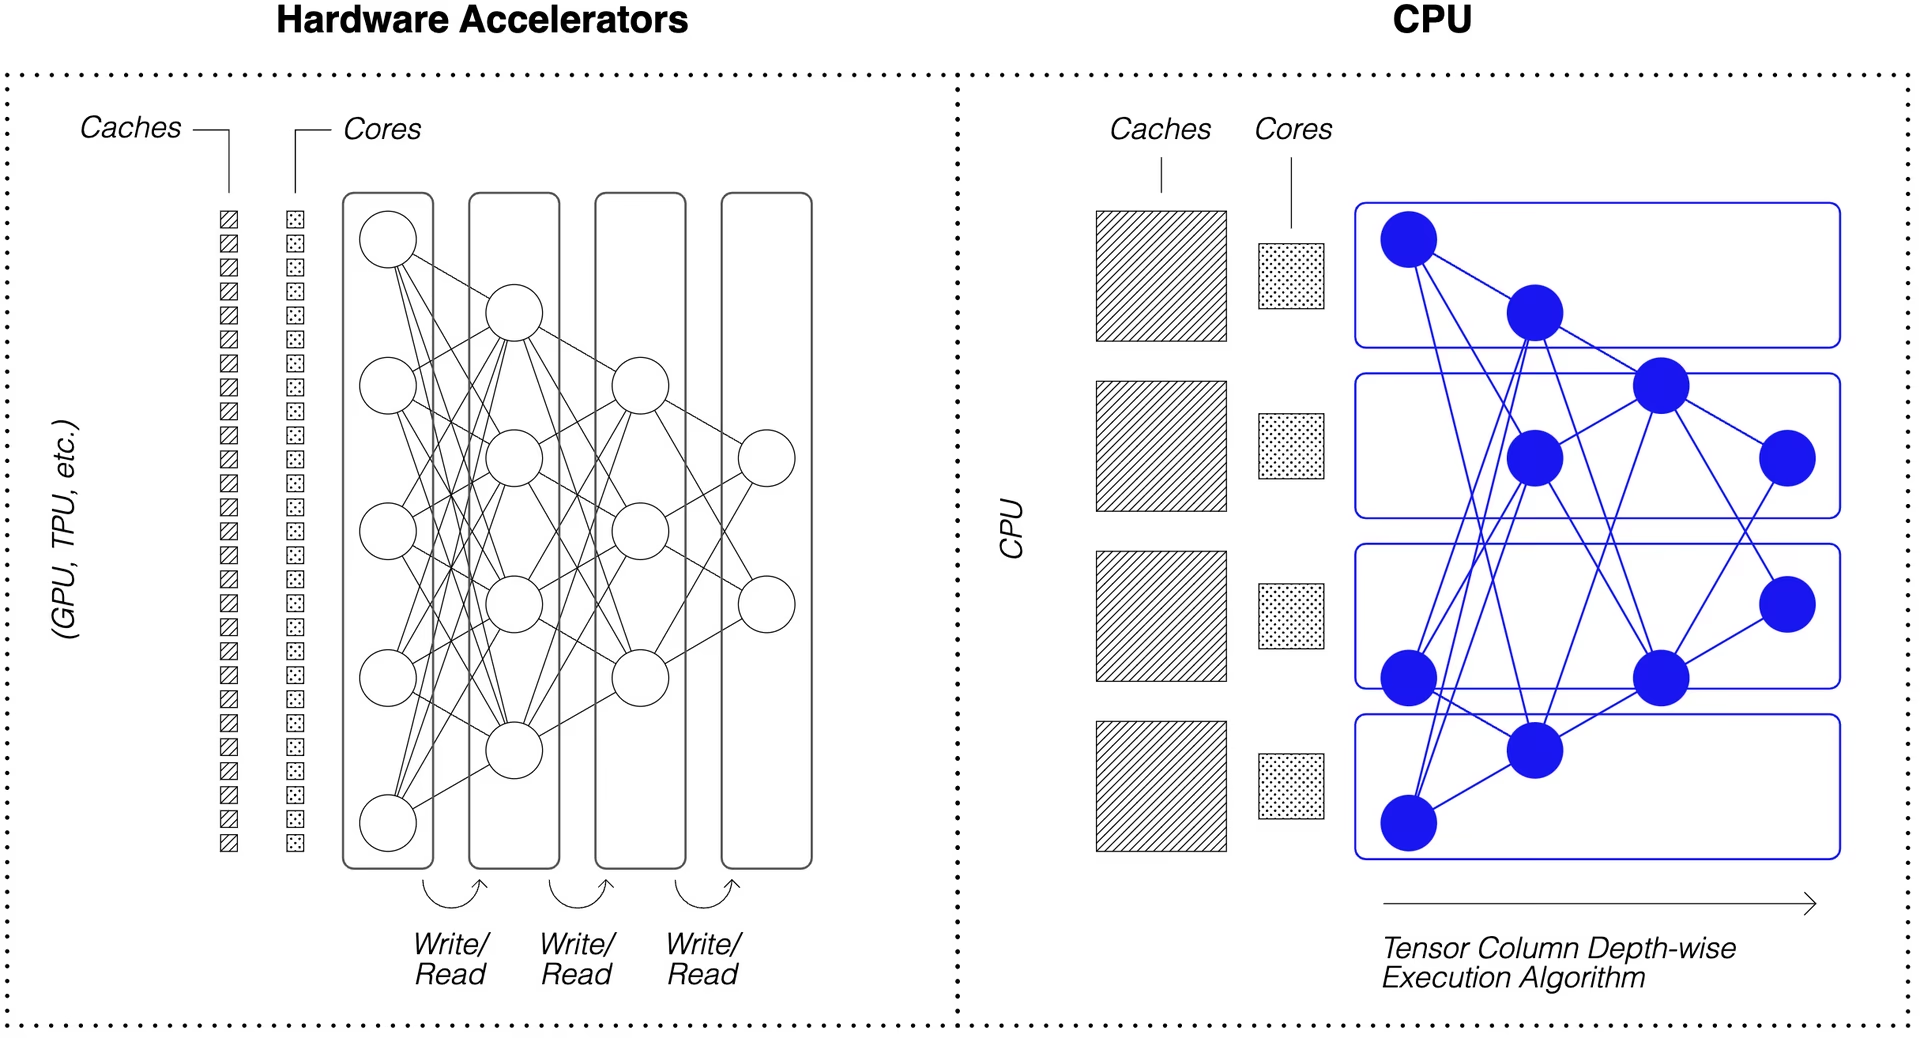
La ejecución en profundidad de redes dispersas en la caché es lo que permite a DeepSparse ofrecer inferencias rápidas en CPU.
¿Cómo puedo crear una versión dispersa de YOLOv5 entrenada con mis datos?#
El repositorio de modelos de código abierto de Neural Magic, SparseZoo, contiene puntos de control predispersificados de cada modelo YOLOv5. Con SparseML, integrado con Ultralytics, puedes ajustar un punto de control disperso con tus datos mediante un único comando de CLI.
Consulta la integración de SparseML con YOLOv5 para obtener más información.
Uso de DeepSparse#
Vamos a ver un ejemplo de evaluación comparativa e implementación de una versión dispersa de YOLOv5s con DeepSparse.
Instalar DeepSparse#
Ejecuta lo siguiente para instalar DeepSparse. Te recomendamos que utilices un entorno virtual con Python.
pip install "deepsparse[server,yolo,onnxruntime]"Recopilar un archivo ONNX#
DeepSparse acepta modelos en formato ONNX, que se pueden proporcionar como:
- Un identificador de SparseZoo que señala a un archivo ONNX en SparseZoo.
- Una ruta local a un modelo ONNX en el sistema de archivos.
Los ejemplos siguientes utilizan los puntos de control estándar denso y podado-cuantizado de YOLOv5s, identificados mediante estos identificadores de SparseZoo:
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Implementar un modelo#
DeepSparse ofrece API prácticas para integrar tu modelo en una aplicación.
Para probar los siguientes ejemplos de implementación, descarga una imagen de muestra y guárdala como basilica.jpg con este comando:
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgAPI de Python#
Pipelines integra el preprocesamiento y el posprocesamiento de las salidas en el entorno de ejecución, lo que proporciona una interfaz sencilla para añadir DeepSparse a una aplicación. La integración de DeepSparse con Ultralytics incluye un Pipeline listo para usar que acepta imágenes sin procesar y genera las cajas delimitadoras.
Crea un Pipeline y ejecuta la inferencia:
from deepsparse import Pipeline

# lista de imágenes en el sistema de archivos local
images = ["basilica.jpg"]

# crear Pipeline
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# ejecutar inferencia en imágenes y recibir cajas delimitadoras + clases
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
Si ejecutas el código en la nube, puede aparecer un error indicando que OpenCV no encuentra libGL.so.1. Puedes instalar la biblioteca que falta:
apt-get install libgl1También puedes usar la compilación de OpenCV sin interfaz gráfica, que evita por completo las dependencias de GUI:
pip install opencv-python-headlessServidor HTTP#
DeepSparse Server se ejecuta sobre FastAPI, el popular framework web, y Uvicorn, el servidor web. Con un solo comando de CLI, puedes configurar un endpoint de servicio de modelos con DeepSparse. El servidor admite cualquier Pipeline de DeepSparse, incluida la detección de objetos con YOLOv5, lo que te permite enviar imágenes sin procesar al endpoint y recibir las cajas delimitadoras.
Inicia el servidor con YOLOv5s podado y cuantizado:
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Ejemplo de solicitud con el paquete requests de Python:
import json
from contextlib import ExitStack

import requests

# lista de imágenes para la inferencia (archivos locales en el cliente)
path = ["basilica.jpg"]

# enviar una solicitud HTTP al endpoint /predict/from_files
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# la respuesta se devuelve en JSON
annotations = json.loads(resp.text)  # diccionario de resultados de anotación
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]
CLI de anotación#
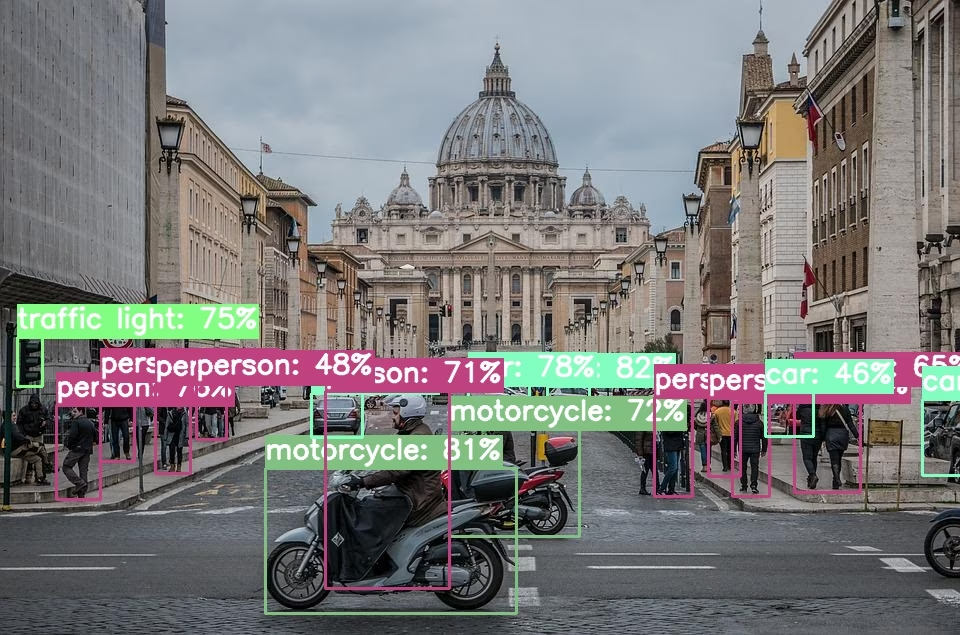
También puedes usar el comando annotate para que el motor guarde una foto anotada en el disco. Prueba --source 0 para anotar la imagen en directo de tu cámara web.
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpgAl ejecutar el comando anterior, se creará una carpeta annotation-results y se guardará dentro la imagen anotada.
Evaluación del rendimiento#
Compararemos el rendimiento de DeepSparse con el de ONNX Runtime en YOLOv5s mediante el script de evaluación de DeepSparse.
Las pruebas se ejecutaron en una instancia de AWS c6i.8xlarge (16 núcleos).
Comparación del rendimiento con lote de 32#
Referencia de ONNX Runtime#
Con un lote de 32, ONNX Runtime alcanza 42 imágenes/s con el YOLOv5s denso estándar:
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
Rendimiento de DeepSparse en modelos densos#
Aunque DeepSparse ofrece su mejor rendimiento con modelos dispersos optimizados, también funciona bien con el YOLOv5s denso estándar.
Con un lote de 32, DeepSparse alcanza 70 imágenes por segundo con YOLOv5s denso estándar: una mejora de 1,7 veces frente a ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
Rendimiento de DeepSparse en modelos dispersos#
Cuando se aplica dispersidad al modelo, las mejoras de rendimiento de DeepSparse con respecto a ONNX Runtime son aún mayores.
Con un lote de 32, DeepSparse alcanza 241 imágenes por segundo con YOLOv5s podado y cuantizado: una mejora de 5,8 veces frente a ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
Comparación del rendimiento con lote de 1#
DeepSparse también puede superar en velocidad a ONNX Runtime en situaciones con lote de 1, donde la latencia es crítica.
Referencia de ONNX Runtime#
Con un lote de 1, ONNX Runtime alcanza 48 imágenes/s con el YOLOv5s denso estándar.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
Rendimiento de DeepSparse en modelos dispersos#
Con un lote de 1, DeepSparse alcanza 135 elementos por segundo con YOLOv5s podado y cuantizado: una mejora de 2,8 veces frente a ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
Como las instancias c6i.8xlarge tienen instrucciones VNNI, se puede aumentar aún más el rendimiento de DeepSparse si se podan los pesos en bloques de 4.
Con un lote de 1, DeepSparse alcanza 180 elementos por segundo con YOLOv5s podado y cuantizado con 4 bloques: una mejora de 3,7 veces frente a ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
Empieza a usar DeepSparse#
¿Investigación o pruebas? DeepSparse Community es gratuito para investigación y pruebas. Empieza con el README de DeepSparse.
Para obtener más información sobre cómo implementar YOLOv5 con DeepSparse, consulta los ejemplos de DeepSparse con YOLOv5 y la publicación del blog de Ultralytics sobre la integración de DeepSparse.
Preguntas frecuentes#
No. DeepSparse es un entorno de ejecución para CPU, y las pruebas anteriores se midieron en una instancia de AWS
c6i.8xlargede 16 núcleos sin ningún acelerador.Expórtalo a ONNX con
python export.py --weights best.pt --include onnxy pasa la ruta del archivo comomodel_pathen lugar de un identificador de SparseZoo. Los modelos densos también se benefician del entorno de ejecución, y los modelos podados y cuantizados son los que más ganan.Ajusta uno de los puntos de control de SparseZoo predispersionados con tus datos mediante SparseML, que conserva la estructura de dispersidad durante el entrenamiento, y luego expórtalo a ONNX.
No. Las versiones de la comunidad dejaron de tener soporte el 2 de junio de 2025 y los paquetes de PyPI están congelados. Los flujos de trabajo existentes siguen funcionando, pero para las nuevas implementaciones conviene considerar las opciones de OpenVINO o ONNX Runtime, que se mantienen activamente.


Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.