Arquitectura de Ultralytics YOLOv5#
YOLOv5 (v6.0/6.1) es un potente algoritmo de detección de objetos desarrollado por Ultralytics. En este artículo analizamos en profundidad la arquitectura de YOLOv5, las estrategias de aumento de datos, las metodologías de entrenamiento y las técnicas de cálculo de la pérdida. Comprender todo esto te ayudará a mejorar la aplicación práctica de la detección de objetos en diversos ámbitos, como la vigilancia, los vehículos autónomos y el reconocimiento de imágenes.
1. Estructura del modelo#
La arquitectura de YOLOv5 consta de tres partes principales:
- Columna vertebral: es el cuerpo principal de la red. En YOLOv5, la columna vertebral se basa en la estructura
CSPDarknet53, una modificación de la arquitectura Darknet utilizada en versiones anteriores. - Cuello: esta parte conecta la columna vertebral con la cabeza. YOLOv5 utiliza las estructuras
SPPF(Spatial Pyramid Pooling - Fast) yPANet(Path Aggregation Network). - Cabeza: esta parte se encarga de generar la salida final. Para ello, YOLOv5 utiliza
YOLOv3 Head.
La estructura del modelo se muestra en la siguiente imagen. Puedes consultar los detalles de la estructura del modelo en models/yolov5l.yaml.
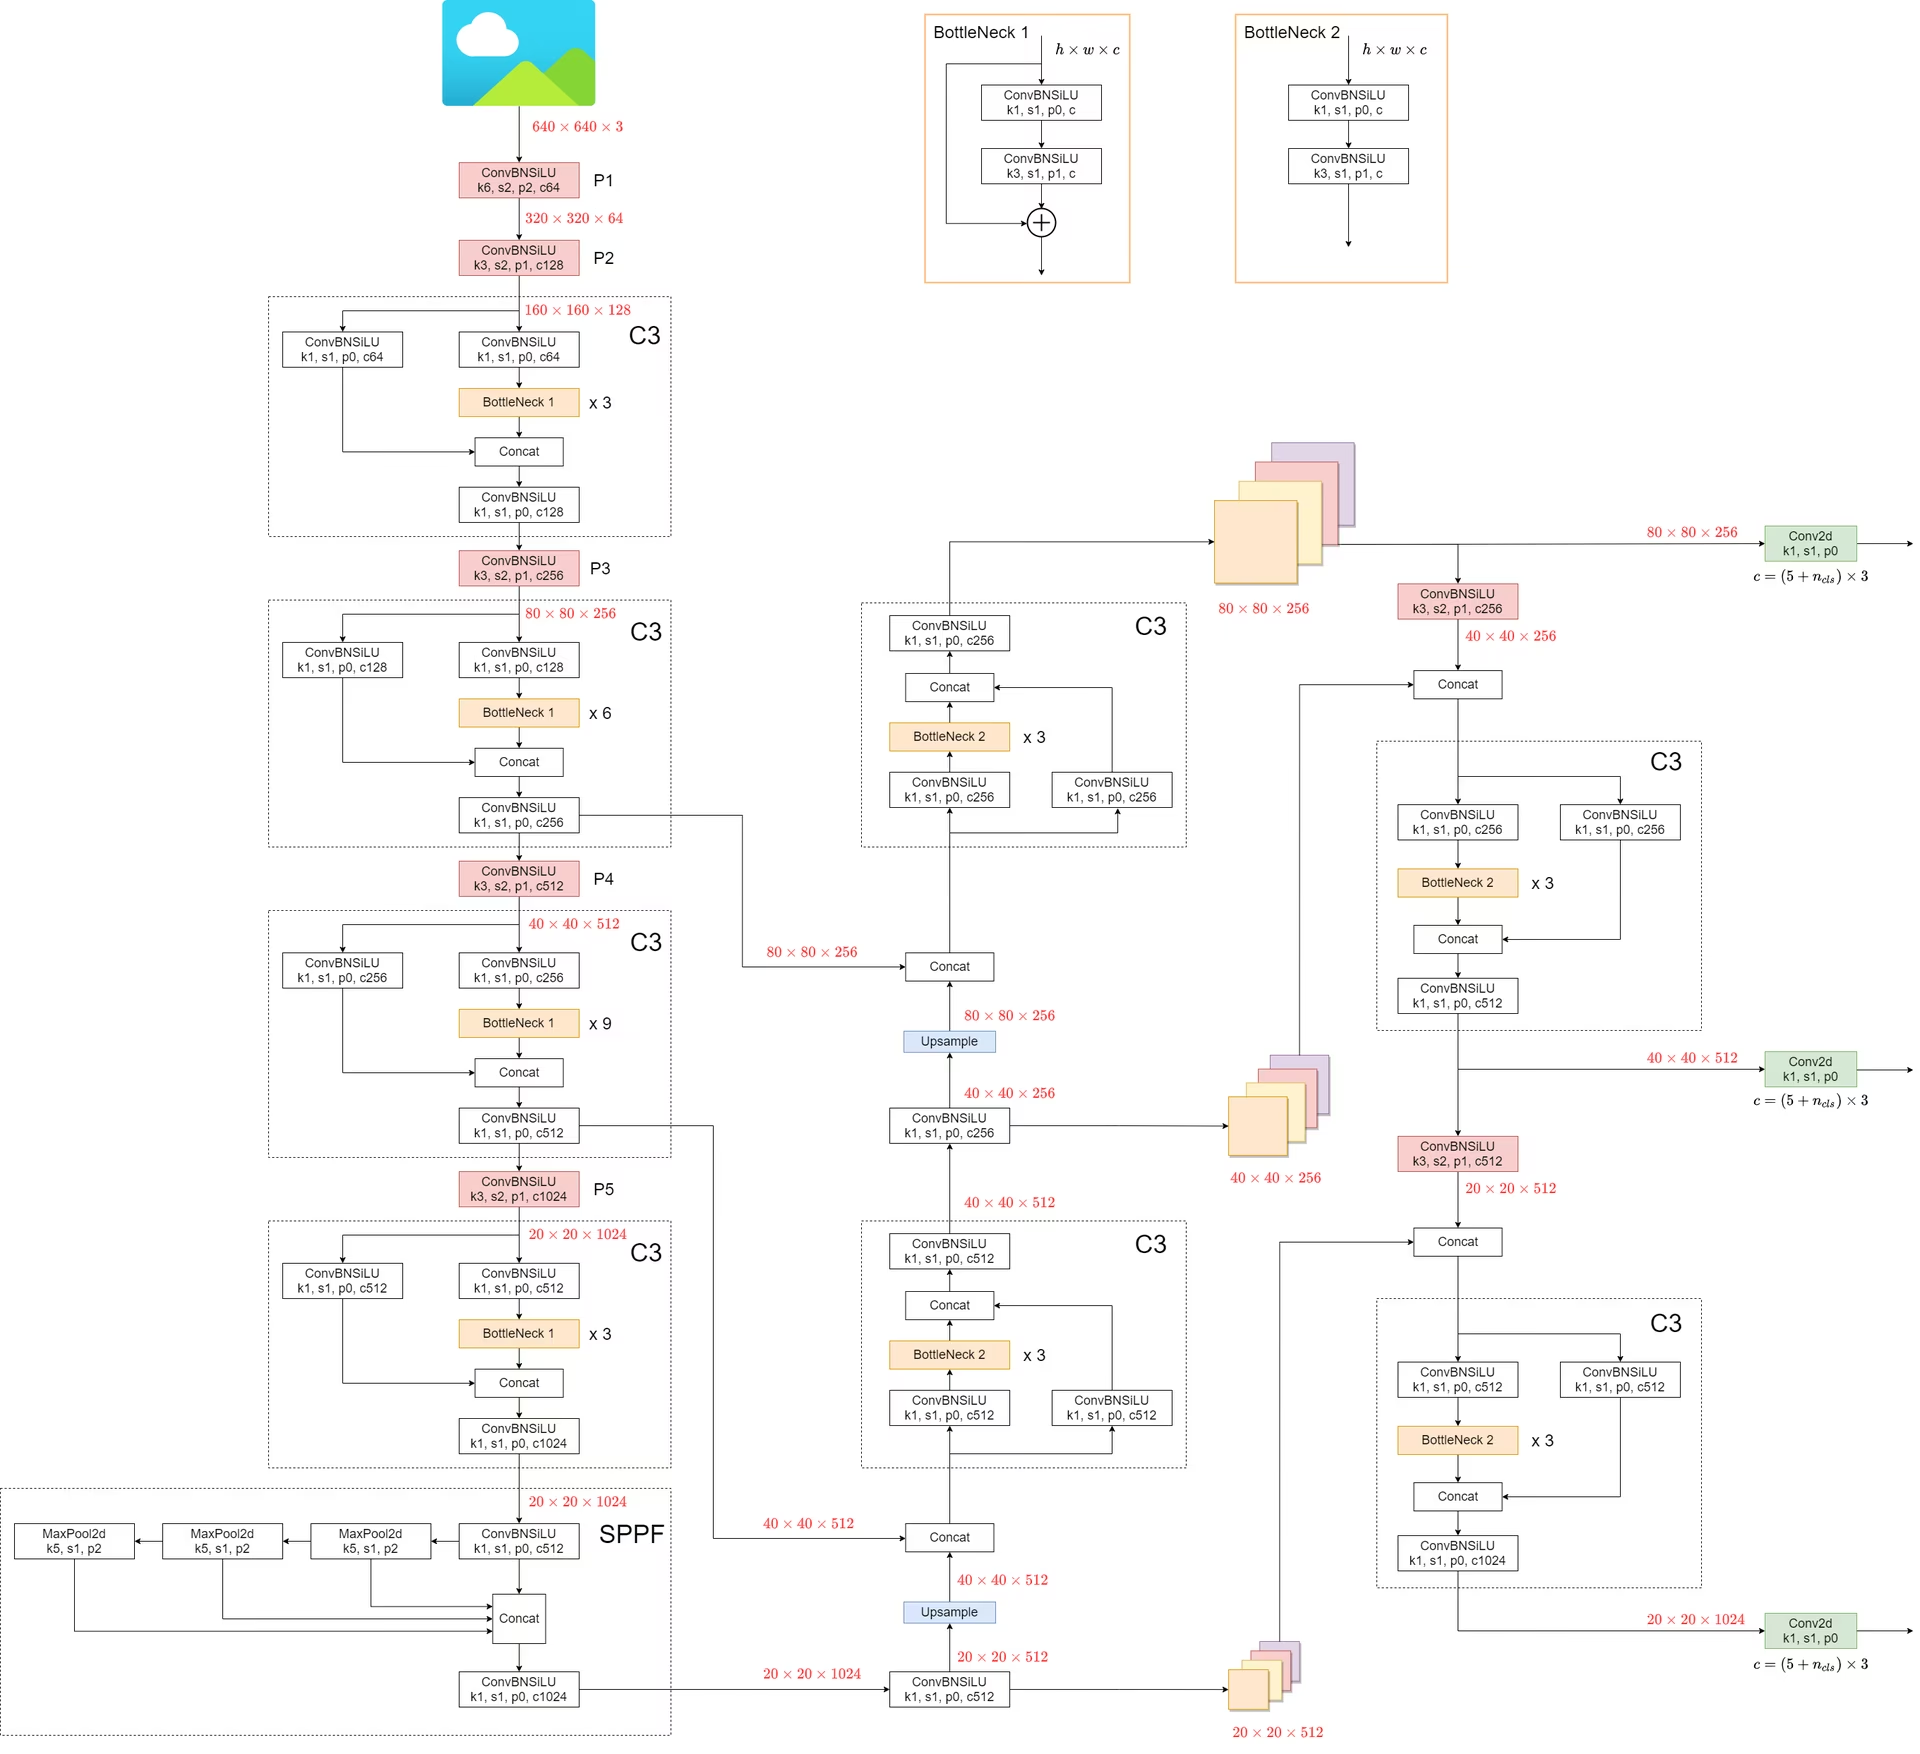
YOLOv5 incorpora varias mejoras destacables con respecto a sus predecesores:
- La estructura
Focus, presente en versiones anteriores, se sustituye por una estructura6x6 Conv2d. Este cambio mejora la eficiencia #4825. - La estructura
SPPse sustituye porSPPF. Este cambio duplica con creces la velocidad de procesamiento y mantiene la misma salida.
Para probar la velocidad de SPP y SPPF, puedes usar el siguiente código:
Ejemplo de perfilado de velocidad: SPP frente a SPPF (haz clic para abrir)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
resultado:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Técnicas de aumento de datos#
YOLOv5 utiliza diversas técnicas de aumento de datos para mejorar la capacidad de generalización del modelo y reducir el sobreajuste. Entre ellas se incluyen:
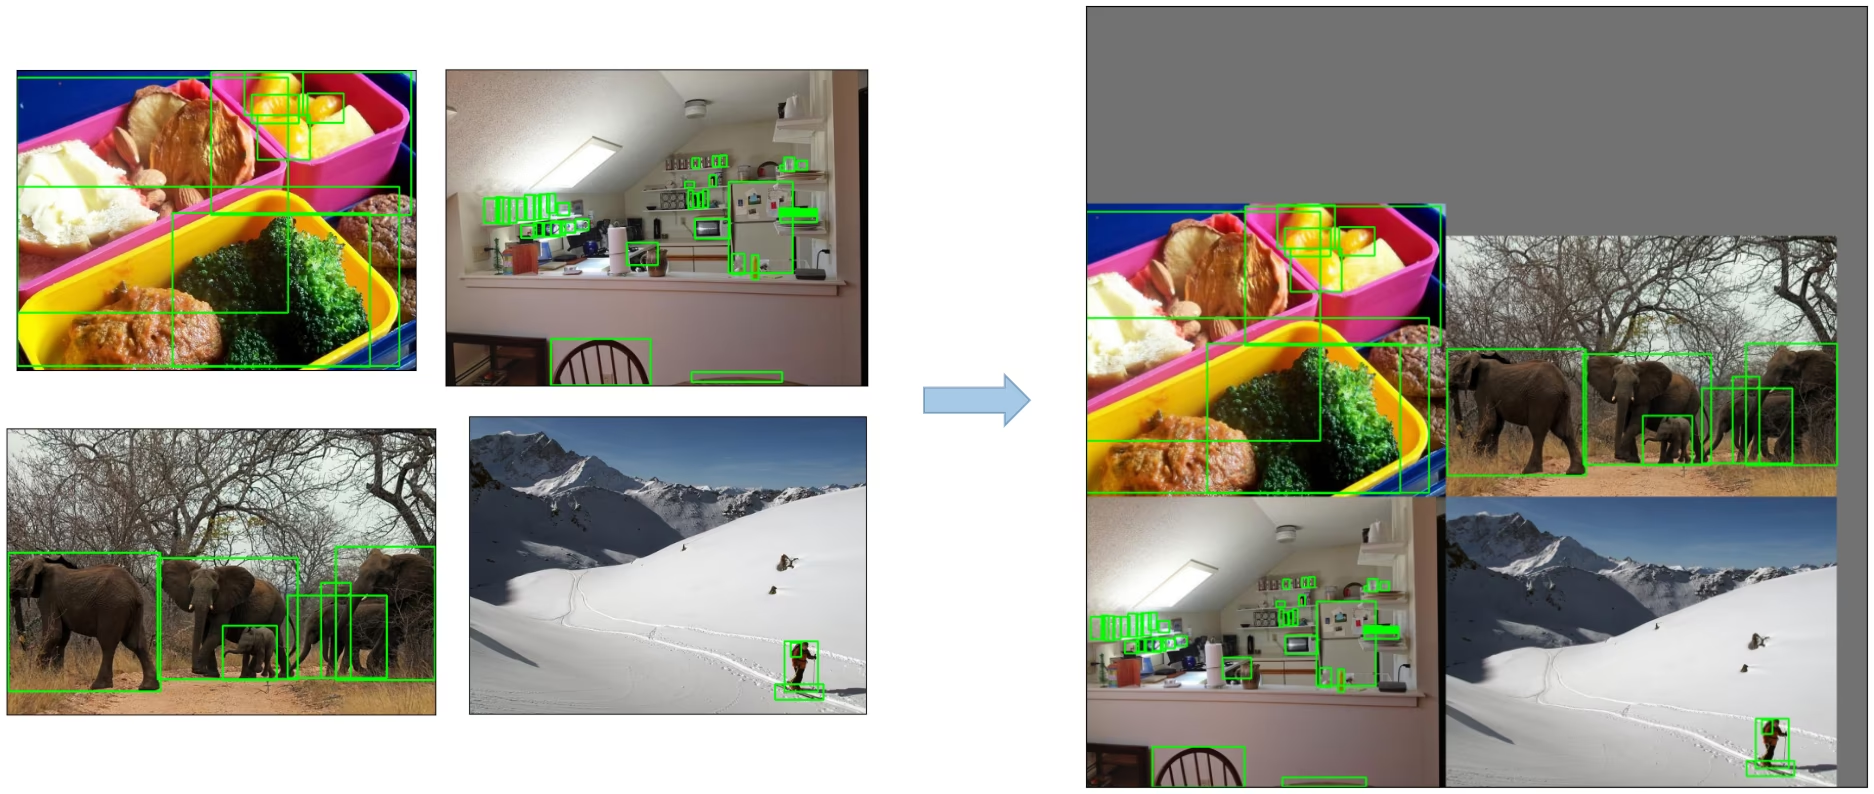
-
Aumento Mosaic: técnica de procesamiento de imágenes que combina cuatro imágenes de entrenamiento en una para ayudar a los modelos de detección de objetos a gestionar mejor distintas escalas y traslaciones de objetos.
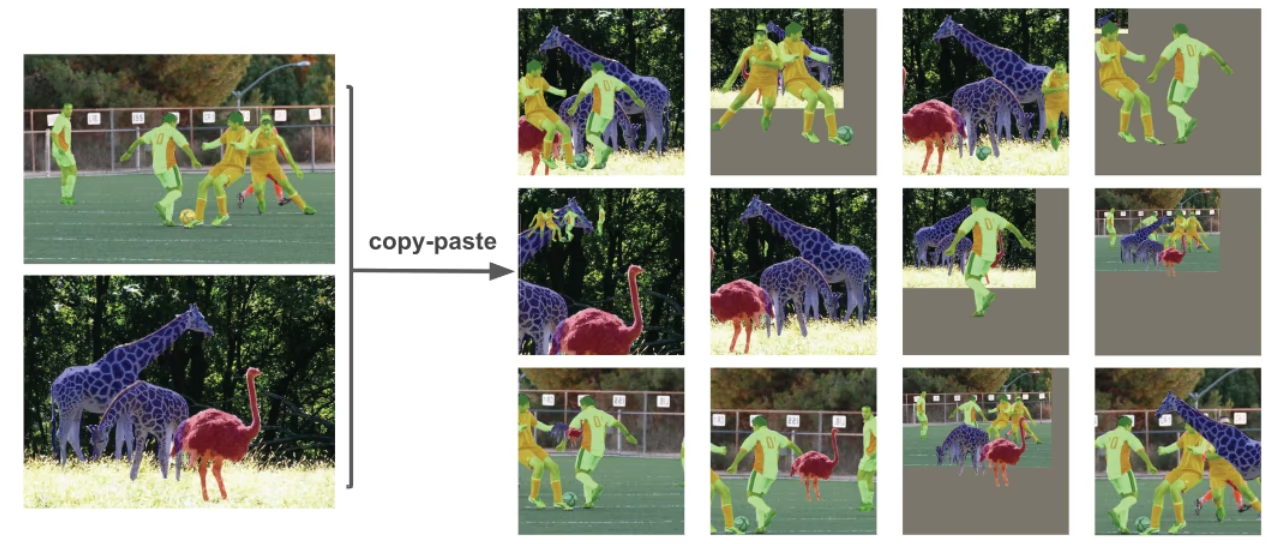
-
Aumento Copy-Paste: método innovador de aumento de datos que copia recortes aleatorios de una imagen y los pega en otra imagen elegida al azar, generando así una nueva muestra de entrenamiento.
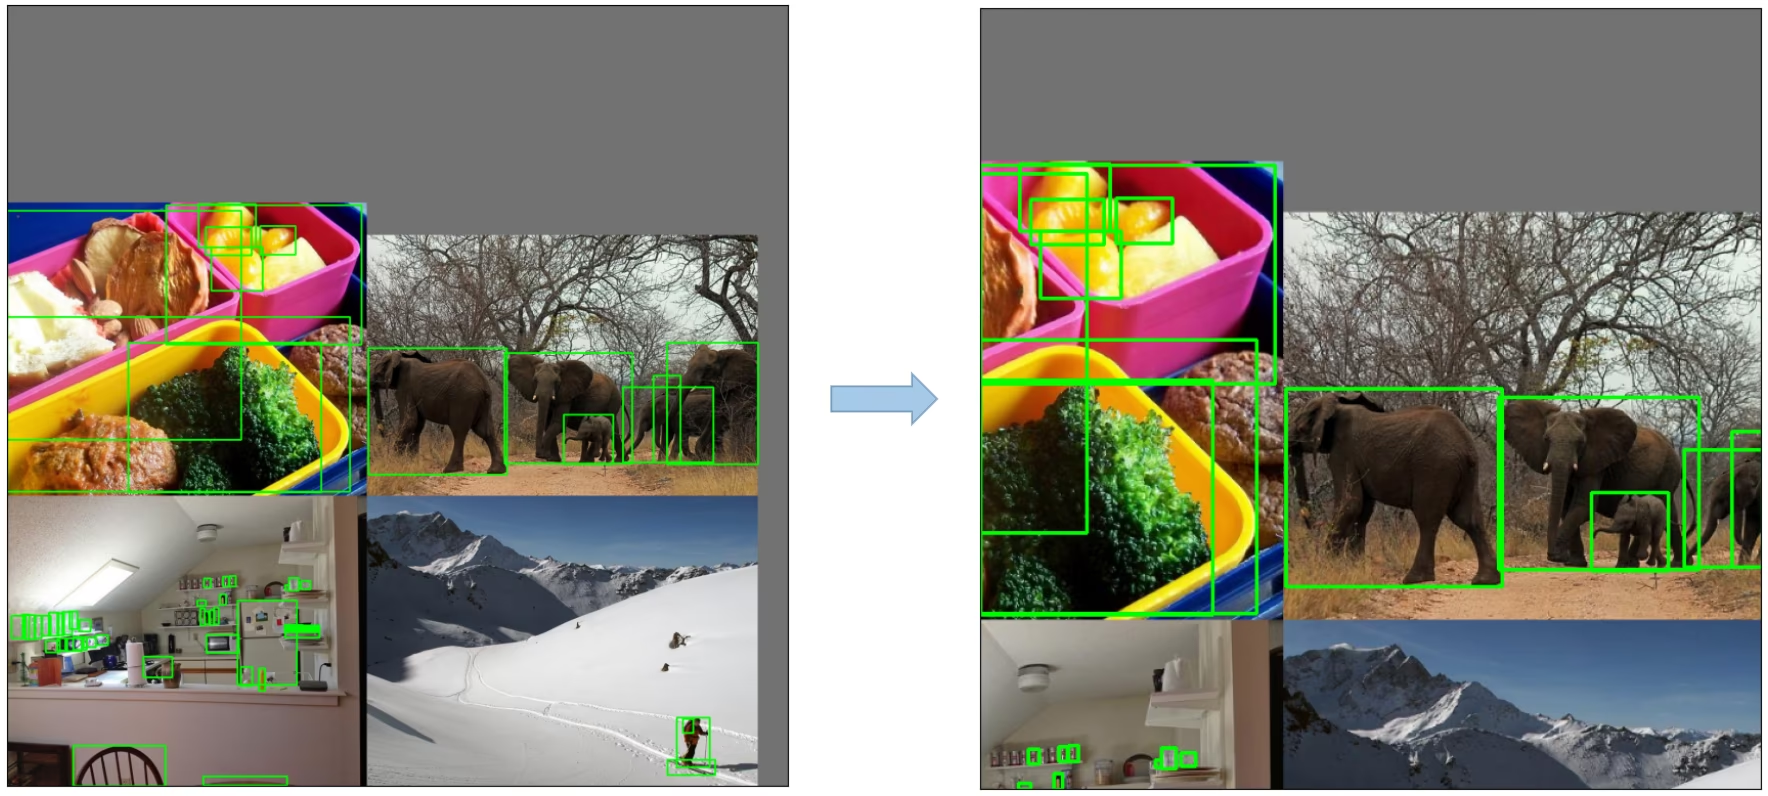
-
Transformaciones afines aleatorias: incluyen rotación, escalado, traslación y cizallamiento aleatorios de las imágenes.
-
Aumento MixUp: método que crea imágenes compuestas mediante una combinación lineal de dos imágenes y sus etiquetas correspondientes.
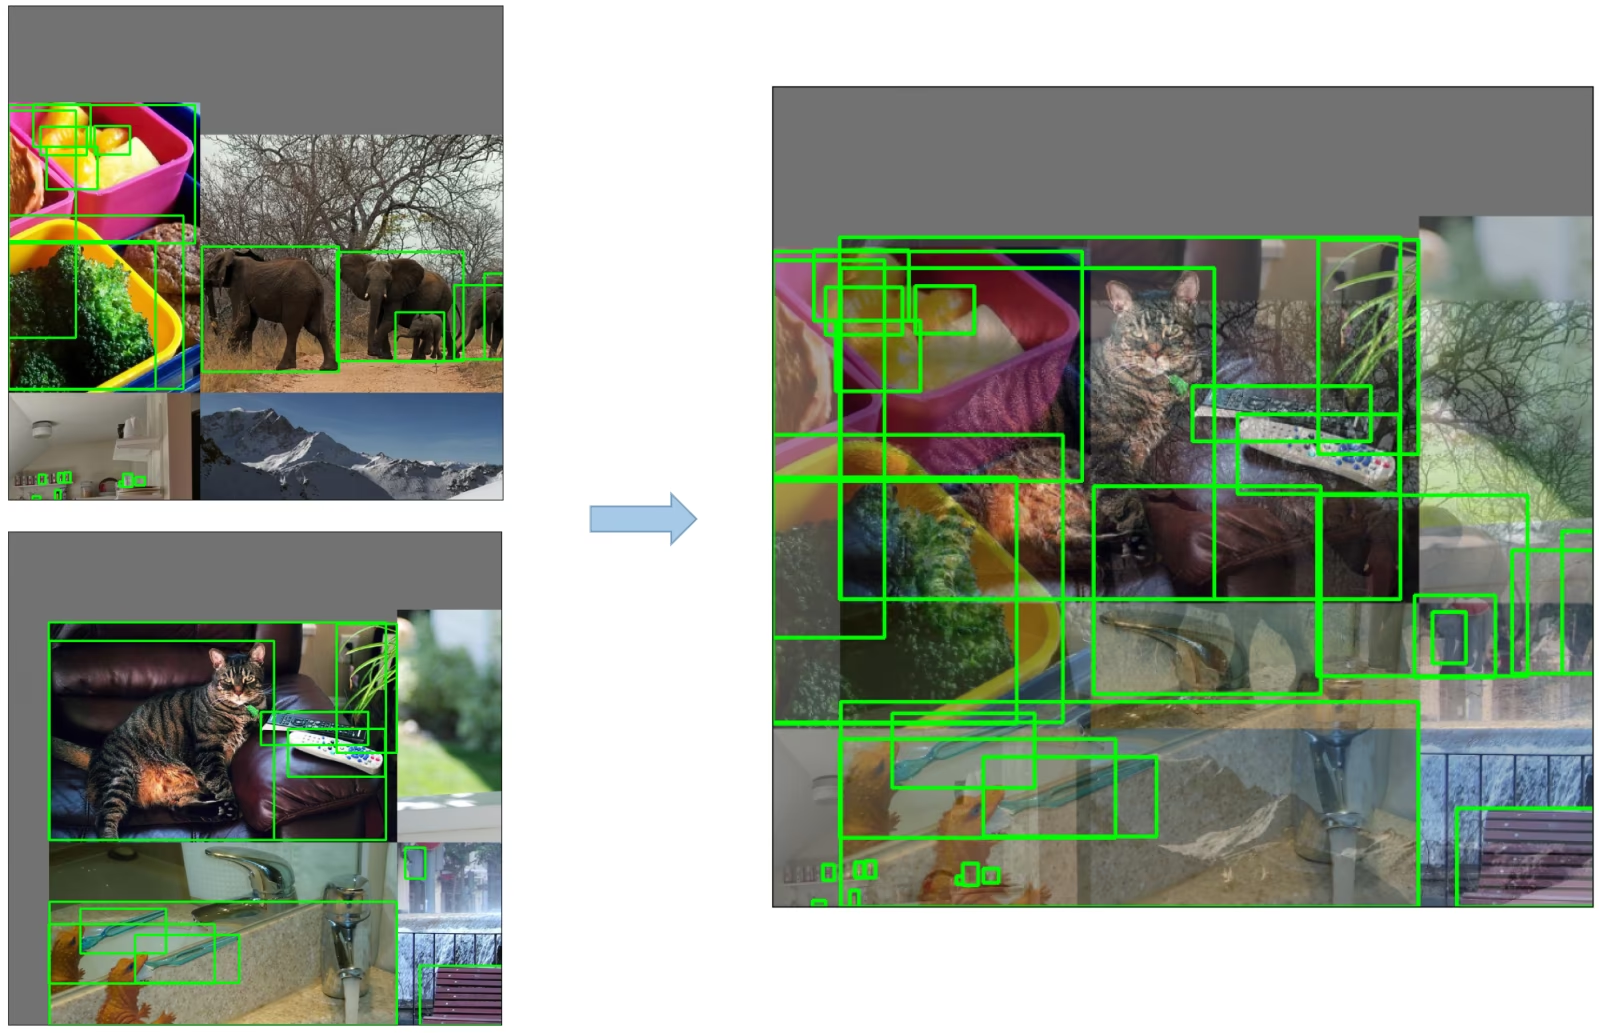
-
Albumentations: potente biblioteca de aumento de imágenes que admite una gran variedad de técnicas de aumento. Descubre más sobre cómo usar los aumentos de Albumentations.
-
Aumento HSV: cambios aleatorios en el tono, la saturación y el valor de las imágenes.
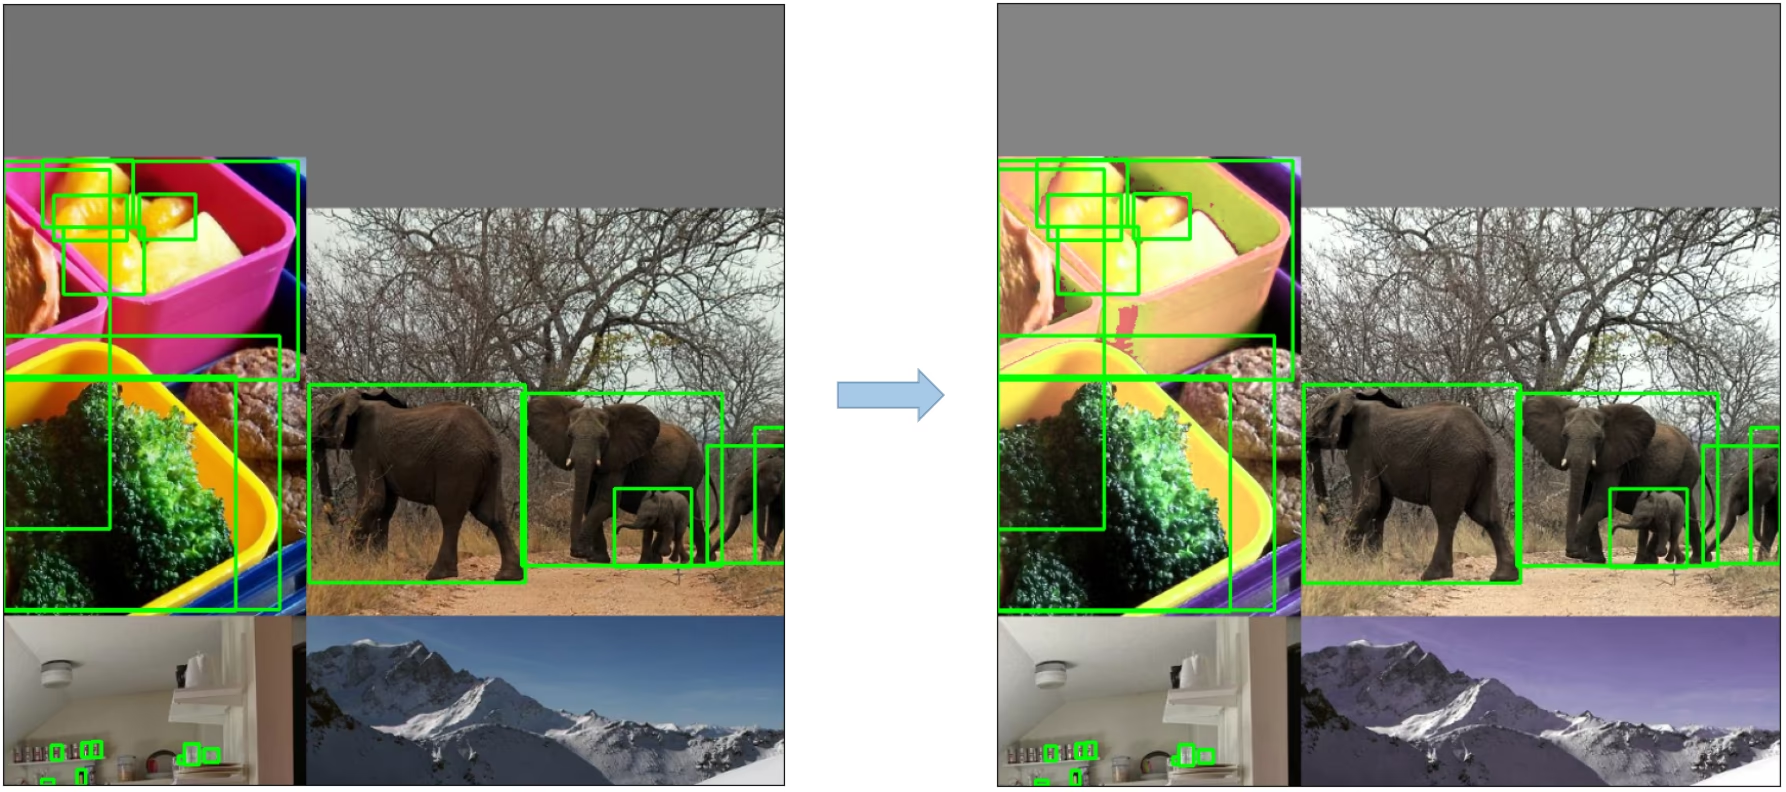
-
Volteo horizontal aleatorio: método de aumento que voltea aleatoriamente las imágenes en horizontal.
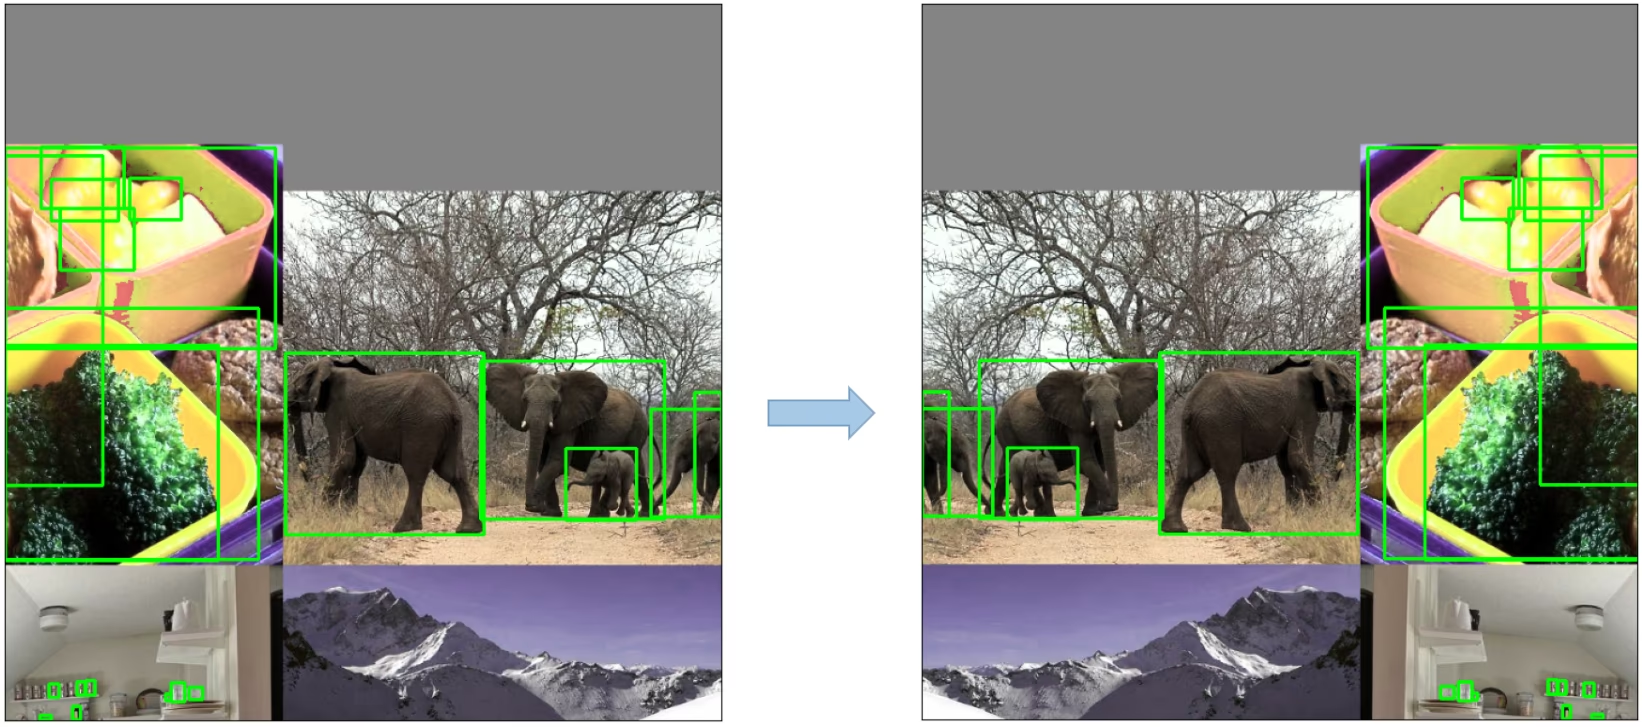
3. Estrategias de entrenamiento#
YOLOv5 aplica varias estrategias de entrenamiento sofisticadas para mejorar el rendimiento del modelo. Entre ellas se incluyen:
- Entrenamiento multiescala: durante el entrenamiento, las imágenes de entrada se reescalan aleatoriamente entre 0,5 y 1,5 veces su tamaño original.
- AutoAnchor: Esta estrategia optimiza las cajas de anclaje previas para que coincidan con las características estadísticas de las cajas de referencia de tus datos personalizados.
- Programador de calentamiento y tasa de aprendizaje coseno: Un método para ajustar la tasa de aprendizaje y mejorar el rendimiento del modelo.
- Media móvil exponencial (EMA): Una estrategia que utiliza la media de los parámetros de pasos anteriores para estabilizar el proceso de entrenamiento y reducir el error de generalización.
- Entrenamiento de precisión mixta: Un método para realizar operaciones en formato de media precisión, que reduce el uso de memoria y aumenta la velocidad de cálculo.
- Evolución de hiperparámetros: Una estrategia para ajustar automáticamente los hiperparámetros y lograr un rendimiento óptimo. Consulta el tutorial de evolución de hiperparámetros.
4. Funcionalidades adicionales#
4.1 Calcular las pérdidas#
La pérdida en YOLOv5 se calcula como una combinación de tres componentes individuales:
- Pérdida de clases (pérdida BCE): La pérdida de entropía cruzada binaria mide el error de la tarea de clasificación.
- Pérdida de objetualidad (pérdida BCE): Otra pérdida de entropía cruzada binaria que calcula el error al detectar si hay un objeto en una celda de la cuadrícula concreta.
- Pérdida de localización (pérdida CIoU): La pérdida de IoU completa mide el error al localizar el objeto dentro de la celda de la cuadrícula.
La función de pérdida global se representa así:
4.2 Equilibrar las pérdidas#
Las pérdidas de objetualidad de las tres capas de predicción (P3, P4, P5) tienen pesos distintos. Los pesos de equilibrio son, respectivamente, [4.0, 1.0, 0.4]. Este enfoque garantiza que las predicciones a distintas escalas contribuyan adecuadamente a la pérdida total.
4.3 Eliminar la sensibilidad a la cuadrícula#
La arquitectura de YOLOv5 introduce cambios importantes en la estrategia de predicción de cajas respecto a versiones anteriores de YOLO. En YOLOv2 y YOLOv3, las coordenadas de las cajas se predecían directamente mediante la activación de la última capa.

Sin embargo, en YOLOv5 se ha actualizado la fórmula para predecir las coordenadas de las cajas con el fin de reducir la sensibilidad a la cuadrícula y evitar que el modelo prediga dimensiones de caja ilimitadas.
Las fórmulas revisadas para calcular la caja delimitadora predicha son las siguientes:
Compara el desplazamiento del punto central antes y después del escalado. El intervalo del desplazamiento del punto central se ajusta de (0, 1) a (-0.5, 1.5). Así, el desplazamiento puede ser fácilmente 0 o 1.

Compara la proporción de escalado de la altura y la anchura (con respecto al anclaje) antes y después del ajuste. Las ecuaciones originales de las cajas de yolo/darknet tienen un defecto grave. La anchura y la altura no tienen ningún límite, ya que se calculan simplemente como out=exp(in), lo que resulta peligroso porque puede provocar gradientes descontrolados, inestabilidad, pérdidas NaN y, en última instancia, la pérdida completa del entrenamiento. Consulta este problema para obtener más información.

4.4 Crear los objetivos#
El proceso de creación de objetivos en YOLOv5 es fundamental para la eficiencia del entrenamiento y la precisión del modelo. Consiste en asignar las cajas de referencia a las celdas de cuadrícula adecuadas del mapa de salida y emparejarlas con las cajas de anclaje correspondientes.
El proceso sigue estos pasos:
- Calcula la proporción entre las dimensiones de la caja de referencia y las dimensiones de cada plantilla de anclaje.

- Si la proporción calculada está dentro del umbral, empareja la caja de referencia con el anclaje correspondiente.

- Asigna el anclaje emparejado a las celdas adecuadas. Ten en cuenta que, debido al desplazamiento revisado del punto central, una caja de referencia puede asignarse a más de un anclaje, ya que el intervalo del desplazamiento del punto central se ajusta de (0, 1) a (-0.5, 1.5), lo que permite realizar coincidencias adicionales.

De este modo, el proceso de creación de objetivos garantiza que cada objeto de referencia se asigne y empareje correctamente durante el entrenamiento, lo que permite a YOLOv5 aprender la tarea de detección de objetos con mayor eficacia.
Conclusión#
YOLOv5 supone un avance significativo en la evolución de la detección de objetos en tiempo real. Sus decisiones arquitectónicas, estrategias de entrenamiento y mejoras de ingeniería ofrecen un rendimiento y una eficiencia sólidos en comparación con versiones anteriores de YOLO.
Las principales mejoras de YOLOv5 incluyen el uso de una arquitectura dinámica, una amplia variedad de técnicas de aumento de datos, estrategias de entrenamiento innovadoras, así como importantes ajustes en el cálculo de las pérdidas y el proceso de creación de objetivos. Todas estas innovaciones mejoran significativamente la precisión y la eficiencia de la detección de objetos, al tiempo que mantienen una gran velocidad, característica distintiva de los modelos YOLO.
Preguntas frecuentes#
Una columna vertebral CSPDarknet53 extrae características, un cuello SPPF y PANet las fusiona en distintas escalas y una cabeza de estilo YOLOv3 predice cajas, objetualidad y clases con pasos de 8, 16 y 32. La lista completa de capas está en
models/yolov5l.yaml.SPPF encadena tres operaciones de agrupación máxima de 5x5 en lugar de ejecutar en paralelo las agrupaciones de 5x5, 9x9 y 13x13. La salida es matemáticamente idéntica, pero se ejecuta más del doble de rápido, como muestra el fragmento de perfilado anterior.
El desplazamiento original de YOLO no podía alcanzar exactamente 0 o 1, por lo que era difícil predecir los objetos centrados en los límites de la cuadrícula. Escalar la sigmoide al intervalo (-0.5, 1.5) elimina esa sensibilidad a la cuadrícula, y elevar
2σal cuadrado para la anchura y la altura limita las predicciones a 4 veces el tamaño del anclaje, lo que evita los gradientes descontrolados de la exponencial ilimitada.Cualquier anclaje cuyas proporciones de anchura y altura con respecto a la caja estén dentro de
anchor_t(4.0 de forma predeterminada) coincide, y el intervalo de desplazamiento ampliado también permite asignar la caja a las dos celdas de cuadrícula vecinas. Por tanto, un único objeto puede generar varios objetivos positivos, lo que acelera la convergencia.