Aprendizaje por transferencia con capas congeladas en YOLOv5#
📚 Esta guía explica cómo congelar las capas de YOLOv5 🚀 al aplicar el aprendizaje por transferencia. El aprendizaje por transferencia es una potente técnica de aprendizaje automático (ML) que te permite volver a entrenar rápidamente un modelo con datos nuevos sin tener que entrenar toda la red desde cero. Si congelas los pesos de las capas iniciales y actualizas solo los parámetros de las capas posteriores, puedes reducir considerablemente los recursos computacionales necesarios y el tiempo de entrenamiento. Sin embargo, este método puede afectar ligeramente a la precisión final del modelo.
Antes de empezar#
En primer lugar, clona el repositorio de YOLOv5 e instala las dependencias necesarias que se indican en requirements.txt. Asegúrate de tener instalado un entorno de Python>=3.8.0 con PyTorch>=1.8. Los modelos preentrenados y los conjuntos de datos necesarios se descargarán automáticamente desde la versión más reciente de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
Cómo funciona la congelación de capas#
Al congelar capas de una red neuronal, impides que sus parámetros (pesos y sesgos) se actualicen durante el entrenamiento. En PyTorch, esto se consigue estableciendo el atributo requires_grad de los tensores de la capa en False. Como consecuencia, no se calculan gradientes para estas capas durante la retropropagación, lo que ahorra operaciones y memoria.
Así implementa YOLOv5 la congelación de capas en su script de entrenamiento:
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
        v.requires_grad = False  # Disable gradient calculation for frozen layers
Explorar la arquitectura del modelo#
Comprender la estructura del modelo YOLOv5 es fundamental para decidir qué capas congelar. Puedes inspeccionar los nombres de todos los módulos y sus parámetros con el siguiente fragmento de Python:
# Suponiendo que 'model' es la instancia del modelo YOLOv5 que has cargado
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""
La arquitectura de YOLOv5 suele constar de una columna vertebral (capas 0-9 en configuraciones estándar como YOLOv5s/m/l/x), encargada de la extracción de características, y una cabeza (las capas restantes), que realiza la detección de objetos.
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
    # ... subsequent head layers for feature fusion and detection
Opciones de congelación#
Puedes controlar qué capas se congelan mediante el argumento --freeze del comando de entrenamiento. Este argumento especifica el índice del primer módulo descongelado; los módulos anteriores a este índice tendrán los pesos congelados. Si indicas varios índices en su lugar (por ejemplo, --freeze 0 1 2), se congelarán exactamente esos módulos. Usa model.model (un nn.Sequential) para inspeccionar el orden de los módulos si necesitas confirmar qué índices corresponden a un bloque concreto.
Congelar solo la columna vertebral#
Para congelar toda la columna vertebral (capas 0 a 9), algo habitual al adaptar el modelo a nuevas clases de objetos y conservar las capacidades generales de extracción de características aprendidas a partir de un conjunto de datos grande como COCO:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10Esta estrategia resulta eficaz cuando el conjunto de datos de destino comparte características visuales de bajo nivel (bordes, texturas) con los datos de entrenamiento originales (por ejemplo, COCO), pero contiene categorías de objetos diferentes.
Congelar todo excepto las capas finales de detección#
Para congelar prácticamente toda la red y dejar entrenables solo las capas convolucionales de salida finales (parte del módulo Detect, normalmente el último módulo; por ejemplo, el módulo 24 en YOLOv5s):
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24Este método resulta útil cuando principalmente necesitas adaptar el modelo a un número distinto de clases de salida, manteniendo intacta la gran mayoría de las características aprendidas. Requiere menos recursos computacionales para el ajuste fino.
Comparativa de rendimiento#
Para ilustrar los efectos de congelar capas, entrenamos YOLOv5m con el conjunto de datos Pascal VOC durante 50 épocas, partiendo de los pesos oficiales preentrenados con COCO (yolov5m.pt). Comparamos tres escenarios: entrenar todas las capas (--freeze 0), congelar la columna vertebral (--freeze 10) y congelar todas las capas excepto las capas finales de detección (--freeze 24).
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10
Resultados de precisión#
Los resultados muestran que congelar capas puede acelerar considerablemente el entrenamiento, pero puede reducir ligeramente la mAP (precisión media) final. Entrenar todas las capas suele ofrecer la mejor precisión, mientras que congelar más capas acelera el entrenamiento a costa de un posible descenso del rendimiento.
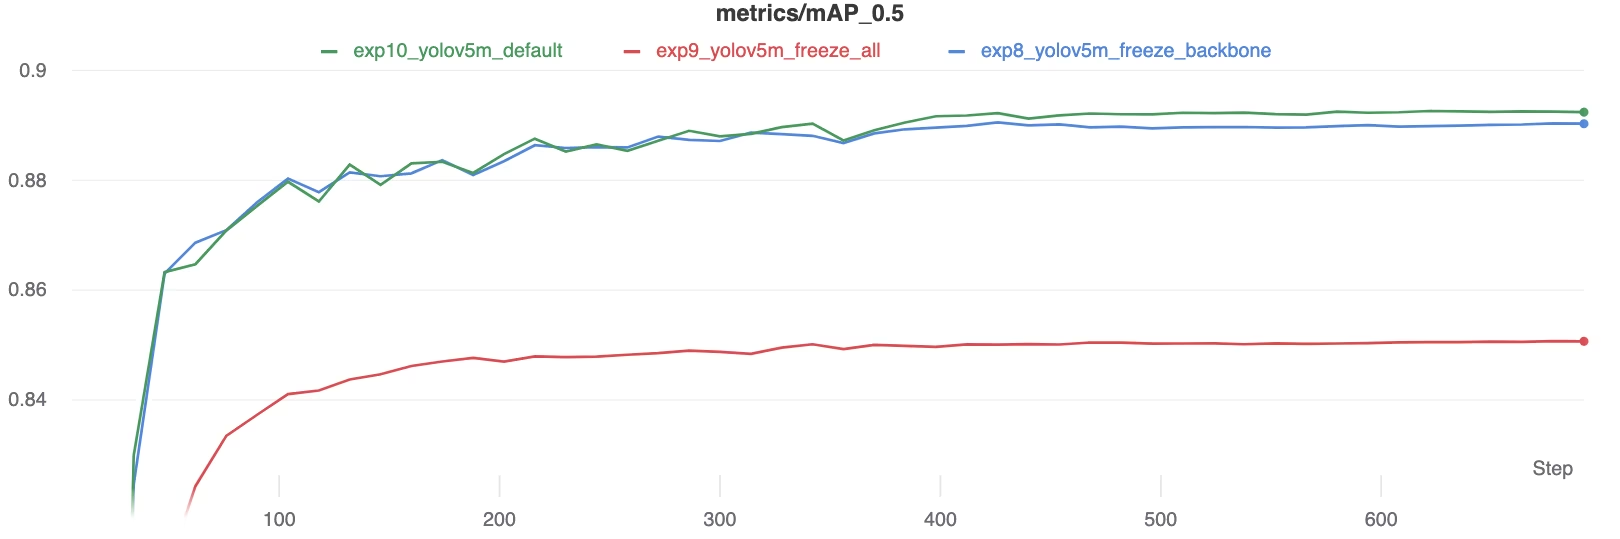 Comparación de mAP50 durante el entrenamiento
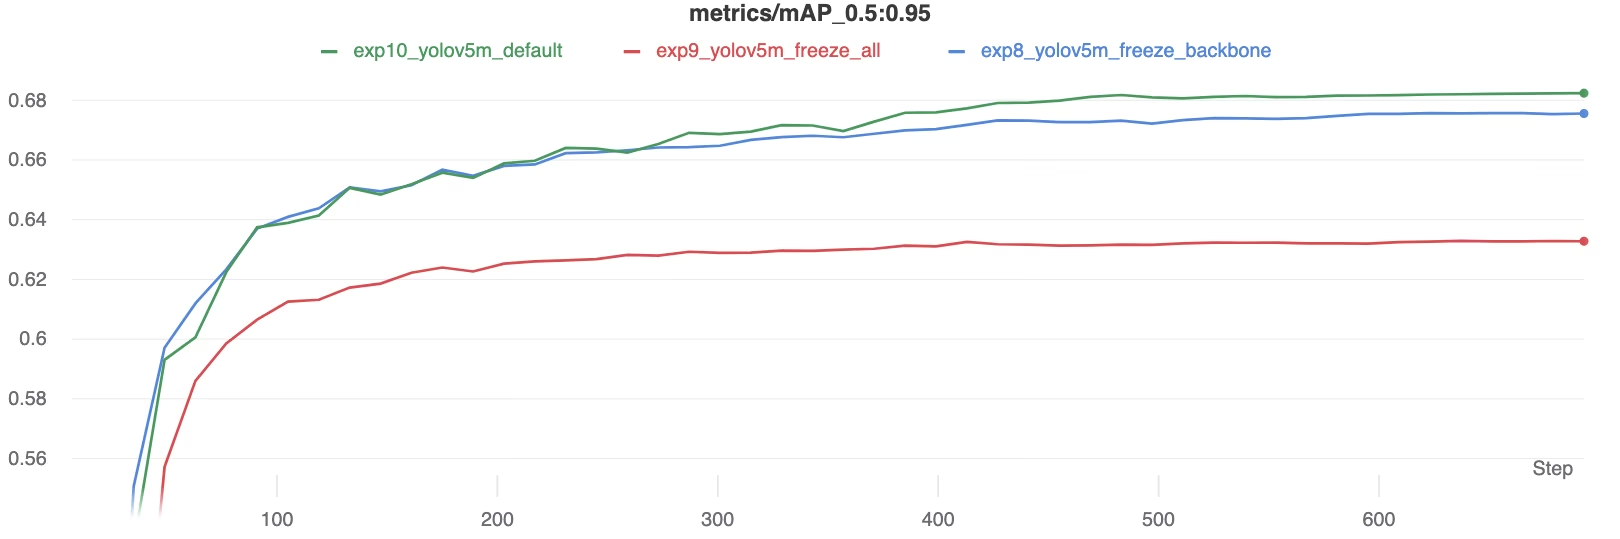 Comparación de mAP50-95 durante el entrenamiento
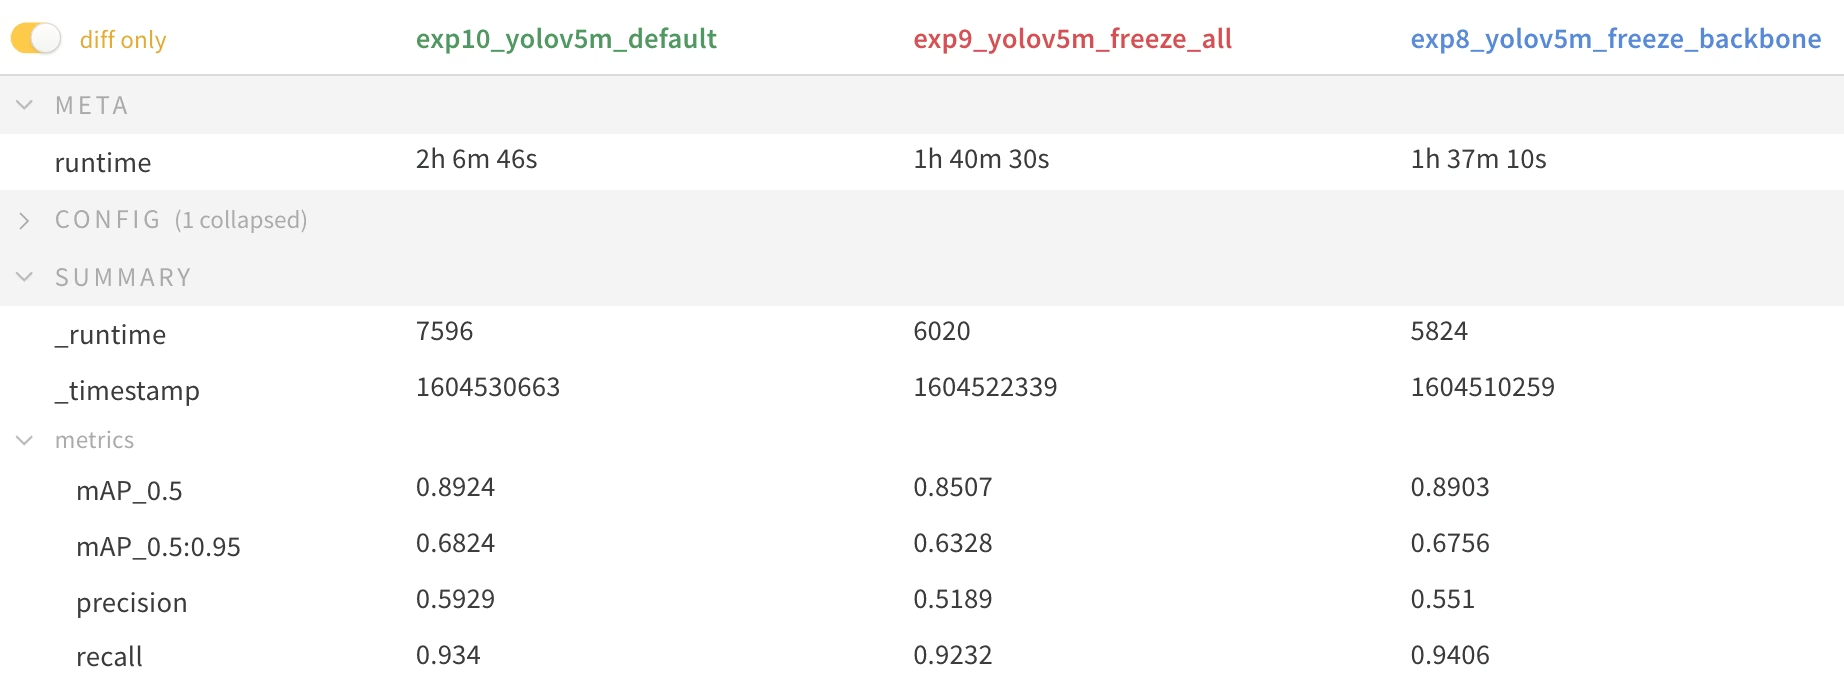 *Tabla resumen de métricas de rendimiento*
Uso de recursos#
Congelar más capas reduce considerablemente los requisitos de memoria de la GPU y el uso total de recursos. Esto hace que el aprendizaje por transferencia con capas congeladas sea una opción atractiva cuando se trabaja con recursos de hardware limitados, ya que permite entrenar modelos más grandes o utilizar imágenes de mayor tamaño de lo que sería posible en otras circunstancias.
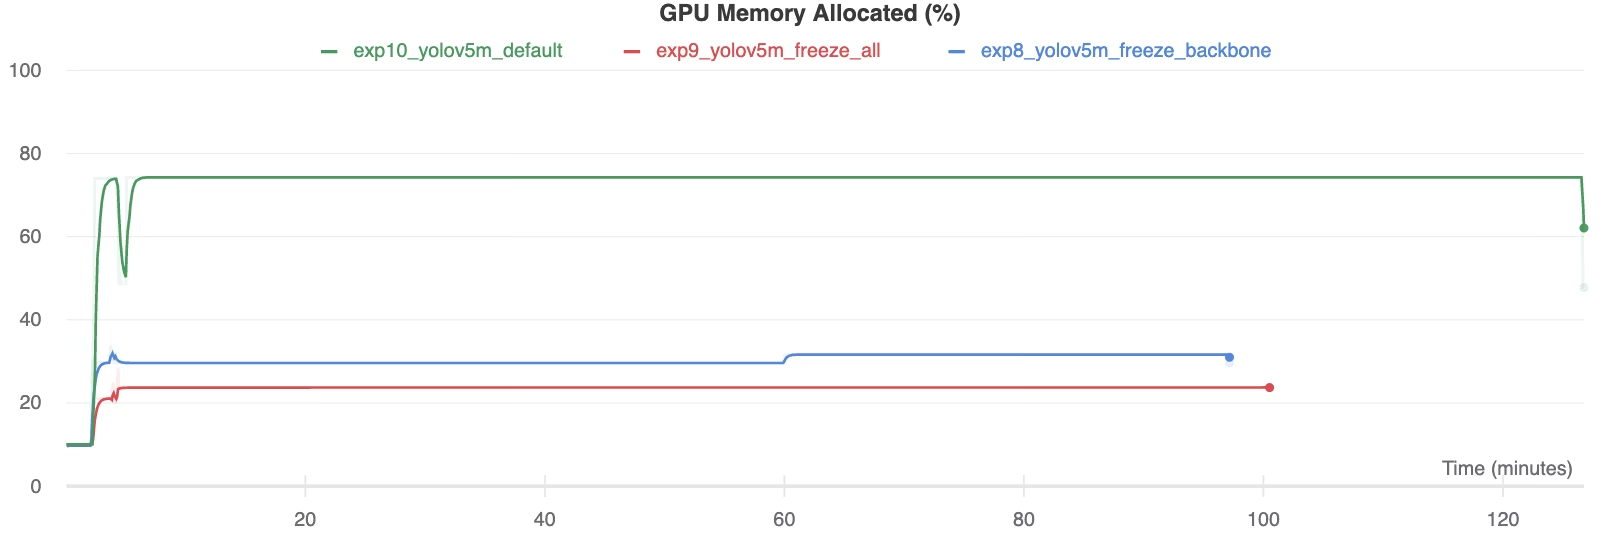 Memoria de GPU asignada (%)
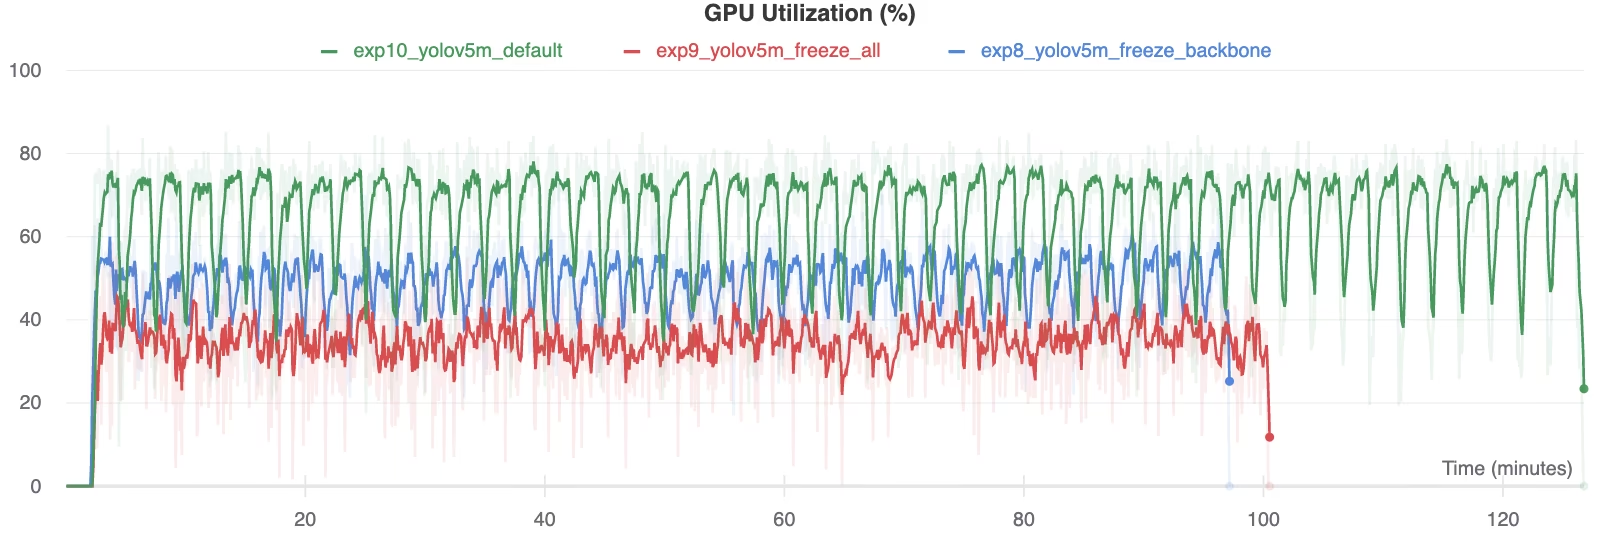 Uso de GPU (%)
Cuándo conviene congelar capas#
Congelar capas durante el aprendizaje por transferencia resulta especialmente ventajoso en varias situaciones:
- Recursos computacionales limitados: si tienes restricciones de memoria de GPU o de potencia de procesamiento.
- Conjuntos de datos pequeños: cuando el conjunto de datos de destino es mucho más pequeño que el conjunto de datos de preentrenamiento original, congelar capas ayuda a evitar el sobreajuste.
- Creación rápida de prototipos: cuando necesitas adaptar rápidamente un modelo existente a una nueva tarea o dominio para una evaluación inicial.
- Dominios con características similares: si las características de bajo nivel de tu nuevo conjunto de datos son muy similares a las del conjunto de datos con el que se preentrenó el modelo.
Descubre más sobre los matices del aprendizaje por transferencia en nuestra entrada del glosario y plantéate usar la evolución de hiperparámetros para optimizar el rendimiento.
Entornos compatibles#
Ultralytics ofrece varios entornos listos para usar con dependencias esenciales como CUDA, CuDNN, Python y PyTorch preinstaladas.
- Cuadernos gratuitos con GPU:


- Google Cloud: Guía de inicio rápido de GCP
- Amazon: Guía de inicio rápido de AWS
- Azure: Guía de inicio rápido de AzureML
- Docker: Guía de inicio rápido de Docker

Estado del proyecto#

Esta insignia confirma que todas las pruebas de integración continua (CI) de GitHub Actions de YOLOv5 se superan correctamente. Estas pruebas de CI evalúan rigurosamente la funcionalidad y el rendimiento de YOLOv5 en operaciones clave: entrenamiento, validación, inferencia, exportación y pruebas de rendimiento. Garantizan un funcionamiento coherente y fiable en macOS, Windows y Ubuntu, y se ejecutan automáticamente cada 24 horas y con cada nueva confirmación de código.
Preguntas frecuentes#
Congela los primeros
Nmódulos demodel.model, por lo que sus pesos permanecen fijos y no reciben gradientes.--freeze 10congela la columna vertebral, mientras que--freeze 24congela todo excepto el móduloDetectfinal.En el experimento con VOC anterior, entrenar todas las capas ofreció la mejor mAP; congelar la columna vertebral redujo ligeramente la precisión, y congelar todo excepto la cabeza de detección tuvo el mayor coste. A cambio, los entrenamientos con capas congeladas son más rápidos y utilizan mucha menos memoria de GPU.
Cuando tus imágenes comparten características de bajo nivel con los datos de preentrenamiento, tu conjunto de datos es pequeño o necesitas obtener rápidamente una referencia con hardware limitado. Entrena todas las capas cuando el conjunto de datos aumente o necesites arañar los últimos puntos de mAP.
Sí. Inicia una nueva ejecución a partir de
best.ptdel modelo congelado, sin--freeze, para ajustar toda la red, normalmente con una tasa de aprendizaje más baja.