Consejos para obtener los mejores resultados al entrenar YOLOv5
Esta guía explica cómo obtener el mejor mAP y los mejores resultados de entrenamiento con YOLOv5.
La mayoría de las veces, se pueden obtener buenos resultados sin cambiar los modelos ni los parámetros de entrenamiento, siempre que tu conjunto de datos tenga un tamaño suficiente y esté bien etiquetado. Si no obtienes buenos resultados a la primera, puedes seguir algunos pasos para mejorarlos, pero siempre recomendamos a los usuarios entrenar primero con todos los ajustes predeterminados antes de plantearse cualquier cambio. Así se establece una referencia de rendimiento y se detectan aspectos que se pueden mejorar.
Si tienes preguntas sobre los resultados de entrenamiento, proporciona toda la información posible para recibir una respuesta útil, incluidos los gráficos de resultados (pérdidas de entrenamiento y validación, P, R y mAP), la curva PR, la matriz de confusión, los mosaicos de entrenamiento, los resultados de prueba y las imágenes de estadísticas del conjunto de datos, como labels.png. Todo esto se encuentra en el directorio project/name, normalmente yolov5/runs/train/exp.
Las secciones siguientes abarcan los principales factores que afectan a los resultados del entrenamiento de YOLOv5.
Conjunto de datos#
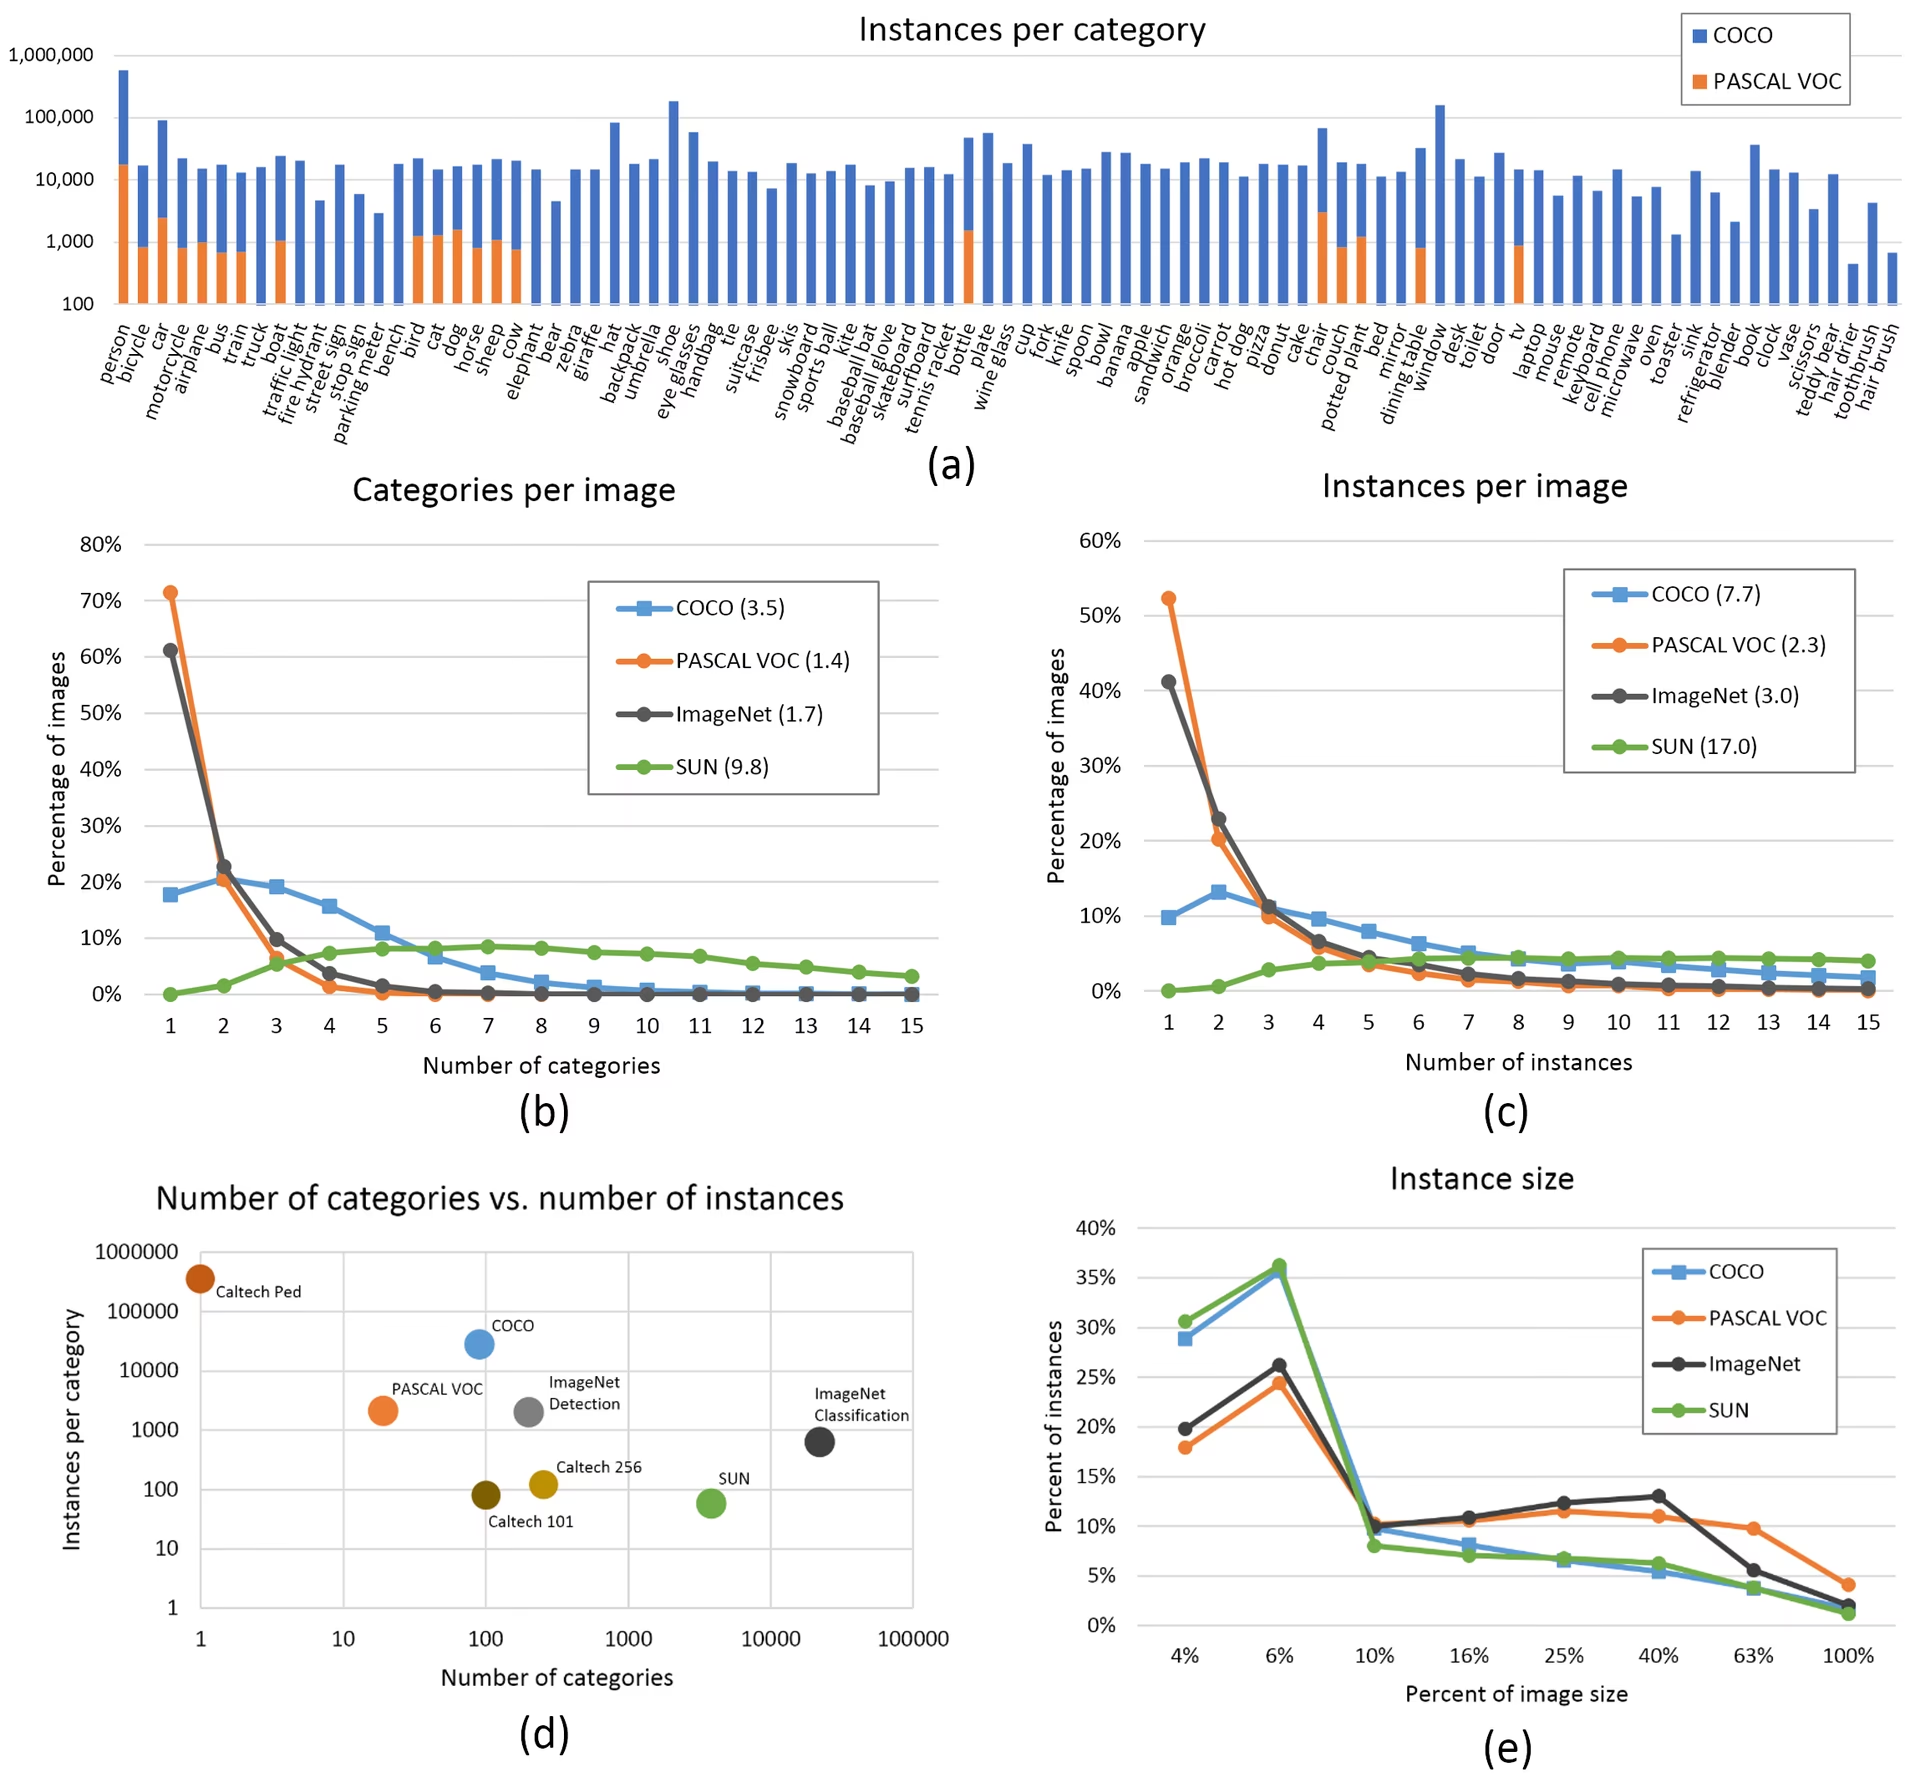
- Imágenes por clase. Se recomiendan ≥ 1500 imágenes por clase
- Instancias por clase. Se recomiendan ≥ 10000 instancias (objetos etiquetados) por clase
- Variedad de imágenes. Deben ser representativas del entorno de despliegue. Para casos de uso reales, recomendamos imágenes de distintas horas del día, estaciones, condiciones meteorológicas, situaciones de iluminación, ángulos y fuentes (recopiladas de Internet, obtenidas localmente, de distintas cámaras), etc.
- Coherencia de las etiquetas. Deben etiquetarse todas las instancias de todas las clases en todas las imágenes. El etiquetado parcial no funcionará.
- Precisión de las etiquetas. Las etiquetas deben delimitar cada objeto con precisión. No debe quedar espacio entre un objeto y su cuadro delimitador. No debe haber ningún objeto sin etiquetar.
- Criterios para la división entre entrenamiento y validación. Asegúrate de que las imágenes de validación y prueba no aparezcan nunca en el conjunto de entrenamiento para evitar métricas demasiado optimistas. Mantén distribuciones de clases similares en las distintas divisiones.
- Verificación de etiquetas. Consulta los mosaicos
train_batch*.jpgal iniciar el entrenamiento para comprobar que las etiquetas sean correctas. - Imágenes de fondo. Son imágenes sin objetos que se añaden a un conjunto de datos para reducir los falsos positivos (FP). Recomendamos que entre el 0 y el 10 % de las imágenes sean de fondo para ayudar a reducir los FP (COCO incluye 1000 imágenes de fondo como referencia, el 1 % del total). Las imágenes de fondo no necesitan etiquetas.
Selección del modelo#
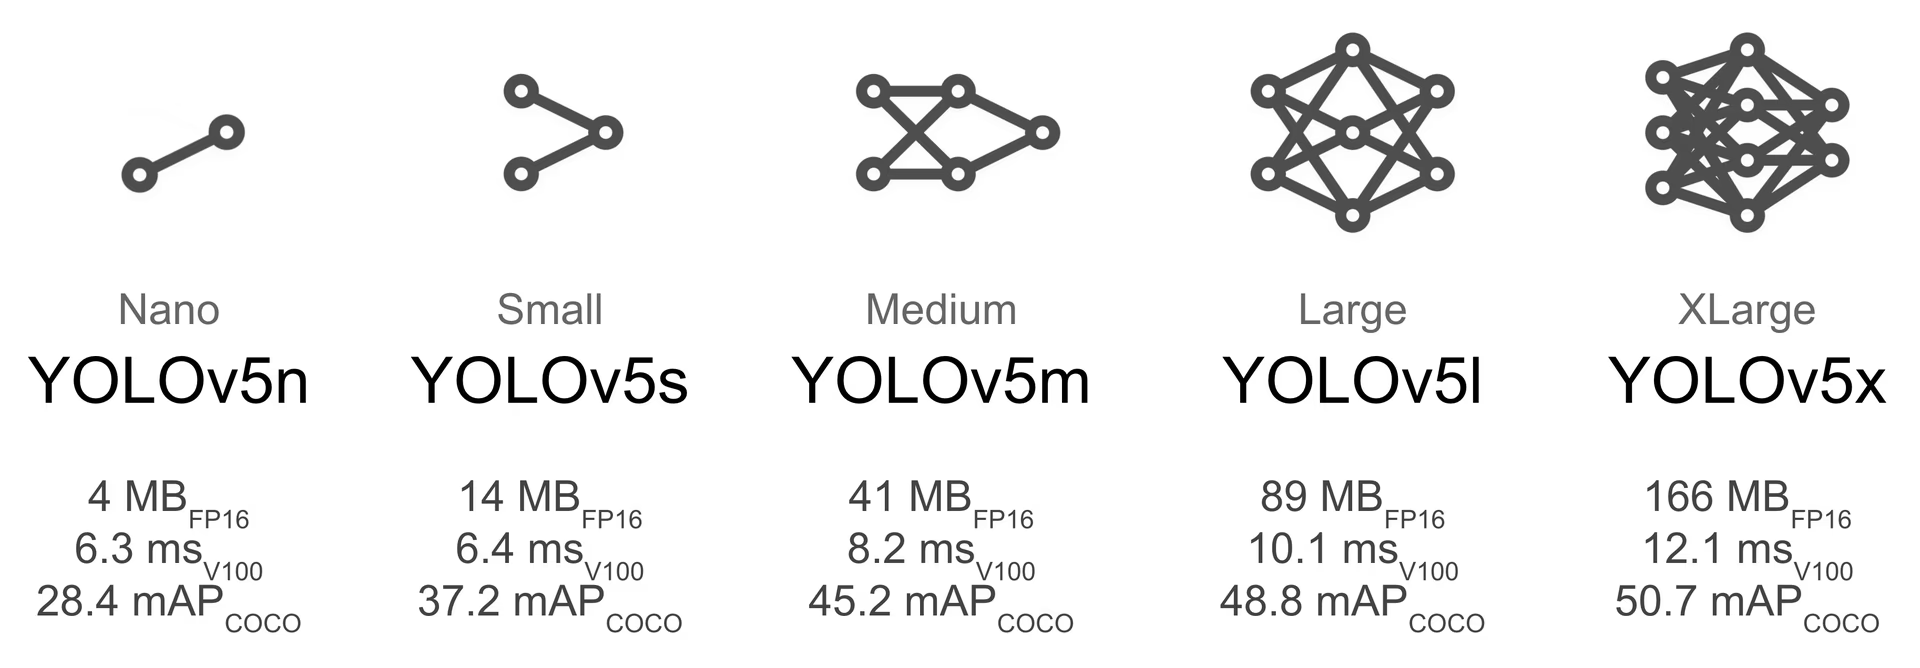
Los modelos más grandes, como YOLOv5x y YOLOv5x6, ofrecen mejores resultados en casi todos los casos, pero tienen más parámetros, requieren más memoria CUDA para entrenarse y son más lentos al ejecutarse. Para implementaciones móviles, recomendamos YOLOv5s/m; para implementaciones en la nube, recomendamos YOLOv5l/x.
-
Empieza con pesos preentrenados. Recomendado para conjuntos de datos pequeños o medianos (por ejemplo, VOC, VisDrone y GlobalWheat). Pasa el nombre del modelo al argumento
--weights. Los modelos se descargan automáticamente de la versión más reciente de YOLOv5.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Empieza desde cero. Recomendado para conjuntos de datos grandes (por ejemplo, COCO, Objects365 y OIv6). Pasa el YAML de la arquitectura del modelo que te interese junto con un argumento
--weights ''vacío:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Configuración del entrenamiento#
Antes de modificar nada, entrena primero con la configuración predeterminada para establecer una referencia de rendimiento. Encontrarás una lista completa de los ajustes de train.py en el analizador de argumentos de train.py.
- Épocas. Empieza con 300 épocas. Si el modelo empieza a sobreajustarse pronto, puedes reducir el número de épocas. Si no se produce sobreajuste después de 300 épocas, entrena durante más tiempo, por ejemplo, 600 o 1200 épocas.
- Tamaño de imagen. COCO se entrena con la resolución nativa de
--img 640, aunque, debido a la gran cantidad de objetos pequeños del conjunto de datos, puede beneficiarse de un entrenamiento con resoluciones más altas, como--img 1280. Si hay muchos objetos pequeños, los conjuntos de datos personalizados se beneficiarán de un entrenamiento con la resolución nativa o una superior. Los mejores resultados de inferencia se obtienen con el mismo--imgque se usó para el entrenamiento; por ejemplo, si entrenas con--img 1280, también deberías probar y detectar con--img 1280. - Tamaño del lote. Usa el mayor
--batch-sizeque admita tu hardware. Los tamaños de lote pequeños generan estadísticas de normalización por lotes deficientes y conviene evitarlos. Puedes usar--batch-size -1para seleccionar automáticamente el tamaño de lote óptimo para tu GPU. - Tasa de aprendizaje. La planificación predeterminada de la tasa de aprendizaje funciona bien en la mayoría de los casos. Para acelerar la convergencia, puedes probar la opción
--cos-lrpara activar una planificación cosenoidal de la tasa de aprendizaje, que la reduce gradualmente siguiendo una curva cosenoidal a lo largo de las épocas. - Aumento de datos. YOLOv5 incluye varias técnicas de aumento, como el mosaico, que combina varias imágenes de entrenamiento. Ajusta la intensidad del aumento mediante el hiperparámetro
mosaicen tu archivo--hyppara ayudar a estabilizar el entrenamiento. - Hiperparámetros. Los hiperparámetros predeterminados se encuentran en hyp.scratch-low.yaml. Te recomendamos entrenar primero con los hiperparámetros predeterminados antes de plantearte modificarlos. En general, aumentar los hiperparámetros de aumento de datos reducirá y retrasará el sobreajuste, lo que permitirá entrenamientos más largos y un mAP final más alto. Reducir los hiperparámetros de ganancia de los componentes de pérdida, como
hyp['obj'], ayudará a reducir el sobreajuste en esos componentes concretos. Para optimizar estos hiperparámetros automáticamente, consulta nuestro tutorial sobre evolución de hiperparámetros. - Entrenamiento con precisión mixta. YOLOv5 activa automáticamente la precisión mixta automática (AMP) cuando detecta una GPU compatible, lo que acelera el entrenamiento y reduce el uso de memoria sin sacrificar la precisión del modelo.
- Entrenamiento con varias GPU. Si tienes varias GPU, inicia el entrenamiento DistributedDataParallel con
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3para reducir considerablemente el tiempo de entrenamiento. - Parada anticipada. Usa
--patience 50para detener el entrenamiento si las métricas de validación no mejoran durante 50 épocas, ahorrar tiempo y evitar el sobreajuste.
Técnicas avanzadas de optimización#
- Aprendizaje por transferencia. Para conjuntos de datos especializados, empieza con pesos preentrenados y, si quieres, congela capas con
--freezepara adaptar el modelo a tu tarea específica. - Poda de modelos. Después del entrenamiento, plantéate podar el modelo para poner a cero los pesos redundantes con una pérdida mínima de precisión y, después, implementarlo con un entorno de ejecución que tenga en cuenta la dispersión para obtener mejoras de velocidad.
- Conjunto de modelos. Para aplicaciones críticas, entrena varios modelos con distintas configuraciones y combina sus predicciones para mejorar la precisión.
- Aumentación en tiempo de prueba. Activa TTA durante la inferencia con
--augmentpara mejorar la precisión de las predicciones mediante la combinación de predicciones obtenidas con versiones volteadas y redimensionadas de la imagen de entrada.
Lecturas adicionales#
Si quieres saber más, un buen punto de partida es A Recipe for Training Neural Networks, de Karpathy, que contiene ideas de entrenamiento aplicables a todos los ámbitos del ML.
¡Buena suerte! Cuéntanos si tienes alguna otra pregunta.
Preguntas frecuentes#
Es posible que tu modelo esté sobreajustándose si la pérdida de entrenamiento sigue disminuyendo mientras que la pérdida de validación empieza a aumentar. Supervisa el mAP de validación: si se estanca o disminuye mientras la pérdida de entrenamiento sigue mejorando, es señal de sobreajuste. Entre las soluciones se incluyen añadir más datos de entrenamiento, aumentar la ampliación de datos o aplicar técnicas de regularización.
El tamaño de lote óptimo depende de la memoria de tu GPU. Por lo general, los tamaños de lote mayores ofrecen mejores estadísticas de normalización por lotes y más estabilidad durante el entrenamiento. Usa el tamaño de lote más grande que admita tu hardware sin quedarte sin memoria. Puedes usar
--batch-size -1para determinar automáticamente el tamaño de lote óptimo para tu configuración.Para acelerar el entrenamiento, prueba a usar varias GPU con DDP, almacenar en caché el conjunto de datos con
--cachey optimizar el tamaño del lote (la precisión mixta se activa automáticamente en las GPU compatibles). También puedes usar una variante de modelo más pequeña, como YOLOv5s, si la precisión absoluta no es fundamental.
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.