Aumento en tiempo de prueba (TTA)#
📚 Esta guía explica cómo usar el aumento en tiempo de prueba (TTA) durante las pruebas y la inferencia para mejorar el mAP y la exhaustividad con YOLOv5 🚀.
Antes de empezar#
Clona el repositorio e instala requirements.txt en un entorno Python>=3.8.0 que incluya PyTorch>=1.8. Los modelos y los conjuntos de datos se descargan automáticamente desde la versión más reciente de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Prueba normal#
Antes de probar TTA, queremos establecer un rendimiento de referencia con el que comparar. Este comando prueba YOLOv5x en COCO val2017 con un tamaño de imagen de 640 píxeles. yolov5x.pt es el modelo más grande y preciso disponible. Las otras opciones son yolov5n.pt, yolov5s.pt, yolov5m.pt y yolov5l.pt, o tu propio punto de control tras entrenar con un conjunto de datos personalizado, es decir, runs/train/exp/weights/best.pt. Para ver información sobre todos los modelos disponibles, consulta la documentación de YOLOv5.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSalida:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Prueba con TTA#
Añade --augment a cualquier comando val.py existente para activar TTA y aumenta el tamaño de imagen aproximadamente un 30 % para mejorar los resultados. Ten en cuenta que la inferencia con TTA suele tardar entre 2 y 3 veces más que la inferencia normal, ya que las imágenes se voltean de izquierda a derecha y se procesan a 3 resoluciones distintas, antes de combinar las salidas con NMS. Parte de la reducción de velocidad se debe simplemente al mayor tamaño de imagen (832 frente a 640), mientras que otra parte se debe a las propias operaciones de TTA; por tanto, asegúrate de que la GPU tenga suficiente memoria disponible antes de aumentar --img.
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --halfSalida:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833
Inferencia con TTA#
La inferencia con TTA de detect.py funciona igual que la inferencia con TTA de val.py: basta con añadir --augment a cualquier comando detect.py existente:
python detect.py --weights yolov5s.pt --img 832 --source data/images --augmentSalida:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)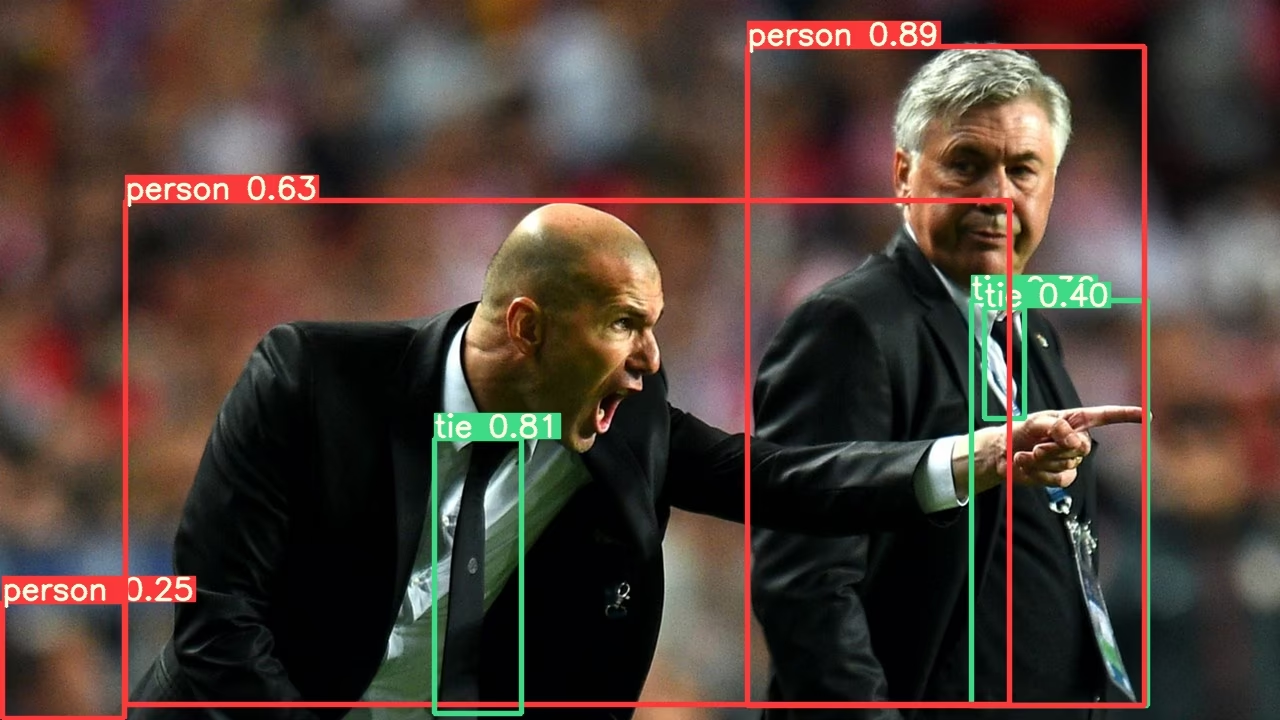
TTA con PyTorch Hub#
La TTA está integrada automáticamente en todos los modelos de YOLOv5 PyTorch Hub y se puede activar pasando augment=True en el momento de la inferencia.
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # o yolov5m, yolov5x, personalizado

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # o archivo, PIL, OpenCV, numpy, varios

# Inference
results = model(img, augment=True)  # <--- Inferencia con TTA

# Results
results.print() # o .show(), .save(), .crop(), .pandas(), etc.Personalización#
Puedes personalizar las operaciones de TTA aplicadas en el método forward_augment() de YOLOv5.
Ventajas del aumento en tiempo de prueba#
El aumento en tiempo de prueba ofrece varias ventajas importantes para las tareas de detección de objetos:
- Mayor precisión: Como muestran los resultados anteriores, la TTA aumenta el mAP de 0.504 a 0.516 y el mAR de 0.681 a 0.696.
- Mejor detección de objetos pequeños: La TTA mejora especialmente la detección de objetos pequeños, y el AP para áreas pequeñas aumenta de 0.351 a 0.361.
- Mayor robustez: Al probar varias versiones de cada imagen, la TTA reduce el impacto del ángulo de visión, la iluminación y otros factores ambientales.
- Implementación sencilla: Solo hay que añadir la opción
--augmenta los comandos existentes.
La contrapartida es un mayor tiempo de inferencia, por lo que la TTA es más adecuada para aplicaciones que priorizan la precisión frente a la velocidad.
Entornos compatibles#
Ultralytics ofrece una variedad de entornos listos para usar, cada uno con dependencias esenciales preinstaladas, como CUDA, CUDNN, Python y PyTorch, para que puedas poner en marcha tus proyectos.
- Cuadernos gratuitos con GPU:


- Google Cloud: Guía de inicio rápido de GCP
- Amazon: Guía de inicio rápido de AWS
- Azure: Guía de inicio rápido de AzureML
- Docker: Guía de inicio rápido de Docker

Estado del proyecto#

Esta insignia indica que todas las pruebas de integración continua (CI) de GitHub Actions de YOLOv5 se superan correctamente. Estas pruebas de CI comprueban rigurosamente la funcionalidad y el rendimiento de YOLOv5 en varios aspectos clave: entrenamiento, validación, inferencia, exportación y evaluaciones comparativas. Garantizan un funcionamiento uniforme y fiable en macOS, Windows y Ubuntu, con pruebas cada 24 horas y tras cada nueva confirmación.
Preguntas frecuentes#
Cada imagen se procesa a tres escalas y volteada de izquierda a derecha; después, se combinan las predicciones antes de aplicar NMS. Estas vistas adicionales mejoran la exhaustividad, sobre todo en objetos pequeños, a costa de un mayor coste computacional.
La inferencia suele tardar entre 2 y 3 veces más de lo normal. Parte del coste se debe al mayor tamaño de
--img, así que asegúrate de que la GPU tenga suficiente memoria antes de aumentarlo.Usar una resolución aproximadamente un 30 % mayor, por ejemplo, 832 en lugar de 640, proporciona más detalles a las pasadas multiescala y dio los mejores resultados en las pruebas de rendimiento anteriores.
No. El paso forward aumentado se ejecuta en el
DetectionModelde PyTorch, por lo que--augmentsolo afecta a los checkpoints de.pt. Los formatos exportados ONNX, TensorRT y otros lo ignoran.