Evolución de hiperparámetros para YOLOv5#
📚 Esta guía explica la evolución de hiperparámetros para YOLOv5 🚀. La evolución de hiperparámetros es un método de optimización de hiperparámetros que utiliza un algoritmo genético (GA) para la optimización.
Los hiperparámetros del aprendizaje automático controlan distintos aspectos del entrenamiento, y encontrar sus valores óptimos puede ser complicado. Los métodos tradicionales, como las búsquedas en cuadrícula, pueden volverse rápidamente inviables debido a lo siguiente:
- El gran espacio de búsqueda
- Las correlaciones desconocidas entre las dimensiones
- El elevado coste de evaluar la aptitud en cada punto
Por eso, los algoritmos genéticos son una opción adecuada para buscar hiperparámetros.
Antes de empezar#
Clona el repositorio e instala requirements.txt en un entorno Python>=3.8.0 que incluya PyTorch>=1.8. Los modelos y los conjuntos de datos se descargan automáticamente desde la versión más reciente de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Inicializar los hiperparámetros#
YOLOv5 tiene unos 30 hiperparámetros que se usan en diversos ajustes de entrenamiento. Se definen en los archivos *.yaml del directorio /data/hyps. Unos valores iniciales más acertados producirán mejores resultados finales, por lo que es importante inicializarlos correctamente antes de iniciar la evolución. Si tienes dudas, usa los valores predeterminados, optimizados para entrenar YOLOv5 con COCO desde cero.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Definir la aptitud#
La aptitud es el valor que queremos maximizar. En YOLOv5 definimos una función de aptitud predeterminada como una combinación ponderada de métricas: mAP@0.5 aporta el 10 % del peso y mAP@0.5:0.95 aporta el 90 % restante; la precisión (P) y la exhaustividad (R) no se incluyen. Puedes ajustarlas como consideres o usar la definición de aptitud predeterminada de utils/metrics.py (recomendado). Esta aptitud determina qué resultado se guarda en hyp_evolve.yaml; el algoritmo genético clasifica a los progenitores y a los individuos de élite únicamente según mAP@0.5, así que cambiar estos pesos no modifica la selección de progenitores.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # Pesos para [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Evoluciona#
La evolución se realiza a partir de un escenario base que buscamos mejorar. En este ejemplo, el escenario base consiste en ajustar COCO128 durante 10 épocas con YOLOv5s preentrenado. El comando de entrenamiento del escenario base es:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cachePara evolucionar los hiperparámetros específicos de este escenario, partiendo de nuestros valores iniciales definidos en la Sección 1. y maximizando la aptitud definida en la Sección 2., añade --evolve:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
La configuración predeterminada de la evolución ejecuta 300 generaciones, y en cada generación se entrena el escenario base una vez para cada uno de los 50 individuos de la población. Puedes modificar el número de generaciones mediante el argumento --evolve; por ejemplo, python train.py --evolve 1000.
Los principales operadores genéticos son el cruce y la mutación. En cada generación se entrena a todos los individuos y se les asigna una puntuación según mAP@0.5; se seleccionan los padres mediante selección por torneo, añadiendo los individuos de élite con mejor aptitud al grupo de padres, y se crea la siguiente población mediante cruce y mutación, con tasas que se adaptan a medida que avanza la evolución. Los resultados se registran en runs/evolve/exp/evolve.csv, y cada generación se guarda la descendencia con mayor aptitud como runs/evolve/exp/hyp_evolve.yaml:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
Para obtener los mejores resultados, recomendamos un mínimo de 300 generaciones de evolución. Ten en cuenta que la evolución suele requerir mucho tiempo y recursos, ya que el escenario base se entrena miles de veces, lo que puede exigir cientos o miles de horas de GPU.
Cuando termine la evolución, reutiliza la configuración descubierta indicando el archivo guardado en el entrenamiento; por ejemplo, python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. Visualiza#
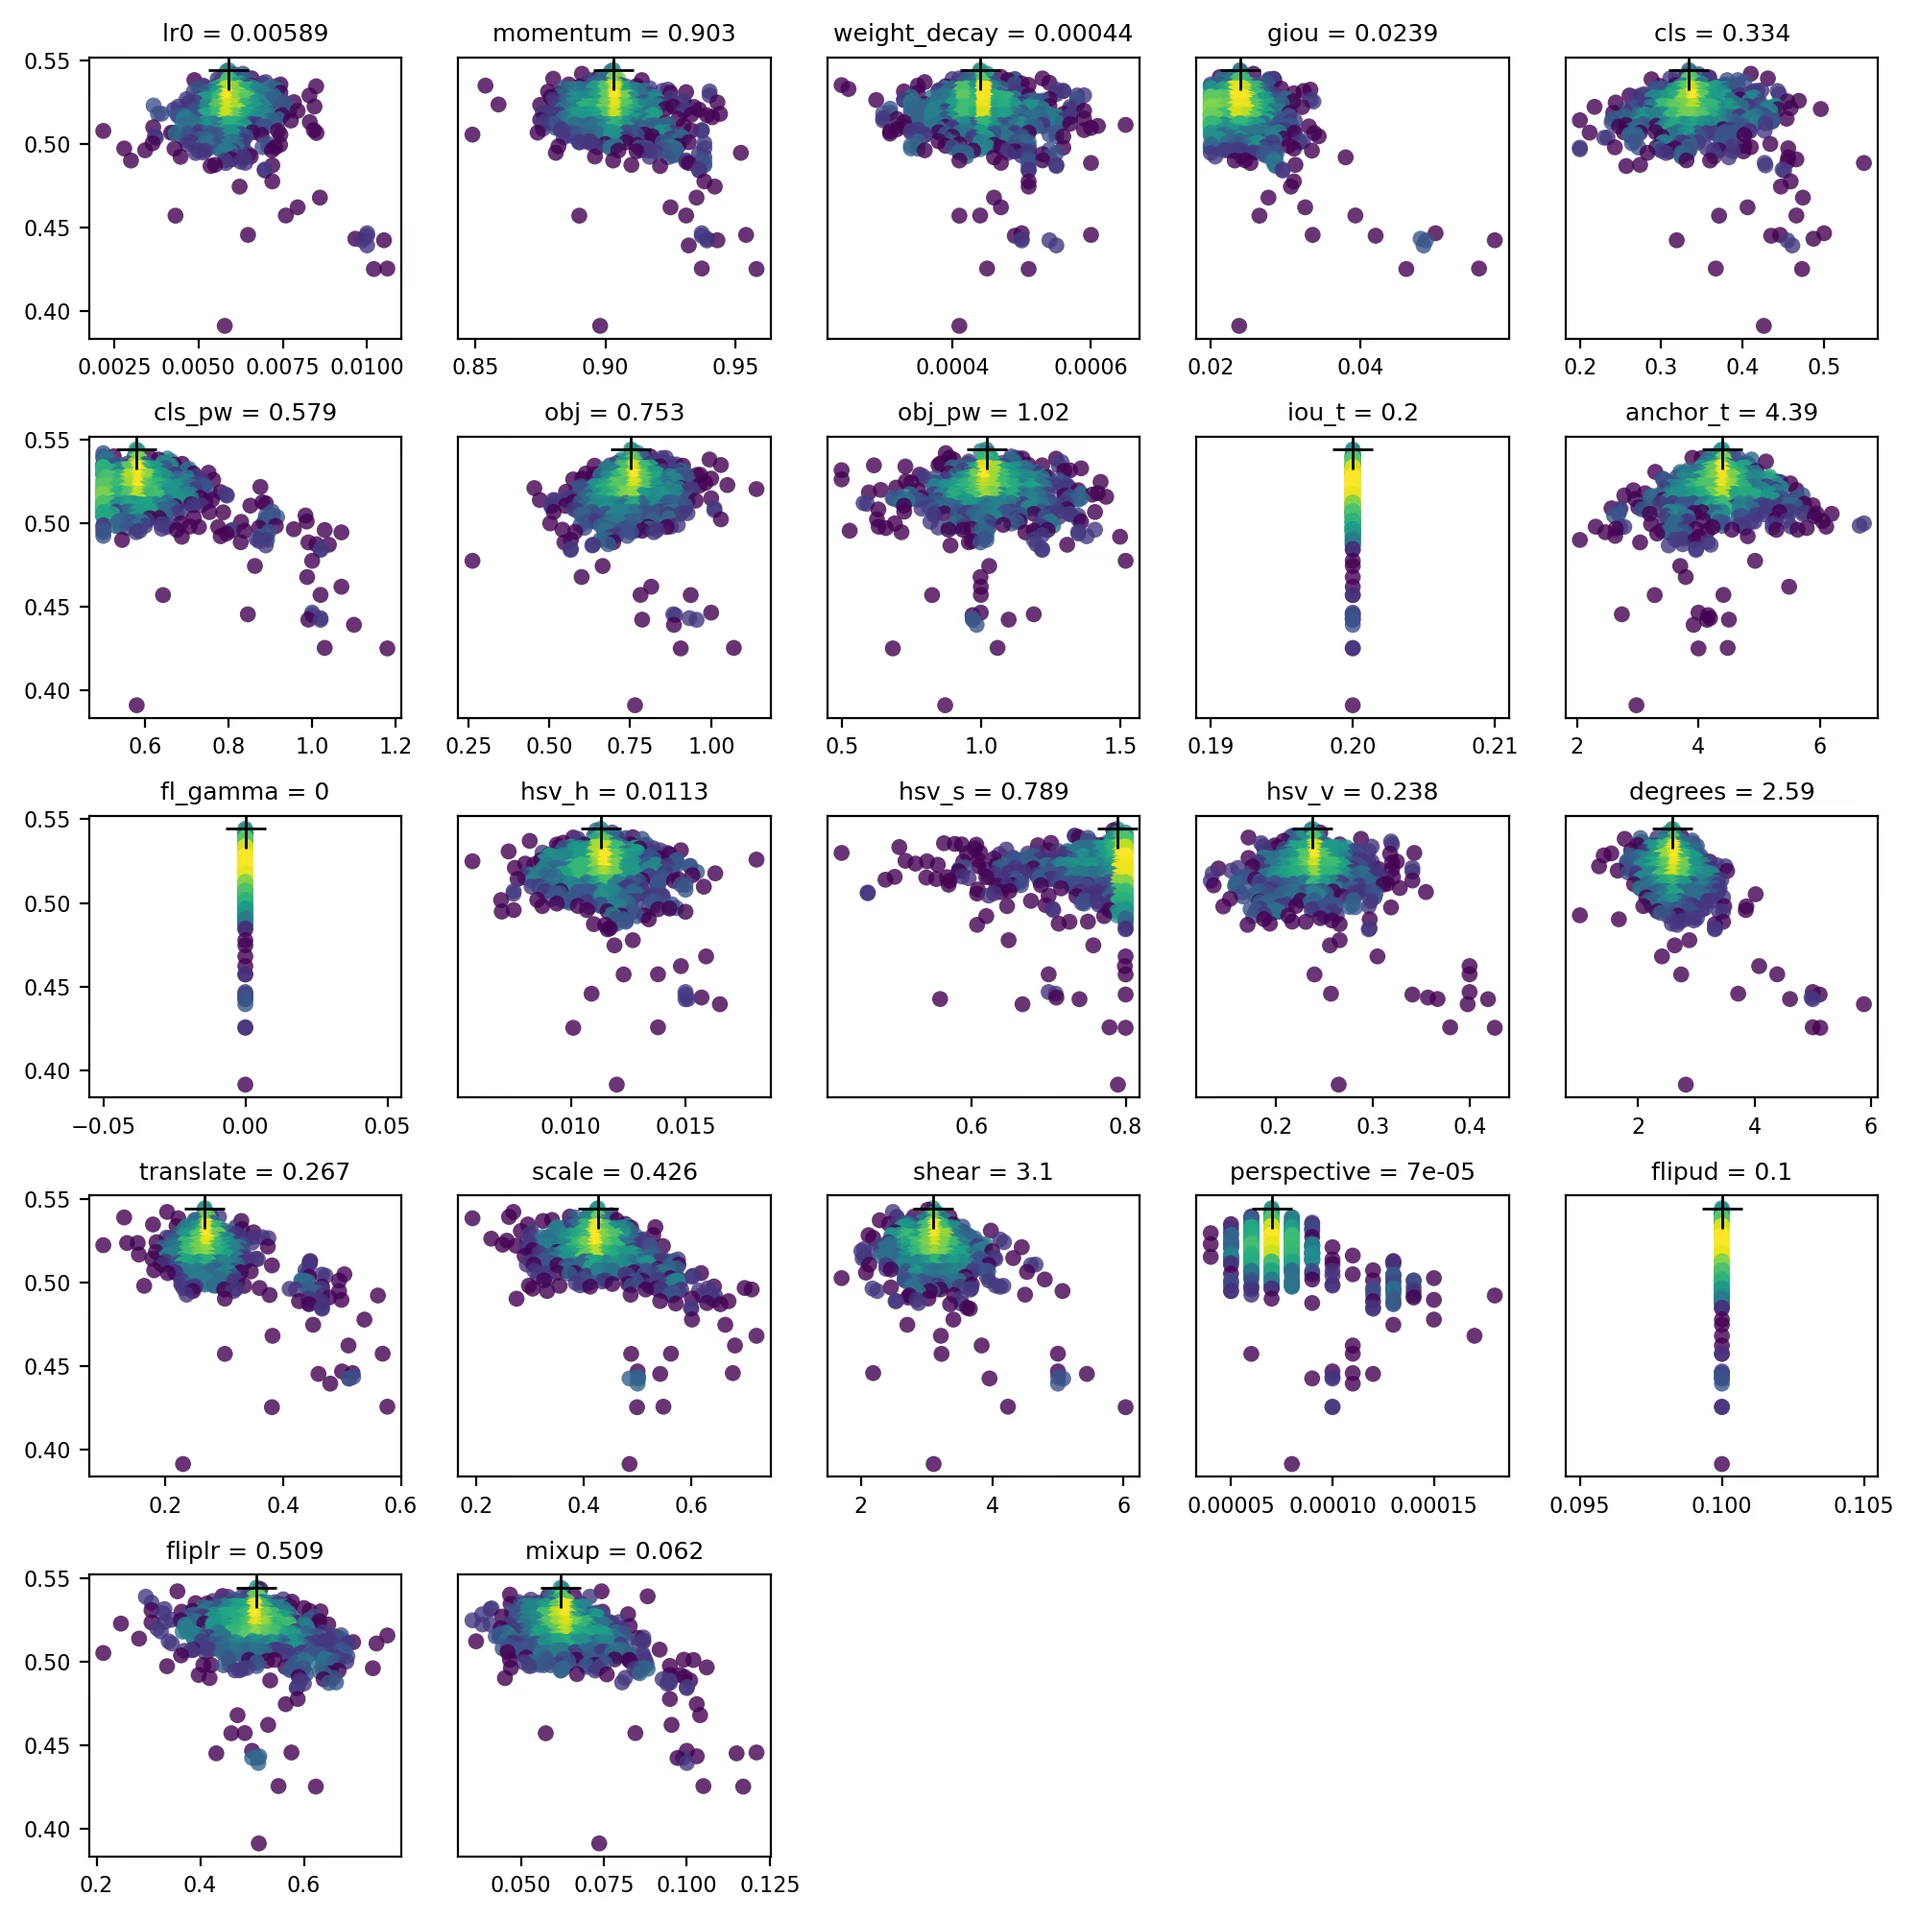
evolve.csv se representa como evolve.png mediante utils.plots.plot_evolve() cuando termina la evolución, con un gráfico por hiperparámetro que muestra la aptitud (eje y) frente a los valores del hiperparámetro (eje x). El amarillo indica concentraciones más altas. Las distribuciones verticales indican que un parámetro se ha desactivado y no muta. Puedes seleccionar esta opción en el diccionario meta de train.py; resulta útil para fijar parámetros e impedir que evolucionen.
Entornos compatibles#
Ultralytics ofrece una variedad de entornos listos para usar, cada uno con dependencias esenciales preinstaladas, como CUDA, CUDNN, Python y PyTorch, para que puedas poner en marcha tus proyectos.
- Cuadernos gratuitos con GPU:


- Google Cloud: Guía de inicio rápido de GCP
- Amazon: Guía de inicio rápido de AWS
- Azure: Guía de inicio rápido de AzureML
- Docker: Guía de inicio rápido de Docker

Estado del proyecto#

Esta insignia indica que todas las pruebas de integración continua (CI) de GitHub Actions de YOLOv5 se superan correctamente. Estas pruebas de CI comprueban rigurosamente la funcionalidad y el rendimiento de YOLOv5 en varios aspectos clave: entrenamiento, validación, inferencia, exportación y evaluaciones comparativas. Garantizan un funcionamiento uniforme y fiable en macOS, Windows y Ubuntu, con pruebas cada 24 horas y tras cada nueva confirmación.
Preguntas frecuentes#
En cada generación se entrena el escenario base una vez por individuo de la población de 50 miembros, por lo que 300 generaciones de una ejecución de COCO128 de 10 épocas cuestan aproximadamente 15 000 veces lo que cuesta una ejecución de ese tipo. Mantén el escenario base breve y representativo. El bucle multigpu anterior inicia una búsqueda independiente en cada GPU en lugar de compartir una única búsqueda, así que reduce
--evolvepor proceso si trabajas con un presupuesto fijo.Sí.
--evolvetiene un valor predeterminado de 300 generaciones; indica un número, como--evolve 1000, para ejecutar más.Establece el primer valor de su entrada en el diccionario
metadetrain.pyenFalse. Los parámetros excluidos conservan su valor inicial y aparecen como líneas verticales enevolve.png.Pasa el archivo guardado a una ejecución de entrenamiento normal:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.