Entrena YOLOv5 con datos personalizados#
📚 Esta guía explica cómo entrenar tu propio conjunto de datos personalizado con el modelo YOLOv5 🚀. Entrenar modelos personalizados es un paso fundamental para adaptar las soluciones de visión artificial a aplicaciones concretas del mundo real, más allá de la detección de objetos genérica.
Antes de empezar#
Primero, asegúrate de que tienes configurado el entorno necesario. Clona el repositorio de YOLOv5 e instala las dependencias necesarias desde requirements.txt. Es imprescindible contar con un entorno de Python>=3.8.0 y PyTorch>=1.8. Los modelos y conjuntos de datos se descargan automáticamente de la versión más reciente de YOLOv5 si no se encuentran localmente.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
Entrena con datos personalizados#
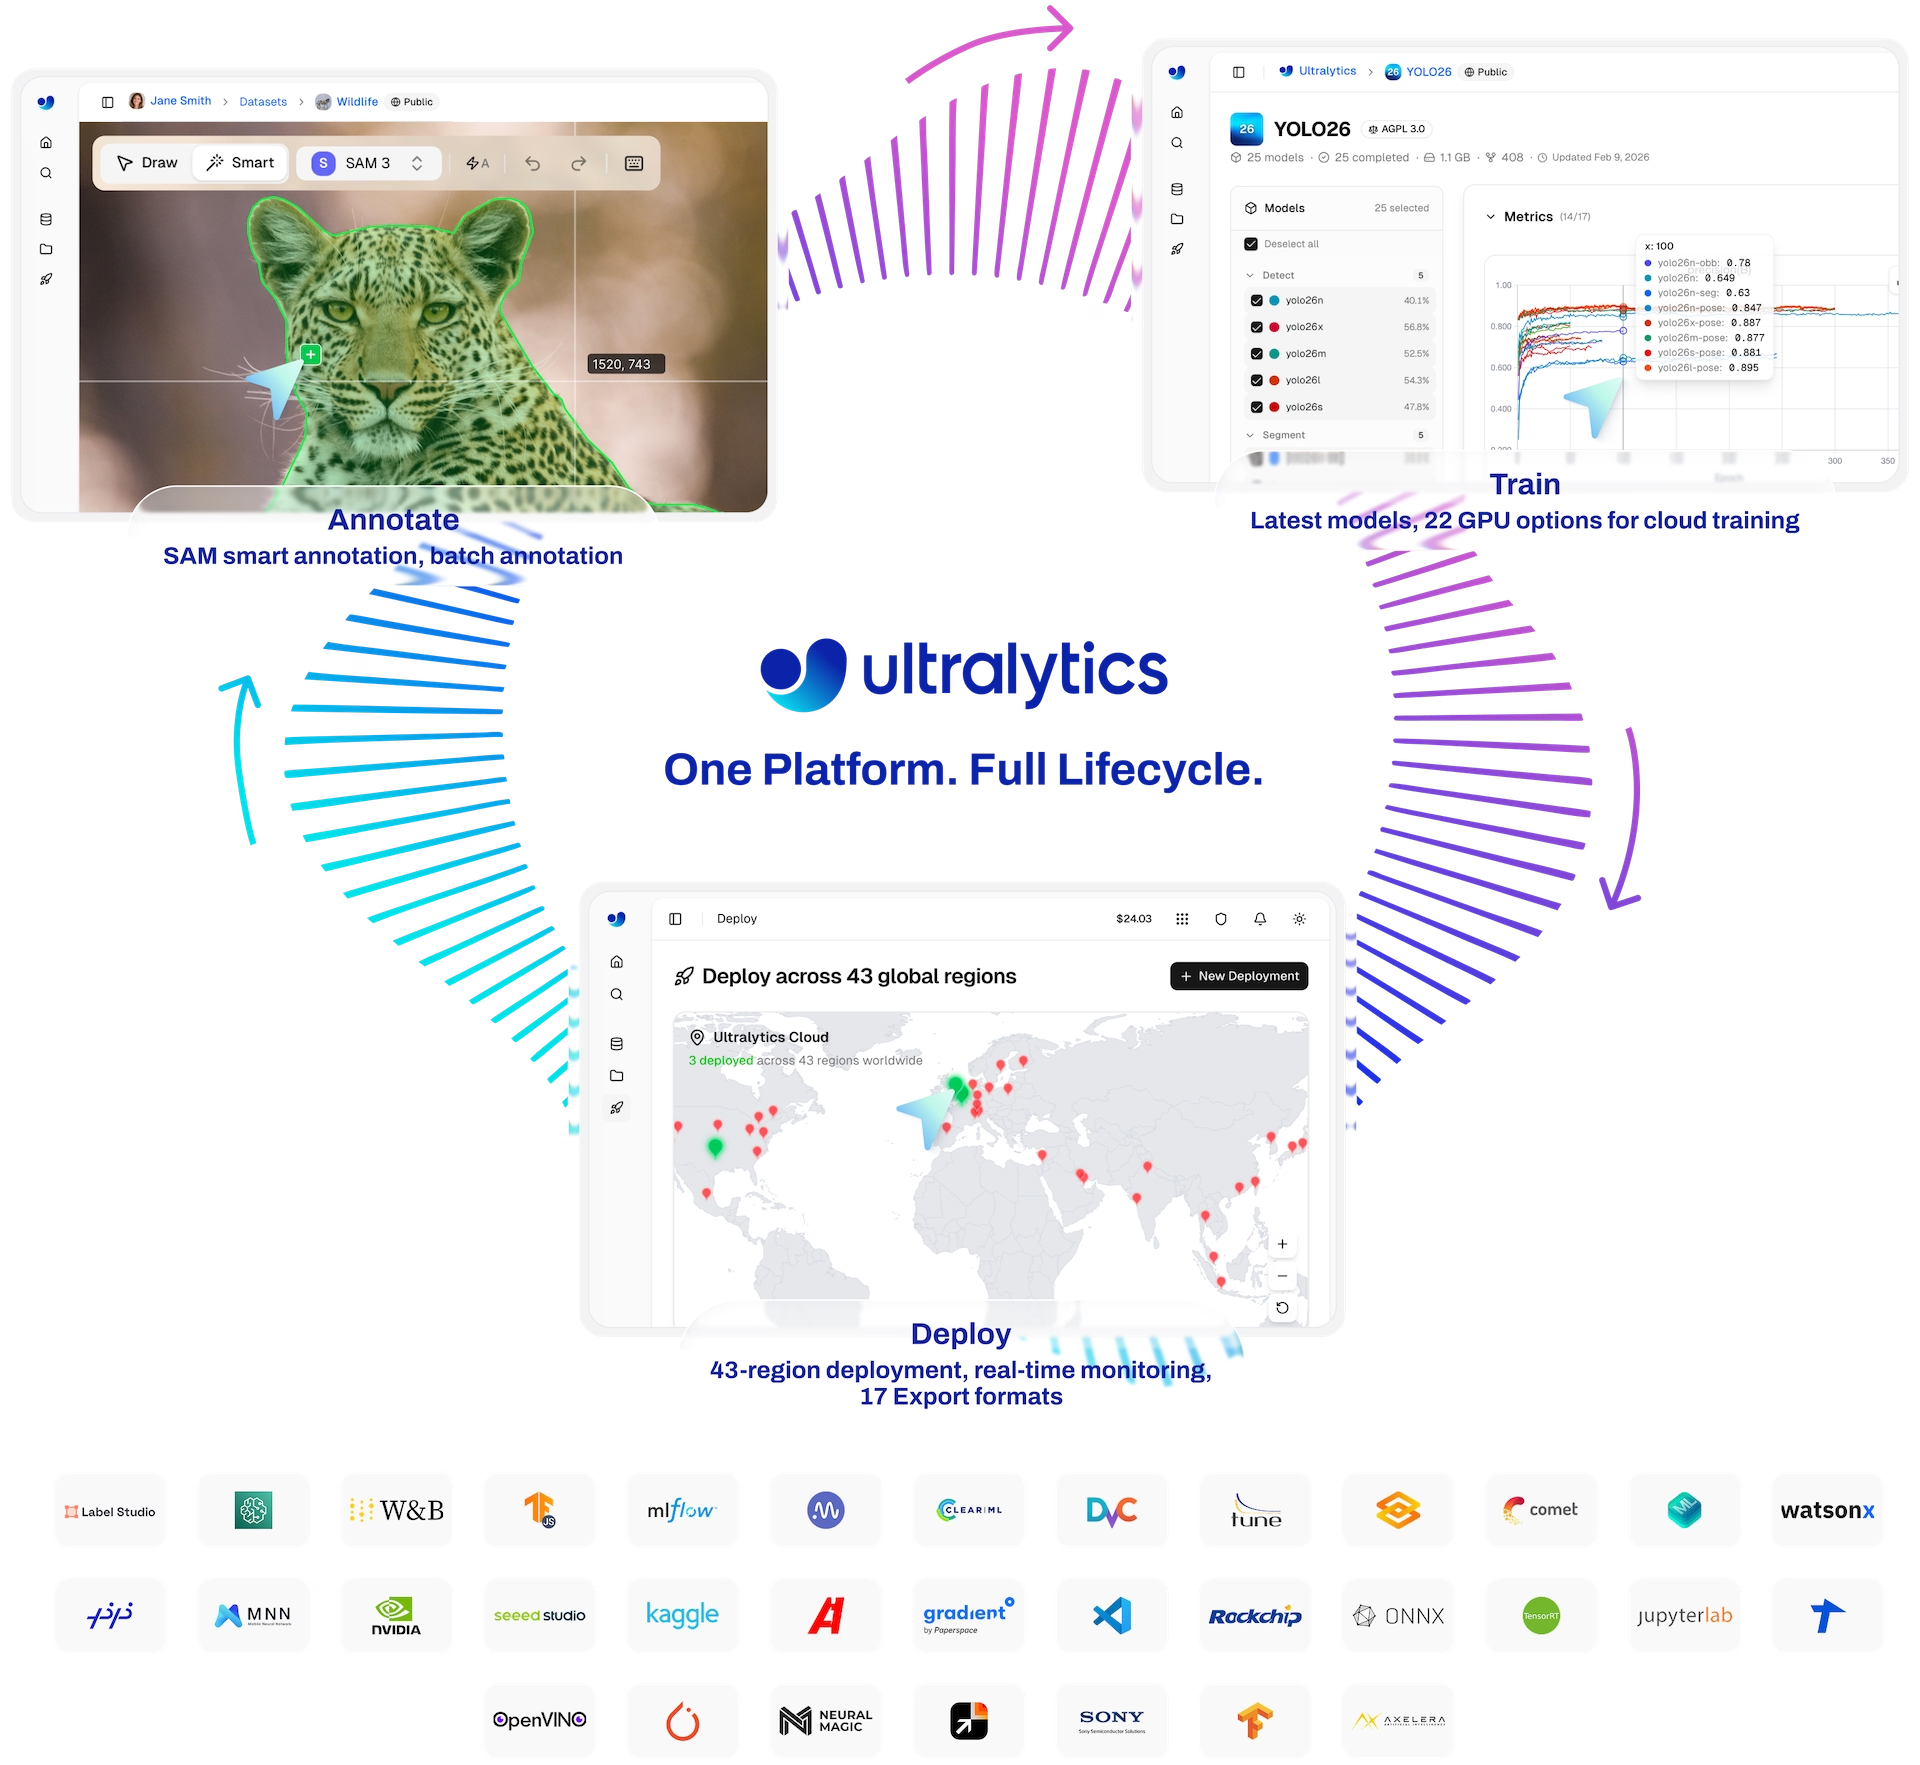
Desarrollar un modelo personalizado de detección de objetos es un proceso iterativo:
- Recopila y organiza imágenes: reúne imágenes relevantes para tu tarea específica. Los datos diversos y de alta calidad son fundamentales. Consulta nuestra guía sobre recopilación y anotación de datos.
- Etiqueta los objetos: anota con precisión los objetos de interés en tus imágenes.
- Entrena un modelo: usa los datos etiquetados para entrenar tu modelo YOLOv5. Aprovecha el aprendizaje por transferencia partiendo de pesos preentrenados.
- Despliega y predice: utiliza el modelo entrenado para realizar inferencias con datos nuevos que no haya visto.
- Recopila casos límite: identifica situaciones en las que el modelo tenga un rendimiento deficiente (casos límite) y añade datos similares a tu conjunto de datos para mejorar su robustez. Repite el ciclo.
La plataforma de Ultralytics ofrece una solución simplificada sin código para todo este ciclo de operaciones de aprendizaje automático (MLOps), incluida la gestión de conjuntos de datos, el entrenamiento de modelos y el despliegue.
Ultralytics ofrece dos opciones de licencia para adaptarse a distintos casos de uso:
- Licencia AGPL-3.0: esta licencia de código abierto aprobada por la OSI es ideal para estudiantes, investigadores y entusiastas que apuestan por la colaboración abierta y el intercambio de conocimientos. Exige que las obras derivadas se compartan con la misma licencia. Consulta el archivo LICENSE para obtener todos los detalles.
- Licencia Enterprise: para desarrollo y uso en producción, esta licencia permite integrar fácilmente el software y los modelos de IA de Ultralytics en productos y servicios empresariales, incluidas herramientas internas, flujos de trabajo automatizados e implementaciones de producción, sin las obligaciones de código abierto de AGPL-3.0. Para empezar, ponte en contacto con nosotros a través de Licencias de Ultralytics.
Descubre más sobre nuestras opciones de licencia en la página de licencias de Ultralytics.
Antes de iniciar el entrenamiento, es esencial preparar el conjunto de datos.
1. Crea un conjunto de datos#
Los modelos YOLOv5 necesitan datos etiquetados para aprender las características visuales de las clases de objetos. Organizar correctamente tu conjunto de datos es fundamental.
1.1 Crea dataset.yaml#
El archivo de configuración del conjunto de datos (por ejemplo, coco128.yaml) describe la estructura del conjunto de datos, los nombres de las clases y las rutas a los directorios de imágenes. COCO128 es un pequeño conjunto de datos de ejemplo que contiene las primeras 128 imágenes del amplio conjunto de datos COCO. Es útil para probar rápidamente el flujo de entrenamiento y diagnosticar posibles problemas como el sobreajuste.
La estructura del archivo dataset.yaml incluye:
path: el directorio raíz que contiene el conjunto de datos.train,val,test: rutas relativas desdepatha directorios que contienen imágenes o archivos de texto con listas de rutas de imágenes para los conjuntos de entrenamiento, validación y prueba.names: un diccionario que asigna los índices de clase (a partir de 0) a los nombres de clase correspondientes.
Puedes establecer path como un directorio absoluto (por ejemplo, /home/user/datasets/coco128) o como una ruta relativa, como ../datasets/coco128, al iniciar el entrenamiento desde la raíz del repositorio de YOLOv5.
A continuación se muestra la estructura de coco128.yaml (ver en GitHub):
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 Aprovecha los modelos para el etiquetado automatizado#
El etiquetado manual es el método más habitual, pero lleva mucho tiempo. Los modelos fundacionales pueden automatizar o semiautomatizar la anotación y acelerar la creación de conjuntos de datos. Estos son algunos modelos que pueden ayudar a generar etiquetas:
- Google Gemini: los grandes modelos multimodales como Gemini tienen una potente capacidad para comprender imágenes. Puedes pedirles que identifiquen y localicen objetos en las imágenes, generando cuadros delimitadores o descripciones que se pueden convertir en etiquetas en formato YOLO. Descubre su potencial en el cuaderno de tutorial incluido.
- SAM2 (modelo Segment Anything 2): los modelos fundacionales centrados en la segmentación, como SAM2, pueden identificar y delimitar objetos con gran precisión. Aunque se usan principalmente para la segmentación, las máscaras resultantes suelen poder convertirse en anotaciones de cuadros delimitadores adecuadas para tareas de detección de objetos.
- YOLOWorld: este modelo ofrece capacidades de detección con vocabulario abierto. Puedes proporcionar descripciones de texto de los objetos que te interesan y YOLOWorld los localizará en las imágenes sin haber recibido entrenamiento previo con esas clases específicas. Puedes usarlo como punto de partida para generar etiquetas iniciales y luego perfeccionarlas.
El uso de estos modelos puede servir como paso de «preetiquetado» y reducir el trabajo manual necesario. Sin embargo, es fundamental revisar y perfeccionar las etiquetas generadas automáticamente para garantizar su precisión y coherencia, ya que su calidad afecta directamente al rendimiento del modelo YOLOv5 entrenado. Después de generar las etiquetas (y, si hace falta, perfeccionarlas), asegúrate de que cumplen el formato YOLO: un archivo *.txt por imagen, con cada línea representando un objeto como class_index x_center y_center width height (coordenadas normalizadas y clase indexada desde cero). Si una imagen no contiene objetos de interés, no hace falta crear el archivo *.txt correspondiente.
Las especificaciones de los archivos *.txt del formato YOLO son precisas:
- Una fila por cada cuadro delimitador.
- Cada fila debe contener:
class_index x_center y_center width height. - Las coordenadas deben estar normalizadas en un rango de 0 a 1. Para ello, divide los valores en píxeles de
x_centerywidthentre el ancho total de la imagen, y dividey_centeryheightentre la altura total de la imagen. - Los índices de clase empiezan en cero (es decir, la primera clase se representa con
0, la segunda con1, y así sucesivamente).
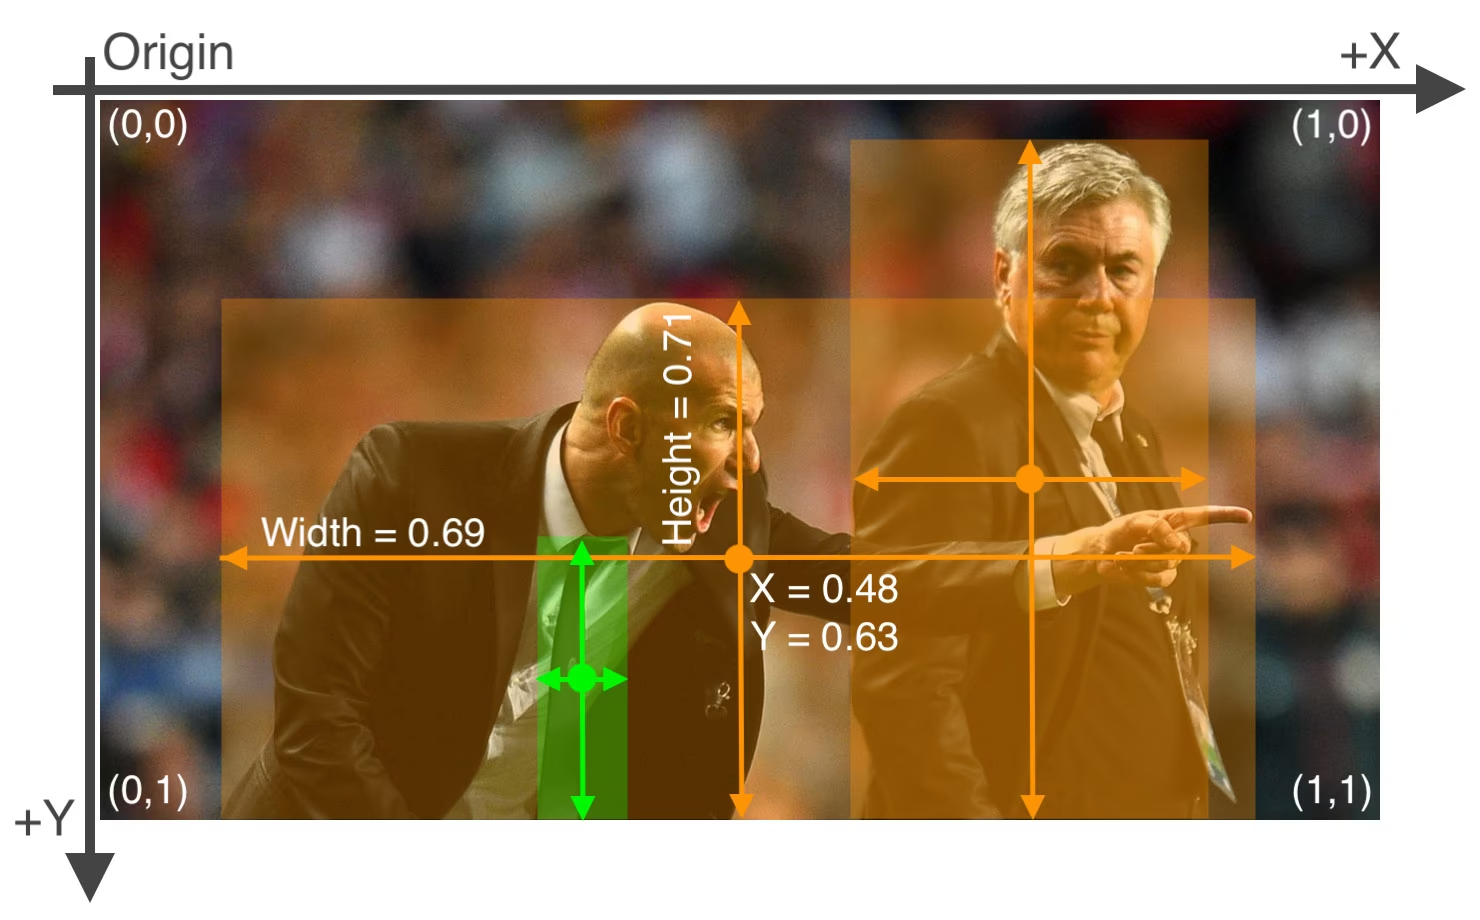
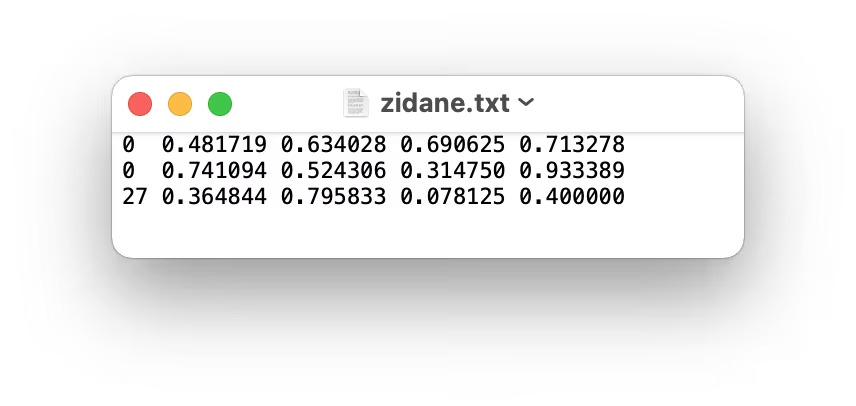
El archivo de etiquetas correspondiente a la imagen anterior, con dos objetos «person» (índice de clase 0) y un objeto «tie» (índice de clase 27), tendría este aspecto:
1.3 Organiza los directorios#
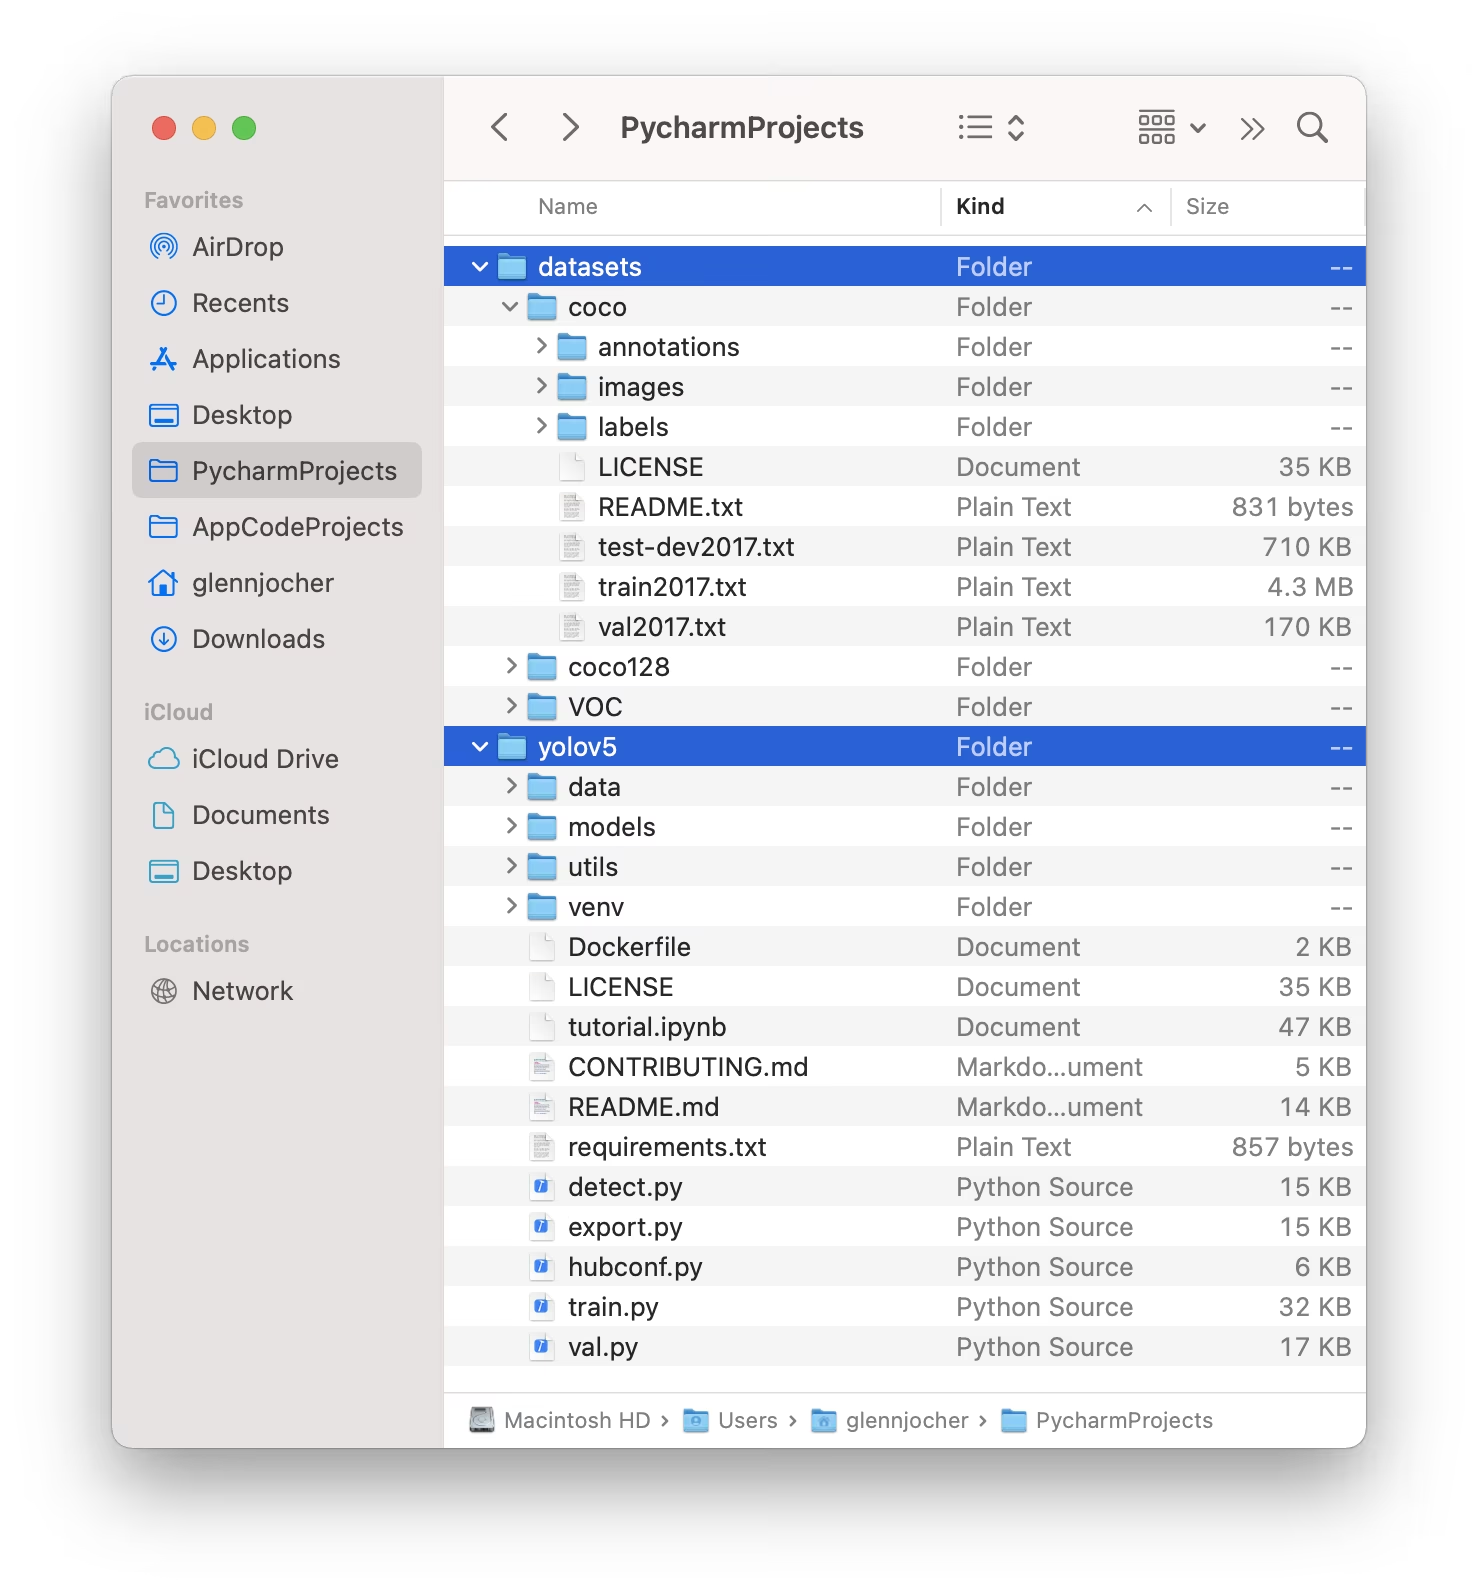
Estructura el directorio de tus conjuntos de datos como se muestra a continuación. De forma predeterminada, YOLOv5 espera que el directorio del conjunto de datos (por ejemplo, /coco128) esté dentro de una carpeta /datasets situada junto al directorio del repositorio /yolov5.
YOLOv5 encuentra automáticamente las etiquetas de cada imagen sustituyendo la última aparición de /images/ en la ruta de la imagen por /labels/. Por ejemplo:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
La estructura de directorios recomendada es:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. Selecciona un modelo#
Elige un modelo preentrenado para iniciar el proceso de entrenamiento. Empezar con pesos preentrenados acelera considerablemente el aprendizaje y mejora el rendimiento frente a entrenar desde cero. YOLOv5 ofrece modelos de distintos tamaños, cada uno con un equilibrio diferente entre velocidad y precisión. Por ejemplo, YOLOv5s es el segundo modelo más pequeño y el segundo más rápido, por lo que es adecuado para entornos con recursos limitados. Consulta la tabla del README para comparar en detalle todos los modelos disponibles.

3. Entrena#
Inicia el entrenamiento del modelo con el script train.py. Estos son algunos argumentos esenciales:
--img: define el tamaño de las imágenes de entrada (por ejemplo,--img 640). Los tamaños más grandes suelen ofrecer mayor precisión, pero requieren más memoria de GPU.--batch: determina el tamaño del lote (por ejemplo,--batch 16). Elige el tamaño máximo que admita tu GPU.--epochs: especifica el número total de épocas de entrenamiento (por ejemplo,--epochs 100). Una época representa un ciclo completo por todo el conjunto de datos de entrenamiento.--data: ruta al archivodataset.yaml(por ejemplo,--data coco128.yaml).--weights: ruta al archivo de pesos iniciales. Se recomienda encarecidamente usar pesos preentrenados (por ejemplo,--weights yolov5s.pt) para converger más rápido y obtener mejores resultados. Para entrenar desde cero (no se recomienda, salvo que tengas un conjunto de datos muy grande y necesidades específicas), usa--weights '' --cfg yolov5s.yaml.
Los pesos preentrenados se descargan automáticamente de la versión más reciente de YOLOv5 si no se encuentran localmente.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt💡 Usa --cache ram o --cache disk para almacenar en caché las imágenes del conjunto de datos en la RAM o en el disco local, respectivamente. Esto acelera considerablemente el entrenamiento, sobre todo cuando las operaciones de E/S (entrada/salida) del conjunto de datos son un cuello de botella. Ten en cuenta que necesitarás mucha RAM o espacio en disco.
💡 Entrena siempre con conjuntos de datos almacenados localmente. Acceder a datos desde unidades de red (como Google Drive) o almacenamiento remoto puede ser mucho más lento y perjudicar el rendimiento del entrenamiento. Copiar el conjunto de datos a una SSD local suele ser la mejor opción.
Todos los resultados del entrenamiento, incluidos los pesos y los registros, se guardan en el directorio runs/train/. Cada sesión de entrenamiento crea un subdirectorio nuevo (por ejemplo, runs/train/exp, runs/train/exp2, etc.). Para una experiencia interactiva y práctica, consulta la sección de entrenamiento de nuestros cuadernos de tutorial oficiales: 

4. Visualiza#
YOLOv5 se integra a la perfección con varias herramientas para visualizar el progreso del entrenamiento, evaluar los resultados y supervisar el rendimiento en tiempo real.
Registro y visualización con Comet#
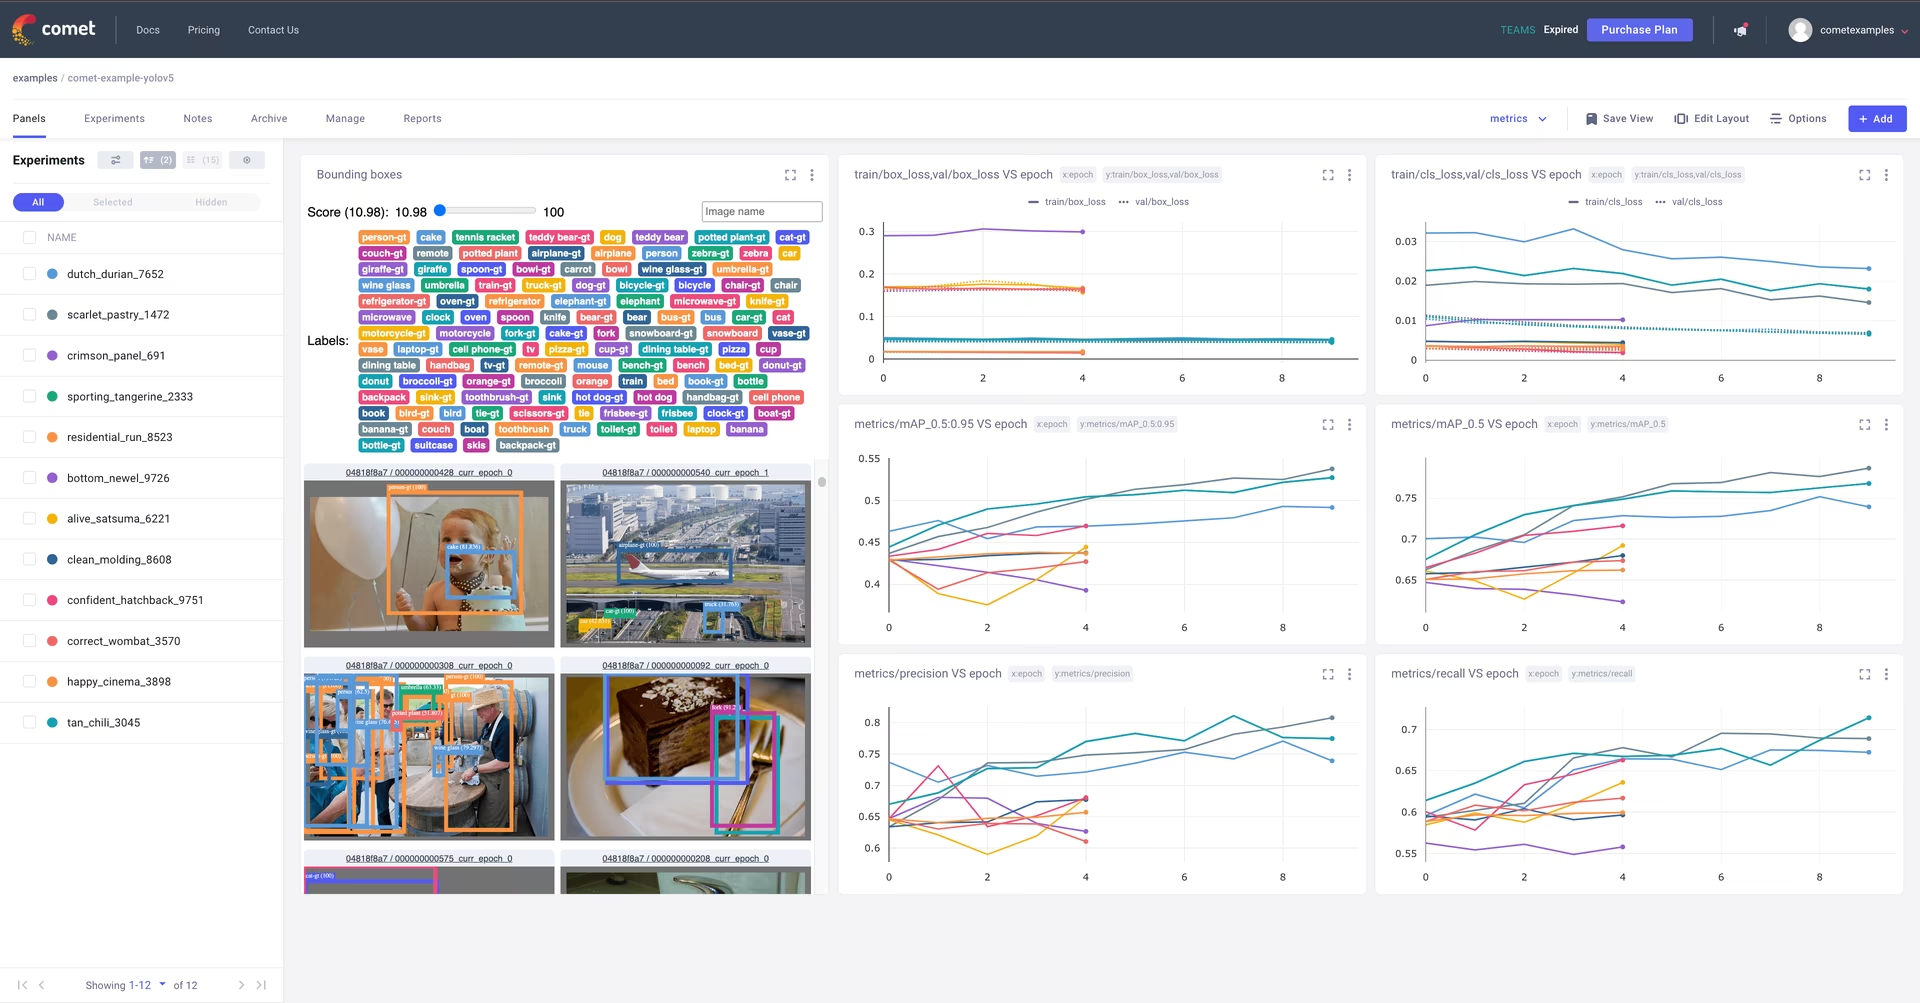
Comet está totalmente integrado para realizar un seguimiento completo de los experimentos. Visualiza métricas en directo, guarda hiperparámetros, gestiona conjuntos de datos y puntos de control de modelos, y analiza predicciones del modelo con paneles personalizados de Comet interactivos.
Empezar es muy sencillo:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
Descubre en detalle las funciones compatibles en nuestra guía de integración de Comet. Consulta la documentación oficial para obtener más información sobre las capacidades de Comet. Prueba el cuaderno de Colab de Comet con esta demostración en directo:
Registro y automatización con ClearML#
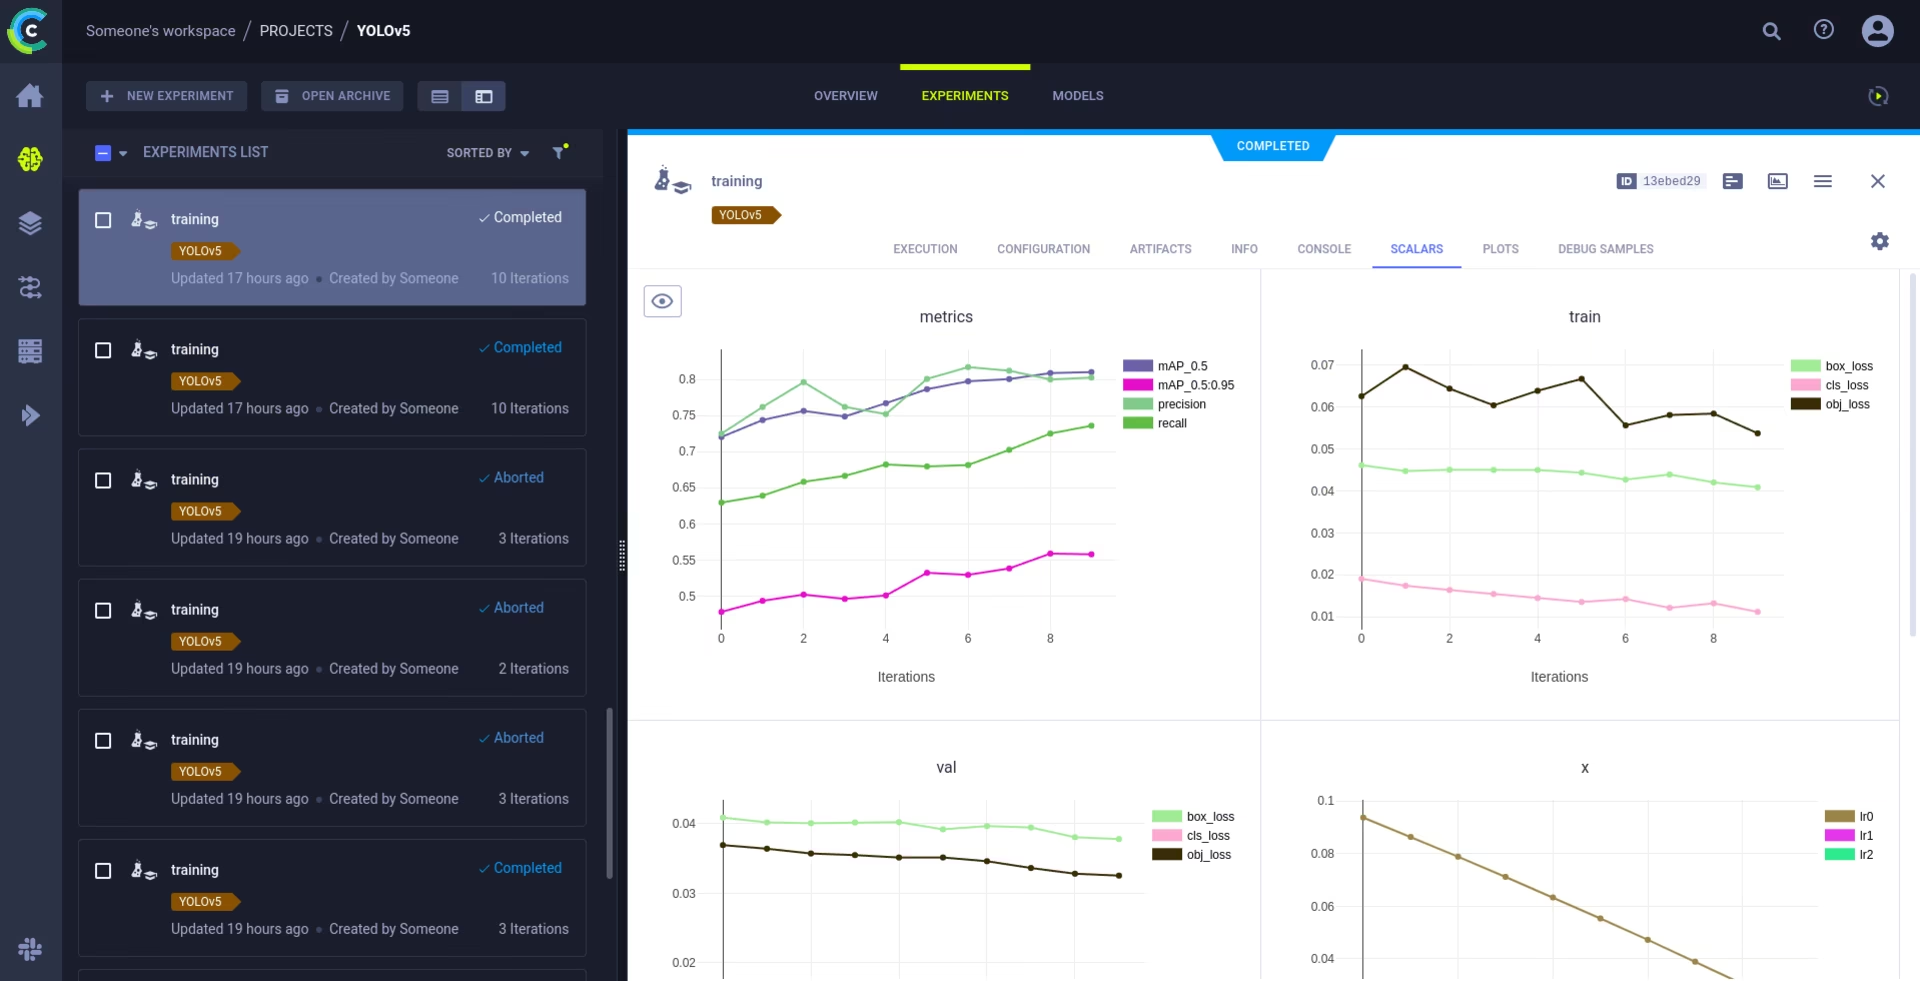
La integración con ClearML permite realizar un seguimiento detallado de experimentos, gestionar las versiones de los conjuntos de datos e incluso ejecutar tareas de entrenamiento de forma remota. Activa ClearML con estos sencillos pasos:
- Instala el paquete:
pip install clearml - Inicializa ClearML: ejecuta
clearml-inituna vez para conectarte a tu servidor de ClearML (autoalojado o al plan gratuito).
ClearML captura automáticamente los detalles de los experimentos, las cargas de modelos, las comparaciones, los cambios de código sin confirmar y los paquetes instalados, lo que garantiza una reproducibilidad completa. Puedes programar fácilmente tareas de entrenamiento en agentes remotos y gestionar las versiones de los conjuntos de datos con ClearML Data. Consulta la guía de integración de ClearML para obtener todos los detalles.
Registro local#
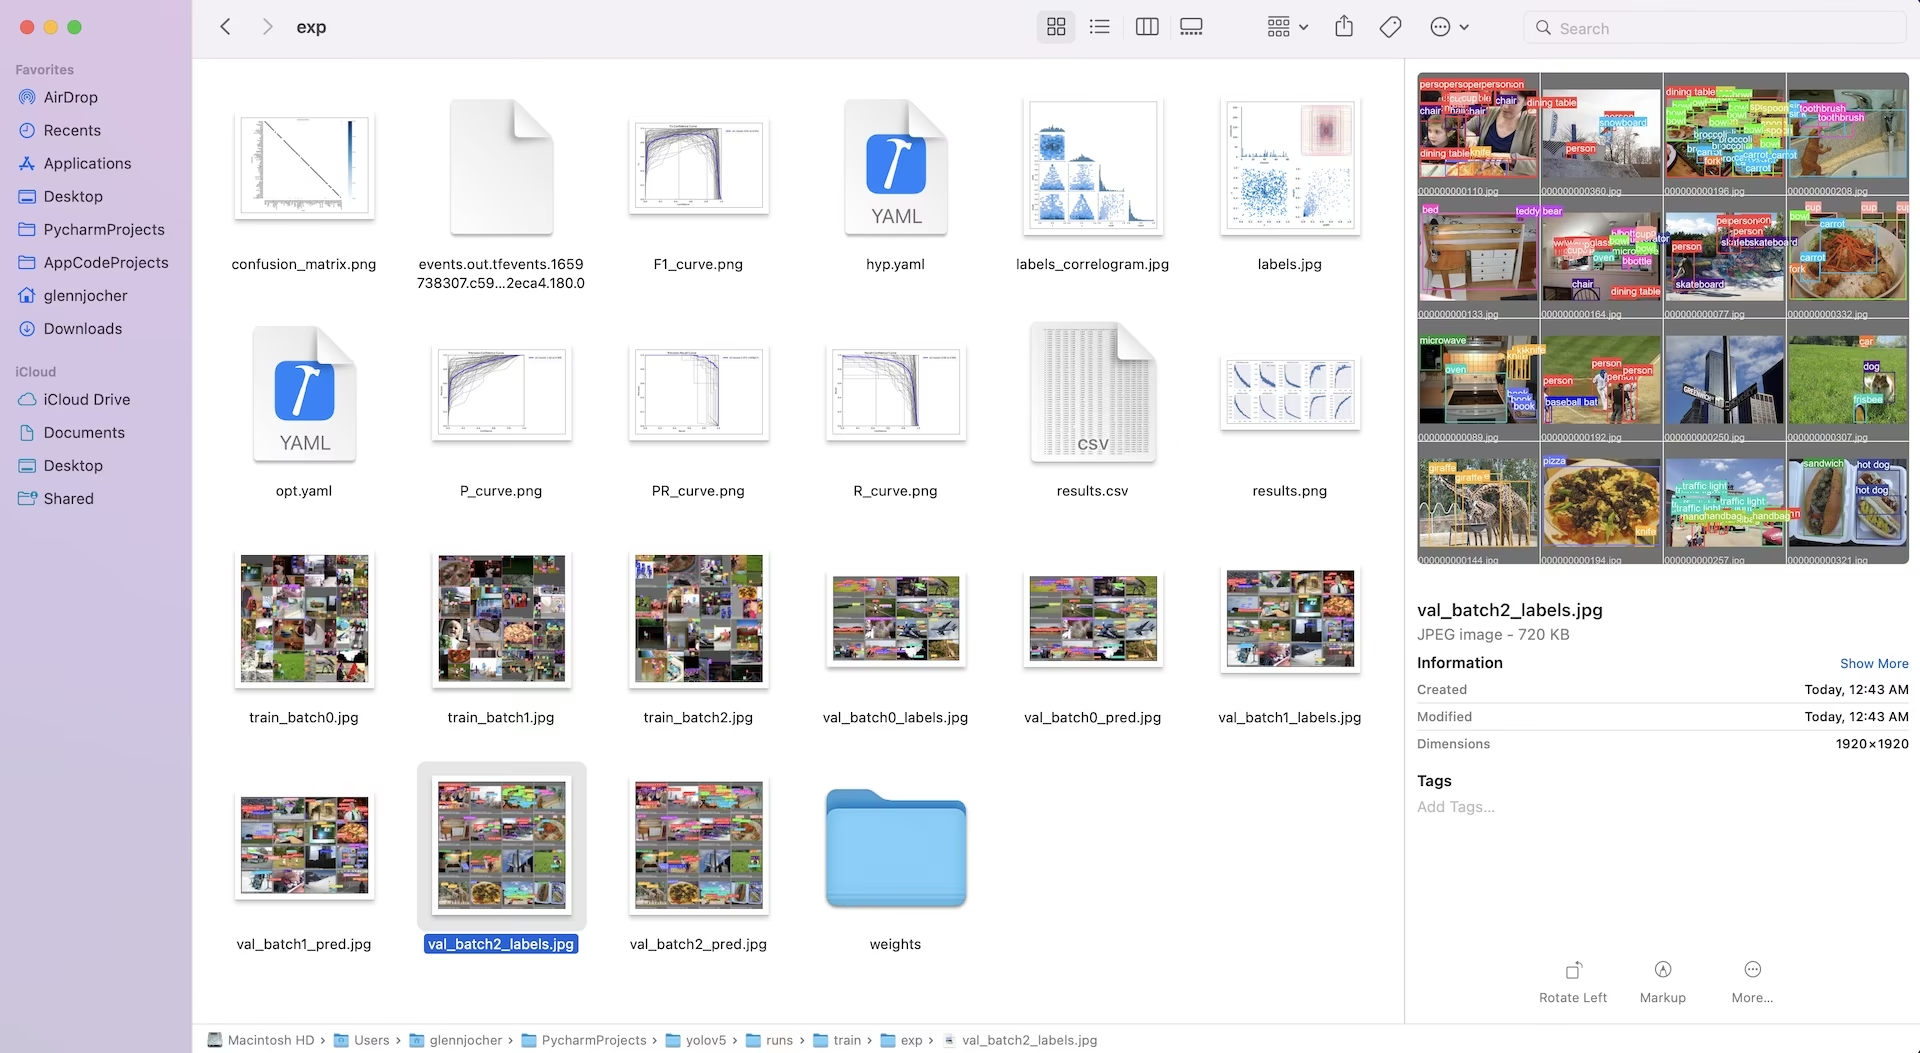
Los resultados del entrenamiento se registran automáticamente con TensorBoard y se guardan como archivos CSV en el directorio del experimento correspondiente (por ejemplo, runs/train/exp). Los datos registrados incluyen:
- Pérdida de entrenamiento y validación, y métricas de rendimiento.
- Imágenes de muestra que muestran las aumentaciones aplicadas (como mosaicos).
- Etiquetas de referencia junto con predicciones del modelo para su inspección visual.
- Métricas de evaluación clave, como las curvas de precisión-recuperación (PR).
- Matrices de confusión para analizar en detalle el rendimiento por clase.
El archivo results.csv se actualiza después de cada época y se representa como results.png al finalizar el entrenamiento. También puedes representar manualmente cualquier archivo results.csv con la función de utilidad proporcionada:
from utils.plots import plot_results

# Representa los resultados de un directorio de ejecución de entrenamiento específico
plot_results("runs/train/exp/results.csv")  # Esto generará 'results.png' en el mismo directorio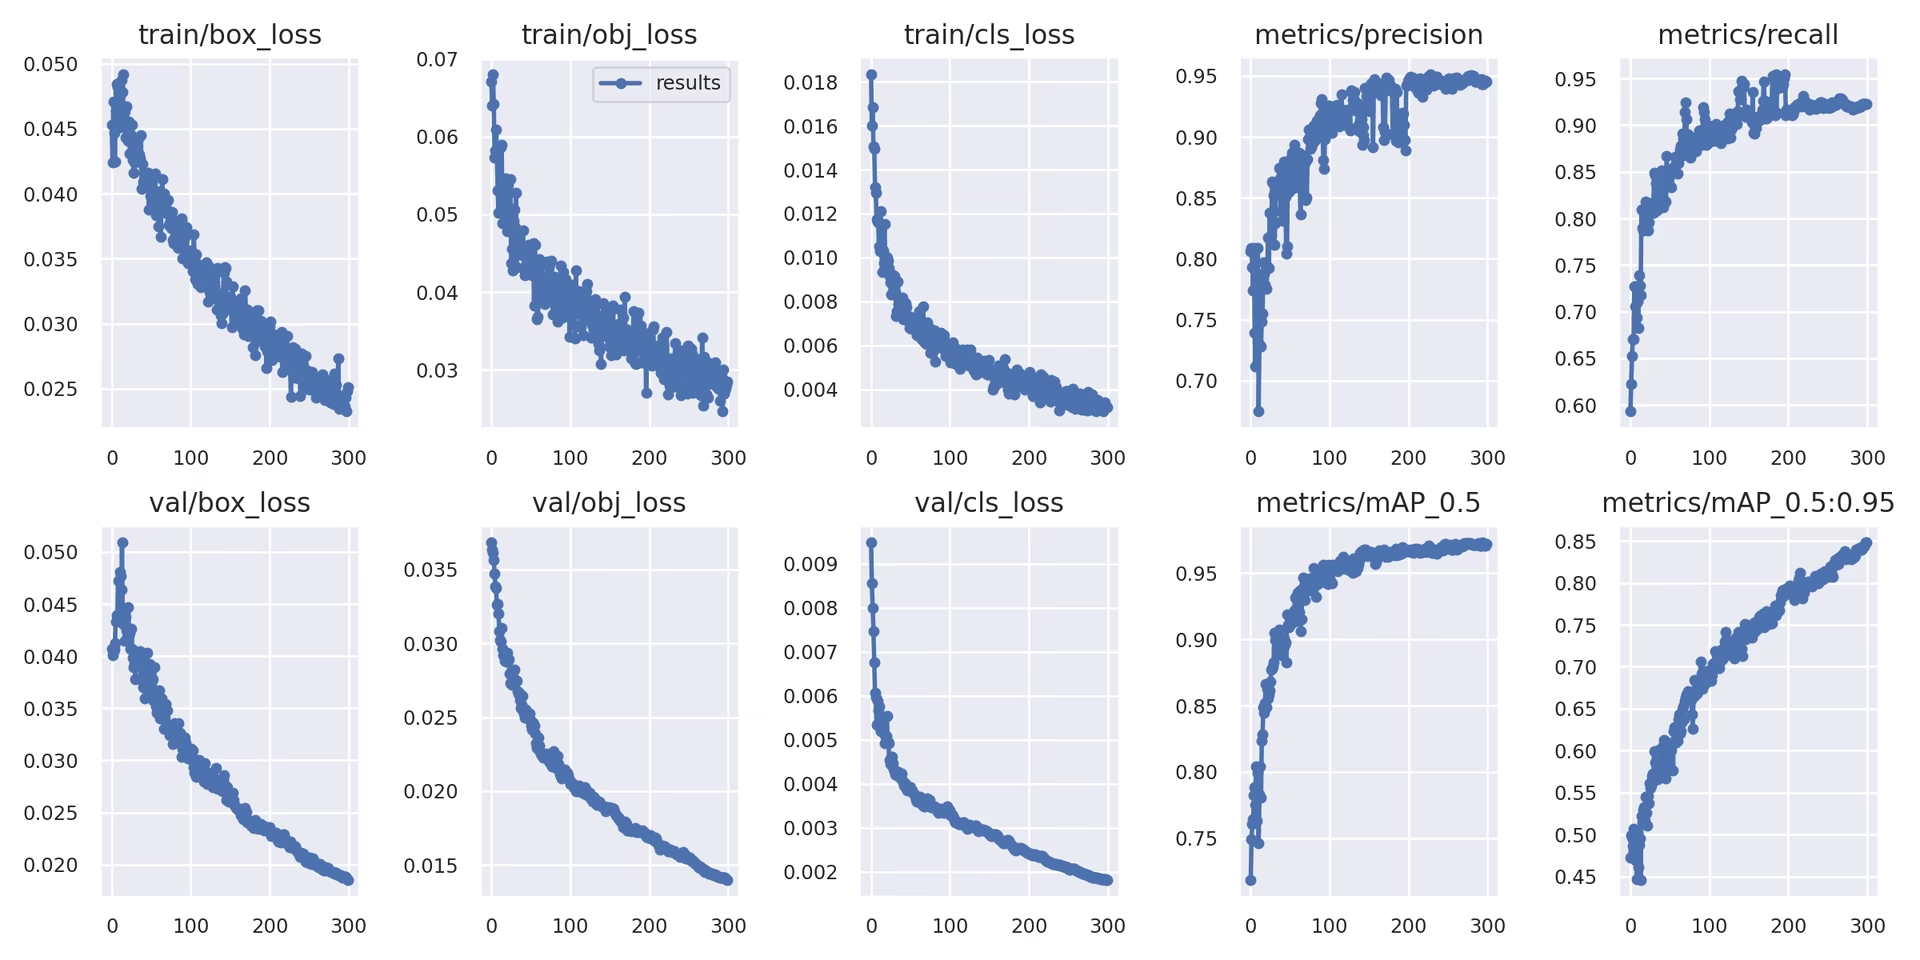
5. Próximos pasos#
Al completar el entrenamiento correctamente, se guarda el punto de control del modelo con mejor rendimiento (best.pt), listo para el despliegue o para seguir perfeccionándolo. Estos son algunos de los pasos siguientes que puedes dar:
- Ejecuta inferencias con imágenes o vídeos nuevos usando el modelo entrenado mediante la CLI o Python.
- Ejecuta
val.pypara evaluar la precisión del modelo y su capacidad de generalización con distintas particiones de datos (por ejemplo, un conjunto de prueba reservado). - Exporta el modelo a distintos formatos de despliegue, como ONNX, TensorFlow SavedModel o TensorRT, para optimizar las inferencias en diversas plataformas.
- Usa la evolución de hiperparámetros para intentar mejorar aún más el rendimiento.
- Sigue mejorando tu modelo con nuestros consejos para obtener los mejores resultados de entrenamiento y añade progresivamente datos más diversos y difíciles basándote en el análisis del rendimiento.
Entornos compatibles#
Ultralytics ofrece entornos listos para usar con dependencias esenciales como CUDA, cuDNN, Python y PyTorch, para que puedas empezar sin complicaciones.
- Cuadernos gratuitos con GPU:
- Plataformas en la nube:
- Google Cloud: Guía de inicio rápido de GCP
- Amazon AWS: guía de inicio rápido de AWS
- Microsoft Azure: guía de inicio rápido de AzureML
- Configuración local:
- Docker: Guía de inicio rápido de Docker
- Docker: Guía de inicio rápido de Docker


Estado del proyecto#

Esta insignia indica que todas las pruebas de integración continua (CI) de GitHub Actions de YOLOv5 se superan correctamente. Estas rigurosas pruebas de CI cubren las funciones principales, como el entrenamiento, la validación, la inferencia, la exportación y las pruebas de rendimiento, en macOS, Windows y Ubuntu. Las pruebas se ejecutan automáticamente cada 24 horas y con cada confirmación de código para garantizar una estabilidad constante y un rendimiento óptimo.
Preguntas frecuentes#
Entrenar YOLOv5 con un conjunto de datos personalizado implica varios pasos clave:
- Prepara tu conjunto de datos: recopila imágenes y anótalas. Asegúrate de que las anotaciones estén en el formato YOLO requerido. Organiza las imágenes y las etiquetas en los directorios
train/yval/(y, opcionalmente, entest/). Plantéate usar modelos como Google Gemini, SAM2 o YOLOWorld para facilitar o automatizar el proceso de etiquetado (consulta la sección 1.2). - Configura tu entorno: clona el repositorio de YOLOv5 e instala las dependencias con
pip install -r requirements.txt.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - Crea la configuración del conjunto de datos: define las rutas del conjunto de datos, el número de clases y los nombres de las clases en un archivo
dataset.yaml. - Inicia el entrenamiento: ejecuta el script
train.pye indica las rutas a tudataset.yaml, los pesos preentrenados que quieras usar (p. ej.,yolov5s.pt), el tamaño de imagen, el tamaño del lote y el número de épocas.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- Prepara tu conjunto de datos: recopila imágenes y anótalas. Asegúrate de que las anotaciones estén en el formato YOLO requerido. Organiza las imágenes y las etiquetas en los directorios
Ultralytics Platform es una plataforma integral diseñada para agilizar todo el ciclo de vida del desarrollo de modelos YOLO, a menudo sin necesidad de escribir código. Estas son algunas de sus principales ventajas:
- Entrenamiento simplificado: entrena modelos fácilmente con entornos preconfigurados y una interfaz de usuario intuitiva.
- Gestión de datos integrada: sube, controla las versiones y gestiona tus conjuntos de datos de forma eficiente desde la plataforma.
- Supervisión en tiempo real: sigue el progreso del entrenamiento y visualiza las métricas de rendimiento a medida que se generan.
- Funciones de colaboración: facilita el trabajo en equipo con recursos compartidos, herramientas de gestión de proyectos y opciones sencillas para compartir modelos.
- Despliegue sin código: despliega los modelos entrenados directamente en distintos destinos.
Para ver una guía práctica, consulta nuestra publicación del blog: Cómo entrenar tus modelos personalizados con Ultralytics Platform.
Tanto si anotas manualmente como si usas herramientas automatizadas (como las mencionadas en la sección 1.2), las etiquetas finales deben estar en el formato YOLO específico que requiere YOLOv5:
- Crea un archivo
.txtpara cada imagen. El nombre del archivo debe coincidir con el nombre de la imagen (p. ej.,image1.jpgcorresponde aimage1.txt). Coloca estos archivos en un directoriolabels/, al mismo nivel que el directorioimages/(p. ej.,../datasets/mydataset/labels/train/). - Cada línea de un archivo
.txtrepresenta la anotación de un objeto y sigue este formato:class_index center_x center_y width height. - Las coordenadas (
center_x,center_y,width,height) deben estar normalizadas (valores entre 0.0 y 1.0) con respecto a las dimensiones de la imagen. - Los índices de clase empiezan en cero (la primera clase es
0, la segunda es1, etc.).
Muchas herramientas de anotación manual permiten exportar directamente al formato YOLO. Si usas modelos automatizados, necesitarás scripts o procesos para convertir sus resultados (p. ej., coordenadas de cuadros delimitadores o máscaras de segmentación) a este formato de texto normalizado específico. Asegúrate de que la estructura final del conjunto de datos se ajuste al ejemplo de la guía. Para obtener más información, consulta nuestra Guía de recopilación y anotación de datos.
- Crea un archivo
Ultralytics ofrece licencias flexibles adaptadas a distintas necesidades:
- Licencia AGPL-3.0: esta licencia de código abierto es adecuada para la investigación académica, los proyectos personales y los casos en los que cumplir las condiciones del código abierto sea aceptable. Exige que las modificaciones y las obras derivadas también se publiquen como código abierto bajo AGPL-3.0. Consulta los detalles de la licencia AGPL-3.0.
- Licencia Enterprise: una licencia comercial diseñada para empresas que integran YOLOv5 en productos o servicios propietarios. Esta licencia elimina las obligaciones de código abierto de AGPL-3.0 y permite distribuir software de código cerrado. Visita nuestra página de licencias para obtener más información o solicitar una licencia Enterprise.
Elige la licencia que mejor se adapte a los requisitos y al modelo de distribución de tu proyecto.