Exportación de modelos YOLO26 a TensorRT
TensorRT es el SDK de NVIDIA para la inferencia de aprendizaje profundo de alta velocidad. Al exportar un modelo Ultralytics YOLO26 con format="engine", se crea un archivo .engine optimizado para la GPU NVIDIA en la que se compila, con precisión FP32, FP16 o INT8.
TensorRT optimiza un motor para la GPU en la que se compila. Compila el motor en la GPU de despliegue o en otra del mismo modelo y con la misma versión de TensorRT; un archivo .engine no es un formato de modelo portátil. Para el despliegue en el borde, Ultralytics Platform ofrece ocho opciones de destino Jetson, con el estado de compilación física y validación documentado para cada una, o puedes exportar localmente en el dispositivo de destino.
Resumen#
| Propiedad | Detalles |
|---|---|
Argumento format | engine (alias: tensorrt, trt) |
| Salida | yolo26n.engine, un archivo que empieza con una cabecera de metadatos JSON (nombres de clases, tarea y tamaño de imagen). El archivo intermedio yolo26n.onnx se guarda junto a él |
| Se ejecuta en | GPU NVIDIA: centros de datos, estaciones de trabajo y Jetson, incluidos los núcleos DLA de Jetson (no disponible en TensorRT 11) |
| Entorno de ejecución | TensorRT 7.0 o posterior (no se admite la versión 10.2.0) |
| Precisión | FP32, FP16, INT8 |
| Equipo de exportación | Una máquina con GPU NVIDIA y CUDA. Compila en la GPU de despliegue o en otra del mismo modelo |
Ultralytics Platform puede compilar un motor TensorRT por ti en el tipo de GPU que elijas, incluidos los destinos NVIDIA Jetson, para que no necesites un entorno de exportación local.
Inicio rápido#
Instala el paquete Ultralytics en una máquina con GPU NVIDIA y CUDA. En Linux, si falta, la primera exportación instala el paquete Python de TensorRT compatible con tu versión de CUDA. En NVIDIA Jetson, usa la versión de TensorRT incluida con JetPack. En Windows, instala TensorRT por tu cuenta antes de exportar.
pip install ultralyticsPara otros métodos de instalación, consulta la guía de instalación. Después, exporta tu modelo y carga el motor exportado para ejecutar inferencias o validar su precisión. La inferencia y la validación requieren una GPU NVIDIA. Compilar un motor YOLO26n tarda entre uno y tres minutos en una NVIDIA T4.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato TensorRT
model.export(format="engine")  # crea 'yolo26n.engine'

# O exporta un motor FP16 en su lugar
model.export(format="engine", quantize=16) # crea 'yolo26n.engine'from ultralytics import YOLO
# Carga el modelo exportado a TensorRT
model = YOLO("yolo26n.engine")
# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carga el modelo exportado a TensorRT
model = YOLO("yolo26n.engine")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Tareas compatibles#
La exportación a TensorRT admite las siete tareas de Ultralytics con modelos YOLOv8, YOLO11 y YOLO26: detección, segmentación, segmentación semántica, estimación de profundidad, clasificación, estimación de pose y OBB. La segmentación semántica y la estimación de profundidad solo están disponibles con YOLO26, la única familia que incluye esas cabezas.
Argumentos de exportación#
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'engine' | Formato de destino del modelo exportado, que define su compatibilidad con distintos entornos de implementación. |
imgsz | int o tuple | 640 | Tamaño de imagen deseado para la entrada del modelo. Puede ser un número entero para imágenes cuadradas o una tupla (height, width) para dimensiones específicas. |
quantize | int o str | None | Precisión de cuantización: 16 (FP16) o 8 (INT8/PTQ; requiere calibración data/fraction); 32/sin configurar corresponde a FP32. Un checkpoint entrenado con quantize=8 exporta a INT8 usando los rangos que contiene, sin calibración, también cuando quantize no está configurado; quantize=16 o quantize=32 genera un error. Sustituye a las marcas half/int8, obsoletas. |
dynamic | bool | False | Compila un motor que admite tamaños de lote de 1 a batch y tamaños de imagen de 32 píxeles hasta el doble de imgsz; el mínimo es mayor para los motores INT8 dinámicos en GPU antiguas. Cuando se establece False, el motor solo admite los valores batch y imgsz de la exportación. |
simplify | bool | True | Simplifica el grafo del modelo con onnxslim, lo que puede mejorar el rendimiento y la compatibilidad. |
opset | int | None | Especifica la versión del opset de ONNX para el grafo ONNX intermedio. Si no se establece, se usa el opset 18 (inferior en PyTorch < 2.4), limitado a la versión instalada de onnx. |
workspace | float o None | None | Límite superior, en GiB, de la memoria que TensorRT utiliza para compilar el motor. Déjalo en None para que TensorRT asigne la memoria automáticamente. |
nms | bool, opcional | None | Selecciona la salida sin procesar (None, predeterminada), NMS integrado (True) o la cabeza sin NMS (False). Con nms=True, conf (0.25 de forma predeterminada), iou, max_det y agnostic_nms quedan fijados durante la exportación; nms=True se ignora para los modelos de segmentación semántica y profundidad, y genera un error en los modelos de clasificación. |
batch | int | 1 | Tamaño del lote del motor o tamaño máximo del lote con dynamic=True. También es el tamaño del lote utilizado para la calibración INT8. |
data | str | None | Ruta al archivo YAML del conjunto de datos, que se usa para la calibración INT8; en clasificación, se indica en su lugar un directorio de conjunto de datos o el nombre de un conjunto de datos integrado. La calibración utiliza la partición val, salvo que se establezca split. Si se omite con quantize=8, Ultralytics utiliza el pequeño conjunto de datos predeterminado para la tarea del modelo, como coco8.yaml para detección; un checkpoint entrenado con quantize=8 no necesita ninguno. |
fraction | float, int o list | 1.0 | Subconjunto de calibración expresado como proporción, número de imágenes o proporciones/recuentos [train, val, test]. Las listas de dos elementos dejan completo test, mientras que 0 lo omite. |
device | str | None | Especifica el dispositivo para la exportación: GPU (device=0, si no se configura), DLA para NVIDIA Jetson (device=dla:0 o device=dla:1, con quantize=16 o quantize=8). |
En NVIDIA Jetson, Ultralytics exporta con el entorno de ejecución TensorRT de tu versión de JetPack. En JetPack 7, la exportación requiere TensorRT 10.15 o posterior, pero anterior a la versión 11. device=dla:0 y device=dla:1 generan un error con TensorRT 11. NVIDIA indica que TensorRT 10.7 es la última versión 10.x con compatibilidad con DLA, y TensorRT 11.4.1 añade compatibilidad con JetPack 7.2.2, que Ultralytics todavía no utiliza.
Para consultar los argumentos comunes a todos los formatos, visita la documentación del modo de exportación.
Exportación a TensorRT con cuantización INT8#
quantize=8 genera un motor INT8 con cuantización posterior al entrenamiento (PTQ): la exportación procesa imágenes de calibración con el modelo para medir el rango de valores de cada tensor. Un checkpoint ajustado con quantize=8 mediante entrenamiento consciente de la cuantización ya contiene sus rangos INT8, por lo que su exportación omite la calibración.
Los argumentos quantize y data son iguales en todas las versiones de TensorRT, pero la exportación de un checkpoint no entrenado con quantize=8 funciona de forma distinta internamente:
| TensorRT 7-10 | TensorRT 11 | |
|---|---|---|
| Método INT8 | Cuantización implícita con la interfaz IInt8Calibrator | Cuantización explícita: NVIDIA ModelOpt inserta nodos Q/DQ en el grafo ONNX |
| Algoritmo de calibración | MINMAX_CALIBRATION en GPU, ENTROPY_CALIBRATION_2 para DLA | ModelOpt max, ejecutado en la CPU |
| Imágenes de calibración utilizadas | Cada lote completo de la partición | Unas 512 imágenes en orden aleatorio, o cada lote completo de una partición más pequeña |
dynamic=True con quantize=8 | No está cubierto por las pruebas; exporta sin dynamic=True | Compatible |
FP16 (quantize=16) | Indicador del compilador de TensorRT | Conversión de precisión mixta ModelOpt |
ModelOpt se instala la primera vez que se utiliza. Ultralytics no reutiliza la caché de calibración, por lo que cada exportación vuelve a calibrar. Para obtener información sobre ambos métodos, consulta Trabajar con tipos cuantizados en la documentación de TensorRT.
Para un checkpoint no entrenado con quantize=8, pasa imágenes de calibración con data, por ejemplo data="my_dataset.yaml". La calibración utiliza la partición val de ese conjunto de datos, salvo que establezcas split, y fraction limita el número de imágenes. NVIDIA recomienda al menos 500 imágenes representativas de los datos de despliegue, y la exportación registra una advertencia si hay menos de 300. Si no se indica data, la exportación registra una advertencia y utiliza el pequeño conjunto de datos de ejemplo para la tarea del modelo, como coco8.yaml para detección. Su partición de validación tiene 4 imágenes, suficientes para probar la exportación, pero no para calibrar un modelo para el despliegue.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Calibra con el 10 % de las imágenes de validación de COCO (500 imágenes); sustituye coco.yaml por tu propio conjunto de datos
model.export(format="engine", quantize=8, data="coco.yaml", fraction=0.1)

# Carga el motor INT8 exportado y ejecuta la inferencia
model = YOLO("yolo26n.engine")
result = model.predict("https://ultralytics.com/images/bus.jpg")
En la GPU de referencia, los motores INT8 fueron entre 1,04 y 2,3 veces más rápidos que los motores FP32, pero solo superaron en velocidad a los motores FP16 en tres de los diez modelos. INT8 perdió entre 1,7 y 2,9 mAP en YOLO26n a YOLO26l, y mucho más en YOLO26x y YOLO26n-pose. El motor INT8 de YOLO26n era más grande que su motor FP32 (30 MB frente a 11 MB), mientras que los modelos grandes redujeron su tamaño (53 MB frente a 103 MB en YOLO26l). INT8 también puede alterar los valores de confianza, así que elige el umbral de confianza a partir de la curva F1 del propio motor INT8. Consulta los resultados de referencia de cada modelo.
Formato de salida#
El motor recibe una entrada llamada images y devuelve las mismas salidas que la exportación ONNX a partir de la que se ha creado, con una excepción: en las versiones de TensorRT anteriores a la 10, los modelos semánticos devuelven puntuaciones de clase float con la forma (batch, classes, height, width) en lugar del mapa de clases uint8. Consulta el formato de salida de ONNX para ver la forma de salida de cada tarea y cada valor de nms.
Cargar el motor fuera de Ultralytics#
Un archivo .engine de Ultralytics no es un motor TensorRT sin más. Empieza con una longitud de 4 bytes en orden little-endian, seguida de esa cantidad de bytes de metadatos JSON y, después, el motor serializado. deserialize_cuda_engine de TensorRT devuelve None cuando recibe el archivo completo. Omite la cabecera para cargar el motor con la API de TensorRT:
import json

import tensorrt as trt

with open("yolo26n.engine", "rb") as f:
    n = int.from_bytes(f.read(4), byteorder="little")  # longitud de la cabecera de metadatos
    metadata = json.loads(f.read(n))  # nombres de clases, tarea, imgsz, lote, argumentos de exportación
    engine = trt.Runtime(trt.Logger(trt.Logger.WARNING)).deserialize_cuda_engine(f.read())
Si otra herramienta necesita un archivo de motor TensorRT sin más, escribe los bytes posteriores a la cabecera en un archivo nuevo o compila el motor con esa herramienta a partir del archivo yolo26n.onnx que la exportación deja junto al motor. En TensorRT 11, las exportaciones FP16 e INT8 calibradas también dejan yolo26n.fp16.onnx y yolo26n.int8.onnx; compila un motor INT8 con otra herramienta a partir del archivo .int8.onnx. Para un checkpoint entrenado con quantize=8, yolo26n.onnx ya contiene los nodos Q/DQ, y no se escribe ningún archivo .int8.onnx; en TensorRT 11, esa exportación deja yolo26n.fp16.onnx, el mismo grafo Q/DQ con sus otras capas en FP16.
Despliega#
YOLO("yolo26n.engine") carga el motor con el entorno de ejecución de TensorRT para Python. El motor se ejecuta en la GPU 0 de forma predeterminada, incluso si pasas device="cpu". Pasa device=1 para ejecutarlo en otra GPU del mismo modelo. Un motor exportado con device=dla:0 o device=dla:1 se ejecuta en ese núcleo DLA.
Un motor exportado sin dynamic=True tiene una forma de entrada fija. Predict y val utilizan el valor imgsz de la exportación e ignoran cualquier argumento imgsz distinto. Ultralytics divide los lotes más grandes en lotes del tamaño de exportación y rellena los más pequeños, por lo que se admite cualquier número de imágenes. Un motor exportado con dynamic=True admite cualquier tamaño de lote e imagen dentro de su rango y genera ValueError: input size ... is outside the TensorRT optimization profile si la forma queda fuera de ese rango. Con nms=True, un lote que supere el rango se divide en lotes del tamaño de exportación.
Guías de despliegue#
-
NVIDIA Triton Inference Server: sirve una exportación ONNX con el acelerador TensorRT de Triton, que compila el motor en la GPU del servidor.
-
Inicio rápido de NVIDIA Jetson: configura Ultralytics en dispositivos Jetson y exporta motores TensorRT con JetPack, incluido DLA.
-
Inicio rápido de NVIDIA DGX Spark: configura Ultralytics y TensorRT en NVIDIA DGX Spark.
-
DeepStream en NVIDIA Jetson: ejecuta modelos exportados en flujos de vídeo de NVIDIA DeepStream.
-
NVIDIA TensorRT en GitHub: código fuente, ejemplos y herramientas para TensorRT.
Limitaciones y solución de problemas#
- Los motores no son portátiles: cada motor se compila para un modelo de GPU y una versión de TensorRT. Vuelve a compilarlo si cambias la GPU, la versión de TensorRT o la versión de JetPack. Si no se puede cargar un motor, Ultralytics registra
TensorRT model exported with a different version than expected. - Se necesita una GPU: la exportación utiliza
device=0si no se establecedevicey falla conexport running on CPU but must be on GPUparadevice=cpu. - El motor no se carga en otras herramientas: el archivo
.engineempieza con una cabecera de metadatos, por lo que la API de TensorRT no puede leerlo directamente. Consulta Cargar el motor fuera de Ultralytics. - Versión de TensorRT: Ultralytics requiere TensorRT 7.0.0 o posterior. TensorRT 10.2.0 no es compatible y la instalación automática lo omite. En JetPack 7 y los sistemas NVIDIA DGX, la exportación requiere TensorRT 10.15 o posterior (y anterior a la 11 en Jetson) e intenta instalarlo si la versión instalada queda fuera de ese rango.
- Cabeza sin NMS en versiones antiguas de TensorRT: las versiones de TensorRT anteriores a la 8.5.0 no pueden compilar la cabeza YOLO26 sin NMS. La exportación registra una advertencia y escribe predicciones sin procesar que requieren NMS. Actualiza TensorRT a la versión 8.5.0 o posterior para exportar con
nms=False. - INT8 en JetPack 6: con TensorRT 10.3.0 en JetPack 6, falla una exportación INT8 con
nms=True, y una exportación INT8 connms=Falsevuelve a las predicciones sin procesar. Consulta la guía de Jetson para ver la solución. - INT8 en TensorRT 10.16: la exportación INT8 con TensorRT 10.16.1 falló en las GPU NVIDIA RTX PRO 6000 Blackwell y RTX 6000D con
Could not find any implementation for node. En la RTX PRO 6000 Blackwell, TensorRT 10.13, 10.14, 10.15 y 11.4 compilaron el motor INT8. - DLA:
device=dla:0ydevice=dla:1solo funcionan en NVIDIA Jetson y únicamente conquantize=16oquantize=8. La exportación genera un error en TensorRT 11. Las capas no compatibles con DLA se ejecutan en la GPU. - Formas dinámicas:
dynamic=Truenecesita un tamaño máximo de lote, así que establece tambiénbatch, por ejemplobatch=8. Si no lo haces, la exportación registra una advertencia y el tamaño máximo del lote es 1. El motor admite lotes de 1 abatchy tamaños de imagen de 32 píxeles hasta el doble del valorimgszde exportación. Por ejemplo, un motor exportado conimgsz=320 batch=4se ejecuta con 640 píxeles y rechaza 704 píxeles o un lote de 6 coninput size ... is outside the TensorRT optimization profile. Combinadynamic=Trueconquantize=8únicamente en TensorRT 11. En GPU con una capacidad de cómputo de 7.5 o inferior, como la T4, el tamaño mínimo de estos motores INT8 dinámicos es de 64 píxeles (128 para modelos P6). - Tamaño de entrada fijo: un motor exportado sin
dynamic=Truesiempre se ejecuta con el valorimgszde la exportación. Pasar otro valorimgsza predict o val no tiene ningún efecto, así que vuelve a exportar para cambiar el tamaño de entrada. - Exportación INT8 sin
data: salvo que el checkpoint se haya entrenado conquantize=8, la exportación calibra con el pequeño conjunto de datos predeterminado para la tarea, que tiene 4 imágenes de validación para detección, y registra una advertencia. Pasadatacon imágenes representativas; la exportación avisa si hay menos de 300. - Inferencias iniciales lentas: las primeras llamadas con un motor nuevo, o con un nuevo
imgszen un motor dinámico, tardan más que las posteriores.
Para otros errores, consulta la guía de problemas habituales.
Pruebas de rendimiento#
La página del modelo YOLO26 muestra la velocidad con TensorRT 10 de cada modelo en una GPU NVIDIA T4 para todas las tareas, salvo la segmentación semántica.
Comparativa entre FP32, FP16 e INT8#
Las tablas siguientes comparan PyTorch con motores TensorRT 11.4 FP32, FP16 e INT8 para todos los modelos de detección YOLO26 y para el modelo YOLO26n en otras cinco tareas. Todos los valores se midieron en una misma GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Milisegundos por imagen; cuanto menos, mejor. El formato más rápido de cada modelo aparece en negrita; se excluye el motor INT8 de YOLO26x porque su precisión era inestable.
| Modelo | imgsz | PyTorch | TensorRT FP32 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 0.67 | 0.48 | 0.53 |
| YOLO26s | 640 | 2.98 | 1.15 | 0.61 | 0.66 |
| YOLO26m | 640 | 3.29 | 2.22 | 1.03 | 1.08 |
| YOLO26l | 640 | 4.70 | 3.03 | 1.49 | 1.43 |
| YOLO26x | 640 | 5.93 | 4.31 | 2.09 | 1.84 |
| YOLO26n-seg | 640 | 3.18 | 0.93 | 0.65 | 0.72 |
| YOLO26n-sem | 1024 | 1.74 | 0.74 | 0.45 | 0.71 |
| YOLO26n-cls | 224 | 1.75 | 0.29 | 0.24 | 0.20 |
| YOLO26n-pose | 640 | 3.39 | 0.76 | 0.51 | 0.59 |
| YOLO26n-obb | 1024 | 4.55 | 1.03 | 0.64 | 0.88 |
- FP16 mantuvo la precisión de FP32 con una diferencia inferior a 0,1 puntos en todos los modelos. En los modelos de detección, fue entre 1,4 y 2,2 veces más rápido que el motor FP32 y entre 2,8 y 5,9 veces más rápido que PyTorch.
- INT8 tuvo una latencia que quedó dentro de un margen del 12 % respecto a FP16 en los modelos de detección y perdió entre 1,7 y 2,9 mAP en YOLO26n, YOLO26s, YOLO26m y YOLO26l. En esta GPU, solo fue más rápido que FP16 en YOLO26l, YOLO26x y YOLO26n-cls.
- La precisión de YOLO26x INT8 cayó a un intervalo de entre 25,3 y 38,5 mAP en tres compilaciones, frente a 57,5 en FP32. YOLO26n-pose INT8 bajó de 56,7 a 33,4 mAP de pose. Valida cada motor INT8 con tus propios datos antes de desplegarlo.
- Los motores FP32 y FP16 de TensorRT 10.16 para YOLO26n y YOLO26s igualaron la precisión de TensorRT 11.4. Sus motores FP16 fueron aproximadamente un 7 % más rápidos y sus motores FP32, entre un 4 % y un 9 % más lentos que con TensorRT 11.4.
Para NVIDIA Jetson y DGX Spark, consulta las pruebas de rendimiento de Jetson y la guía de DGX Spark.
Medido con ultralytics 8.4.211, TensorRT 11.4.0, PyTorch 2.15.0 y CUDA 13.2 en batch=1 el 13 de noviembre de 2026. La latencia corresponde a la fase de inferencia que indica val y no incluye el preprocesamiento ni el posprocesamiento.
Acerca de TensorRT#
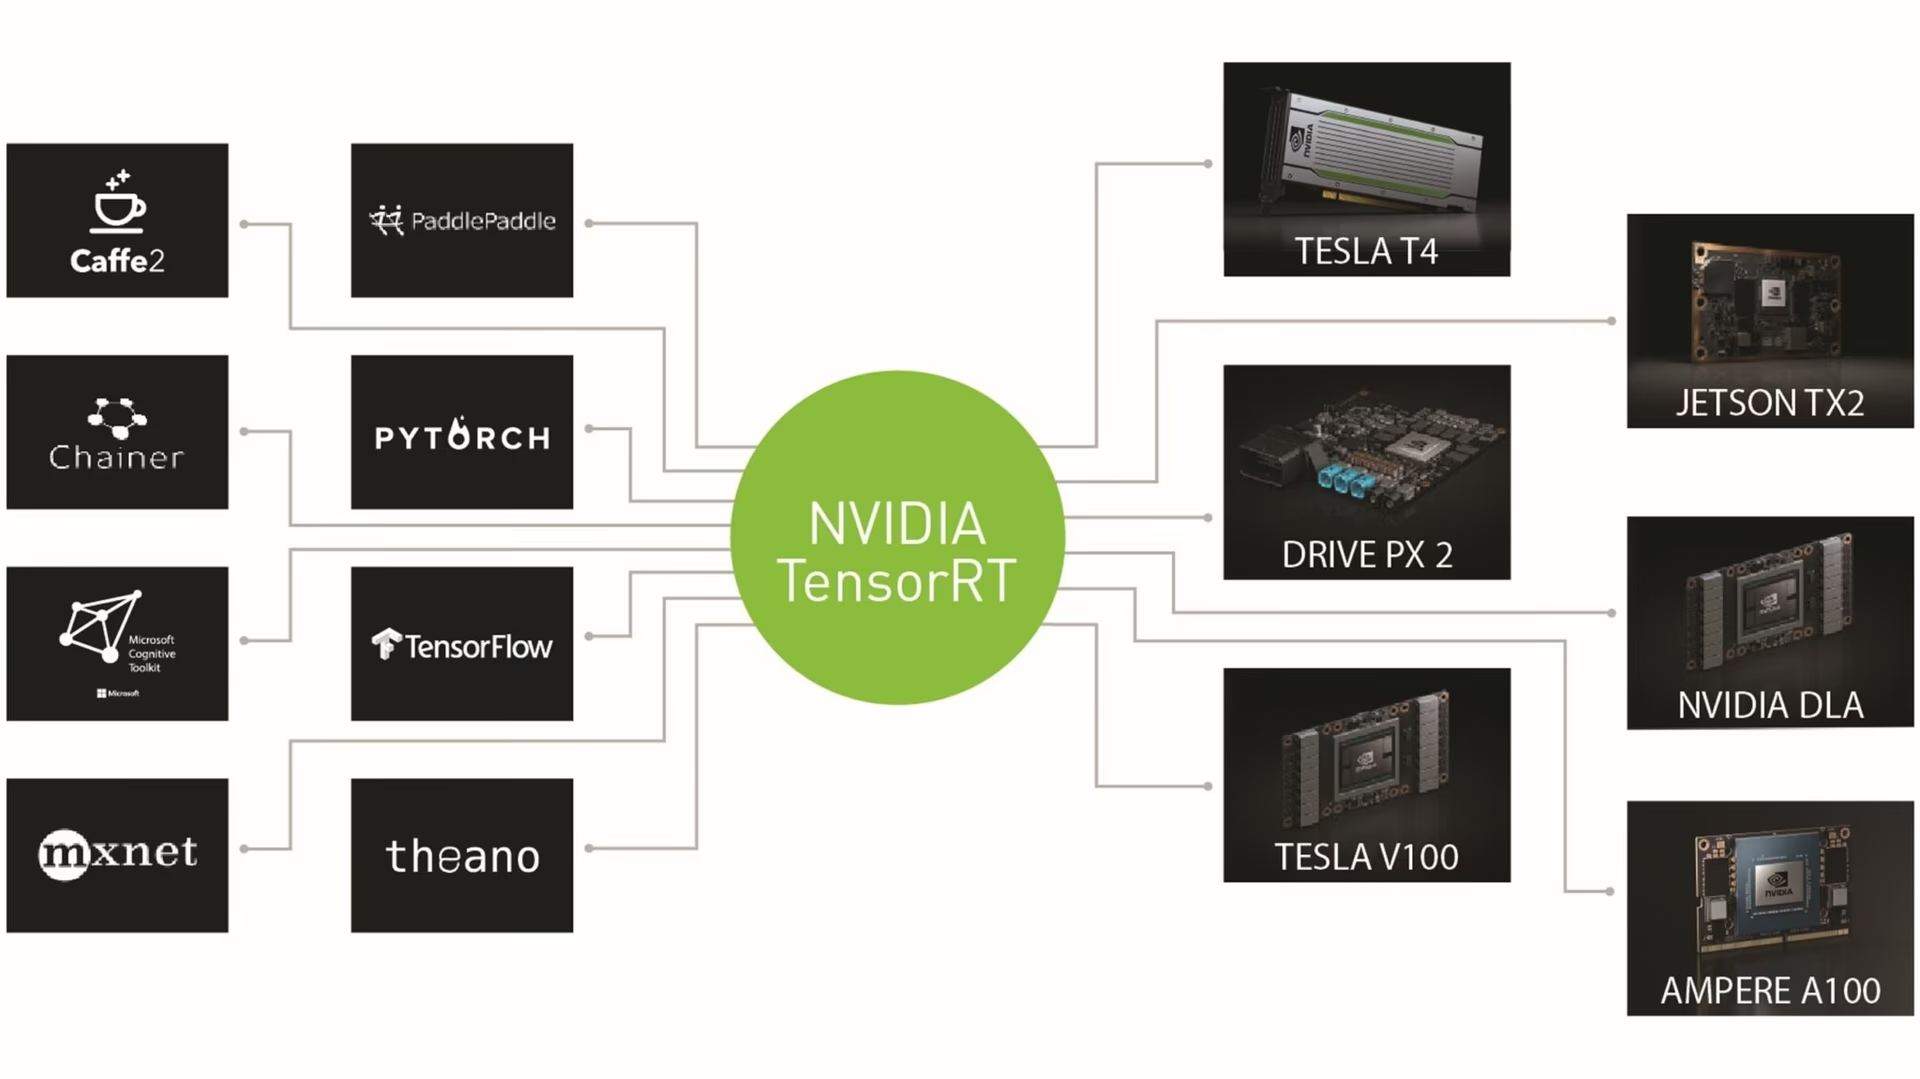
TensorRT compila un motor fusionando capas, seleccionando el kernel más rápido para cada capa en la GPU de compilación y, de forma opcional, reduciendo la precisión a FP16 o INT8. Para consultar la referencia completa, visita la documentación de TensorRT.
Preguntas frecuentes#
Solo en una GPU del mismo modelo y con la misma versión de TensorRT. Un motor se compila para un modelo de GPU y una versión de TensorRT concretos. Para compartir un archivo entre distintos tipos de hardware, exporta a ONNX y compila el motor en cada dispositivo. Para NVIDIA Jetson, Ultralytics Platform puede compilar motores para ocho modelos de Jetson.
Empieza por FP16 (
quantize=16). No necesita datos de calibración y mantiene la precisión de FP32. En las pruebas de rendimiento con una NVIDIA RTX PRO 6000 Blackwell y TensorRT 11.4, FP16 redujo la latencia de YOLO26s de 1,15 ms a 0,61 ms por imagen, con el mismo resultado de 48,5 mAPvalidación 50-95. INT8 (quantize=8) alcanzó 0,66 ms y 46,3 mAPvalidación 50-95, así que no fue más rápido que FP16 en esa GPU, y necesita datos de calibración representativos, salvo que el punto de control se haya entrenado conquantize=8. INT8 puede resultar útil en otros equipos: las pruebas de rendimiento de Jetson muestran resultados de FP16 e INT8 para dispositivos integrados. Mide ambas precisiones en el dispositivo donde vayas a desplegar el modelo antes de elegir INT8.Exporta con
dynamic=Truey establecebatchen el tamaño de lote más grande que tengas previsto usar. El motor acepta entonces tamaños de lote de 1 abatchy tamaños de imagen desde 32 píxeles hasta el doble del tamaño de imagen de exportaciónimgsz, con un mínimo más alto para los motores INT8 dinámicos en GPU más antiguas. Sindynamic=True, el motor tiene una única forma de entrada fija y Ultralytics divide cada lote o le añade relleno para ajustarlo a esa forma.Motor dinámicofrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", dynamic=True, batch=8, quantize=16) model = YOLO("yolo26n.engine") results = model(["https://ultralytics.com/images/bus.jpg"] * 4, batch=4) # un lote de 4 imágenesEjecuta la exportación en la propia Jetson con la versión de TensorRT incluida en tu versión de JetPack. Para usar un núcleo DLA, añade
device=dla:0conquantize=16oquantize=8. Consulta la guía de NVIDIA Jetson para ver la configuración y las pruebas de rendimiento.Exportar en Jetsonfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", quantize=16) # Motor FP16 en la GPU de Jetson # O compila el motor FP16 para el núcleo DLA 0 model.export(format="engine", quantize=16, device="dla:0")La guía de Triton Inference Server exporta el modelo a ONNX y habilita el acelerador TensorRT de Triton en
config.pbtxt. A continuación, Triton compila el motor TensorRT en la GPU del servidor la primera vez que se carga y lo guarda en caché, por lo que el motor siempre coincide con la GPU y la versión de TensorRT del servidor. La guía explica la estructura del repositorio de modelos, el contenedor del servidor y la inferencia del cliente con Ultralytics.


Comentarios116
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
AgbajeAyomipo
Hi Ultralytics team, I’ve trained a YOLOv11 model on (1024x1024) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True) but it fails silently. If I use a dynamic=true without specifying the imgsz parameter, the export succeeds and uses (1024, 1024). My questions:
Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround? Are there ways to improve performance with high-res inference on Jetson Orin Nano? What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1martinmclee
Have you gotten any workaround? Perhaps with the YOLO26?
Hi Ultralytics team, I’ve trained a YOLOv11 model on full-size 5MP (2592x1944) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True)but it fails silently. If I use a dynamic=true, the export succeeds and uses (1024, 1024). My questions:- Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround?
- Are there ways to improve performance with high-res inference on Jetson Orin Nano?
- What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1020423lzl
m的模型大小比n大的多,速度也慢了很多,输入图像尺寸越大,越吃显存,速度也越慢
李子乐控制工程 @.***
---Original--- From: @.> Date: Sat, May 9, 2026 10:30 AM To: @.>; Cc: @.@.>; Subject: Re: [ultralytics/ultralytics] zh/integrations/tensorrt/ (Discussion #9868)
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令: yolo export model=yolo11m.pt imgsz=1280 format='engine 推理代码为: model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')
另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
— Reply to this email directly, view it on GitHub, or unsubscribe. Triage notifications on the go with GitHub Mobile for iOS or Android. You are receiving this because you commented.Message ID: @.***>
 User
能不能读完再说话,肯定是m和m比,n和n比,同样尺寸输入和同样尺寸输入的比啊。 该显卡的RT core算力是普通fp32算力的近两倍。
 Glenn JocherUltralytics
是的,性能应当在同一模型、同一
imgsz、同一batch、同一后处理参数下比较;m比n更大、1280比640更吃显存且更慢是正常现象。对 RTX A6000 来说,FP32的 TensorRT 往往不会比.pt明显更快,建议先按 TensorRT 导出文档 用half=True重新导出,并在相同输入上预热后再统计平均耗时;如果engine与.pt结果仍明显不一致,请贴出!yolo checks、完整控制台日志文本和一个最小可复现示例,我们好继续排查环境或后处理差异。
- User
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令:
yolo export model=yolo11m.pt imgsz=1280 format='engine推理代码为:model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
etson@yahboom:~/ultralytics/ultralytics$ yolo predict model=best.engine source=0 save=False show WARNING ⚠️ Unable to automatically guess model task, assuming 'task=detect'. Explicitly define task for your model, i.e. 'task=detect', 'segment', 'classify','pose' or 'obb'. Ultralytics 8.3.172 🚀 Python-3.10.12 torch-2.5.0a0+872d972e41.nv24.08 CUDA:0 (Orin, 7620MiB) Loading best.engine for TensorRT inference... [12/18/2025-17:11:05] [TRT] [I] Loaded engine size: 75 MiB [12/18/2025-17:11:05] [TRT] [I] [MS] Running engine with multi stream info [12/18/2025-17:11:05] [TRT] [I] [MS] Number of aux streams is 7 [12/18/2025-17:11:05] [TRT] [I] [MS] Number of total worker streams is 8 [12/18/2025-17:11:05] [TRT] [I] [MS] The main stream provided by execute/enqueue calls is the first worker stream [12/18/2025-17:11:05] [TRT] [I] [MemUsageChange] TensorRT-managed allocation in IExecutionContext creation: CPU +1, GPU +88, now: CPU 1, GPU 158 (MiB)
[ WARN:0@2.771] global cap_gstreamer.cpp:1777 open OpenCV | GStreamer warning: Cannot query video position: status=0, value=-1, duration=-1 1/1: 0... Success ✅ (inf frames of shape 1920x1080 at 5.00 FPS)
Traceback (most recent call last): File "/home/jetson/.local/bin/yolo", line 7, in sys.exit(entrypoint()) File "/home/jetson/Downloads/ultralytics-main/ultralytics/cfg/init.py", line 983, in entrypoint getattr(model, mode)(**overrides) # default args from model File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/model.py", line 555, in predict return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 247, in predict_cli for _ in gen: # sourcery skip: remove-empty-nested-block, noqa File "/usr/local/lib/python3.10/dist-packages/torch/utils/_contextlib.py", line 36, in generator_context response = gen.send(None) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 351, in stream_inference s[i] += self.write_results(i, Path(paths[i]), im, s) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 434, in write_results string += f"{result.verbose()}{result.speed['inference']:.1f}ms" File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in verbose return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) KeyError: 171 terminate called without an active exception Aborted (core dumped) jetson@yahboom:~/ultralytics/ultralytics$ How to solve it
- Glenn JocherUltralytics
KeyError: 171表示模型输出了类别171,但当前names里没有这个索引(通常是自定义数据集的标签类别编号不在0..nc-1范围内、data.yaml里的names数量与nc不匹配,或导出/推理用的模型与数据配置不一致导致的元数据错配);请先把所有标注.txt的 class id 修正为连续的0..nc-1,同步修正data.yaml的nc/names,修正后删除数据集labels/下的*.cache,再用同一套环境从best.pt重新导出.engine(参考 TensorRT 导出文档),并在推理时显式加上task=detect。另外请把下面命令的完整输出(文本)贴在这个 discussion 里,以及你当时的导出命令,方便我们确认是否有多环境/路径冲突:yolo checks Thank you for your reply. The issue has been resolved. I was using the RT-DETR model, but I mistakenly used "from ultralytics import YOLO" when exporting
- Glenn JocherUltralytics
Glad you found it — RT-DETR models should be loaded/exported with
RTDETR(...)(mixing them withYOLO(...)can produce mismatched metadata likenames), see the RT-DETR model docs for details:from ultralytics import RTDETR model = RTDETR("best.pt") model.export(format="engine") # creates best.engine
fly2skyToEnjoy
May I ask : The following command exports the file, whether the box and mask are both nmsed at the same time ???
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("yolo11n.pt")
Export the model to TensorRT format
model.export(format="engine") # creates 'yolo11n.engine'
Load the exported TensorRT model
tensorrt_model = YOLO("yolo11n.engine")
Run inference
results = tensorrt_model("https://ultralytics.com/images/bus.jpg")
AK993
这个方法适用于rt-detr吗
dilanpatel195
I am trying to prediction model for the YOLOv11n-seg, I have exported the .py to .engine to back it run faster but keep getting a KEY error message:
KeyError Traceback (most recent call last) Cell In[4], line 109 106 # Inside the main loop after grabbing a frame 107 if inference_active and not inpainting_active: 108 # Perform YOLO inference --> 109 results = model(rgb_frame)[0] 110 masked_image = rgb_frame.copy() # Make a copy for masking 112 # Process YOLO masks (original functionality remains unchanged)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:176, in Model.call(self, source, stream, **kwargs) 147 def call( 148 self, 149 source: Union[str, Path, int, Image.Image, list, tuple, np.ndarray, torch.Tensor] = None, 150 stream: bool = False, 151 **kwargs, 152 ) -> list: 153 """ 154 Alias for the predict method, enabling the model instance to be callable for predictions. 155 (...) 174 ... print(f"Detected {len(r)} objects in image") 175 """ --> 176 return self.predict(source, stream, **kwargs)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:554, in Model.predict(self, source, stream, predictor, **kwargs) 552 if prompts and hasattr(self.predictor, "set_prompts"): # for SAM-type models 553 self.predictor.set_prompts(prompts) --> 554 return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:168, in BasePredictor.call(self, source, model, stream, *args, **kwargs) 166 return self.stream_inference(source, model, *args, **kwargs) 167 else: --> 168 return list(self.stream_inference(source, model, *args, **kwargs))
File c:\ProgramData\miniconda3\Lib\site-packages\torch\utils_contextlib.py:36, in _wrap_generator..generator_context(*args, **kwargs) 33 try: 34 # Issuing None to a generator fires it up 35 with ctx_factory(): ---> 36 response = gen.send(None) 38 while True: 39 try: 40 # Forward the response to our caller and get its next request
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:274, in BasePredictor.stream_inference(self, source, model, *args, **kwargs) 268 self.results[i].speed = { 269 "preprocess": profilers[0].dt * 1e3 / n, 270 "inference": profilers[1].dt * 1e3 / n, 271 "postprocess": profilers[2].dt * 1e3 / n, 272 } 273 if self.args.verbose or self.args.save or self.args.save_txt or self.args.show: --> 274 s[i] += self.write_results(i, Path(paths[i]), im, s) 276 # Print batch results 277 if self.args.verbose:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:334, in BasePredictor.write_results(self, i, p, im, s) 332 result = self.results[i] 333 result.save_dir = self.save_dir.str() # used in other locations --> 334 string += f"{result.verbose()}{result.speed['inference']:.1f}ms" 336 # Add predictions to image 337 if self.args.save or self.args.show:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\results.py:663, in Results.verbose(self) 661 for c in boxes.cls.unique(): 662 n = (boxes.cls == c).sum() # detections per class --> 663 log_string += f"{n} {self.names[int(c)]}{'s' * (n > 1)}, " 664 return log_string
KeyError: 2
Any help would be greatly appreciated!
Ranjith3436
Now, My TensorRT Sengment model used for track. if any detections not there the processing FPS is 75-80 in jetson. But once the person or people detected suddenly reused to 15-20. processing time going to 40ms. only when the object detected. What's the issue in model.track(), could i run all the tracking thing on GPU.
- Glenn JocherUltralytics(editado)
@Ranjith3436 the performance drop when objects are detected is expected behavior, as tracking introduces additional computational overhead. When objects are detected, the model.track() method performs several CPU-bound operations including feature extraction, association, and trajectory management.
To improve performance:
- Try using a smaller model variant (like YOLO26n-seg instead of larger variants)
- Consider reducing the image resolution for tracking
- Optimize tracking parameters by setting
persist=Trueand adjustingconfthresholds higher to track fewer objects - Use
half=True(FP16) orint8=Truewhen exporting your model to TensorRT for maximum GPU acceleration
For the tracking components specifically, the BoT-SORT or ByteTrack algorithms used by Ultralytics do have some CPU-bound operations, but you can minimize their impact with the above optimizations. For more details on tracking optimization, check our tracking documentation.
1
I convert Classification model that i retrained. But it throw the error "amax(): Expected reduction dim 1 to have non-zero size."
- Glenn JocherUltralytics
@Ranjith3436 this error typically occurs when TensorRT encounters an empty dimension during model conversion. For classification models, this could happen if:
- Your model architecture was modified or if you're using a custom architecture
- There might be an issue with batch normalization layers during export
- The class count in your retrained model might be causing dimension mismatches
Try these solutions:
- Ensure your model's forward pass works correctly before export
- Try exporting with
simplify=Falseto preserve the original graph structure - Check if your classification model has the correct output dimension for your number of classes
If the issue persists, share more details about your model architecture and export command for better assistance. For more guidance, refer to our TensorRT integration documentation.
The model trained use yolov8l-cls.pt and the error come from jetson device.
(model): ClassificationModel( (model): Sequential( (0): Conv( (conv): Conv2d(3, 64, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (1): Conv( (conv): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (2): C2f( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(320, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (3): Conv( (conv): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (4): C2f( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(1024, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (5): Conv( (conv): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (6): C2f( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2048, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (7): Conv( (conv): Conv2d(512, 1024, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (8): C2f( (cv1): Conv( (conv): Conv2d(1024, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2560, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (9): Classify( (conv): Conv( (conv): Conv2d(1024, 1280, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1280, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (pool): AdaptiveAvgPool2d(output_size=1) (drop): Dropout(p=0.0, inplace=True) (linear): Linear(in_features=1280, out_features=2, bias=True) ) ) ) )
model architecture
This error sorted out