Prácticas recomendadas y consejos de aprendizaje automático para entrenar modelos
Introducción#
Uno de los pasos más importantes al trabajar en un proyecto de visión artificial es entrenar el modelo. Antes de llegar a este paso, tienes que definir tus objetivos y recopilar y anotar tus datos. Después de preprocesar los datos para asegurarte de que estén limpios y sean coherentes, puedes pasar a entrenar el modelo.
El entrenamiento de modelos es el proceso de enseñar al modelo a reconocer patrones visuales y hacer predicciones a partir de tus datos, y determina directamente la precisión de tu aplicación. En esta guía se explican las prácticas recomendadas, las técnicas de optimización y los consejos para resolver problemas, con el objetivo de ayudarte a entrenar tus modelos de visión artificial de forma eficaz.
Ver: Consejos para entrenar modelos | Cómo gestionar conjuntos de datos grandes | Tamaño del lote, uso de la GPU y precisión mixta
Cómo entrenar un modelo de aprendizaje automático#
Un modelo de visión artificial se entrena ajustando sus parámetros internos para minimizar los errores. Al principio, se proporciona al modelo un conjunto amplio de imágenes etiquetadas. El modelo predice qué aparece en las imágenes y, después, se comparan las predicciones con las etiquetas o el contenido reales para calcular los errores. Estos errores indican cuánto se desvían las predicciones del modelo de los valores reales.
Durante el entrenamiento, el modelo hace predicciones de forma iterativa, calcula los errores y actualiza sus parámetros mediante un proceso denominado retropropagación. En este proceso, el modelo ajusta sus parámetros internos (pesos y sesgos) para reducir los errores. Al repetir este ciclo muchas veces, mejora gradualmente su precisión. Con el tiempo, aprende a reconocer patrones complejos como formas, colores y texturas.
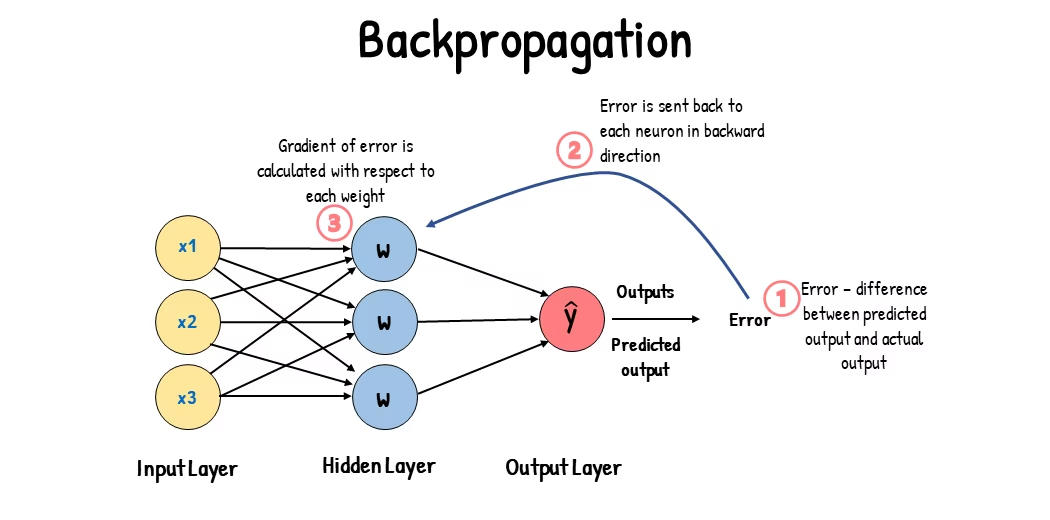
Este proceso de aprendizaje permite que el modelo de visión artificial realice diversas tareas, como la detección de objetos, la segmentación de instancias, la segmentación semántica y la clasificación de imágenes. El objetivo final es crear un modelo capaz de generalizar lo aprendido a imágenes nuevas que no haya visto, para que pueda interpretar datos visuales con precisión en aplicaciones del mundo real.
Ahora que sabemos qué ocurre entre bastidores al entrenar un modelo, veamos qué aspectos debes tener en cuenta.
Entrenamiento con conjuntos de datos grandes#
Hay varios aspectos que debes tener en cuenta si planeas usar un conjunto de datos grande para entrenar un modelo. Por ejemplo, puedes ajustar el tamaño del lote, controlar el uso de la GPU y elegir el entrenamiento multiescala, entre otras opciones. Veamos cada una en detalle.
Tamaño del lote y uso de la GPU#
Al entrenar modelos con conjuntos de datos grandes, es fundamental aprovechar la GPU de forma eficiente. El tamaño del lote es un factor importante: es el número de muestras de datos que procesa un modelo de aprendizaje automático en una sola iteración de entrenamiento. Si usas el tamaño máximo de lote que admite tu GPU, puedes aprovechar al máximo sus capacidades y reducir el tiempo de entrenamiento del modelo. Sin embargo, debes evitar quedarte sin memoria de la GPU. Si se producen errores de memoria, reduce el tamaño del lote poco a poco hasta que el modelo se entrene sin problemas.
Ver: Cómo acelerar 2× la inferencia de Ultralytics YOLO26 mediante el procesamiento por lotes | Python y GPU | MLOps 🚀
En lo que respecta a YOLO26, puedes establecer el parámetro batch en los argumentos del modo de entrenamiento para ajustarlo a la capacidad de tu GPU. En un único acelerador, batch=-1 analiza el rendimiento del modelo y elige un tamaño de lote que apunte a una utilización de memoria de aproximadamente el 60 %; una fracción como batch=0.70 apunta a una proporción diferente. Las ejecuciones con varias GPU requieren un tamaño de lote global explícito que sea como mínimo igual al número de dispositivos. En CPU y en los chips de Apple, AutoBatch muestra una advertencia y recurre a batch=16.
Entrenamiento con subconjuntos#
El entrenamiento con subconjuntos es una estrategia práctica que consiste en entrenar el modelo con un conjunto de datos más pequeño que represente al conjunto de datos completo. Puede ahorrar tiempo y recursos, especialmente durante las fases iniciales de desarrollo y prueba del modelo. Si tienes poco tiempo o estás probando distintas configuraciones del modelo, el entrenamiento con subconjuntos es una buena opción.
En YOLO26, puedes implementar el entrenamiento con un subconjunto mediante el parámetro fraction. Usa una proporción como fraction=0.1 para el 10 % de los datos de entrenamiento, un número entero como fraction=300 para seleccionar exactamente 300 imágenes de entrenamiento o una lista [train, val, test] como fraction=[300, 100, 0] para limitar cada partición y omitir las imágenes de prueba. Las listas de dos elementos, como [300, 100], mantienen completa la partición de prueba. Los conjuntos de datos NDJSON seleccionan registros espaciados uniformemente antes de descargarlos, por lo que las ejecuciones repetidas reutilizan exactamente el mismo subconjunto. Los conjuntos de datos de clasificación organizados en carpetas de imágenes también seleccionan muestras espaciadas uniformemente. Para otros conjuntos de datos organizados en carpetas de imágenes, fraction selecciona las primeras N imágenes según el orden de las rutas de imagen ordenadas, no una muestra aleatoria; por tanto, selecciona manualmente los subconjuntos cuando el orden pueda excluir fuentes o clases. Al preparar las particiones de entrenamiento y validación, mantén los grupos de imágenes casi duplicadas íntegramente en una sola partición.
Entrenamiento multiescala#
El entrenamiento multiescala es una técnica que mejora la capacidad de generalización del modelo al entrenarlo con imágenes de distintos tamaños. El modelo puede aprender a detectar objetos a diferentes escalas y distancias, y volverse más robusto.
Al entrenar YOLO26, puedes habilitar el aumento de escala configurando el parámetro scale. Este parámetro ajusta el tamaño de las imágenes de entrenamiento según un factor especificado para simular objetos a distintas distancias. Por ejemplo, al establecer scale=0.5, las imágenes de entrenamiento se amplían o reducen aleatoriamente por un factor entre 0,5 y 1,5 durante el entrenamiento. Al configurar este parámetro, el modelo se expone a distintas escalas de imagen y puede mejorar su capacidad para detectar objetos de diferentes tamaños y en distintas situaciones.
Ultralytics también admite el entrenamiento multiescala por tamaño de imagen mediante el parámetro multi_scale. A diferencia de scale, que amplía o reduce las imágenes y luego las rellena o recorta para volver a imgsz, multi_scale cambia imgsz en cada lote (redondeado al stride del modelo). Por ejemplo, con imgsz=640 y multi_scale=0.25, el tamaño de entrenamiento se elige entre 480 y 800 en pasos de stride (p. ej., 480, 512, 544, ..., 800), mientras que multi_scale=0.0 mantiene un tamaño fijo.
Almacenamiento en caché#
El almacenamiento en caché es una técnica importante para mejorar la eficiencia del entrenamiento de modelos de aprendizaje automático. Al guardar las imágenes preprocesadas en memoria, la caché reduce el tiempo que la GPU pasa esperando a que se carguen los datos desde el disco. El modelo puede recibir datos continuamente, sin retrasos causados por las operaciones de E/S del disco.
Puedes controlar el almacenamiento en caché al entrenar YOLO26 mediante el parámetro cache:
cache=True: Almacena las imágenes del conjunto de datos en RAM, lo que ofrece la mayor velocidad de acceso, pero aumenta el uso de memoria.cache='disk': Almacena las imágenes en el disco; es más lento que la RAM, pero más rápido que volver a cargar los datos cada vez.cache=False: Desactiva el almacenamiento en caché y depende por completo de la E/S del disco, la opción más lenta.
Entrenamiento con precisión mixta#
El entrenamiento con precisión mixta usa tipos de coma flotante de 16 bits (FP16) y 32 bits (FP32): FP16 para acelerar los cálculos y FP32 para mantener la precisión cuando sea necesario. La mayoría de las operaciones de la red neuronal se realizan en FP16 para aprovechar la mayor velocidad de cálculo y el menor uso de memoria. Sin embargo, se conserva una copia maestra de los pesos del modelo en FP32 para garantizar la precisión durante las actualizaciones de pesos. Así puedes gestionar modelos o tamaños de lote más grandes con las mismas limitaciones de hardware.
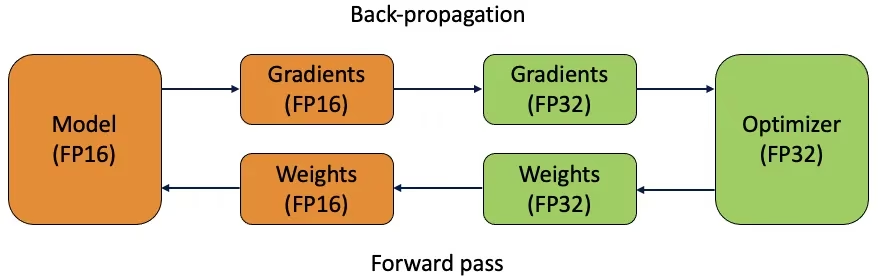
Para implementar el entrenamiento con precisión mixta, tendrás que modificar los scripts de entrenamiento y asegurarte de que tu hardware (como las GPU) lo admita. Muchos frameworks modernos de aprendizaje profundo, como PyTorch y TensorFlow, ofrecen compatibilidad integrada con la precisión mixta.
El entrenamiento con precisión mixta es sencillo con YOLO26: AMP ya está activado de forma predeterminada (amp=True). En una GPU CUDA, YOLO realiza una comprobación de compatibilidad al inicio del entrenamiento y usa FP32 completo si no la supera; en la CPU y en los chips Apple, AMP se omite por completo. Establece amp=False para forzar FP32 o amp="bf16" para entrenar en bfloat16 con las GPU compatibles.
Pesos preentrenados#
Usar pesos preentrenados es una forma eficaz de acelerar el entrenamiento del modelo. Los pesos preentrenados proceden de modelos entrenados previamente con grandes conjuntos de datos, lo que permite que tu modelo empiece con ventaja. El aprendizaje por transferencia adapta modelos preentrenados a tareas nuevas y relacionadas. El ajuste fino de un modelo preentrenado consiste en partir de esos pesos y continuar el entrenamiento con tu conjunto de datos específico. Este método reduce el tiempo de entrenamiento y suele ofrecer un mejor rendimiento, porque el modelo parte de una base sólida de características básicas.
Los pesos preentrenados se obtienen del argumento model, por lo que model=yolo26n.pt ya empieza con pesos de COCO. El parámetro pretrained controla si se conservan esos pesos (True, opción predeterminada), se descartan (False) o se sustituyen por otro punto de control (pretrained=path/to/best.pt). Establecer pretrained=True en un modelo *.yaml no descarga pesos por sí solo. Consulta Cómo ajustar YOLO con un conjunto de datos personalizado para ver el flujo completo de aprendizaje por transferencia.
Otras técnicas que debes tener en cuenta al gestionar un conjunto de datos grande#
Hay otras técnicas que conviene tener en cuenta al gestionar un conjunto de datos grande:
- Programadores de la tasa de aprendizaje: implementar programadores de la tasa de aprendizaje permite ajustarla dinámicamente durante el entrenamiento. Una tasa de aprendizaje bien ajustada puede evitar que el modelo sobrepase los mínimos y mejorar la estabilidad. Al entrenar YOLO26, el parámetro
lrfayuda a gestionar la programación de la tasa de aprendizaje estableciendo la tasa de aprendizaje final como una fracción de la inicial. Para controlar comportamientos que no se exponen mediante argumentos, como las tasas de aprendizaje por capa o el recorte del gradiente, crea una subclase del entrenador. - Entrenamiento distribuido: Para gestionar conjuntos de datos grandes, el entrenamiento distribuido reduce el tiempo de entrenamiento al repartir la carga de trabajo entre varias GPU o máquinas. Este enfoque es especialmente útil en proyectos empresariales a gran escala con muchos recursos computacionales.
- Formato de memoria channels-last: el entrenamiento con NVIDIA CUDA utiliza automáticamente la disposición de memoria NHWC, más rápida, con PyTorch 1.11 y versiones posteriores, excepto en Windows, donde se observó un menor rendimiento. El entrenamiento con AMD ROCm mantiene NCHW, que allí ofreció un mejor rendimiento. Establece
channels_last=Truepara forzarlo ochannels_last=Falsepara mantener NCHW; PyTorch 1.10 y versiones anteriores, CPU y MPS siguen usando NCHW de forma predeterminada.
Número de épocas de entrenamiento#
Al entrenar un modelo, una época corresponde a un recorrido completo por todo el conjunto de datos de entrenamiento. Durante una época, el modelo procesa una vez cada ejemplo del conjunto de entrenamiento y actualiza sus parámetros según el algoritmo de aprendizaje. Normalmente se necesitan varias épocas para que el modelo aprenda y refine sus parámetros con el tiempo.
Una pregunta habitual es cómo determinar el número de épocas de entrenamiento. Un buen punto de partida son 300 épocas. Si el modelo empieza a sobreajustarse pronto, puedes reducir el número de épocas. Si no se produce sobreajuste después de 300 épocas, puedes prolongar el entrenamiento a 600, 1200 o más épocas.
Sin embargo, el número ideal de épocas puede variar según el tamaño del conjunto de datos y los objetivos del proyecto. Los conjuntos de datos grandes pueden requerir más épocas para que el modelo aprenda de forma eficaz, mientras que los más pequeños pueden necesitar menos para evitar el sobreajuste. Para YOLO26, puedes establecer el parámetro epochs en tu script de entrenamiento.
Parada temprana#
La parada temprana es una técnica útil para optimizar el entrenamiento del modelo. Si supervisas el rendimiento en validación, puedes detener el entrenamiento cuando el modelo deje de mejorar. Así ahorras recursos computacionales y evitas el sobreajuste.
El proceso consiste en establecer un parámetro de paciencia que determina cuántas épocas hay que esperar a que mejoren las métricas de validación antes de detener el entrenamiento. Si el rendimiento del modelo no mejora durante ese número de épocas, el entrenamiento se detiene para evitar malgastar tiempo y recursos.
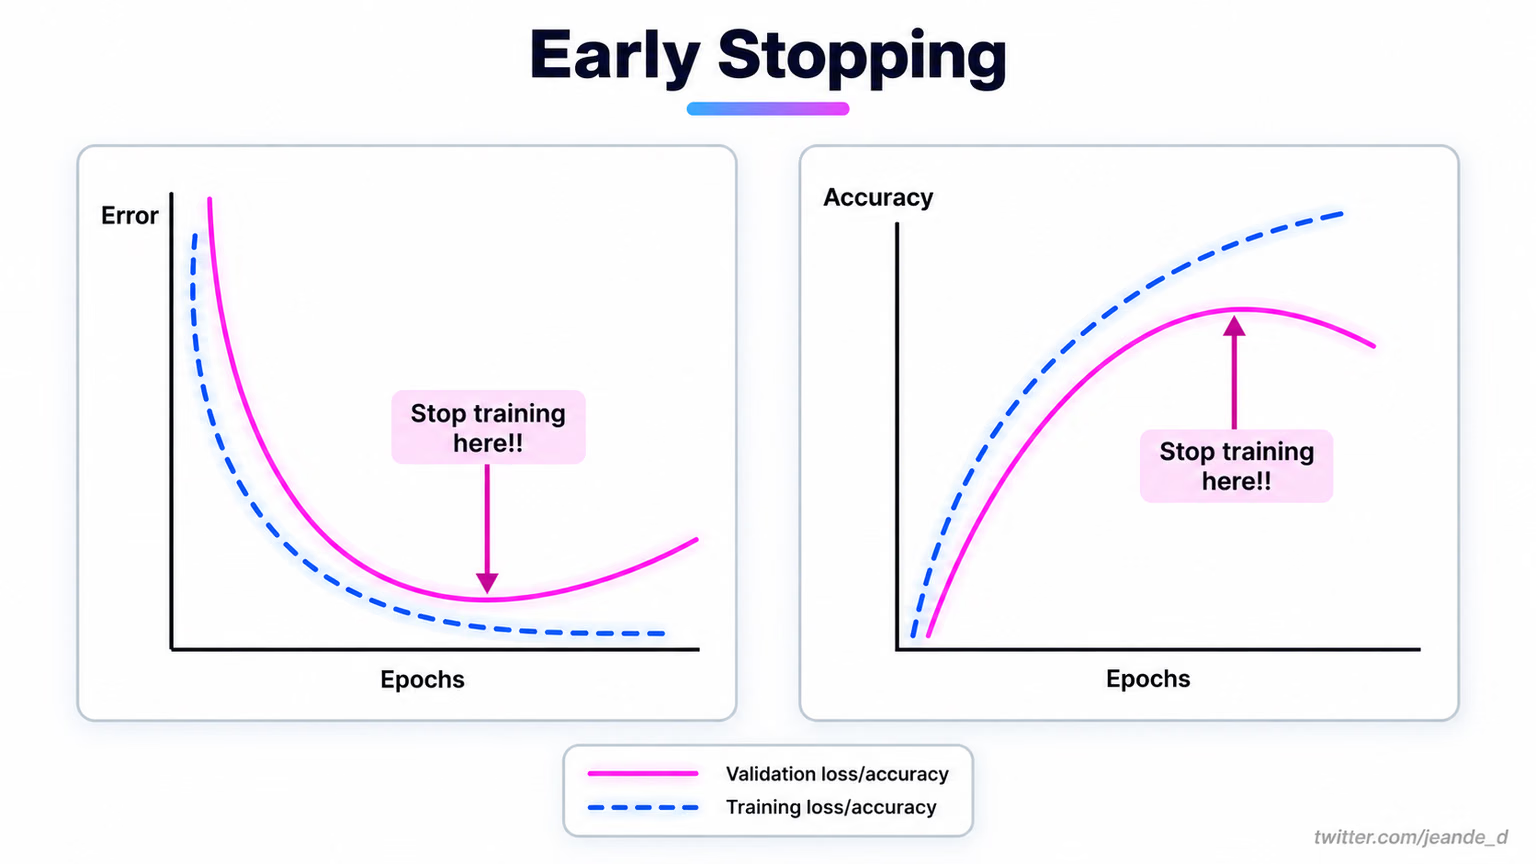
Con YOLO26, puedes habilitar la detención temprana configurando el parámetro de paciencia en la configuración de entrenamiento. Por ejemplo, patience=5 significa que el entrenamiento se detendrá si las métricas de validación no mejoran durante 5 épocas consecutivas. Así, el entrenamiento es más eficiente y se evitan cálculos innecesarios.
Elegir entre el entrenamiento en la nube y el local#
Hay dos opciones para entrenar tu modelo: en la nube o de forma local.
El entrenamiento en la nube ofrece escalabilidad y hardware potente, por lo que es ideal para gestionar conjuntos de datos grandes y modelos complejos. Plataformas como Google Cloud, AWS y Azure proporcionan acceso bajo demanda a GPU y TPU de alto rendimiento, lo que acelera el entrenamiento y permite experimentar con modelos más grandes. Ultralytics Platform también ofrece entrenamiento en la nube gestionado para modelos YOLO. Sin embargo, el entrenamiento en la nube puede ser caro, sobre todo si se prolonga, y la transferencia de datos puede aumentar los costes y la latencia.
El entrenamiento local ofrece más control y opciones de personalización, lo que te permite adaptar el entorno a tus necesidades específicas y evitar los costes recurrentes de la nube. Puede resultar más económico en proyectos a largo plazo y, como los datos permanecen en tus instalaciones, es más seguro. Sin embargo, el hardware local puede tener recursos limitados y requerir mantenimiento, lo que puede alargar los tiempos de entrenamiento de los modelos grandes.
Selección de un optimizador#
Un optimizador es un algoritmo que ajusta los pesos de tu red neuronal para minimizar la función de pérdida, que mide el rendimiento del modelo. En términos más sencillos, el optimizador ayuda al modelo a aprender modificando sus parámetros para reducir los errores. Elegir el optimizador adecuado afecta directamente a la rapidez y la precisión con las que aprende el modelo.
También puedes ajustar los parámetros del optimizador para mejorar el rendimiento del modelo. Al ajustar la tasa de aprendizaje, determinas el tamaño de los pasos al actualizar los parámetros. Para lograr estabilidad, puedes empezar con una tasa de aprendizaje moderada y reducirla gradualmente con el tiempo para mejorar el aprendizaje a largo plazo. Además, al definir el momento, determinas cuánto influyen las actualizaciones anteriores en las actuales. Un valor habitual para el momento es aproximadamente 0,9. Por lo general, ofrece un buen equilibrio.
Optimizadores habituales#
Los distintos optimizadores tienen ventajas e inconvenientes. Estos son algunos de los más habituales.
-
SGD (Descenso de gradiente estocástico):
- Actualiza los parámetros del modelo mediante el gradiente de la función de pérdida con respecto a los parámetros.
- Es sencillo y eficiente, pero puede tardar en converger y quedarse atascado en mínimos locales.
-
Adam (estimación adaptativa del momento):
- Combina las ventajas de SGD con momento y RMSProp.
- Ajusta la tasa de aprendizaje de cada parámetro basándose en estimaciones del primer y segundo momento de los gradientes.
- Es adecuado para datos ruidosos y gradientes dispersos.
- Es eficiente y, por lo general, requiere menos ajustes. Para entrenamientos más cortos,
optimizer=autode YOLO26 selecciona AdamW, estrechamente relacionado, en lugar de Adam.
-
RMSProp (propagación de la raíz cuadrática media):
- Ajusta la tasa de aprendizaje de cada parámetro dividiendo el gradiente por una media móvil de las magnitudes de los gradientes recientes.
- Ayuda a abordar el problema de la desaparición del gradiente y es eficaz para las redes neuronales recurrentes.
-
MuSGD (híbrido de Muon y SGD):
- Combina actualizaciones al estilo SGD con un comportamiento inspirado en Muon para mejorar la estabilidad durante el entrenamiento a gran escala.
- Es una buena opción si buscas la capacidad de generalización de SGD, pero necesitas una convergencia más fluida que con SGD estándar.
- Es especialmente relevante para las configuraciones de entrenamiento de YOLO26; si no tienes claro cuál elegir, empieza con
optimizer=autoy compara MuSGD con tus datos.
Con YOLO26, el parámetro optimizer te permite elegir entre distintos optimizadores, como SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam y RMSProp. También puedes establecerlo en auto para que se seleccione automáticamente según el número de iteraciones de entrenamiento (AdamW para ejecuciones cortas y MuSGD para más de 10 000 iteraciones).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDConecta con la comunidad#
Formar parte de una comunidad de entusiastas de la visión artificial puede ayudarte a resolver problemas y aprender más rápido. Aquí tienes algunas formas de conectar, pedir ayuda y compartir ideas.
Recursos de la comunidad#
- Incidencias de GitHub: Visita el repositorio de YOLO26 en GitHub y usa la pestaña Issues para hacer preguntas, informar de errores y proponer funciones nuevas. La comunidad y las personas responsables del mantenimiento son muy activas y están dispuestas a ayudar.
- Servidor de Discord de Ultralytics: Únete al servidor de Discord de Ultralytics para charlar con otros usuarios y desarrolladores, recibir ayuda y compartir tus experiencias.
Estos recursos te ayudarán a resolver problemas y a estar al día de las últimas tendencias y prácticas de la comunidad de visión artificial.
Conclusiones clave#
Entrenar modelos de visión artificial implica seguir buenas prácticas, optimizar las estrategias y resolver los problemas a medida que surgen. Técnicas como ajustar el tamaño de los lotes, usar precisión mixta y partir de pesos preentrenados pueden mejorar el rendimiento de los modelos y acelerar su entrenamiento. Métodos como el entrenamiento con subconjuntos y la detención temprana ayudan a ahorrar tiempo y recursos. Mantenerte en contacto con la comunidad y estar al día de las nuevas tendencias te ayudará a seguir mejorando tus habilidades de entrenamiento de modelos.
Preguntas frecuentes#
Para mejorar la utilización de la GPU, establece el parámetro
batchen el tamaño máximo que admita tu GPU. En un único acelerador,batch=-1analiza el rendimiento del modelo y apunta a una utilización de memoria de aproximadamente el 60 %. Recurre abatch=16en CPU y en los chips de Apple, mientras que las ejecuciones con varias GPU requieren un tamaño de lote global explícito que sea como mínimo igual al número de dispositivos. Para obtener más información, consulta los argumentos del modo de entrenamiento.El entrenamiento con precisión mixta usa tipos de coma flotante de 16 bits (FP16) y 32 bits (FP32) para equilibrar la velocidad computacional y la precisión. En YOLO26 está habilitado de forma predeterminada mediante
amp=True; estableceamp=Falsepara forzar FP32. AMP se omite en CPU y en los chips Apple.El entrenamiento multiescala mejora el rendimiento del modelo al entrenarlo con imágenes de distintos tamaños, lo que le permite generalizar mejor a diferentes escalas y distancias. YOLO26 ofrece dos parámetros independientes para ello.
scale=0.5muestrea un factor de zoom entre 0,5 y 1,5 y después añade relleno o recorta la imagen para volver a unimgszfijo, mientras quemulti_scale=0.25varía el propioimgszen cada lote, en pasos de stride. Para consultar los ajustes y obtener más información, visita la documentación del modo de entrenamiento.El uso de pesos preentrenados puede acelerar considerablemente el entrenamiento y mejorar la precisión del modelo al aprovechar uno que ya conoce características visuales básicas. Cárgalos mediante el argumento
model, como enmodel=yolo26n.pt; a continuación,pretraineddecide si se conservan esos pesos (True, valor predeterminado), se descartan (False) o se sustituyen por otro punto de control (pretrained=path/to/best.pt, la forma de transferir pesos a una compilaciónmodel=*.yaml). Encontrarás más información en la documentación del modo de entrenamiento.El número de épocas indica cuántas pasadas completas por el conjunto de datos de entrenamiento se realizan durante el entrenamiento del modelo. Un punto de partida habitual son 300 épocas. Si tu modelo empieza a sobreajustarse pronto, puedes reducir el número. Si no observas sobreajuste, puedes ampliar el entrenamiento a 600, 1200 o más épocas. Para establecer este valor en YOLO26, usa el parámetro
epochsen tu script de entrenamiento. Para obtener más consejos sobre cómo determinar el número ideal de épocas, consulta esta sección sobre el número de épocas.


Comentarios12
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(editado)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.