Estrategias de recopilación y anotación de datos para visión artificial
La recopilación y la anotación de datos son los dos pasos fundamentales de cualquier proyecto de visión artificial: primero reúnes imágenes o vídeos representativos y después los etiquetas para que un modelo pueda aprender de ellos. La calidad de estos datos determina directamente el rendimiento del modelo; por eso, antes de empezar a entrenar, es importante definir las clases, recopilar datos sin sesgos y mantener la coherencia de las anotaciones.
Ver: Cómo crear estrategias eficaces de recopilación y anotación de datos para visión artificial 🚀
Esta guía explica cómo configurar las clases y recopilar datos, en qué consiste la anotación de datos, así como los tipos y formatos de anotación disponibles, y estrategias de etiquetado eficientes, con cada decisión alineada con los objetivos de tu proyecto.
Configuración de clases y recopilación de datos#
La recopilación de imágenes y vídeos para un proyecto de visión artificial se reduce a tres decisiones: cuántas clases definir, de dónde obtener los datos y cómo evitar sesgos en el conjunto de datos.
Cómo elegir las clases adecuadas para tu proyecto#
Una de las primeras preguntas al iniciar un proyecto de visión artificial es cuántas clases incluir. Tienes que determinar las clases, es decir, las distintas categorías o etiquetas que quieres que tu modelo reconozca y diferencie. El número de clases debe responder a los objetivos concretos de tu proyecto.
Por ejemplo, si quieres controlar el tráfico, tus clases podrían incluir «coche», «camión», «autobús», «motocicleta» y «bicicleta». En cambio, para hacer un seguimiento de los productos de una tienda, tus clases podrían ser «frutas», «verduras», «bebidas» y «aperitivos». Definir las clases según los objetivos de tu proyecto ayuda a que tu conjunto de datos sea pertinente y específico.
Al definir las clases, también es importante decidir si vas a usar pocas clases generales o muchas clases específicas. El número de clases se refiere a cuántas clases distintas te interesan. Esta decisión influye en el nivel de detalle de tus datos y en la complejidad del modelo. Estos son los aspectos que debes tener en cuenta en cada opción:
- Pocas clases generales: son categorías más amplias e inclusivas, como «vehículo» y «no vehículo». Simplifican la anotación y requieren menos recursos computacionales, pero proporcionan menos información detallada, lo que puede limitar la eficacia del modelo en situaciones complejas.
- Muchas clases específicas: incluyen más categorías con distinciones más precisas, como «berlina», «SUV», «camioneta» y «motocicleta». Capturan información más detallada, lo que mejora la precisión y el rendimiento del modelo. Sin embargo, requieren más tiempo y trabajo para anotarlas, además de más recursos computacionales.
Empezar con clases más específicas puede ser muy útil, sobre todo en proyectos complejos donde los detalles son importantes. Las clases más específicas te permiten recopilar datos más detallados, obtener información más profunda y establecer distinciones más claras entre categorías. No solo mejoran la precisión del modelo, sino que también facilitan su ajuste posterior si es necesario, con el consiguiente ahorro de tiempo y recursos.
Fuentes de datos#
Puedes utilizar conjuntos de datos públicos o recopilar tus propios datos. Los conjuntos de datos públicos, como los disponibles en Kaggle y Google Dataset Search Engine, ofrecen datos estandarizados y bien anotados, por lo que son un buen punto de partida para entrenar y validar modelos.
Por otro lado, recopilar datos personalizados te permite adaptar el conjunto de datos a tus necesidades concretas. Puedes capturar imágenes y vídeos con cámaras o drones, extraer imágenes de la web o utilizar datos internos que ya tenga tu organización. Los datos personalizados te dan más control sobre su calidad y pertinencia. Combinar fuentes de datos públicas y personalizadas ayuda a crear un conjunto de datos diverso y completo.
Cómo evitar sesgos en la recopilación de datos#
Se produce un sesgo cuando algunos grupos o situaciones están infrarrepresentados o sobrerrepresentados en tu conjunto de datos. Esto hace que el modelo funcione bien con algunos datos, pero mal con otros. Es fundamental evitar los sesgos en la IA para que tu modelo de visión artificial funcione bien en distintas situaciones.
Así puedes evitar sesgos al recopilar datos:
- Fuentes diversas: recopila datos de muchas fuentes para abarcar distintas perspectivas y situaciones.
- Representación equilibrada: incluye una representación equilibrada de todos los grupos pertinentes. Por ejemplo, ten en cuenta distintas edades, géneros y etnias.
- Supervisión continua: revisa y actualiza periódicamente tu conjunto de datos para identificar y corregir los sesgos que puedan surgir.
- Técnicas de mitigación de sesgos: utiliza métodos como el sobremuestreo de clases infrarrepresentadas, el aumento de datos y los algoritmos que tienen en cuenta la equidad.
Seguir estas prácticas ayuda a crear un modelo más robusto y justo, capaz de generalizar bien en aplicaciones del mundo real.
¿Qué es la anotación de datos?#
La anotación de datos es el proceso de etiquetar datos para que puedan utilizarse en el entrenamiento de modelos de aprendizaje automático. En visión artificial, esto significa etiquetar imágenes o vídeos con la información que el modelo necesita para aprender. Sin datos debidamente anotados, los modelos no pueden aprender con precisión las relaciones entre las entradas y las salidas.
Tipos de anotación de datos#
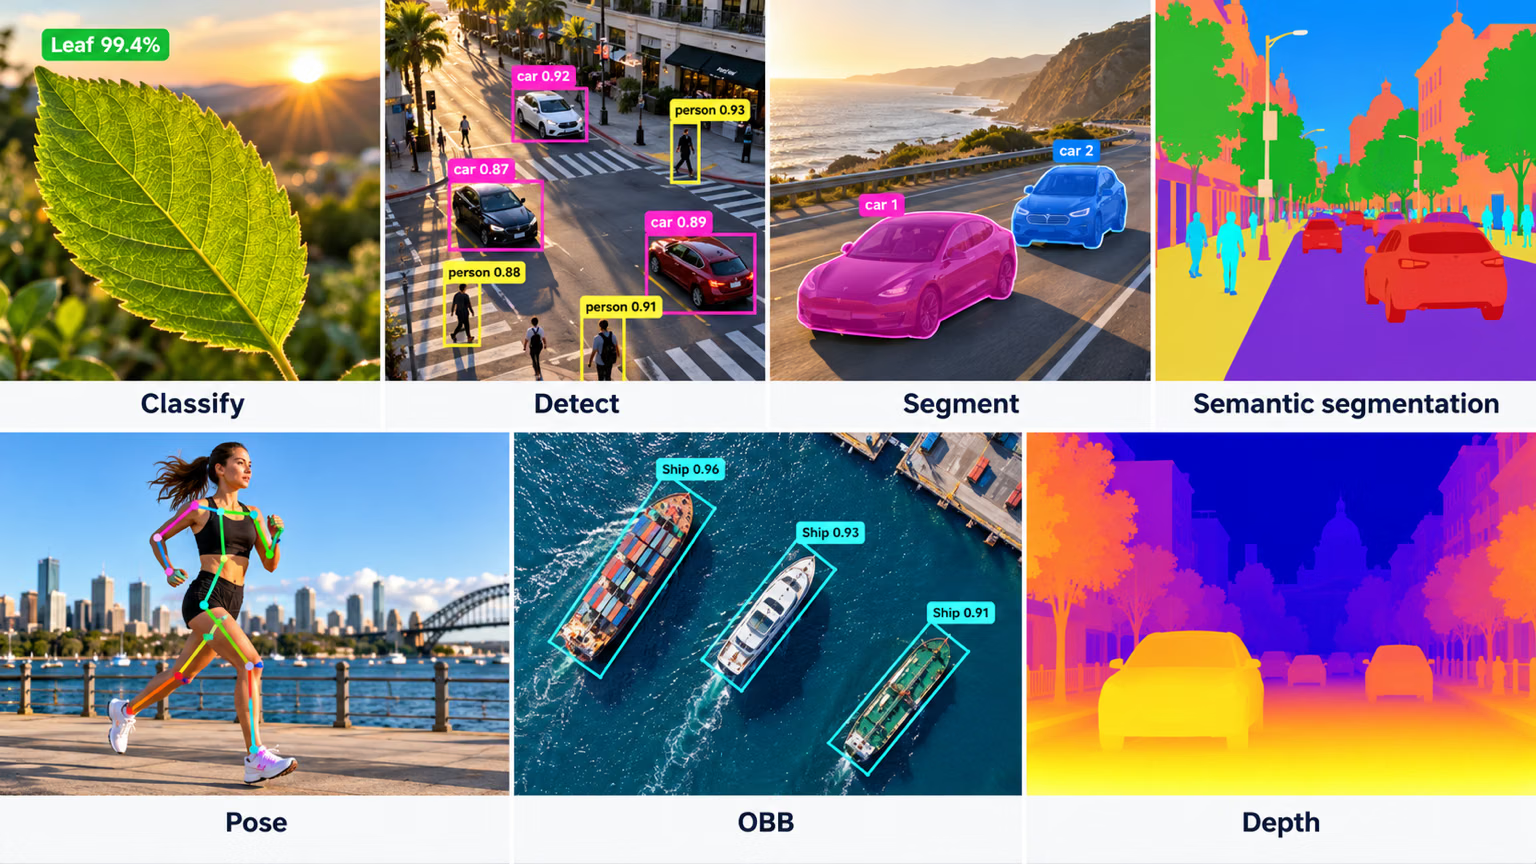
Según los requisitos concretos de una tarea de visión artificial, existen distintos tipos de anotación de datos. Estos son algunos ejemplos:
- Cuadros delimitadores: rectángulos dibujados alrededor de los objetos de una imagen, utilizados principalmente en tareas de detección de objetos. Estos cuadros se definen mediante las coordenadas de las esquinas superior izquierda e inferior derecha.
- Polígonos: contornos detallados de objetos que permiten una anotación más precisa que los cuadros delimitadores. Los polígonos se utilizan en tareas como la segmentación de instancias, donde la forma del objeto es importante.
- Máscaras: máscaras binarias en las que cada píxel pertenece a un objeto o al fondo. Se utilizan en tareas de segmentación semántica para proporcionar detalles a nivel de píxel.
- Puntos clave: puntos concretos marcados en una imagen para identificar ubicaciones de interés. Se utilizan en tareas como la estimación de pose y la detección de puntos de referencia faciales.
- Cuadros delimitadores orientados: rectángulos con un ángulo de rotación, utilizados en tareas de OBB cuando los objetos aparecen con cualquier orientación, como en las imágenes aéreas.
Formatos de anotación habituales#
Después de elegir un tipo de anotación, es importante seleccionar el formato adecuado para almacenar y compartir las anotaciones. Los formatos más habituales son:
| Formato | Estructura de archivos | Usos habituales |
|---|---|---|
| COCO | Un único archivo JSON | Detección de objetos, segmentación de instancias, detección de puntos clave, segmentación de elementos de fondo y segmentación panóptica, descripción de imágenes |
| Pascal VOC | Un archivo XML por imagen | Detección de objetos |
| YOLO | Un archivo .txt por imagen | Detección de objetos, segmentación, pose y cuadros orientados |
El formato YOLO almacena una fila por objeto, con índices de clase a partir de 0. Para la detección de objetos, la fila es class x_center y_center width height, con coordenadas normalizadas entre 0 y 1. En una fila de segmentación, la caja se sustituye por los puntos normalizados del polígono del objeto, mientras que una fila de pose conserva la caja y añade después las coordenadas de los puntos clave, con un indicador de visibilidad para cada punto clave cuando el conjunto de datos declara kpt_shape: [n, 3]. Una fila de OBB almacena class x1 y1 x2 y2 x3 y3 x4 y4 mediante coordenadas normalizadas de las esquinas.
Si tu herramienta de anotación exporta archivos COCO JSON, puedes convertirlos a etiquetas YOLO .txt o entrenar directamente con el archivo JSON mediante una clase de conjunto de datos personalizada.
Definición de directrices de anotación#
Una vez elegidos el tipo y el formato de anotación, el siguiente paso es establecer reglas de etiquetado claras y objetivas. Estas reglas sirven de guía para mantener la coherencia y la precisión durante todo el proceso de anotación. Entre los aspectos clave de estas reglas se incluyen:
- Claridad y detalle: asegúrate de que las instrucciones sean claras. Utiliza ejemplos e ilustraciones para mostrar qué se espera.
- Coherencia: mantén la uniformidad de las anotaciones. Establece criterios estándar para anotar distintos tipos de datos, de modo que todas las anotaciones sigan las mismas reglas.
- Reducción de sesgos: mantén la neutralidad. Aprende a ser objetivo y minimiza los sesgos personales para garantizar anotaciones justas.
- Eficiencia: Usa herramientas y flujos de trabajo que automaticen las tareas repetitivas para que el proceso de anotación sea más rápido y eficiente.
Revisar y actualizar periódicamente las reglas de etiquetado te ayudará a mantener las anotaciones precisas, coherentes y alineadas con los objetivos de tu proyecto.
Herramientas de anotación#
Una buena herramienta de anotación te permite etiquetar todos los tipos que requiere tu tarea, aplicar directrices coherentes y exportar etiquetas en un formato listo para el entrenamiento. Ultralytics Platform incluye un editor de anotaciones para detección, segmentación de instancias, segmentación semántica, clasificación, pose y OBB, junto con anotación inteligente basada en SAM, que convierte un solo clic en una máscara para tareas de detección, segmentación de instancias, segmentación semántica y OBB. Como las anotaciones se guardan con la estructura que necesita cada tarea — filas YOLO .txt para las tareas espaciales y carpetas de clases para la clasificación —, tu conjunto de datos etiquetado pasa directamente al entrenamiento, sin necesidad de convertirlo.
Calidad de las anotaciones: precisión, exactitud y valores atípicos#
Antes de anotar a gran escala, conviene entender la exactitud, la precisión, los valores atípicos y el control de calidad para no etiquetar los datos de forma contraproducente.
Cómo entender la exactitud y la precisión#
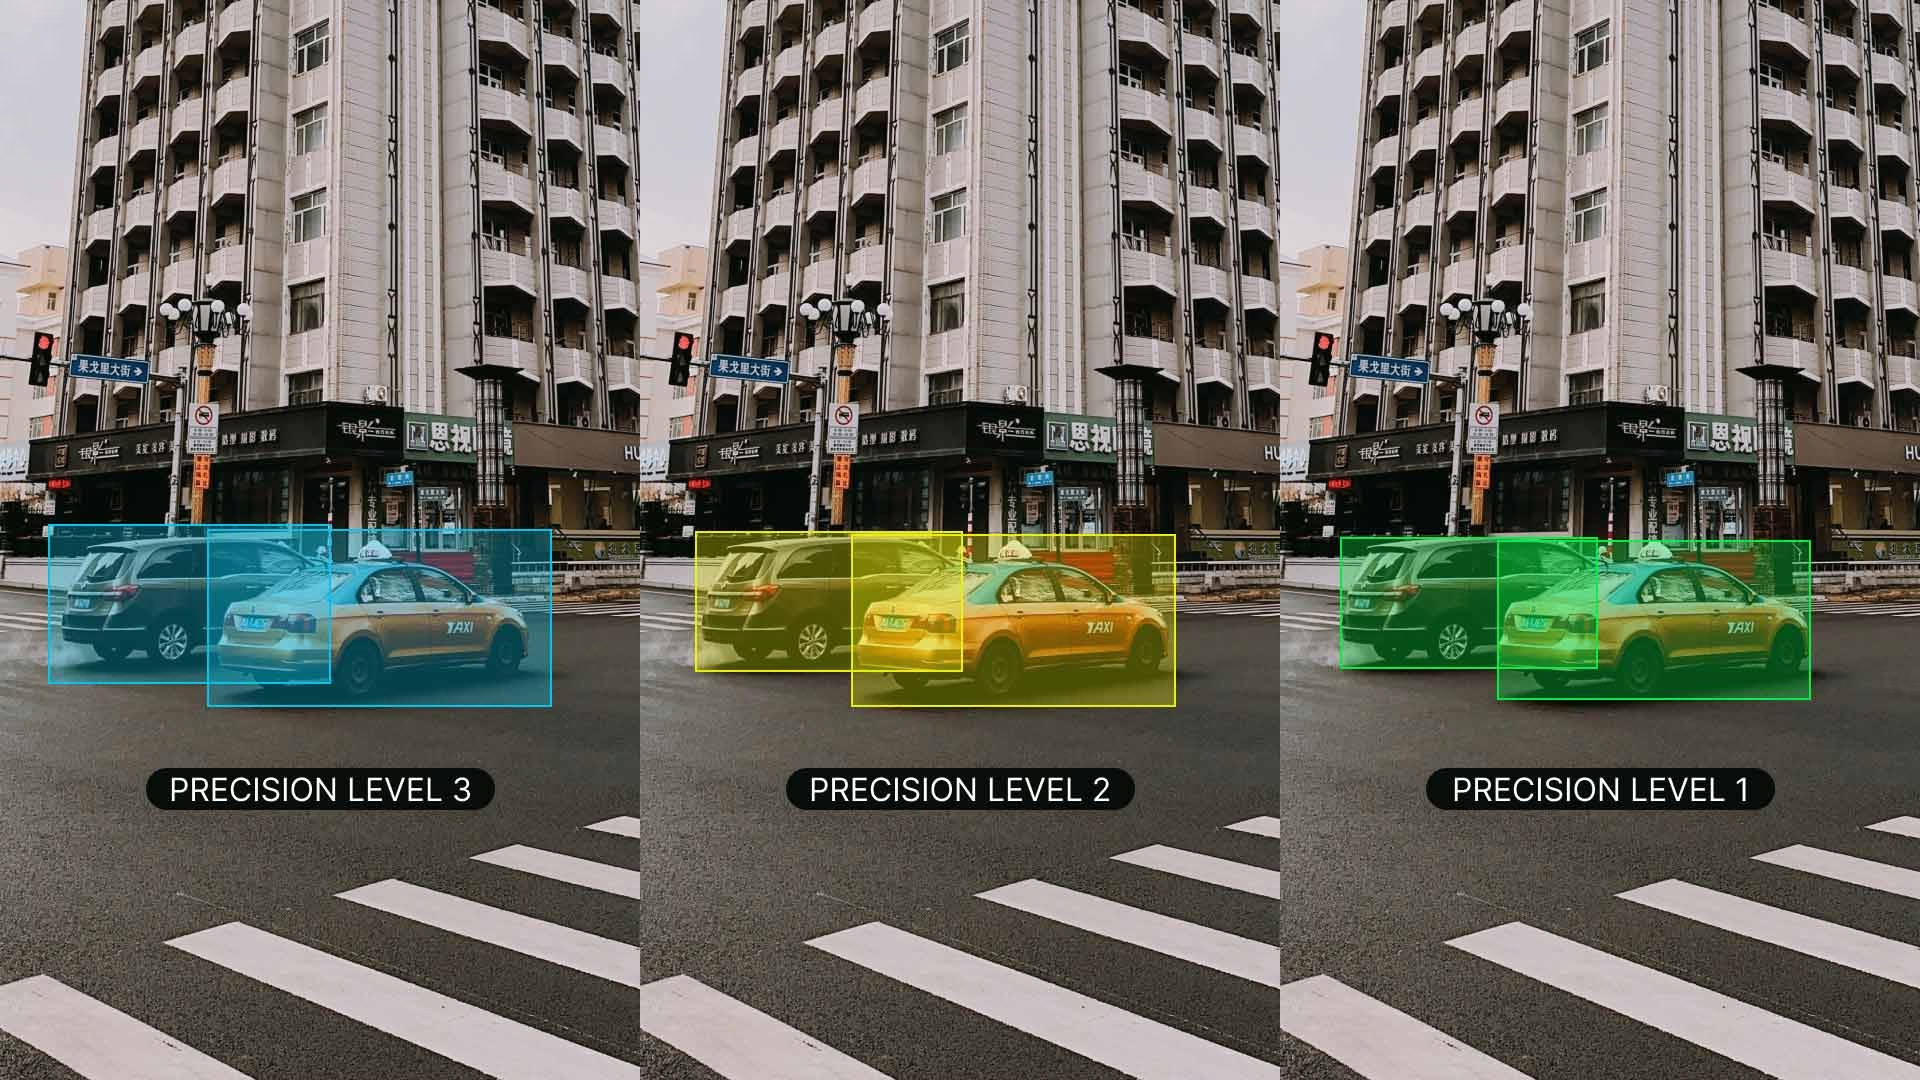
Es importante entender la diferencia entre exactitud y precisión y cómo se relacionan con la anotación. La exactitud indica cuánto se aproximan los datos anotados a los valores reales. Permite medir hasta qué punto las etiquetas reflejan situaciones del mundo real. La precisión indica la coherencia de las anotaciones. Comprueba si asignas la misma etiqueta al mismo objeto o característica en todo el conjunto de datos. Una exactitud y una precisión elevadas permiten entrenar mejores modelos, ya que reducen el ruido y mejoran la capacidad del modelo para generalizar a partir de los datos de entrenamiento.
Identificación de valores atípicos#
Los valores atípicos son puntos de datos que se desvían considerablemente de otras observaciones del conjunto de datos. En las anotaciones, un valor atípico puede ser una imagen etiquetada incorrectamente o una anotación que no encaja con el resto del conjunto de datos. Estos valores son preocupantes porque pueden distorsionar el proceso de aprendizaje del modelo, lo que provoca predicciones inexactas y una mala generalización.
Puedes utilizar distintos métodos para detectar y corregir valores atípicos:
- Técnicas estadísticas: para detectar valores atípicos en características numéricas como los valores de píxel, las coordenadas de los cuadros delimitadores o el tamaño de los objetos, puedes utilizar métodos como los diagramas de caja, los histogramas o las puntuaciones z.
- Técnicas visuales: para detectar anomalías en características categóricas como las clases de objetos, los colores o las formas, utiliza métodos visuales como representar imágenes, etiquetas o mapas de calor.
- Métodos algorítmicos: Usa herramientas como los algoritmos de agrupamiento (p. ej., agrupamiento K-means, DBSCAN) y de detección de anomalías para identificar valores atípicos a partir de los patrones de distribución de los datos.
Control de calidad de los datos anotados#
Al igual que en otros proyectos técnicos, el control de calidad es imprescindible para los datos anotados. Conviene revisar las anotaciones con regularidad para asegurarte de que sean precisas y coherentes. Puedes hacerlo de varias formas:
- Revisar muestras de datos anotados
- Utilizar herramientas automatizadas para detectar errores habituales
- Pedir a otra persona que vuelva a comprobar las anotaciones
Si trabajas con varias personas, es importante que haya coherencia entre los distintos anotadores. Un buen grado de acuerdo entre anotadores significa que las directrices son claras y que todo el mundo las sigue de la misma manera. Así, todos tienen los mismos criterios y las anotaciones son coherentes.
Si durante la revisión encuentras errores, corrígelos y actualiza las directrices para evitar que se repitan. Proporciona comentarios a quienes anotan los datos y ofrece formación periódica para ayudar a reducir los errores. Contar con un proceso sólido para gestionar errores mantiene tu conjunto de datos preciso y fiable.
Estrategias eficientes de etiquetado de datos#
Para que el proceso de etiquetado de datos sea más ágil y eficaz, plantéate aplicar estas estrategias:
- Directrices de anotación claras: Proporciona instrucciones detalladas con ejemplos para asegurarte de que todos los anotadores interpretan las tareas de forma coherente. Por ejemplo, al etiquetar aves, especifica si hay que incluir el ave entera o solo determinadas partes.
- Controles de calidad periódicos: Establece criterios de referencia y utiliza métricas específicas para revisar el trabajo; mantén unos estándares elevados mediante comentarios continuos.
- Utiliza herramientas de preanotación: Muchas plataformas de anotación modernas ofrecen funciones de preanotación asistidas por IA que pueden acelerar considerablemente el proceso al generar automáticamente anotaciones iniciales que después pueden perfeccionar las personas.
- Implementa el aprendizaje activo: Este enfoque da prioridad a etiquetar primero las muestras más informativas, lo que puede reducir el número total de anotaciones necesarias sin perjudicar el rendimiento del modelo.
- Procesamiento por lotes: Agrupa imágenes similares para anotarlas y mantener la coherencia y mejorar la eficiencia.
Estas estrategias pueden ayudar a mantener anotaciones de alta calidad y reducir el tiempo y los recursos necesarios para el proceso de etiquetado.
Conclusión#
Recopilar datos diversos y sin sesgos y anotarlos de forma coherente con las herramientas adecuadas es la base de un modelo de visión artificial fiable. Una vez recopilado y etiquetado tu conjunto de datos, continúa con la guía sobre las etapas de un proyecto de visión artificial para pasar al entrenamiento y la evaluación. Si te surgen dudas, pregunta a la comunidad en el repositorio de Ultralytics en GitHub o en el servidor de Ultralytics en Discord.
Preguntas frecuentes#
Para minimizar los sesgos, recopila datos de fuentes diversas, asegúrate de que los grupos pertinentes (como diferentes edades, géneros y etnias) estén representados de forma equilibrada, revisa y actualiza periódicamente tu conjunto de datos para detectar sesgos emergentes y aplica técnicas de mitigación, como el sobremuestreo de clases infrarrepresentadas, el aumento de datos y los algoritmos que tienen en cuenta la equidad. Evitar los sesgos de este modo permite que tu modelo de visión artificial funcione bien en distintas situaciones del mundo real y mejora su capacidad de generalización.
Establece directrices de etiquetado claras y objetivas, con instrucciones detalladas, ejemplos e ilustraciones, y aplícalas de manera uniforme a todos los tipos de datos para que cada anotación siga las mismas reglas. Forma a los anotadores para que mantengan la neutralidad y reduzcan los sesgos personales, revisa y actualiza las directrices con regularidad y utiliza comprobaciones automáticas de coherencia y comentarios entre anotadores para mantener la precisión y ajustarla a los objetivos del proyecto.
Unos cientos de objetos anotados por clase bastan para empezar a experimentar con el aprendizaje por transferencia, pero, para obtener un rendimiento fiable en el mundo real, Ultralytics recomienda al menos 1.500 imágenes y 10.000 instancias etiquetadas por clase. Combina un conjunto de datos suficientemente grande con un calendario de entrenamiento razonable —alrededor de 300 épocas es un punto de partida habitual, que puedes reducir si el modelo empieza a sobreajustarse pronto— y asegúrate de que tus anotaciones sean rigurosas y se ajusten a los objetivos específicos del proyecto. Descubre estrategias de entrenamiento detalladas en la guía de entrenamiento de YOLO26.
Sí. Ultralytics Platform incluye un editor de anotaciones integrado que admite cuadros delimitadores, polígonos, puntos clave, cuadros orientados y etiquetas de clasificación en un único espacio de trabajo. La anotación inteligente con tecnología SAM agiliza el etiquetado para tareas de detección, segmentación de instancias, segmentación semántica y OBB al generar máscaras con un solo clic; los conjuntos de datos de pose pueden utilizar modelos de pose YOLO para la anotación inteligente, mientras que la clasificación se anota manualmente. Las anotaciones se guardan en el formato que requiere cada tarea: filas
.txtde YOLO para las tareas espaciales y carpetas de clases para la clasificación; después, están listas para el entrenamiento.Elige el tipo de anotación que corresponda a la tarea que quieras entrenar. Los cuadros delimitadores son los más rápidos de dibujar y bastan para la detección de objetos. Los polígonos y las máscaras requieren bastante más tiempo por objeto, pero son necesarios para la segmentación de instancias cuando importa la forma exacta de un objeto. Los puntos clave son adecuados para la estimación de pose y la detección de puntos de referencia, mientras que los cuadros orientados sirven para tareas de OBB, como el análisis de imágenes aéreas, donde un rectángulo alineado con los ejes abarcaría demasiado fondo. Anotar con el nivel de detalle más preciso que realmente necesites permite que el esfuerzo de etiquetado sea proporcional al resultado.


Comentarios16
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
 Letícia Rama
Hello,
Has anyone worked with oriented object detection using a multisource dataset that combines satellite and UAV imagery?
I am currently developing a scientific project focused on oriented detection of fishing vessels. As part of this work, I conducted two systematic reviews: one covering existing oriented detection models and another covering publicly available datasets. So far, I have identified multisource datasets that combine imagery from multiple satellite platforms; however, I have not found datasets that explicitly integrate both satellite and UAV images.
I understand the importance of source diversity to mitigate dataset bias and improve model generalization. That said, I would appreciate insights from the community on whether combining UAV and satellite imagery might introduce excessive domain variability (e.g., differences in spatial resolution, viewing angles, and sensor characteristics), potentially hindering model training and convergence.
Any experiences, references, or best practices related to this type of multisource setup would be highly appreciated.
 Glenn JocherUltralytics
Great question—mixing UAV + satellite can increase domain shift (GSD/resolution, look-angle, sensor PSF), but it’s usually manageable if you control the dataset and evaluation: keep one unified, very explicit labeling policy (same object extent/rotation rules) and balanced sampling as described in our Data Collection and Annotation guide, then train with per-source “slice” validation (sat-only/UAV-only) and consider staged training (pretrain on the larger domain, then fine-tune on the smaller) rather than a single fully-mixed run; if you’re using Ultralytics YOLO for oriented detection, the OBB task docs cover the expected label format and training flow—feel free to share your planned split strategy and a couple example tiles (UAV + satellite) here and the team/community can sanity-check the setup.
1- Letícia Rama
Hi Glenn,
To be more specific,
I am using a pretrained yolo26 m obb to perform detection of a single class: ships of a particular type (fishing boats).
I have a dataset with satellite optical images collected from google earth pro counting 331 pairs of images/labels. The total number of instances is 5974. Images size are fixed at 4823 height x 8192 width. The bounding boxes have 0.075 height x 0.04 width (according to yolo train results). Resolution varies from very-low to very-high. The images were captured with an altitude between 200-400 meters.
I also have 21 very-high resolution images collected from UAV. Images size are fixed at 3072 height x 4096 width. The images were captured with an altitude of 120 meters.
I would like to test if incorporating UAV images in training data would improved the models hability to detect the objects.
From what you proposed, please confirm if I understood correctly:
- Should the train set be mixed (sat+UAV) and the validation set be separate (sat-only/UAV-only)?
- If so, is this separation configured the staged training you are refering? That is, pretrain with sat+UAV as the train set and sat-only as validation subset, and further fine-tune with the same train subset (sat+UAV) but now using the uav-only as the validation set?
Thanks
- Letícia Rama
OBS.: sorry, sometimes I wrote 'train subset', and 'validation subset' but all of them was supposed to be written as 'train set', and 'validation set'.
- Glenn JocherUltralytics
Your first interpretation is correct: compare a satellite-only baseline against mixed satellite+UAV training while keeping fixed, disjoint satellite-only and UAV-only evaluation sets. This is not staged training—changing only the validation set does not fine-tune the model. Staged training would first train on satellite data, then continue from that checkpoint using only the UAV training split with a lower learning rate, evaluating both domains afterward. With only 21 UAV images, split by original scene before tiling to prevent leakage, and consider grouped k-fold validation because a single UAV split will be unstable.
1 - Letícia Rama
Understood, thanks.
Sudharsanam-1
hello ! For detecting 31 Chinese symbols (16 true and 15 fake), how many classes should be used in the model? Is it more efficient to detect the true symbols using only true class , or should we also include the fake symbols as separate classes?
Team-Q-Botix
I’m working on Robocon 2026 (Kung Fu Quest) and using YOLO-seg for detecting KFS symbols — ancient Chinese oracle bone characters. There are 15 true symbols, 15 fake ones (random patterns mimicking the real ones), plus 1 “other” class → total 31 classes.
Do you think instance segmentation (YOLOv8-seg / YOLOv11-seg) is the right approach for these detailed 2D symbols, or would box detection + contour refinement be better? Also, any advice on which model to start with and how large a dataset (per class) you’d recommend for good mask performance on Jetson Orin?
robert-hardman
Hello In object recognition with YOLO11 If we label images by drawing polygons: When training, does YOLO11 convert polygon coordinates to boxes? How does Inference handle polygon coordinates?
- Glenn JocherUltralytics
@robert-hardman yOLO11 does not inherently convert polygon annotations to bounding boxes during training. Polygons are used directly for tasks like instance segmentation, while bounding boxes are utilized for object detection. During inference, polygon annotations are retained for segmentation tasks, ensuring accurate object shape representation. For more on annotation types, refer to Data Annotation Guide.
1
ghost
Hello, thanks for the info ! I would like to know how to perform active learning, specifically what are the metrics to choose the most informative images when the task is multi-instance multi-class object detection ?
 Paula DerrengerUltralytics(editado)
@cawilchesp hello! Great question on active learning for multi-instance multi-class object detection. Active learning can significantly enhance your model by iteratively selecting the most informative samples for annotation. Here are some key metrics and strategies to consider:
Metrics for Selecting Informative Images:
-
Uncertainty Sampling: Choose images where the model is least confident. This can be measured using:
- Entropy: High entropy indicates uncertainty in predictions.
- Margin Sampling: Select samples where the difference between the top two class probabilities is smallest.
- Least Confidence: Select samples with the lowest maximum class probability.
-
Diversity Sampling: Ensure a diverse set of samples to avoid redundancy.
- Core-Set Selection: Use clustering techniques to select a diverse subset of data points.
- Representative Sampling: Choose samples that represent the overall data distribution.
-
Error-Based Sampling: Focus on samples where the model previously made errors.
- Misclassified Samples: Select images where the model's predictions were incorrect.
- High Loss Samples: Choose samples with high loss values during training.
Implementing Active Learning:
Here's a basic example using least-confidence uncertainty sampling for detection, based on each image's mean box confidence (
result.probsis only available for classification models):import numpy as np from ultralytics import YOLO # Load your model model = YOLO('yolo26n.pt') # Predict on a batch of images results = model(['image1.jpg', 'image2.jpg', 'image3.jpg']) # Mean box confidence per image (0 if nothing was detected) scores = [r.boxes.conf.mean().item() if len(r.boxes) else 0.0 for r in results] # Select the image with the lowest confidence most_informative_image = results[int(np.argmin(scores))]Additional Resources:
For more detailed strategies and examples, you can refer to our Data Collection and Annotation Strategies.
Feel free to experiment with these methods and see which works best for your specific use case. If you have any further questions or need more examples, don't hesitate to ask! 😊
-
MoAbbasid
Hello, Im looking for an open source annotation tool similar to labelme that exports directly to YOLOv8 format, something other than labelme?
- Glenn JocherUltralytics
@MoAbbasid hello! For an open-source annotation tool that exports directly to YOLOv8 format, you might want to try CVAT. It's quite versatile and supports exporting annotations directly into YOLO format among others. Another good option could be Label Studio, which offers flexibility in configuring export formats, including YOLO. Both tools provide robust features for efficient data labeling and are well-suited for various annotation tasks. Happy annotating! 😊
1 @glenn-jocher do they offer polygon annotations for instance segmentation?
- Glenn JocherUltralytics(editado)
Hello @MoAbbasid,
Yes, Ultralytics YOLO does support polygon annotations for instance segmentation. This allows for more precise labeling of objects compared to traditional bounding boxes, which can be particularly useful for complex shapes and detailed segmentation tasks.
To create polygon annotations, you can use tools like Roboflow Annotate or CVAT. Both of these tools support polygon annotations and can export the data in a format compatible with Ultralytics YOLO.
Here's a brief overview of how you can use Roboflow for this purpose:
- Create a Project: Start by creating a new project in Roboflow.
- Upload Images: Upload your images to the project.
- Annotate Images: Use the polygon tool to draw detailed outlines around objects. Roboflow also offers a SAM-based label assistant to speed up the annotation process.
- Export Annotations: Once your annotations are complete, you can export the dataset in YOLO format.
For more detailed steps on using Roboflow for data annotation and management, you can refer to the Roboflow documentation.
Here's a quick example of how to load and use a dataset with polygon annotations:
from ultralytics import YOLO

# Load a YOLO26 segmentation model
model = YOLO('yolo26n-seg.pt')

# Train the model on your custom dataset
model.train(data='path/to/your/dataset.yaml', epochs=100, imgsz=640)

# Validate the model
metrics = model.val()

# Make predictions
results = model.predict(source='path/to/your/images')

# Visualize results
results[0].show()
Feel free to reach out if you have any more questions or need further assistance. Happy annotating! 😊
1