Domina el despliegue de YOLOv5 en una VM de aprendizaje profundo de Google Cloud Platform (GCP)
Google Cloud Platform (GCP) es una plataforma de computación en la nube cuya máquina virtual de aprendizaje profundo viene preconfigurada para tareas de ciencia de datos y aprendizaje automático (ML). Este tutorial explica cómo configurar Ultralytics YOLOv5 en una máquina virtual de aprendizaje profundo de GCP. Tanto si estás dando tus primeros pasos en ML como si tienes experiencia, encontrarás una guía clara para entrenar y ejecutar modelos de detección de objetos con YOLOv5.
Los nuevos usuarios de GCP también pueden solicitar una oferta de 300 $ de crédito gratuito para empezar.
Otras opciones para empezar rápidamente con YOLOv5 incluyen nuestro cuaderno de Google Colab  para trabajar desde el navegador, o la escalabilidad de Amazon AWS. También puedes usar nuestra imagen Docker oficial disponible en Docker Hub

Paso 1: Crea y configura tu VM de aprendizaje profundo#
Empieza creando una máquina virtual optimizada para el aprendizaje profundo:
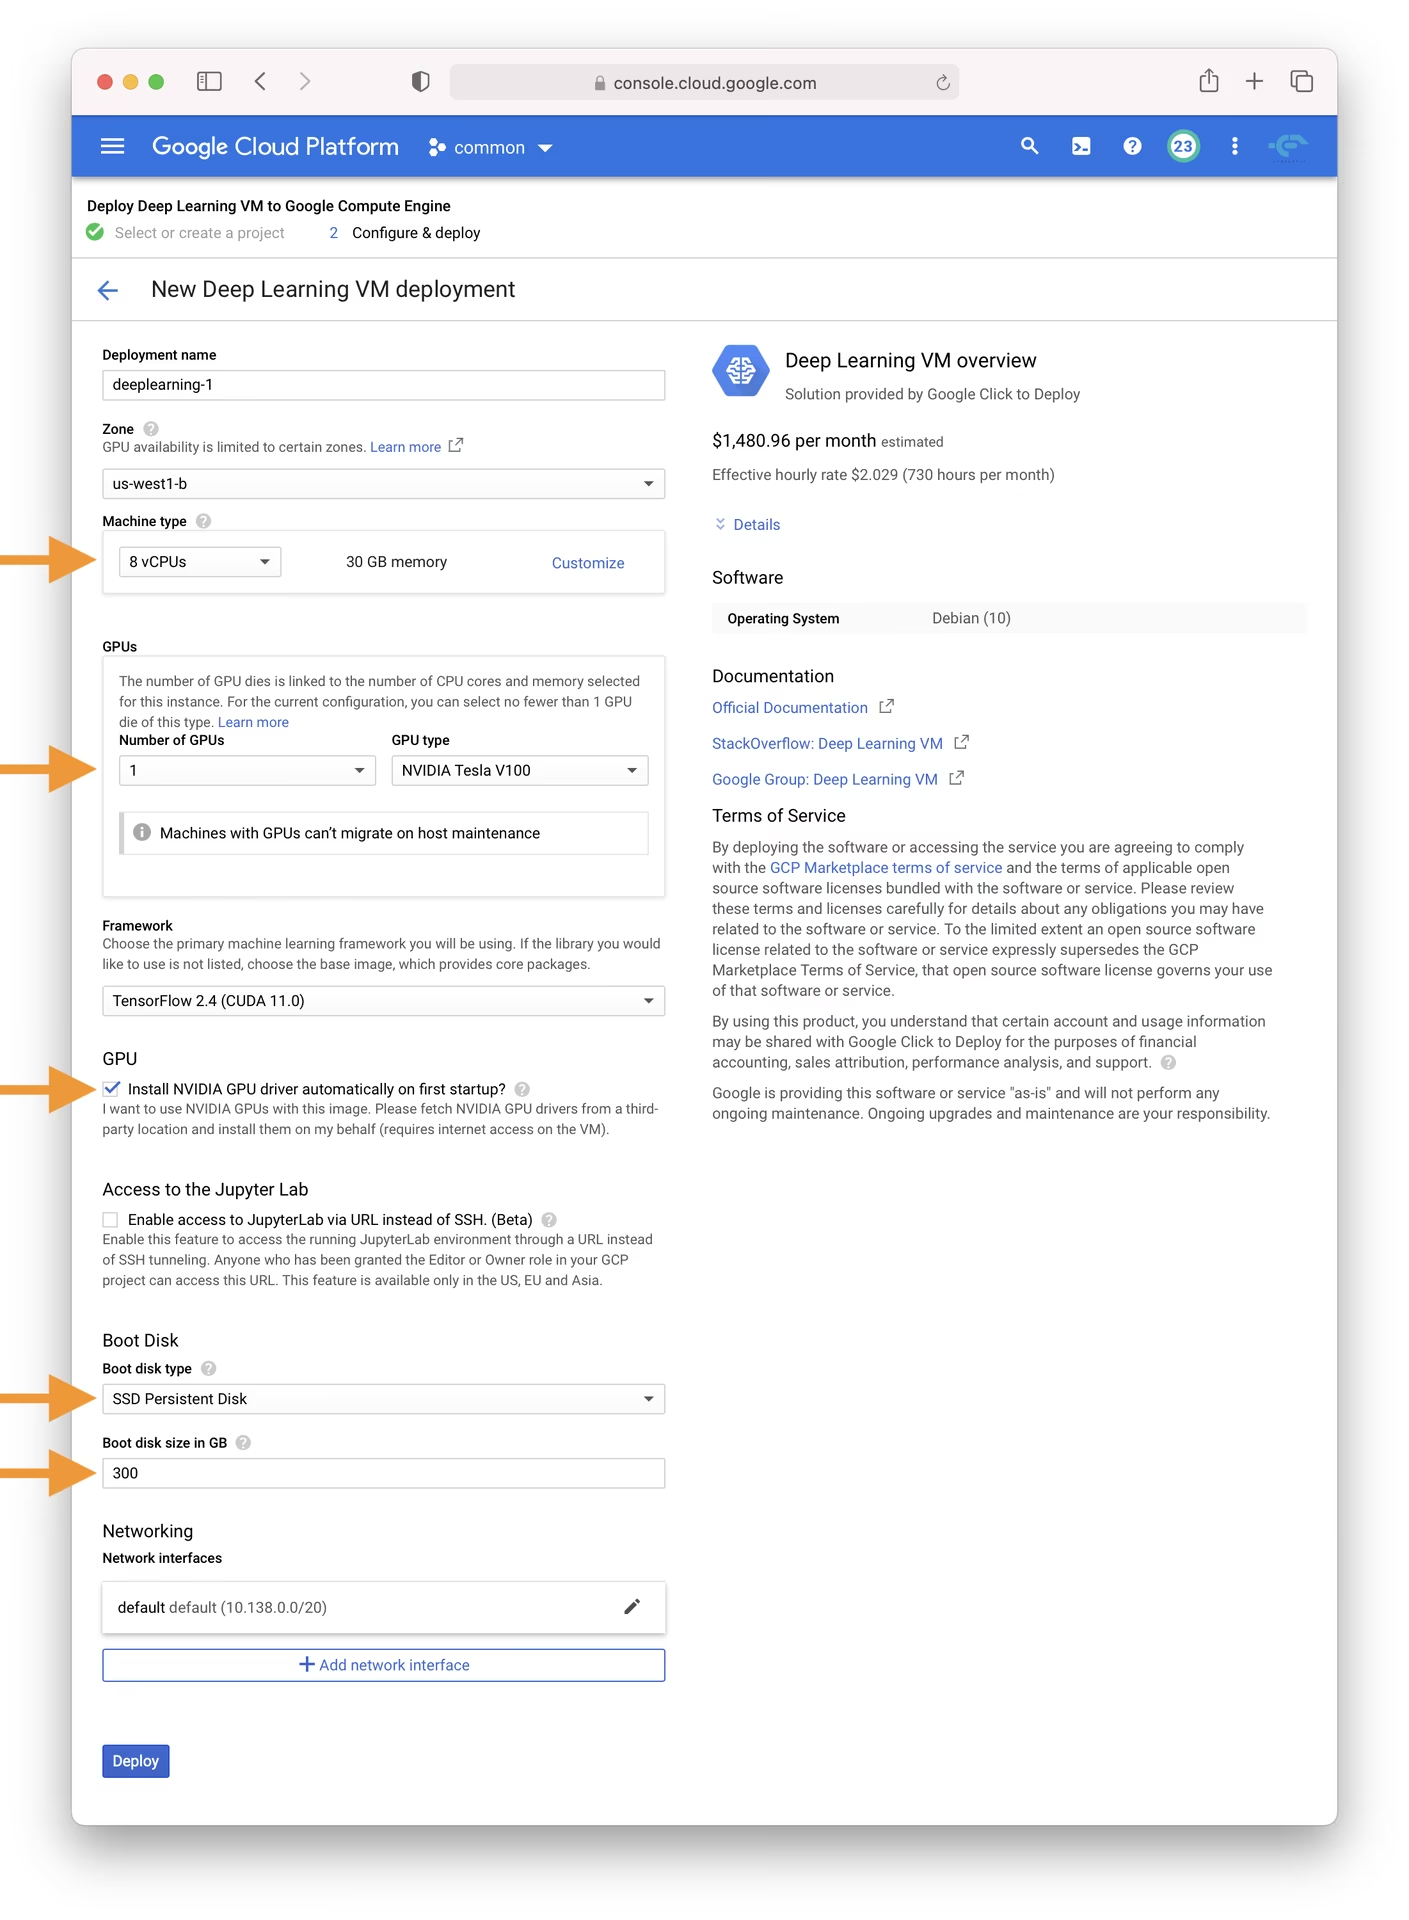
- Ve a Google Cloud Marketplace y selecciona Deep Learning VM.
- Elige una instancia n1-standard-8; ofrece un equilibrio de 8 vCPU y 30 GB de memoria, adecuado para muchas tareas de aprendizaje automático.
- Selecciona una GPU. La elección depende de tu carga de trabajo; incluso una GPU T4 básica acelerará considerablemente el entrenamiento del modelo.
- Marca la casilla «¿Instalar automáticamente el controlador de GPU NVIDIA en el primer inicio?».
- Asigna un disco persistente SSD de 300 GB para evitar cuellos de botella de E/S.
- Haz clic en «Deploy» y espera a que GCP aprovisione tu VM de aprendizaje profundo personalizada.
Esta VM incluye herramientas y marcos esenciales preinstalados, entre ellos la distribución de Python Anaconda, que incluye cómodamente muchas de las dependencias necesarias para YOLOv5.
Paso 2: Prepara la VM para YOLOv5#
A continuación, instala YOLOv5 y sus dependencias:
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install dependencies
pip install -r requirements.txt
YOLOv5 requiere Python 3.8.0 o posterior y PyTorch 1.8 o posterior. Los scripts descargan automáticamente modelos y conjuntos de datos de la versión más reciente de YOLOv5, lo que simplifica el inicio del entrenamiento del modelo.
Paso 3: Entrena y despliega tus modelos YOLOv5#
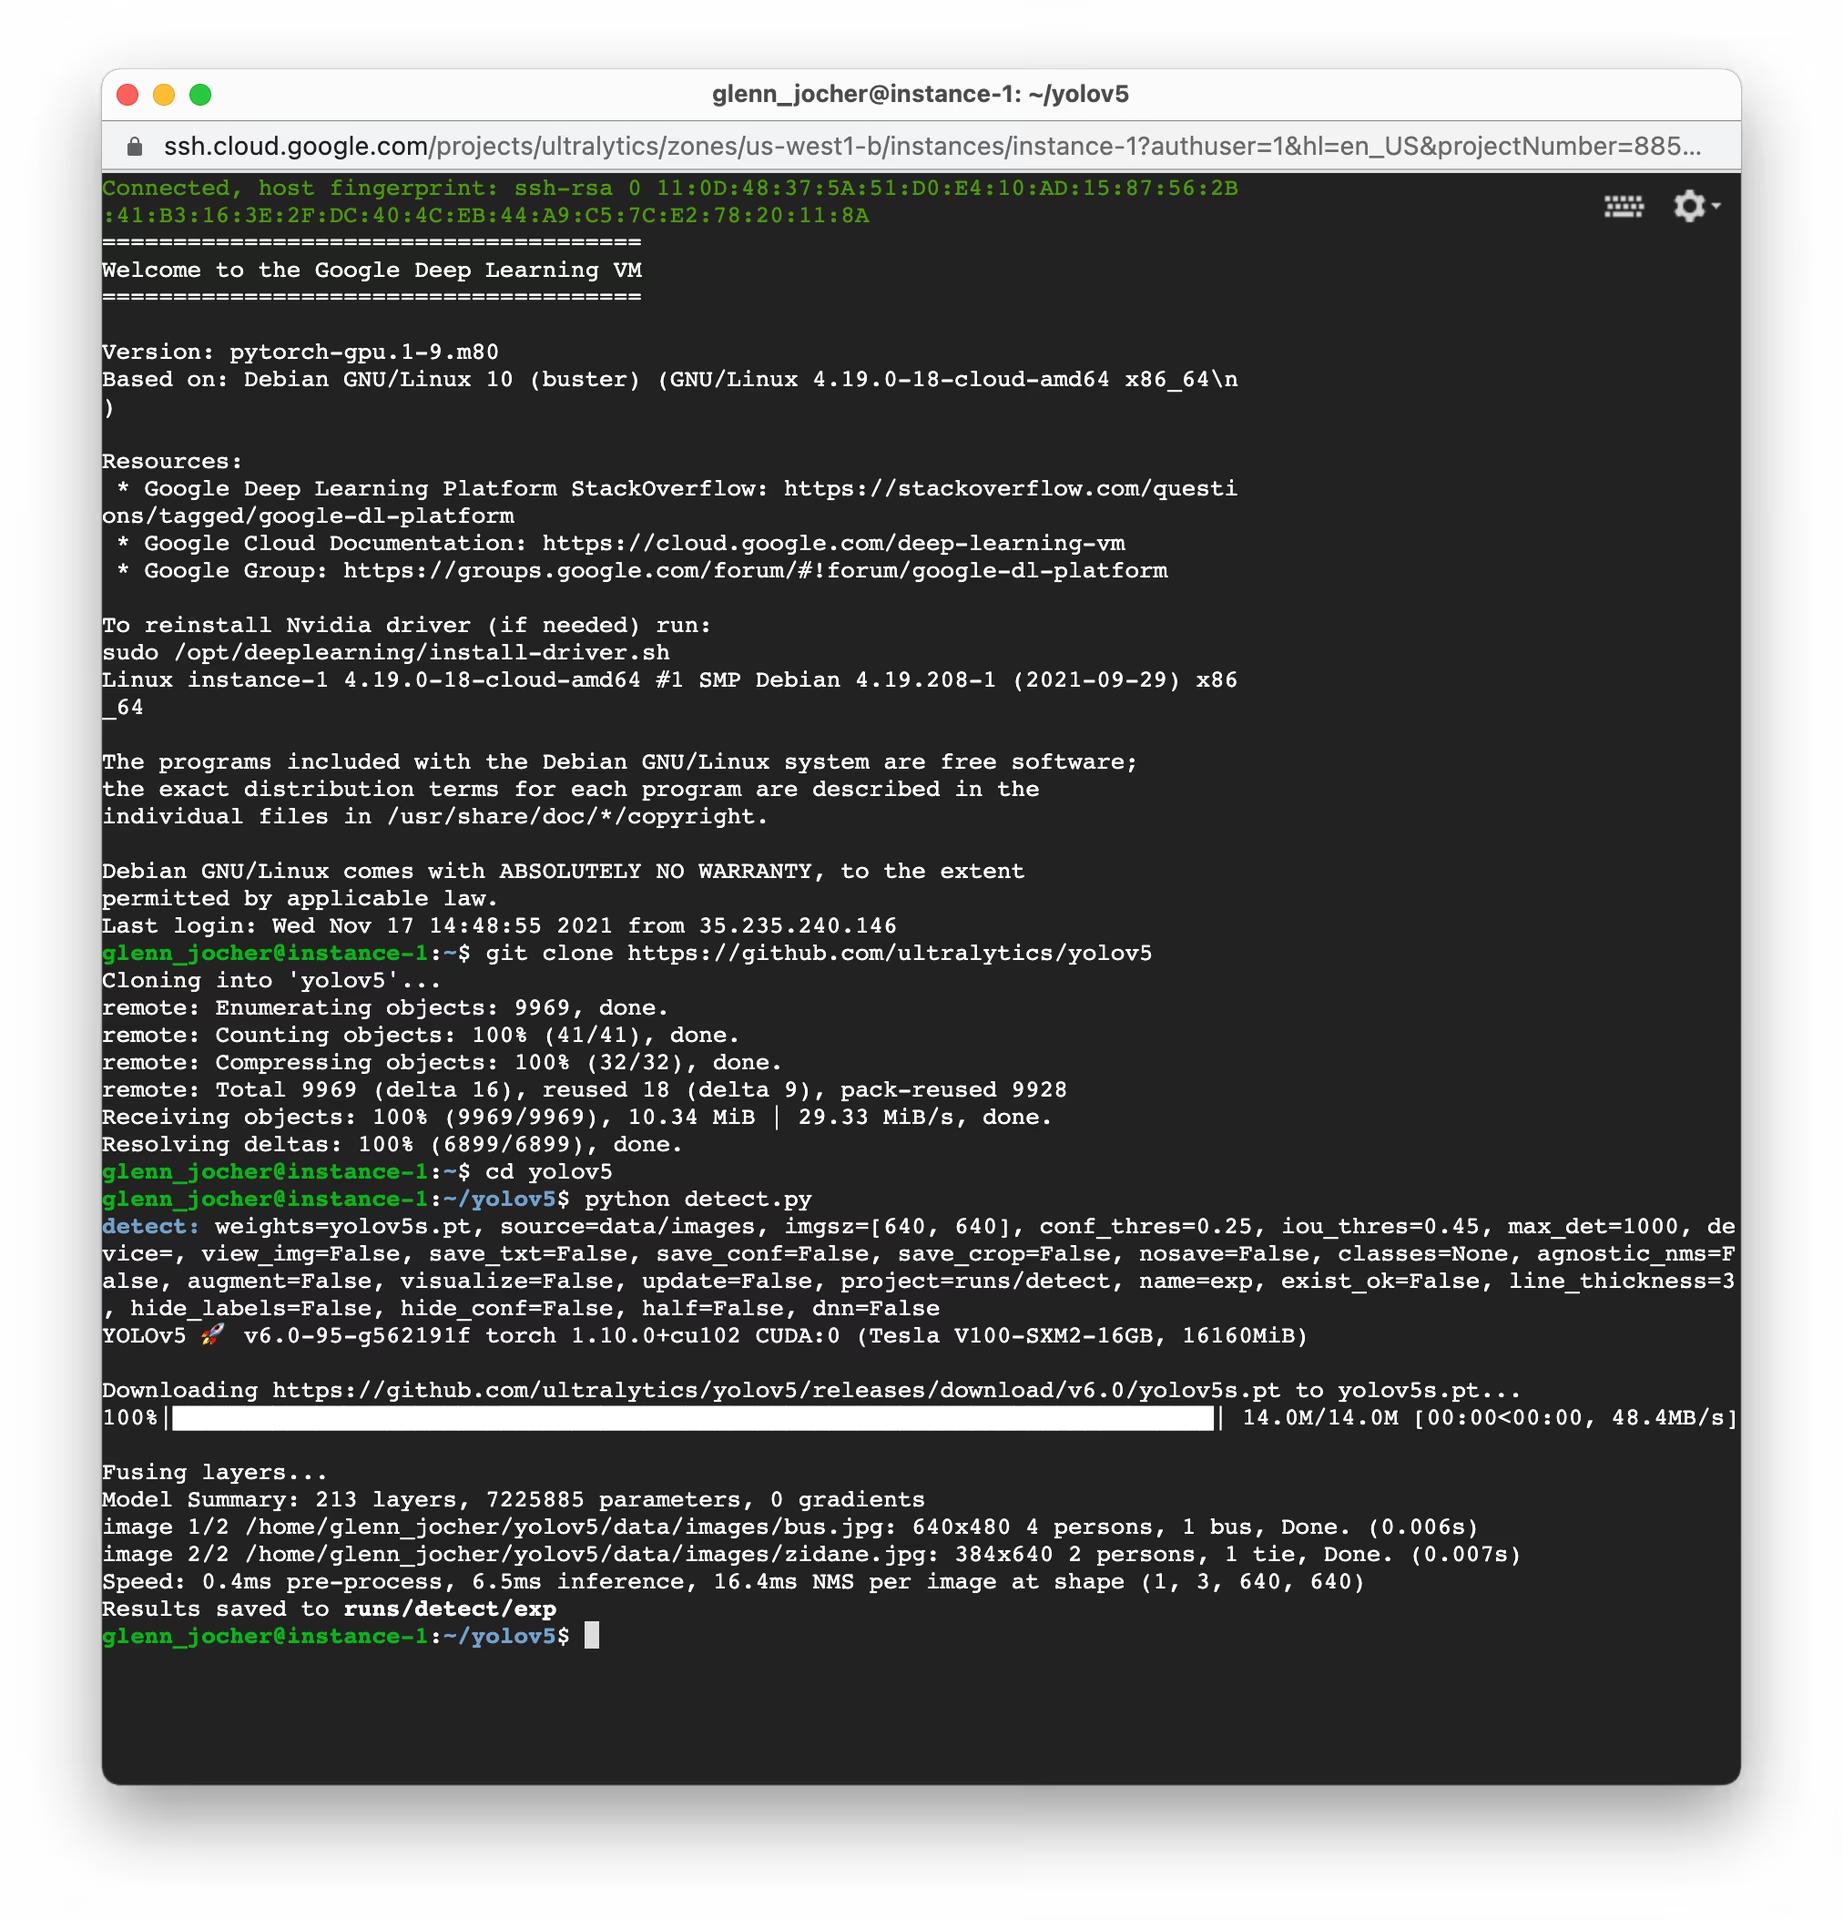
Con la configuración terminada, ya puedes entrenar, validar, predecir y exportar con YOLOv5 en tu VM de GCP:
# Train a YOLOv5 model on your dataset (e.g., yolov5s)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the trained model to check Precision, Recall, and mAP
python val.py --weights yolov5s.pt --data coco128.yaml

# Run inference using the trained model on images or videos
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite
Con unos pocos comandos, puedes entrenar modelos personalizados de detección de objetos adaptados a tus necesidades o empezar con pesos preentrenados para obtener resultados rápidamente.
Asigna espacio de intercambio (opcional)#
Si trabajas con conjuntos de datos especialmente grandes que podrían superar la RAM de tu VM, plantéate añadir espacio de intercambio para evitar errores de memoria:
# Allocate a 64GB swap file
sudo fallocate -l 64G /swapfile

# Set the correct permissions for the swap file
sudo chmod 600 /swapfile

# Set up the Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap space allocation (should show increased swap memory)
free -h
Entrena con conjuntos de datos personalizados#
Para entrenar YOLOv5 con tu conjunto de datos personalizado en GCP, sigue estos pasos generales:
-
Prepara el conjunto de datos en el formato de YOLOv5 (imágenes y sus correspondientes archivos de etiquetas). Consulta nuestra descripción general de los conjuntos de datos para obtener orientación.
-
Sube tu conjunto de datos a la VM de GCP con
gcloud compute scpo mediante la función SSH de la consola web. -
Crea un archivo YAML de configuración del conjunto de datos (
custom_dataset.yaml) que especifique las rutas a los datos de entrenamiento y validación, el número de clases y sus nombres. -
Inicia el proceso de entrenamiento con el archivo YAML de tu conjunto de datos personalizado y, si quieres, parte de pesos preentrenados:
# Example: Train YOLOv5s on a custom dataset for 100 epochs
python train.py --img 640 --batch 16 --epochs 100 --data custom_dataset.yaml --weights yolov5s.pt
Para obtener instrucciones completas sobre cómo preparar los datos y entrenar con conjuntos de datos personalizados, consulta el tutorial Entrenar con datos personalizados.
Aprovecha el almacenamiento en la nube#
Para gestionar los datos de forma eficiente, sobre todo si trabajas con conjuntos de datos grandes o muchos experimentos, integra tu flujo de trabajo de YOLOv5 con Google Cloud Storage:
# Ensure Google Cloud SDK is installed and initialized
# If not installed: curl https://sdk.cloud.google.com/ | bash
# Then initialize: gcloud init

# Example: Copy your dataset from a GCS bucket to your VM
gsutil cp -r gs://your-data-bucket/my_dataset ./datasets/

# Example: Copy trained model weights from your VM to a GCS bucket
gsutil cp -r ./runs/train/exp/weights gs://your-models-bucket/yolov5_custom_weights/
Este método te permite almacenar de forma segura y económica grandes conjuntos de datos y modelos entrenados en la nube, reduciendo al mínimo el espacio de almacenamiento necesario en tu VM.
Conclusión#
Ya tienes Ultralytics YOLOv5 ejecutándose en una máquina virtual de aprendizaje profundo de Google Cloud Platform, lista para proyectos de detección de objetos que van desde experimentos personales e investigación académica hasta soluciones industriales.
Plantéate usar Ultralytics Platform para entrenar y gestionar tus modelos sin código.
Si tienes preguntas o quieres colaborar, únete a los debates de GitHub.
Preguntas frecuentes#
Una máquina
n1-standard-8con una sola GPU T4 basta para la mayoría de las tareas de entrenamiento e inferencia con YOLOv5. Pásate a una L4 o A100 para trabajar con conjuntos de datos grandes o modelos más grandes y marca siempre la opción de instalar automáticamente el controlador de NVIDIA en el primer arranque.Detén la VM desde la consola de Compute Engine cuando esté inactiva. Seguirás pagando por el disco conectado, así que elimina la VM y el disco cuando termines el proyecto y hayas copiado de forma segura los pesos a Cloud Storage.
Para conjuntos de datos pequeños, usa
gcloud compute scp. Para cualquier conjunto de datos más grande, súbelo a un bucket de Cloud Storage y descárgalo congsutil cp -r gs://your-bucket/dataset ./datasets/, que es mucho más rápido dentro de la red de Google.Sí. La Deep Learning VM ya incluye PyTorch, por lo que
pip install ultralyticsañade el entrenamiento y la exportación de YOLO26 con la CLIyolo.


Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.