Poda y dispersión de modelos en YOLOv5#
📚 Esta guía explica cómo aplicar la poda a los modelos YOLOv5 🚀 para crear redes más eficientes sin perder rendimiento.
¿Qué es la poda de modelos?#
La poda de modelos es una técnica para reducir el tamaño y la complejidad de las redes neuronales mediante la eliminación de los parámetros menos importantes (pesos y conexiones). Este proceso crea un modelo más eficiente con varias ventajas:
- Menor tamaño del modelo para facilitar su implementación en dispositivos con recursos limitados
- Inferencia más rápida con un impacto mínimo en la precisión
- Menor uso de memoria y consumo energético
- Mayor eficiencia general para aplicaciones en tiempo real
La poda identifica y elimina los parámetros que contribuyen poco al rendimiento del modelo, lo que da como resultado un modelo más ligero con una precisión similar.
Antes de empezar#
Clona el repositorio e instala requirements.txt en un entorno Python>=3.8.0 que incluya PyTorch>=1.8. Los modelos y los conjuntos de datos se descargan automáticamente desde la versión más reciente de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Prueba del rendimiento de referencia#
Antes de aplicar la poda, establece un rendimiento de referencia con el que comparar. Este comando prueba YOLOv5x con COCO val2017 a un tamaño de imagen de 640 píxeles. yolov5x.pt es el modelo más grande y preciso disponible. Otras opciones son yolov5s.pt, yolov5m.pt y yolov5l.pt, o tu propio checkpoint obtenido al entrenar con un conjunto de datos personalizado, es decir, runs/train/exp/weights/best.pt. Para ver los detalles de todos los modelos disponibles, consulta la tabla del README.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSalida:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
Aplicar poda a YOLOv5x (30 % de dispersión)#
Podemos aplicar la poda al modelo con la función prune() definida en utils/torch_utils.py. Para probar un modelo podado, actualizamos val.py para podar YOLOv5x con una dispersión de 0.3 (el 30 % de los pesos se establece en cero):
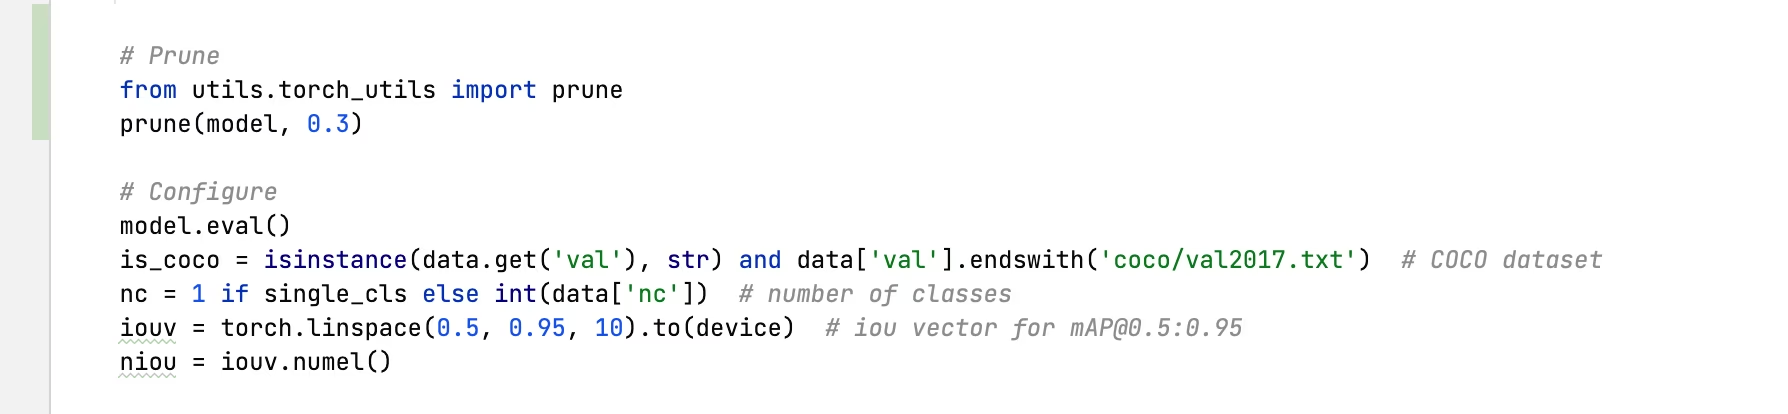
Resultado con un 30 % de poda:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
Análisis de resultados#
A partir de los resultados, podemos observar lo siguiente:
- Dispersión del 30 % alcanzada: el 30 % de los parámetros de peso del modelo en las capas
nn.Conv2dahora vale cero - El tiempo de inferencia no cambia: a pesar de la poda, la velocidad de procesamiento es prácticamente la misma
- Impacto mínimo en el rendimiento: el mAP bajó ligeramente de 0.507 a 0.489 (solo un 3.6 %)
- El tamaño del modelo no cambia: los pesos puestos a cero siguen almacenándose de forma densa, así que el tamaño del archivo solo se reduce con formatos compatibles con datos dispersos o mediante compresión
Esto demuestra que la poda puede reducir significativamente la complejidad del modelo con un impacto menor en el rendimiento, por lo que es una técnica de optimización eficaz para implementarlo en entornos con recursos limitados.
Ajuste fino de modelos podados#
Para obtener los mejores resultados, los modelos podados deben ajustarse finamente después de la poda para recuperar precisión. Puedes hacerlo de la siguiente manera:
- Aplicar la poda con el nivel de dispersión deseado
- Entrenar el modelo podado durante unas pocas épocas con una tasa de aprendizaje más baja
- Evaluar el modelo podado y ajustado finamente frente al modelo de referencia
Este proceso ayuda a los parámetros restantes a adaptarse para compensar las conexiones eliminadas y, a menudo, permite recuperar toda o casi toda la precisión original.
Entornos compatibles#
Ultralytics ofrece una variedad de entornos listos para usar, cada uno con dependencias esenciales preinstaladas, como CUDA, CUDNN, Python y PyTorch, para que puedas poner en marcha tus proyectos.
- Cuadernos gratuitos con GPU:


- Google Cloud: Guía de inicio rápido de GCP
- Amazon: Guía de inicio rápido de AWS
- Azure: Guía de inicio rápido de AzureML
- Docker: Guía de inicio rápido de Docker

Estado del proyecto#

Esta insignia indica que todas las pruebas de integración continua (CI) de GitHub Actions de YOLOv5 se superan correctamente. Estas pruebas de CI comprueban rigurosamente la funcionalidad y el rendimiento de YOLOv5 en varios aspectos clave: entrenamiento, validación, inferencia, exportación y evaluaciones comparativas. Garantizan un funcionamiento uniforme y fiable en macOS, Windows y Ubuntu, con pruebas cada 24 horas y tras cada nueva confirmación.
Preguntas frecuentes#
La poda no estructurada establece los pesos en cero, pero mantiene intactas las dimensiones de los tensores, por lo que los kernels densos de PyTorch realizan la misma cantidad de trabajo. Para acelerar la ejecución, se necesita un entorno de ejecución compatible con la dispersión, como DeepSparse, o una poda estructurada que elimine canales enteros.
Llama a la función auxiliar desde
utils/torch_utils.pyantes de la validación o la exportación:from utils.torch_utils import prune prune(model, amount=0.3) # Dispersión global del 30 % en los pesos de nn.Conv2dEmpieza con 0.3 y mide el mAP. YOLOv5x perdió alrededor de un 3.6 % de mAP con una dispersión del 30 % sin ajuste fino; los niveles de dispersión más altos suelen requerir unas pocas épocas de reentrenamiento con una tasa de aprendizaje baja para recuperar la precisión.
Sí. Los pesos puestos a cero se guardan igual que los demás, así que
export.pyfunciona sin cambios. El tamaño del archivo solo se reduce si el formato de destino o el entorno de ejecución comprime los tensores dispersos.