Ensamblado de modelos YOLOv5#
📚 Esta guía explica cómo usar el ensamblado de modelos de Ultralytics YOLOv5 🚀 durante las pruebas y la inferencia para mejorar el mAP y la exhaustividad.
De aprendizaje por ensamblado:
El modelado por ensamblado es un proceso en el que se crean varios modelos diversos para predecir un resultado, ya sea mediante el uso de distintos algoritmos de modelado o de diferentes conjuntos de datos de entrenamiento. A continuación, el modelo ensamblado agrega las predicciones de cada modelo base y genera una predicción final para los datos no vistos. El objetivo de usar modelos ensamblados es reducir el error de generalización de las predicciones. Siempre que los modelos base sean diversos e independientes, el error de predicción del modelo disminuye al utilizar el enfoque de ensamblado. Este enfoque busca aprovechar la sabiduría colectiva para hacer una predicción. Aunque el modelo ensamblado contiene varios modelos base, actúa y funciona como un único modelo.
Antes de empezar#
Clona el repositorio e instala requirements.txt en un entorno Python>=3.8.0 que incluya PyTorch>=1.8. Los modelos y los conjuntos de datos se descargan automáticamente desde la versión más reciente de YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Prueba normal#
Antes de ensamblar modelos, establece el rendimiento de referencia de un único modelo. Este comando prueba YOLOv5x con COCO val2017 a un tamaño de imagen de 640 píxeles. yolov5x.pt es el modelo más grande y preciso disponible. Otras opciones son yolov5n.pt, yolov5s.pt, yolov5m.pt y yolov5l.pt, o tu propio checkpoint obtenido al entrenar con un conjunto de datos personalizado, es decir, runs/train/exp/weights/best.pt. Para ver los detalles de todos los modelos disponibles, consulta la tabla de checkpoints preentrenados.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSalida:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Prueba del ensamblado#
Puedes ensamblar varios modelos preentrenados durante las pruebas y la inferencia; solo tienes que añadir más modelos al argumento --weights en cualquier comando existente de val.py o detect.py. Este ejemplo prueba un ensamblado de 2 modelos:
- YOLOv5x
- YOLOv5l6
python val.py --weights yolov5x.pt yolov5l6.pt --data coco.yaml --img 640 --halfPuedes enumerar tantos checkpoints como quieras, incluidos pesos personalizados como runs/train/exp5/weights/best.pt. YOLOv5 ejecutará cada modelo automáticamente y concatenará sus predicciones por imagen antes de aplicar NMS.
Salida:
val: data=./data/coco.yaml, weights=['yolov5x.pt', 'yolov5l6.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients  # Model 1
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients  # Model 2
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']  # Ensemble notice

val: Scanning '../datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:00<00:00, 49695545.02it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [03:58<00:00,  1.52s/it]
                 all       5000      36335      0.747      0.637      0.692      0.502
Speed: 0.1ms pre-process, 39.5ms inference, 2.0ms NMS per image at shape (32, 3, 640, 640)  # <--- ensemble speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.515  # <--- ensemble mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.699
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.557
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.356
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.563
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.668
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.387
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.638
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.689  # <--- ensemble mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.743
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.844
Inferencia con el ensamblado#
Añade más modelos al argumento --weights para ejecutar la inferencia con el ensamblado:
python detect.py --weights yolov5x.pt yolov5l6.pt --img 640 --source data/imagesSalida:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']

image 1/2 /content/yolov5/data/images/bus.jpg: 640x512 4 persons, 1 bus, 1 tie, Done. (0.063s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 384x640 3 persons, 2 ties, Done. (0.056s)
Results saved to runs/detect/exp2
Done. (0.223s)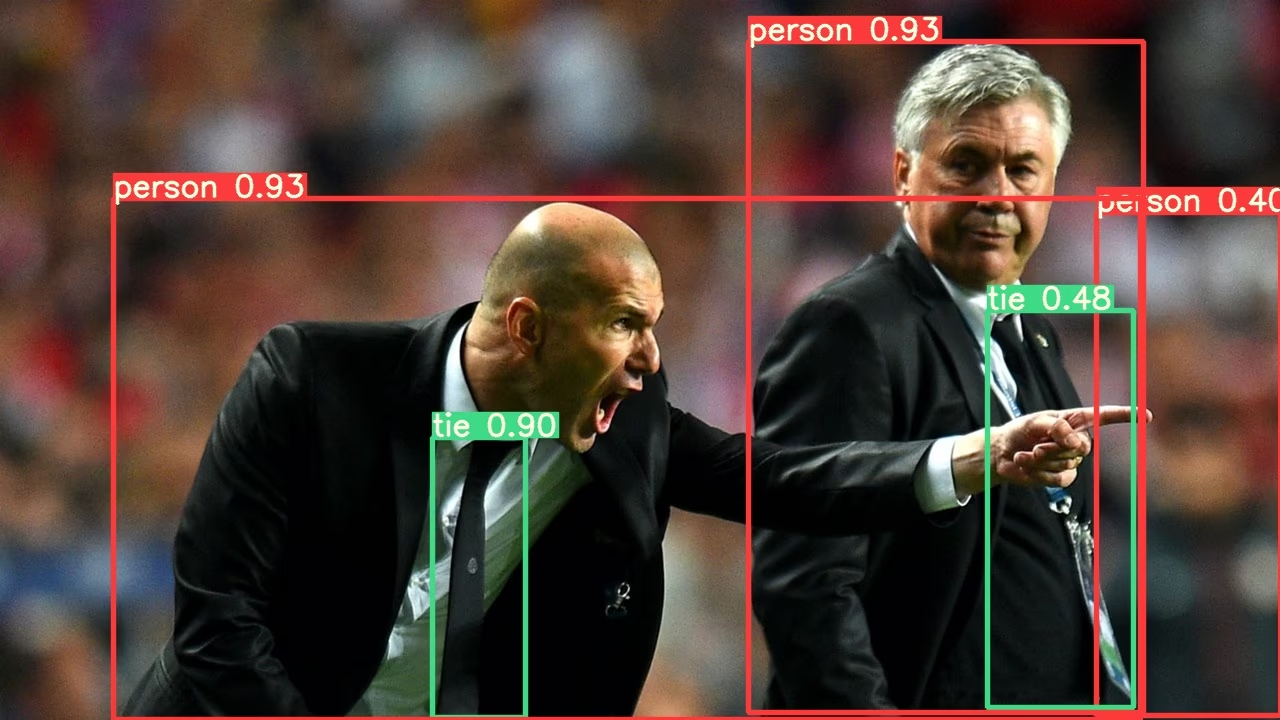
Ventajas del ensamblado de modelos#
El ensamblado de modelos con YOLOv5 ofrece varias ventajas:
- Mayor precisión: Como muestran los ejemplos anteriores, ensamblar varios modelos aumenta el mAP de 0.504 a 0.515 y el mAR de 0.681 a 0.689.
- Mejor generalización: La combinación de modelos diversos ayuda a reducir el sobreajuste y mejora el rendimiento con datos variados.
- Mayor robustez: Los ensamblados suelen ser más robustos frente al ruido y los valores atípicos de los datos.
- Fortalezas complementarias: Cada modelo puede destacar en la detección de distintos tipos de objetos o en diferentes condiciones ambientales.
La principal contrapartida es el aumento del tiempo de inferencia, como muestran las métricas de velocidad (22.4 ms para un único modelo frente a 39.5 ms para el ensamblado).
Cuándo usar el ensamblado de modelos#
Valora usar el ensamblado de modelos en estos casos:
- Cuando la precisión sea más importante que la velocidad de inferencia
- En aplicaciones críticas en las que deban minimizarse los falsos negativos
- Al procesar imágenes difíciles con iluminación, oclusión o escala variables
- Durante competiciones o evaluaciones comparativas en las que se requiera el máximo rendimiento
En aplicaciones en tiempo real con requisitos estrictos de latencia, puede ser más apropiado inferir con un único modelo.
Entornos compatibles#
Ultralytics ofrece una variedad de entornos listos para usar, cada uno con dependencias esenciales preinstaladas, como CUDA, CUDNN, Python y PyTorch, para que puedas poner en marcha tus proyectos.
- Cuadernos gratuitos con GPU:


- Google Cloud: Guía de inicio rápido de GCP
- Amazon: Guía de inicio rápido de AWS
- Azure: Guía de inicio rápido de AzureML
- Docker: Guía de inicio rápido de Docker

Estado del proyecto#

Esta insignia indica que todas las pruebas de integración continua (CI) de GitHub Actions de YOLOv5 se superan correctamente. Estas pruebas de CI comprueban rigurosamente la funcionalidad y el rendimiento de YOLOv5 en varios aspectos clave: entrenamiento, validación, inferencia, exportación y evaluaciones comparativas. Garantizan un funcionamiento uniforme y fiable en macOS, Windows y Ubuntu, con pruebas cada 24 horas y tras cada nueva confirmación.
Preguntas frecuentes#
Los que quieras. Enumera todos los checkpoints después de
--weights, por ejemplo,--weights yolov5x.pt yolov5l6.pt runs/train/exp/weights/best.pt. El tiempo de inferencia aumenta aproximadamente en proporción al número de modelos.Sí. Las predicciones se concatenan antes de aplicar NMS, así que todos los modelos deben entrenarse con la misma lista de clases y en el mismo orden. Los tamaños de entrada y las arquitecturas pueden ser distintos.
Sí. Añade
--augmental mismo comandoval.pyodetect.pypara aplicar TTA a todos los modelos del ensamblado.El módulo
Ensemblede PyTorch enmodels/experimental.pyse encarga del ensamblado, por lo que solo se aplica a los checkpoints de.pt. Exporta cada modelo por separado si necesitas archivos ONNX o TensorRT.