Integración con ClearML#

Acerca de ClearML#
ClearML es una plataforma de MLOps de código abierto diseñada para agilizar los flujos de trabajo de aprendizaje automático y ahorrar tiempo de ingeniería.
- 🔨 Registra cada ejecución de entrenamiento de YOLOv5 en el gestor de experimentos.
- 🔧 Versiona y accede a tus datos de entrenamiento personalizados con la herramienta de control de versiones de datos integrada de ClearML.
- 🔦 Entrena y supervisa ejecuciones de forma remota con ClearML Agent.
- 🔬 Encuentra el mejor mAP con la optimización de hiperparámetros de ClearML.
- 🔭 Convierte tu modelo YOLOv5 entrenado en una API con unos pocos comandos usando ClearML Serving.
Usa tantas o tan pocas de estas herramientas como necesites: empieza solo con el gestor de experimentos o conéctalas todas para crear una canalización completa.
🦾 Configuración#
ClearML necesita comunicarse con un servidor para hacer un seguimiento de tus experimentos y datos. Tienes dos opciones:
- Regístrate en el servicio alojado de ClearML, que es gratuito, o
- Despliega tu propio servidor de ClearML: es de código abierto, por lo que sigue siendo una opción viable incluso para datos sensibles.
A continuación, instala el paquete de Python clearml y conecta el SDK a tu servidor:
pip install clearmlGenera credenciales en Configuración → Espacio de trabajo → Crear credenciales nuevas (en la parte superior derecha de la interfaz de ClearML) y, después, ejecuta:
clearml-initSigue las indicaciones. Ya está: la configuración ha terminado.
🚀 Entrenar YOLOv5 con ClearML#
Para habilitar el seguimiento de experimentos, instala el paquete pip de ClearML si aún no lo has hecho:
pip install clearmlEsto habilitará la integración con el script de entrenamiento de YOLOv5. A partir de ahora, el gestor de experimentos de ClearML registrará y almacenará todas las ejecuciones de entrenamiento.
Para personalizar los nombres del proyecto y de la tarea, pasa --project y --name a train.py. Los valores predeterminados son YOLOv5 y Training. ClearML usa / como delimitador de subproyectos, así que evita / en los nombres personalizados de proyecto.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheO bien, usa nombres personalizados:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheCada ejecución registra:
- El código fuente y los cambios sin confirmar
- Los paquetes instalados
- Los hiperparámetros
- Los puntos de control del modelo (usa
--save-period npara guardar cadanépocas) - La salida de la consola
- Los valores escalares (mAP_0.5, mAP_0.5:0.95, precisión, exhaustividad, pérdidas, tasas de aprendizaje)
- Los detalles de la máquina, el tiempo de ejecución y la fecha de creación
- Gráficos generados, como el correlograma de etiquetas y la matriz de confusión
- Imágenes con cuadros delimitadores por época
- Visualizaciones de mosaicos por época
- Imágenes de validación por época
Todo aparece en la interfaz de ClearML para que puedas supervisar el entrenamiento desde un único lugar. Añade columnas personalizadas (por ejemplo, mAP_0.5) para ordenar por el modelo con mejor rendimiento, o selecciona varios experimentos para compararlos en paralelo.
Sigue leyendo sobre la optimización de hiperparámetros y la ejecución remota.
🔗 Gestión de versiones de conjuntos de datos#
Versionar los datos por separado del código facilita obtener la última versión y garantiza una reproducibilidad completa. Este repositorio acepta un ID de versión del conjunto de datos, obtiene los datos automáticamente si faltan y registra el ID como parámetro de la tarea para que siempre sepas qué datos se usaron en cada experimento.
Preparar el conjunto de datos#
El repositorio YOLOv5 admite muchos conjuntos de datos mediante archivos de configuración YAML. De forma predeterminada, los conjuntos de datos se descargan en la carpeta ../datasets, relativa a la raíz del repositorio. Tras descargar coco128, la estructura de carpetas es la siguiente:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
Puedes usar cualquier conjunto de datos, siempre que conserves esta estructura.
A continuación, copia el archivo YAML del conjunto de datos en la carpeta raíz del conjunto de datos: ClearML lee este archivo para usar correctamente el conjunto de datos. Puedes escribir tu propio YAML siguiendo el diseño del ejemplo y asegurándote de que define path, train, test, val, nc y names.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
Subir el conjunto de datos#
Para registrar el conjunto de datos como un conjunto de datos versionado de ClearML, ve a su carpeta raíz y ejecuta:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync es una forma abreviada de la siguiente secuencia, que también puedes ejecutar explícitamente:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
Entrenar con un conjunto de datos de ClearML#
Una vez registrado el conjunto de datos, indica su ID al entrenamiento:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 Optimización de hiperparámetros#
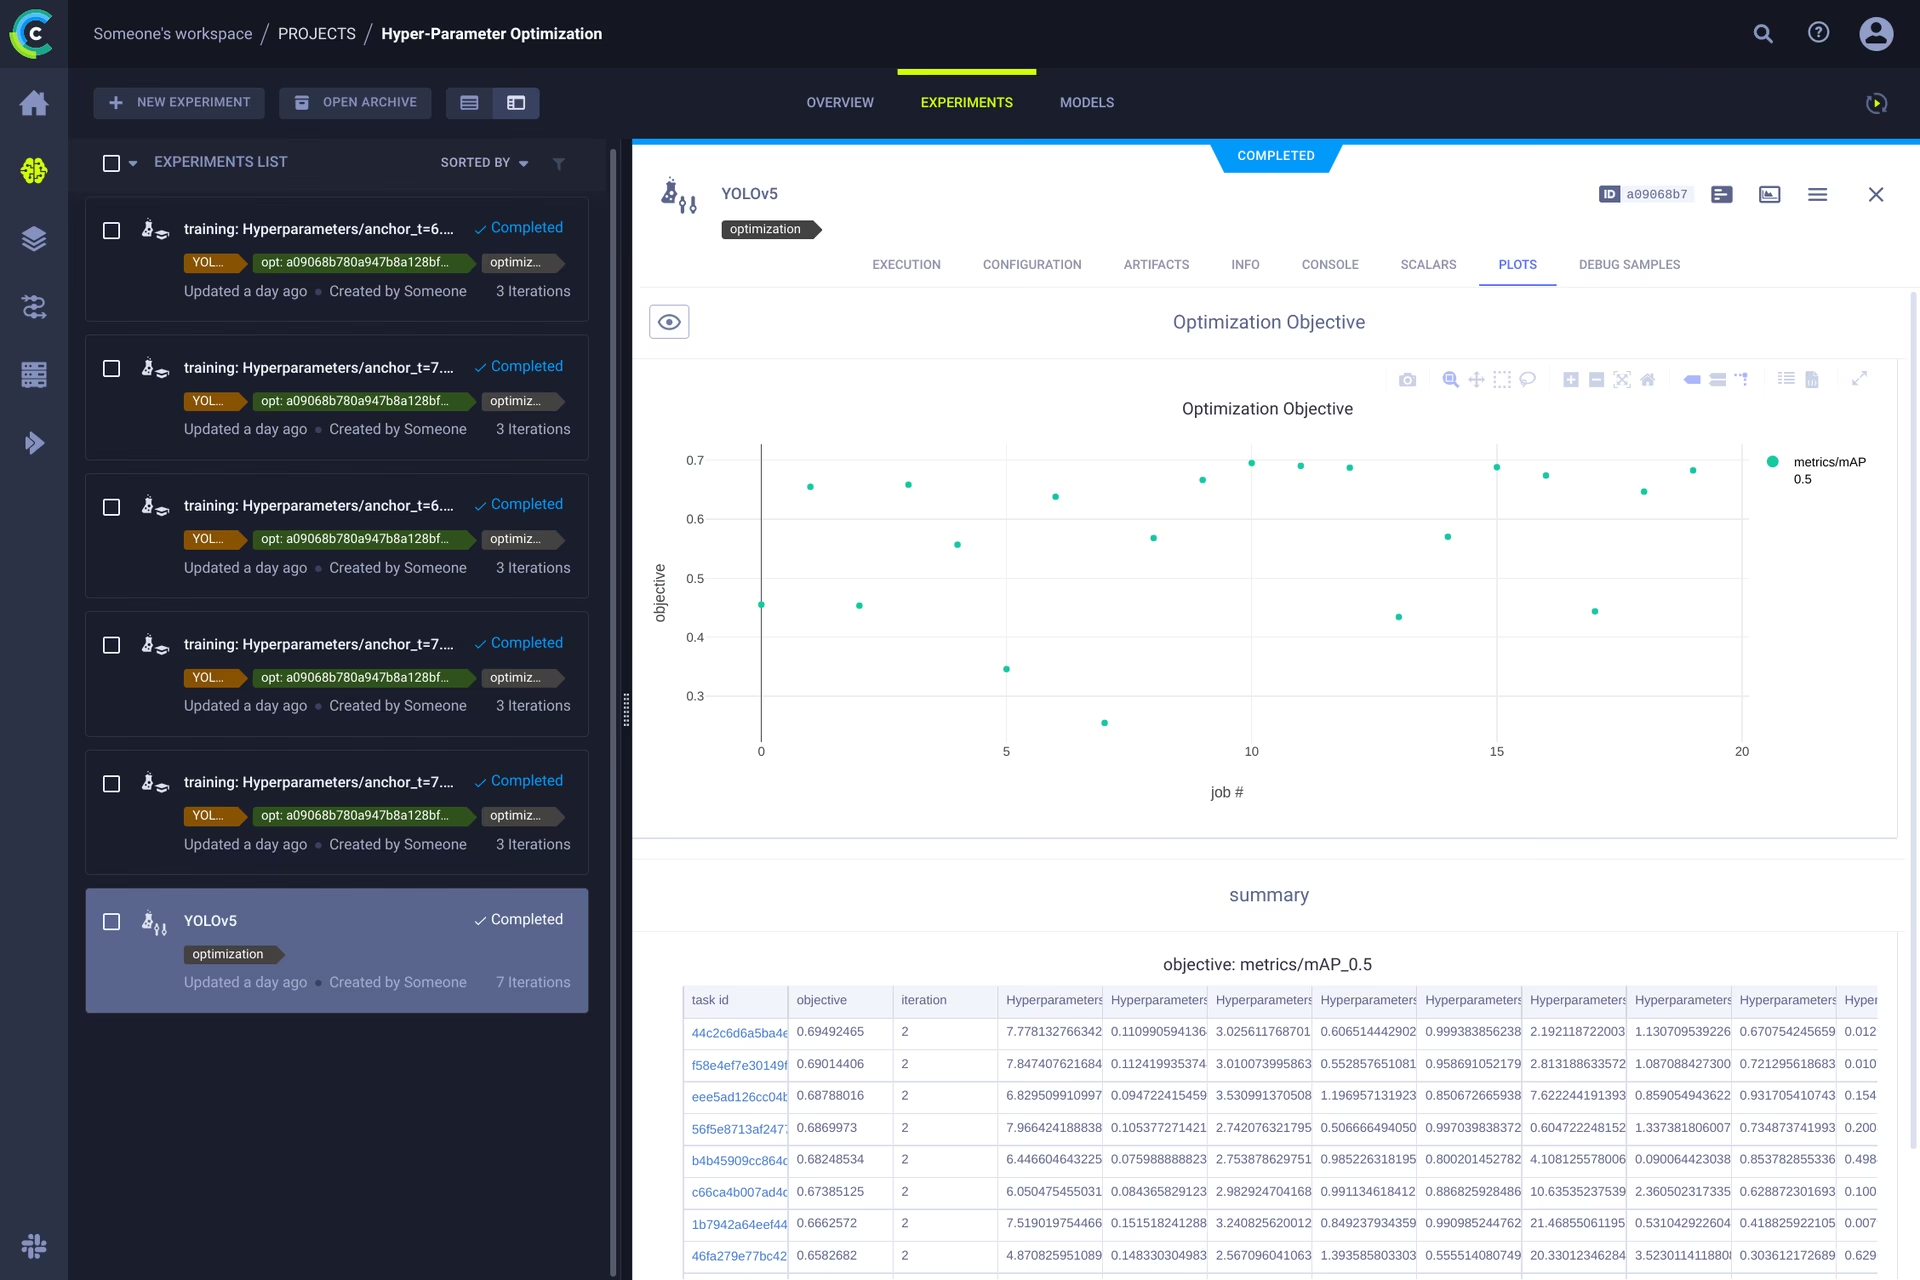
Con los experimentos y los datos versionados, puedes aprovecharlos para crear nuevos procesos. Como cada experimento registrado captura el entorno completo —código, paquetes instalados y configuración—, las ejecuciones son totalmente reproducibles. ClearML te permite clonar un experimento, cambiar sus parámetros y volver a ejecutarlo automáticamente, lo que constituye la base de la optimización de hiperparámetros (HPO).
Para ejecutar HPO localmente, usa el script incluido. Primero, asegúrate de que haya una tarea de entrenamiento en el gestor de experimentos: el script la clonará y variará sus hiperparámetros.
Rellena el ID de la tarea de plantilla en utils/loggers/clearml/hpo.py y, después, ejecuta:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
Para ejecutar las pruebas en agentes remotos, sustituye optimizer.start_locally() por optimizer.start() y configura execution_queue en la llamada HyperParameterOptimizer con la cola a la que se conectan tus agentes.
🤯 Ejecución remota (avanzado)#
Ejecutar HPO localmente es práctico, pero a menudo querrás ejecutar experimentos en hardware más potente, como una máquina con GPU local o una instancia en la nube. Para eso sirve ClearML Agent:
Cada experimento registrado contiene todo lo necesario para reproducirlo en otra máquina (paquetes instalados, cambios sin confirmar y configuración). Un agente de ClearML escucha una cola, recoge las tareas entrantes, recrea el entorno, ejecuta el trabajo y transmite los valores escalares y los gráficos al gestor de experimentos.
Convierte cualquier máquina —una máquina virtual en la nube, un equipo local con GPU o un portátil— en un agente de ClearML con:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]Clonar, editar y poner en cola#
Con un agente en ejecución, puedes asignarle trabajo directamente desde la interfaz:
- 🪄 Haz clic con el botón derecho en un experimento y clónalo.
- 🎯 Edita sus hiperparámetros.
- ⏳ Haz clic con el botón derecho en la tarea clonada y añádela a la cola de destino.
Ejecutar una tarea de forma remota#
También puedes marcar mediante programación un script en ejecución para que se ejecute de forma remota añadiendo task.execute_remotely() después de inicializar el registrador de ClearML. Añade la línea resaltada a train.py:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ AÑADE ESTA LÍNEA
    # ...
    # Procesar el enlace del artefacto del conjunto de datos personalizado
    data_dict = loggers.remote_dataset
# ...
Tras este cambio, al ejecutar el script de entrenamiento, se ejecutará hasta esa línea, empaquetará el código y lo enviará a la cola.
Escalado automático de trabajadores#
ClearML incluye escaladores automáticos que ponen en marcha máquinas remotas en AWS, GCP o Azure cuando una cola tiene experimentos pendientes, las convierten en agentes de ClearML y las apagan cuando terminan el trabajo; así solo pagas por la capacidad de cálculo que está realmente en uso.
Mira el vídeo de introducción a continuación:
Más información#
Para obtener más información sobre la integración de ClearML con los modelos de Ultralytics, consulta nuestra guía de integración de ClearML y descubre cómo puedes mejorar tu flujo de trabajo de MLOps con otras herramientas de seguimiento de experimentos.
Preguntas frecuentes#
No. El servicio alojado gratuito en app.clear.ml funciona de inmediato después de
clearml-init. El autoalojamiento es opcional y suele elegirse cuando los datos no pueden salir de tu red.YOLOv5 activa la integración siempre que el paquete
clearmlse pueda importar, así que desinstálalo conpip uninstall clearmlpara desactivar el seguimiento durante una ejecución.Registra el conjunto de datos con
clearml-data syncy, después, pasa su ID como argumento de datos:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. El ID queda registrado en la tarea para que cada experimento sepa exactamente qué datos ha utilizado.Sí. Inicia un
clearml-agent daemonen cada máquina y, después, añade a la cola experimentos clonados desde la interfaz o modificautils/loggers/clearml/hpo.pypara que llame aoptimizer.start()conexecution_queueconfigurado, de modo que el optimizador envíe las pruebas a la cola.