Validation croisée k-fold avec Ultralytics
Introduction#
Ce guide explique comment mettre en œuvre la validation croisée K-fold pour des jeux de données de détection d’objets dans l’écosystème Ultralytics. Il s’appuie sur le format de détection YOLO et des bibliothèques Python comme scikit-learn, pandas et PyYAML pour présenter la configuration, la génération de vecteurs de caractéristiques et la répartition du jeu de données en K-folds.
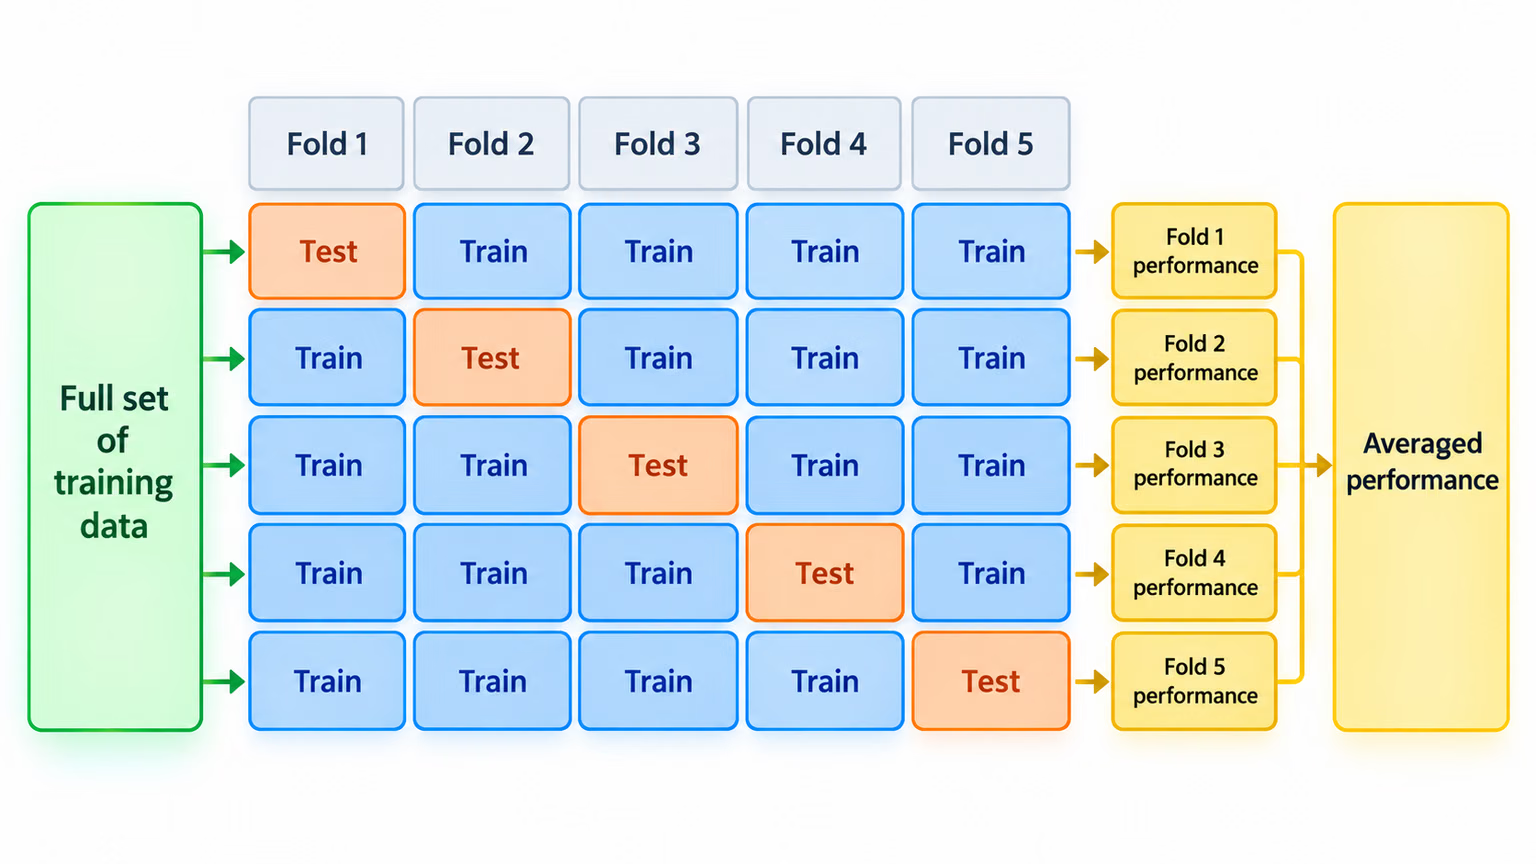
Que ton projet utilise le jeu de données Fruit Detection ou une source de données personnalisée, ce tutoriel t’aide à comprendre et à appliquer la validation croisée K-fold afin d’améliorer la fiabilité et la robustesse de tes modèles d’apprentissage automatique. Pour ce tutoriel, nous utilisons k=5 folds, mais n’oublie pas que le nombre optimal de folds peut varier selon ton jeu de données et les spécificités de ton projet. La validation croisée K-fold est particulièrement utile lorsque ton jeu de données est petit, bruité ou très variable ; pour les grands jeux de données diversifiés, une répartition bien conçue entre entraînement, validation et test suffit généralement.
Configuration#
-
Tes annotations doivent être au format de détection YOLO.
-
Ce guide suppose que les fichiers d'annotation sont disponibles localement.
-
Pour notre démonstration, nous utilisons le jeu de données Fruit Detection.
- Ce jeu de données contient au total 8479 images.
- Il comprend 6 étiquettes de classe, dont le nombre total d'instances est indiqué ci-dessous.
| Étiquette de classe | Nombre d'instances |
|---|---|
| Pomme | 7049 |
| Raisins | 7202 |
| Ananas | 1613 |
| Orange | 15549 |
| Banane | 3536 |
| Pastèque | 1976 |
-
Les packages Python nécessaires comprennent :
ultralyticssklearnpandaspyyaml
-
Ce tutoriel utilise
k=5plis. Tu dois toutefois déterminer le nombre de plis le mieux adapté à ton jeu de données.
-
Crée un nouvel environnement virtuel Python (
venv) pour ton projet et active-le. Utilisepip(ou le gestionnaire de paquets de ton choix) pour installer :- La bibliothèque Ultralytics :
pip install -U ultralytics. Tu peux aussi cloner le dépôt officiel. - Scikit-learn, pandas et PyYAML :
pip install -U scikit-learn pandas pyyaml.
- La bibliothèque Ultralytics :
-
Vérifie que tes annotations sont au format de détection YOLO.
- Pour ce tutoriel, tous les fichiers d'annotation se trouvent dans le répertoire
Fruit-Detection/labels.
- Pour ce tutoriel, tous les fichiers d'annotation se trouvent dans le répertoire
Génération de vecteurs de caractéristiques pour un jeu de données de détection d'objets#
-
Commence par créer un nouveau fichier Python
example.pypour suivre les étapes ci-dessous. -
Charge les images d’entraînement et de validation répertoriées dans le fichier YAML de ton jeu de données à l’aide de la classe Ultralytics
YOLODataset, sans toucher à l’ensemble de test.from pathlib import Path from ultralytics.data.dataset import YOLODataset from ultralytics.data.utils import check_det_dataset yaml_file = "path/to/data.yaml" data = check_det_dataset(yaml_file) dataset_path = Path(data["path"]) sources = [] for split in ("train", "val"): source = data.get(split) if source: sources.extend(source if isinstance(source, list) else [source]) dataset = YOLODataset(sources, data=data, augment=False) images = [Path(p) for p in dataset.im_files] -
Lis ensuite le contenu du fichier YAML du jeu de données et extrais les indices des étiquettes de classe.
classes = data["names"] cls_idx = sorted(classes.keys()) -
Initialise un DataFrame
pandasvide.import pandas as pd labels_df = pd.DataFrame(0.0, columns=cls_idx, index=images) -
Compte le nombre d’instances de chaque étiquette de classe présente dans les fichiers d’annotation.
from collections import Counter for image, label in zip(images, dataset.labels): lbl_counter = Counter(label["cls"].flatten().astype(int)) labels_df.loc[image, list(lbl_counter)] = list(lbl_counter.values()) -
Voici un exemple du DataFrame renseigné :
                                                       0    1    2    3    4    5
'0000a16e4b057580_jpg.rf.00ab48988370f64f5ca8ea4...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.7e6dce029fb67f01eb19aa7...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.bc4d31cdcbe229dd022957a...'  0.0  0.0  0.0  0.0  0.0  7.0
'00020ebf74c4881c_jpg.rf.508192a0a97aa6c4a3b6882...'  0.0  0.0  0.0  1.0  0.0  0.0
'00020ebf74c4881c_jpg.rf.5af192a2254c8ecc4188a25...'  0.0  0.0  0.0  1.0  0.0  0.0
 ...                                                  ...  ...  ...  ...  ...  ...
'ff4cd45896de38be_jpg.rf.c4b5e967ca10c7ced3b9e97...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff4cd45896de38be_jpg.rf.ea4c1d37d2884b3e3cbce08...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff5fd9c3c624b7dc_jpg.rf.bb519feaa36fc4bf630a033...'  1.0  0.0  0.0  0.0  0.0  0.0
'ff5fd9c3c624b7dc_jpg.rf.f0751c9c3aa4519ea3c9d6a...'  1.0  0.0  0.0  0.0  0.0  0.0
'fffe28b31f2a70d4_jpg.rf.7ea16bd637ba0711c53b540...'  0.0  6.0  0.0  0.0  0.0  0.0
Les lignes utilisent des chemins absolus vers les images, et les colonnes correspondent aux indices des étiquettes de classe. Les étiquettes manquantes restent représentées par des lignes entièrement composées de zéros, correspondant à l’arrière-plan. Cette structure de données permet d’appliquer la validation croisée K-fold à un jeu de données de détection d’objets.
Partitionnement du jeu de données en k-folds#
-
Nous allons maintenant utiliser la classe
KFolddesklearn.model_selectionpour générerkpartitions du jeu de données.- Important :
- Définir
shuffle=Truegarantit une répartition aléatoire des classes dans tes partitions. - En définissant
random_state=MavecMégal à un entier choisi, tu peux obtenir des résultats reproductibles.
- Définir
from sklearn.model_selection import KFold ksplit = 5 kf = KFold(n_splits=ksplit, shuffle=True, random_state=20) # définir random_state pour obtenir des résultats reproductibles kfolds = list(kf.split(labels_df)) - Important :
-
Le jeu de données est maintenant divisé en
kplis, chacun contenant une liste d'indicestrainetval. Nous allons créer un DataFrame pour présenter ces résultats plus clairement.folds = [f"split_{n}" for n in range(1, ksplit + 1)] folds_df = pd.DataFrame(index=labels_df.index, columns=folds) for i, (train, val) in enumerate(kfolds, start=1): folds_df.loc[labels_df.index[train], f"split_{i}"] = "train" folds_df.loc[labels_df.index[val], f"split_{i}"] = "val" -
Nous allons maintenant calculer la répartition des étiquettes de classe pour chaque pli, sous forme de ratio entre les classes présentes dans
valet celles présentes danstrain.fold_lbl_distrb = pd.DataFrame(index=folds, columns=cls_idx) for n, (train_indices, val_indices) in enumerate(kfolds, start=1): train_totals = labels_df.iloc[train_indices].sum() val_totals = labels_df.iloc[val_indices].sum() # To avoid division by zero, we add a small value (1E-7) to the denominator ratio = val_totals / (train_totals + 1e-7) fold_lbl_distrb.loc[f"split_{n}"] = ratioL'idéal est que les ratios de classes soient assez similaires dans chaque partition et d'une classe à l'autre. Cela dépend toutefois des spécificités de ton jeu de données.
-
Écris les listes d'images et un fichier YAML de jeu de données pour chaque partition. Les listes de fichiers texte évitent de copier le jeu de données
kfois.import yaml save_path = dataset_path.parent / f"{ksplit}-Fold_Cross-val" save_path.mkdir(parents=True, exist_ok=True) ds_yamls = [] for split in folds_df.columns: for partition in ("train", "val"): split_images = folds_df.index[folds_df[split] == partition] paths = "\n".join(map(str, split_images)) (save_path / f"{split}_{partition}.txt").write_text(f"{paths}\n") dataset_yaml = save_path / f"{split}.yaml" ds_yamls.append(dataset_yaml) with open(dataset_yaml, "w") as ds_y: yaml.safe_dump( { "path": save_path.as_posix(), "train": f"{split}_train.txt", "val": f"{split}_val.txt", "names": classes, }, ds_y, )
Enregistrer les résultats (facultatif)#
Tu peux éventuellement enregistrer les DataFrames de partitionnement k-fold et de répartition des étiquettes dans des fichiers CSV pour t'y référer ultérieurement.
folds_df.to_csv(save_path / "kfold_datasplit.csv")
fold_lbl_distrb.to_csv(save_path / "kfold_label_distribution.csv")
Entraîner YOLO avec les partitions de données k-fold#
-
Commence par charger le modèle YOLO.
from ultralytics import YOLO weights_path = "path/to/weights.pt" # utiliser yolo26n.pt pour un petit modèle model = YOLO(weights_path, task="detect") -
Parcours ensuite les fichiers YAML du jeu de données pour lancer l’entraînement. Les résultats seront enregistrés dans un répertoire défini par les arguments
projectetname. Par défaut, ce répertoire estruns/detect/train#, où#est un indice entier.results = {} # Define your additional arguments here batch = 16 project = "kfold_demo" epochs = 100 for k, dataset_yaml in enumerate(ds_yamls): model = YOLO(weights_path, task="detect") results[k] = model.train( data=dataset_yaml, epochs=epochs, batch=batch, project=project, name=f"fold_{k + 1}" ) # include any additional train arguments -
Tu peux également utiliser la fonction autosplit d’Ultralytics pour répartir automatiquement le jeu de données :
from ultralytics.data.split import autosplit

# Diviser automatiquement le jeu de données en ensembles train/val/test
autosplit(path="path/to/images", weights=(0.8, 0.2, 0.0), annotated_only=True)
Conclusion#
Dans ce guide, nous avons exploré l'utilisation de la validation croisée k-fold pour entraîner le modèle YOLO de détection d'objets. Nous avons appris à diviser l'ensemble d'entraînement et de validation en K partitions et à utiliser le tableau de ratios généré pour examiner l'équilibre des classes après une répartition aléatoire.
Nous avons également étudié la procédure de création de DataFrames de rapport afin de visualiser la répartition des données et des étiquettes dans les différents ensembles, offrant ainsi une vue claire de la structure des ensembles d’entraînement et de validation.
Nous avons aussi enregistré nos résultats pour pouvoir les consulter ultérieurement, ce qui peut s'avérer particulièrement utile dans les projets à grande échelle ou lors du diagnostic des performances du modèle.
Enfin, nous avons mis en œuvre l'entraînement proprement dit en entraînant le modèle sur chaque partition dans une boucle, puis en enregistrant les résultats pour les analyser et les comparer.
La validation croisée k-fold est une méthode robuste pour tirer le meilleur parti des données disponibles et contribue à garantir que les performances de ton modèle sont fiables et cohérentes sur différents sous-ensembles de données. Elle permet d'obtenir un modèle plus généralisable et plus fiable, moins susceptible de surapprendre les motifs propres à certaines données.
Même si nous avons utilisé YOLO dans ce guide, n'oublie pas que ces étapes sont largement transposables à d'autres modèles de machine learning. En les comprenant, tu pourras appliquer efficacement la validation croisée à tes propres projets de machine learning.
FAQ#
La validation croisée k-fold est une technique qui consiste à diviser le jeu de données en « k » sous-ensembles (plis) afin d'évaluer les performances du modèle de façon plus fiable. Chaque pli sert à la fois de données de validation et de données d'entraînement. Pour la détection d'objets, la validation croisée k-fold contribue à garantir que les performances de ton modèle Ultralytics YOLO sont robustes et généralisables d'une partition de données à l'autre, ce qui améliore sa fiabilité. Pour des instructions détaillées sur la configuration de la validation croisée k-fold avec Ultralytics YOLO, consulte Validation croisée k-fold avec Ultralytics.
Pour mettre en œuvre la validation croisée k-fold avec Ultralytics YOLO, suis ces étapes :
- Vérifie que les annotations sont au format de détection YOLO.
- Utilise des bibliothèques Python comme
sklearn,pandasetpyyaml. - Crée des vecteurs de caractéristiques à partir de ton jeu de données.
- Divise ton jeu de données avec
KFolddesklearn.model_selection. - Entraîne le modèle YOLO sur chaque partition.
Pour un guide complet, consulte la section Partitionnement du jeu de données en k-folds de notre documentation.
Le workflow de ce guide cible le format de détection YOLO, mais la même approche s'adapte à toutes les tâches YOLO : la tâche détermine la façon de composer les plis, pas l'utilité de la validation croisée :
Tâche Conception des plis detectRépartis les données au niveau de l'image, en équilibrant la distribution des objets et des classes entre les plis. Regroupe les images associées (même patient, séquence vidéo, caméra ou site) dans un seul pli. segmentUtilise la même stratégie au niveau de l'image que pour la détection, en veillant également à ce que les masques et les classes soient représentés dans chaque pli. classifyPrivilégie les plis stratifiés afin d'équilibrer la fréquence des classes entre l'entraînement et la validation. poseEffectue la répartition par sujet ou par séquence, afin qu'une même personne ou un même animal n'apparaisse jamais des deux côtés d'un pli. obbRépartis les données au niveau de l'image et conserve ensemble les tuiles ou les recadrages issus d'une même scène — un point particulièrement important pour les images aériennes. Quelle que soit la tâche, évite de répartir des échantillons presque identiques ou apparentés dans des folds opposés : ce type de fuite de données gonfle les métriques de validation bien au-delà des performances que le modèle atteindra en production.
Ultralytics YOLO offre une détection d’objets de pointe en temps réel, avec une grande précision et une excellente efficacité. Polyvalent, il prend en charge plusieurs tâches de vision par ordinateur, comme la détection, la segmentation d’instances, la segmentation sémantique et la classification. Il s’intègre également à des outils comme Ultralytics Platform pour entraîner et déployer des modèles sans code.
Tes annotations doivent respecter le format de détection YOLO. Chaque fichier d'annotation doit indiquer la classe de l'objet ainsi que les coordonnées de sa boîte englobante dans l'image. Le format YOLO garantit un traitement des données rationalisé et standardisé pour l'entraînement des modèles de détection d'objets. Pour en savoir plus sur le formatage correct des annotations, consulte le guide du format de détection YOLO.
Oui, tu peux utiliser la validation croisée k-fold avec n'importe quel jeu de données personnalisé, à condition que les annotations soient au format de détection YOLO. Remplace les chemins d'accès au jeu de données et les étiquettes de classe par ceux qui correspondent à ton jeu de données personnalisé. Cette flexibilité permet à tout projet de détection d'objets de bénéficier d'une évaluation robuste du modèle par validation croisée k-fold. Pour un exemple pratique, consulte notre section Génération de vecteurs de caractéristiques.


Commentaires21
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
jingieboy
does this work with yolov8-cls? if so how would the folder structure look like? how are the data splits
 Glenn JocherUltralytics(modifié)
Yes—K‑Fold works the same for classification; use the standard ImageNet-style layout per fold, and train each fold separately (YOLO infers classes from folder names). For YOLO26 (recommended) you can do:
dataset/
  split_1/
    train/
      class_a/ ...
      class_b/ ...
    val/
      class_a/ ...
      class_b/ ...
  split_2/
    train/...
    val/...
  ...
from ultralytics import YOLO weights = "yolo26n-cls.pt" # swap to 'yolov8n-cls.pt' if you prefer YOLOv8 splits = ["dataset/split_1", "dataset/split_2", "dataset/split_3"] for d in splits: model = YOLO(weights) model.train(data=d, epochs=20, batch=16) # d must contain 'train/' and 'val/' subfoldersFor building folds, use
StratifiedKFoldon image-level labels derived from parent folder names to keep class balance, or use the random splitter shown in the autosplit reference if stratification isn’t required. Classification usage details are in the classification task docs.thank you for this! I have also notice that everytime I run model.val(), the accuracies and confusion matrix values are slightly different this time. Is this normal or during evaluation, there is a small randomness when calling the function.
- Glenn JocherUltralytics
@jingieboy minor variations can occur from non-deterministic CUDA ops or multi-threading; validation itself doesn’t add randomness by default—set seeds and force deterministic ops to lock results:
import random, numpy as np, torch

seed = 0
random.seed(seed); np.random.seed(seed); torch.manual_seed(seed)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False

model.val()  # run evaluation
If differences are still large, double-check your eval args in the validation mode docs.
Nehasq
Hi, I am applying K-fold validation using the leave-one-out technique. My dataset consists of a single class and includes 21 images in total. For each split, I use 20 images for training and 1 image for testing. I am implementing the leave-one-out technique with the code above, setting ksplit=21.
I am not using a separate validation dataset, only training and testing data. Here is the code I am using:
results = {}
Define additional arguments here
batch = 16 project = "kfold_demo" epochs = 100
for k in range(ksplit): dataset_yaml = ds_yamls[k] model = YOLO(weights_path, task="detect") model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project) # Include any train arguments results[k] = model.metrics # Save output metrics for further analysis
In my data.yaml file, I have provided the validation path as the test set. When it trains and validates on the "1 test data," does this mean the model is being tested on data it has never seen during training? This is my first point of confusion.
my data.yaml file for each split looks like this: names:
- pothole path: ../ 2024-12-10_21-Fold_Cross-val/split_1 train: train val: test
My second question is about calculating the final performance. When I ran the above code, it calculated scores for each individual split. Do I need to calculate the final performance metrics manually, or is there any functionality in YOLOv8 to compute the aggregated performance automatically?
- Glenn JocherUltralytics
@Nehasq to address your first question, yes, the model is being tested on unseen data during each split, as the test set (1 image) is excluded from training and only used for validation. Regarding your second question, YOLO does not automatically aggregate metrics across splits. You need to compute the final performance metrics manually by averaging the results from all splits. For reference, you can review the K-Fold Cross Validation guide.
Thanks for your reply. I understand your point. So, are you saying that, for example, in my case, where I have 21 scores (precision, recall, etc.), I should simply add all the precision values together and divide the sum by 21 to get the final precision of the model? Is that correct?
Also, in y case of 20 images( training) and 1 images for test, what batch size would you suggest?
- Glenn JocherUltralytics
Yes, to calculate the final precision (or any metric), you average the values across all splits, i.e., sum all precision scores and divide by the number of splits (21 in your case). As for the batch size, given your small dataset, you could keep it low (e.g., 1 or 2) to ensure efficient utilization of the data while avoiding overfitting.
Thanks, that really helps! With a batch size of 1, I am keeping the epochs at 10. Should it be fewer? Also, to check for overfitting, I need to review the result graphs for each split. However, I can't definitively determine if it is overfitting since each split is separate, right?
- Glenn JocherUltralytics
Keeping epochs at 10 with a batch size of 1 is reasonable given your small dataset size. To check for overfitting, reviewing result graphs from each split can help, but overfitting may be harder to detect since each split involves different training and test data. Consider comparing trends across splits for consistent insights. For further details, you can reference the K-Fold Cross Validation guide.
semyon-v-dot
After the loop:
for ext in supported_extensions:
    images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))
Should be this line of code:
images = sorted(images)For
imagesmatching withlabelslist:labels = sorted(dataset_path.rglob("*labels/*.txt"))Otherwise the script creates background images because some images missing their labels.
- Glenn JocherUltralytics
@semyon-v-dot thank you for your suggestion. Sorting the
imageslist after extending it with supported extensions is a good practice to ensure alignment with thelabelslist. This helps prevent issues with missing labels.1
 sangeun jo
K-폴드 데이터 세트 분할 4번에서
images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))이 코드를images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))로 변환해야 작동했습니다.- Glenn JocherUltralytics
@sangeun-jo thank you for pointing that out. Your modification to
images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))is indeed correct and ensures the code works as intended. If you have any further questions or need additional assistance, feel free to ask!
kh-diab
is it usefult to use this k fold approach when I just have one class only but my issue is the class is detected as background or vice versa as per the attached Confusion matrix
- Glenn JocherUltralytics
@kh-diab using K-Fold Cross Validation can still be beneficial even with a single class. It helps ensure that your model's performance is robust and not overly dependent on a particular subset of the data. This can be particularly useful if you're experiencing issues with class detection accuracy, as it allows you to validate the model's performance across multiple splits and identify any inconsistencies. If your class is being detected as background or vice versa, K-Fold Cross Validation can help diagnose whether this issue is consistent across different data splits or specific to certain subsets. For more details, you can refer to our guide on K-Fold Cross Validation: https://docs.ultralytics.com/guides/kfold-cross-validation/.
alexander-sony
Good guide, consider adding it in a colab notebook.
In section "Train YOLO using K-Fold Data Splits", model should be re-initialized foe every k, i.e. it should be inside the for-loop: for k in range(ksplit).
- Glenn JocherUltralytics
@alexander-sony thank you for your feedback and suggestion! 😊
You're absolutely right about re-initializing the model within the loop for each fold to ensure a fresh start for every training iteration. This can help avoid any potential carryover effects from previous folds. Here's the corrected code snippet for the training section:
from ultralytics import YOLO

weights_path = "path/to/weights.pt"
results = {}

# Define your additional arguments here
batch = 16
project = "kfold_demo"
epochs = 100

for k in range(ksplit):
    model = YOLO(weights_path, task="detect")  # Re-initialize the model inside the loop
    dataset_yaml = ds_yamls[k]
    model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project)  # include any train arguments
    results[k] = model.metrics  # save output metrics for further analysis
Regarding your suggestion to add this guide to a Colab notebook, that's a fantastic idea! It would make the process more interactive and accessible for users. We'll consider creating a Colab version of this guide in the future.
For more details on K-Fold Cross Validation, you can refer to our comprehensive guide.
Thanks again for your valuable input! If you have any more suggestions or questions, feel free to share. Happy coding! 🚀
Likhith-Sugganahalli
@alexander-sony
woudnt that be a new model trained on each split, giving us n different models trained on 1/nth of the dataset?
 Fazri Gading
Is there any way to implement Stratified K-Fold Cross Validation with YOLOv8?
 Paula DerrengerUltralytics
Yes, you can implement Stratified K-Fold Cross Validation with YOLOv8! Stratified K-Fold ensures that each fold has a similar distribution of class labels, which can be particularly useful for imbalanced datasets.
To achieve this, you can use
StratifiedKFoldfromsklearn.model_selectioninstead ofKFold. Here's a brief example of how to modify the K-Fold implementation:from sklearn.model_selection import StratifiedKFold # Assuming labels_df is your DataFrame with class counts ksplit = 5 skf = StratifiedKFold(n_splits=ksplit, shuffle=True, random_state=20) # Generate stratified splits kfolds = list(skf.split(labels_df, labels_df.idxmax(axis=1))) # The rest of the process remains the sameFor a detailed guide on K-Fold Cross Validation, please refer to the Ultralytics documentation. If you have any more questions, feel free to ask! 😊
1