YOLO12 : détection d’objets axée sur l’attention
Présentation#
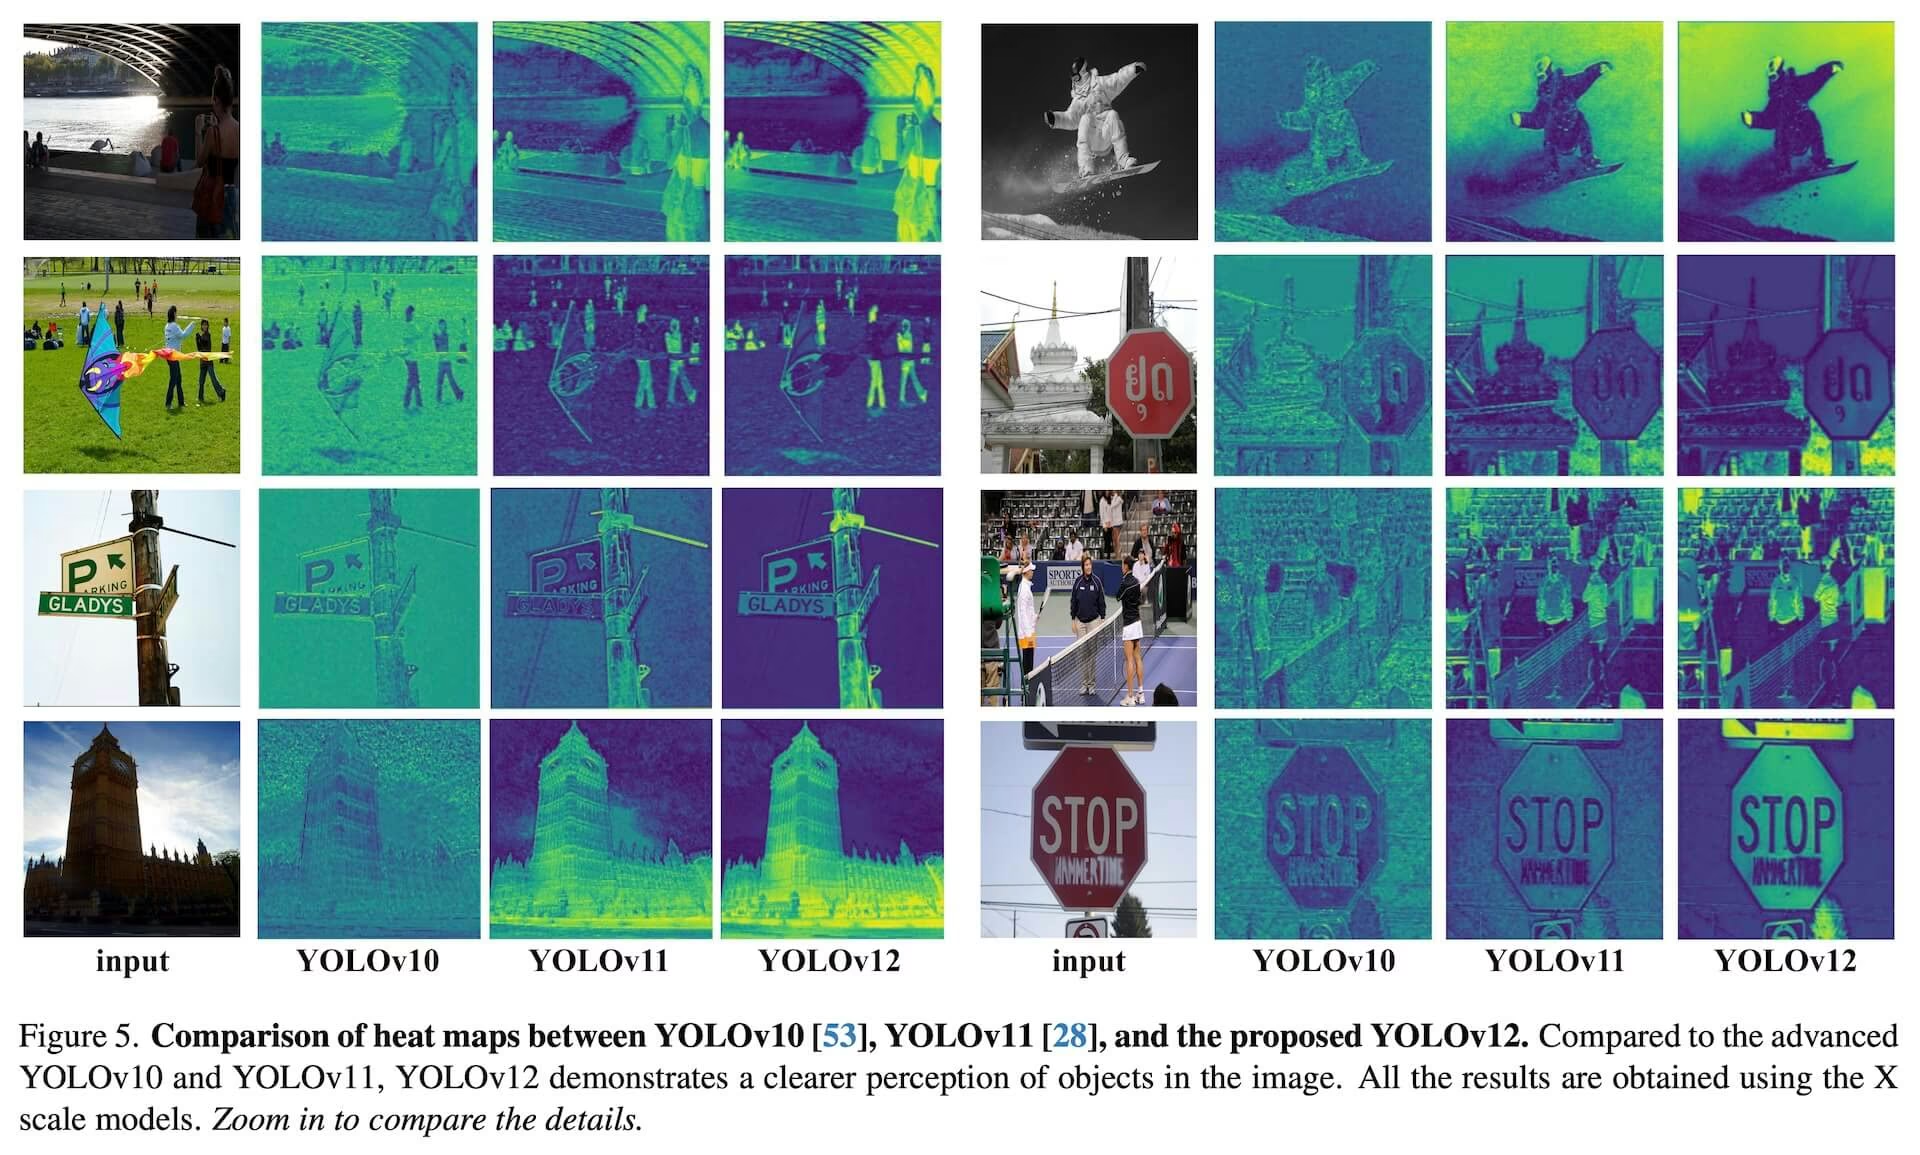
Sorti au début de 2025, YOLO12 introduit une architecture axée sur l'attention, qui s'écarte des approches traditionnelles fondées sur les CNN utilisées dans les modèles YOLO précédents, tout en conservant la vitesse d'inférence en temps réel essentielle à de nombreuses applications. Il atteint une grande précision de détection d'objets grâce à des modifications de ses mécanismes d'attention et de l'architecture globale du réseau. Malgré ces avantages, YOLO12 reste une version pilotée par la communauté, qui peut présenter une instabilité à l'entraînement, une consommation mémoire élevée et un débit CPU plus faible en raison de ses blocs d'attention gourmands ; Ultralytics recommande donc YOLO11 ou YOLO26 pour la plupart des charges de travail en production.
YOLO12 est principalement maintenu pour l'analyse comparative et la recherche. Si tu as besoin d'un entraînement stable, d'une utilisation prévisible de la mémoire et d'une inférence CPU optimisée, choisis YOLO11 ou YOLO26 pour le déploiement.
À regarder : Comment utiliser YOLO12 pour la détection d'objets avec le package Ultralytics | YOLO12 est-il rapide ou lent ?
Fonctionnalités clés#
- Mécanisme d'attention par zone : une nouvelle approche d'auto-attention qui traite efficacement de grands champs réceptifs. Elle divise les cartes de caractéristiques en l régions de taille égale (4 par défaut), horizontalement ou verticalement, évitant les opérations complexes tout en conservant un grand champ réceptif effectif. Cela réduit considérablement le coût de calcul par rapport à l'auto-attention standard.
- Réseaux résiduels efficaces d’agrégation de couches (R-ELAN) : un module d’agrégation de caractéristiques amélioré, basé sur ELAN et conçu pour relever les défis d’optimisation, en particulier dans les modèles à grande échelle axés sur l’attention. R-ELAN introduit :
- Des connexions résiduelles au niveau des blocs avec mise à l’échelle (semblable à la mise à l’échelle des couches).
- Une méthode d’agrégation de caractéristiques repensée, qui crée une structure de type goulot d’étranglement.
- Architecture d’attention optimisée : YOLO12 rationalise le mécanisme d’attention standard afin d’améliorer son efficacité et sa compatibilité avec le framework YOLO. Cela comprend :
- Utilisation de FlashAttention pour réduire au minimum la surcharge liée aux accès mémoire.
- La suppression de l’encodage positionnel pour obtenir un modèle plus simple et plus rapide.
- L’ajustement du ratio MLP (de la valeur habituelle de 4 à 1,2 ou 2) pour mieux équilibrer les calculs entre les couches d’attention et les couches à propagation avant.
- La réduction de la profondeur des blocs empilés pour améliorer l’optimisation.
- Utilisation d'opérations de convolution (lorsqu'elles sont appropriées) pour leur efficacité de calcul.
- L’ajout d’une convolution séparable 7x7 (« percepteur de position ») au mécanisme d’attention afin d’encoder implicitement les informations de position.
- Prise en charge complète des tâches : YOLO12 prend en charge plusieurs tâches essentielles de vision par ordinateur : la détection d’objets, la segmentation d’instances, la classification d’images, l’estimation de pose et la détection d’objets orientés (OBB).
- Efficacité accrue : atteint une précision supérieure avec moins de paramètres que de nombreux modèles antérieurs, offrant ainsi un meilleur équilibre entre vitesse et précision.
- Déploiement flexible : conçu pour être déployé sur diverses plateformes, des appareils en périphérie au cloud.
Tâches et modes pris en charge#
YOLO12 prend en charge diverses tâches de vision par ordinateur. Le tableau ci-dessous présente les tâches prises en charge et les modes opérationnels (entraînement, validation, inférence et export) disponibles pour chacune :
Seuls les poids de détection (yolo12n.pt, yolo12s.pt, yolo12m.pt, yolo12l.pt, yolo12x.pt) sont publiés sur ultralytics/assets. Les architectures de segmentation, de classification, de pose et OBB sont définies dans ultralytics/cfg/models/12/ ; ces variantes prennent donc en charge l’entraînement à partir de zéro avec la configuration .yaml, mais aucun fichier .pt préentraîné n’est actuellement disponible pour elles. Pour obtenir des points de contrôle préentraînés pour la segmentation, la pose, la classification ou OBB, Ultralytics recommande YOLO11 ou YOLO26.
| Type de modèle | Tâche | Poids préentraînés | Entraînement | Validation | Inférence | Export |
|---|---|---|---|---|---|---|
| YOLO12 | Détection | ✅ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-seg | Segmentation | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-cls | Classification | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-pose | Pose | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-obb | OBB | ❌ | ✅ | ✅ | ✅ | ✅ |
Toutes les architectures YOLO12 prennent en charge chaque mode dès qu’un point de contrôle entraîné est disponible. La colonne Pretrained Weights indique uniquement si Ultralytics publie un .pt préentraîné officiel sur ultralytics/assets : pour la segmentation, la pose, la classification et OBB, tu dois entraîner ton propre point de contrôle à partir du fichier .yaml correspondant avant de lancer l’inférence, la validation ou l’exportation.
Indicateurs de performance#
YOLO12 améliore la précision à toutes les échelles de modèle, avec quelques compromis de vitesse par rapport aux modèles YOLO précédents les plus rapides. Voici les résultats quantitatifs pour la détection d'objets sur le jeu de données de validation COCO :
Performances de détection (COCO val2017)#
| Modèle | taille (pixels) | mAPval50-95 | Vitesse CPU ONNX (ms) | Vitesse T4 TensorRT (ms) | paramètres (M) | FLOPs (B) | Comparaison (mAP/vitesse) |
|---|---|---|---|---|---|---|---|
| YOLO12n | 640 | 40.6 | - | 1.64 | 2.6 | 7.5 | +2.1 %/-9 % (vs. YOLOv10n) |
| YOLO12s | 640 | 48.0 | - | 2.61 | 9.3 | 23.3 | +0.1 %/+42 % (vs. RT-DETRv2) |
| YOLO12m | 640 | 52.5 | - | 4.86 | 20.2 | 70.7 | +1.0 %/-3 % (vs. YOLO11m) |
| YOLO12l | 640 | 53.7 | - | 6.77 | 26.4 | 95.4 | +0.4 %/-8 % (vs. YOLO11l) |
| YOLO12x | 640 | 55.2 | - | 11.79 | 59.1 | 208.9 | +0.6 %/-4 % (vs. YOLO11x) |
- Vitesse d'inférence mesurée sur un GPU NVIDIA T4 avec la précision FP16 de TensorRT.
- Les comparaisons indiquent l’amélioration relative de mAP et la variation en pourcentage de la vitesse (une valeur positive indique une accélération ; une valeur négative, un ralentissement). Elles sont effectuées par rapport aux résultats publiés pour YOLOv10, YOLO11 et RT-DETR, lorsqu’ils sont disponibles.
Exemples d'utilisation#
Cette section présente des exemples d'entraînement et d'inférence avec YOLO12.
Les exemples ci-dessous portent sur les modèles YOLO12 Detect (pour la détection d’objets). Pour les autres tâches prises en charge (segmentation, classification, estimation de pose et détection d’objets orientés), consulte la documentation dédiée à chaque tâche : Segment, Classify, Pose et OBB.
Les modèles *.pt préentraînés (avec PyTorch) et les fichiers de configuration *.yaml peuvent être transmis à la classe YOLO() pour créer une instance de modèle en Python :
from ultralytics import YOLO

# Charger un modèle YOLO12n préentraîné sur COCO
model = YOLO("yolo12n.pt")

# Entraîner le modèle sur le jeu de données d'exemple COCO8 pendant 100 époques
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Lancer l’inférence avec le modèle YOLO12n sur l’image 'bus.jpg'
results = model("path/to/bus.jpg")
Améliorations clés#
-
Amélioration de l’extraction de caractéristiques :
- Attention par zone : traite efficacement de grands champs réceptifs et réduit le coût de calcul.
- Équilibre optimisé : améliore l’équilibre entre les calculs des réseaux d’attention et à propagation avant.
- R-ELAN : améliore l’agrégation de caractéristiques grâce à l’architecture R-ELAN.
-
Innovations en matière d’optimisation :
- Connexions résiduelles : introduit des connexions résiduelles avec mise à l’échelle pour stabiliser l’entraînement, en particulier dans les modèles de grande taille.
- Intégration des caractéristiques affinée : met en œuvre une méthode améliorée d’intégration des caractéristiques dans R-ELAN.
- FlashAttention : intègre FlashAttention pour réduire la surcharge liée aux accès mémoire.
-
Efficacité architecturale :
- Moins de paramètres : réduit le nombre de paramètres tout en maintenant ou en améliorant la précision par rapport à de nombreux modèles précédents.
- Attention rationalisée : utilise une implémentation simplifiée de l’attention, sans encodage positionnel.
- Ratios MLP optimisés : ajuste les ratios MLP afin de répartir plus efficacement les ressources de calcul.
Configuration requise#
Par défaut, l’implémentation Ultralytics de YOLO12 ne nécessite pas FlashAttention. Toutefois, FlashAttention peut être compilé et utilisé en option avec YOLO12. Pour compiler FlashAttention, il faut l’un des GPU NVIDIA suivants :
- GPU Turing (p. ex. T4, gamme Quadro RTX)
- GPU Ampere (p. ex. gamme RTX30, A30/40/100)
- GPU Ada Lovelace (p. ex. gamme RTX40)
- GPU Hopper (p. ex., H100/H200)
Citations et remerciements#
Si tu utilises YOLO12 dans tes recherches, cite les travaux originaux de l'université de Buffalo et de l'Académie chinoise des sciences :
@inproceedings{tian2025yolov12,
  title={YOLOv12: Attention-Centric Real-Time Object Detectors},
  author={Tian, Yunjie and Ye, Qixiang and Doermann, David},
  booktitle={Advances in Neural Information Processing Systems},
  volume={38},
  pages={78433--78457},
  year={2025},
  url={https://proceedings.neurips.cc/paper_files/paper/2025/file/7103444259031cc58051f8c9a4868533-Paper-Conference.pdf}
}

@software{yolo12,
  author = {Tian, Yunjie and Ye, Qixiang and Doermann, David},
  title = {YOLO12: Attention-Centric Real-Time Object Detectors},
  year = {2025},
  url = {https://github.com/sunsmarterjie/yolov12},
  license = {AGPL-3.0}
}
L'article sur YOLO12 a été publié dans les actes de NeurIPS 2025, avec une prépublication sur arXiv.
FAQ#
YOLO12 intègre plusieurs innovations clés pour équilibrer vitesse et précision. Le mécanisme d'attention par zone traite efficacement de grands champs réceptifs, réduisant le coût de calcul par rapport à l'auto-attention standard. Les réseaux d'agrégation de couches résiduels efficaces (R-ELAN) améliorent l'agrégation des caractéristiques et répondent aux difficultés d'optimisation des modèles plus grands axés sur l'attention. L'architecture d'attention optimisée, qui comprend l'utilisation de FlashAttention et la suppression de l'encodage positionnel, améliore encore l'efficacité. Ces caractéristiques permettent à YOLO12 d'atteindre une grande précision tout en conservant la vitesse d'inférence en temps réel dont de nombreuses applications ont besoin.
YOLO12 prend en charge un large éventail de tâches essentielles de vision par ordinateur : la détection d'objets, la segmentation d'instances, la classification d'images, l'estimation de pose et la détection d'objets orientés (OBB). YOLO12 s'applique ainsi à des domaines variés, de la robotique et la conduite autonome à l'imagerie médicale et à l'inspection industrielle. Note que les poids
.ptpréentraînés sont actuellement publiés uniquement pour la détection ; les architectures de segmentation, d'estimation de pose, de classification et d'OBB sont fournies sous forme de configurations.yamlpour un entraînement à partir de zéro.YOLO12 améliore la précision à toutes les échelles de modèles par rapport aux modèles YOLO précédents, comme YOLOv10 et YOLO11, avec quelques compromis en matière de vitesse par rapport aux modèles antérieurs les plus rapides. Par exemple, YOLO12n obtient une amélioration de +2.1 % du mAP par rapport à YOLOv10n et de +1.2 % par rapport à YOLO11n sur le jeu de données COCO val2017. Par rapport à des modèles comme RT-DETR, YOLO12s offre une amélioration de +1.5 % du mAP et une augmentation de vitesse de +42 %. Ces métriques soulignent l’équilibre remarquable entre précision et efficacité de YOLO12.
Par défaut, l'implémentation Ultralytics de YOLO12 ne nécessite pas FlashAttention. Toutefois, FlashAttention peut être compilé et utilisé en option avec YOLO12 pour réduire au minimum la surcharge liée aux accès mémoire. Pour compiler FlashAttention, il faut l'un des GPU NVIDIA suivants : GPU Turing (par exemple, T4, gamme Quadro RTX), GPU Ampere (par exemple, gamme RTX30, A30/40/100), GPU Ada Lovelace (par exemple, gamme RTX40) ou GPU Hopper (H100/H200). Les utilisateurs peuvent ainsi profiter de FlashAttention si leur matériel le prend en charge.
Cette page présente des exemples d'utilisation de base pour l'entraînement et l'inférence. YOLO12 utilise les mêmes modes Train, Val, Predict et Export, ainsi que les mêmes interfaces de tâches Segment, Classify, Pose et OBB que les autres modèles Ultralytics.


Commentaires69
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
Zixuan-He
I try use the YOLO12-seg, but with update to lastest version (> pip install -U ultralytics) it is still showing (No such file or directory: 'YOLO12n-seg.pt) with code (yolo segment train data=data.yaml model=YOLO12n-seg.pt epochs=200 batch=16 imgsz=640 patience=25 ). theYOLO12n.pt for obj is good. Is the code changed or need other input?
1 Glenn JocherUltralytics
@Zixuan-He Answer:
The YOLO12-seg model requires using its specific configuration file. Trymodel=yolo12-seg.yamlinstead of the.ptfile to initialize training. The segmentation weights are not yet released as pretrained.ptfiles, but you can train from scratch using the YAML configuration. For details, see the YOLO12-seg documentation.2LucasGenoud
Hello, thank you for your answer ! Do you have any date estimation of when the pretrained segmentation models for YOLO12 will be available ? Thanks
- Glenn JocherUltralytics
We don't have an official release date for YOLO12-seg pretrained weights yet, but you can train segmentation models from scratch using the YOLO12-seg.yaml configuration. For updates, please monitor the YOLO12 documentation.
Thank you for your response. Great work :)
- Glenn JocherUltralytics
Thank you for your kind words! We don't have a specific release date for YOLO12-seg pretrained weights yet, but you can monitor the YOLO12 documentation for updates. The team typically announces new model releases there first. For now, training from scratch using the YOLO12-seg.yaml configuration remains the recommended approach.
dolokbutarbutar24
Here are some sample images for the healthy class. I also attached some "results" images, hopefully can give more information so you guys can help me with the project.
Pada Sen, 30 Mar 2026 pukul 15.58 Glenn Jocher @.***> menulis:
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune weight_decay, momentum, warmup_epochs, lrf, translate, shear, perspective, fliplr, and close_mosaic using the hyperparameter tuning guide https://docs.ultralytics.com/guides/hyperparameter-tuning/ and performance metrics guide https://docs.ultralytics.com/guides/yolo-performance-metrics/. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 https://docs.ultralytics.com/models/yolo26/ since YOLO12 is mainly maintained as a community research model.
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/19360?email_source=notifications&email_token=A23CVICPPIXOD6F3LMBB52T4TIZKDA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRTG44DGNRZUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16378369, or unsubscribe https://github.com/notifications/unsubscribe-auth/A23CVIG2PM2BD5335IFZQXT4TIZKDAVCNFSM6AAAAABXS26SR6VHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMMZXHAZTMOI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
Thanks, that helps; from those samples I’d next verify that the
healthylabels are fully consistent and that the class counts are not skewed, then please attach a few matching image/label.txtpairs plusresults.csvandconfusion_matrix_normalized.pngso we can check whether this is a data issue rather than a YOLO12 training issue, and if you recently fixed labels please delete anylabels/*.cachefiles before retraining.
I am currently working on a project to detect cassava leaf diseases using YOLOv12. The focus of this research is to perform hyperparameter tuning and also determine the most suitable augmentation configuration to improve model performance. So far, the trained model is still hovering around the 0.5 range for the mAP@50-95 evaluation metric. Here are the hyperparameters I have used for tuning so far: epochs=100, patience=20, imgsz=1024, batch=8, optimizer='auto', lr0=0.00511, box=6.32971, cls=2.87957, dfl=2.12658, mosaic=0.25, scale=0.15, mixup=0.0, copy_paste=0.0, degrees=10.0, hsv_h=0.015, hsv_s=0.7, hsv_v=0.4.
What other strategies can I do to improve my model's performance, especially on the mAP@50-95 evaluation metric? Do you have any suggestions for other hyperparameters that need to be added to this project for tuning? I'm sure your experience and skills can answer that and help me hahaha.
- Glenn JocherUltralytics
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune
weight_decay,momentum,warmup_epochs,lrf,translate,shear,perspective,fliplr, andclose_mosaicusing the hyperparameter tuning guide and performance metrics guide. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 since YOLO12 is mainly maintained as a community research model.
 Clousy
在5090 32G上使用yolo12l训练模型的时候,数据量大概7万左右,batch_size=24 内存占用在24G左右,为啥速度只有2-3it/s 是哪里设置有问题?下面是训练参数: rain_args = dict( data="data.yaml", epochs=500, imgsz=640, batch=24, device=device, workers=16,
cache=False, amp=True, # --- 减少 CPU 负担 --- mosaic=0.0, # 暂时关掉 Mosaic 看看速度是否飙升 mixup=0.0, # 同上 )- Glenn JocherUltralytics
yolo12l本身是重注意力结构,吞吐会比同尺度的 CNN 系列低不少,所以你看到的2–3 it/s在batch=24下未必异常(折算大约是48–72 img/s);如果你目标是更高训练/CPU 端速度,建议直接换到更稳更快的 Ultralytics YOLO26(YOLO12 更偏研究/基准用途,见 YOLO12 文档)。想确认是不是环境/数据读取瓶颈的话,请把yolo checks输出和完整文本训练日志(含第一轮的进度条行、CUDA:/显卡名、DataLoader相关信息)贴在这里;另外你现在cache=False可能会被磁盘 IO 卡住、workers=16在部分系统上也会造成额外调度开销,建议先用下面这组参数做一次对照测试(同一数据/同一imgsz),看it/s是否明显变化:yolo checks yolo train model=yolo12l.pt data=data.yaml epochs=2 imgsz=640 batch=24 device=0 workers=8 cache=True mosaic=0.0 mixup=0.0
is there any video (tutorial) about how to classify plant disease? i'm confused about how to do it because i need guidance to do classify task
- Glenn JocherUltralytics(modifié)
Yes—plant disease is just a standard image classification workflow; please follow the Ultralytics YOLO classification guide (and drop any follow-up questions here in this discussion so the Ultralytics team can see them), then try:
from ultralytics import YOLO

# ImageNet-pretrained classifier backbone (recommended starting point)
model = YOLO("yolo26n-cls.pt")

# Your dataset folder should contain train/ and val/ with one subfolder per class
model.train(data="path/to/plant_disease_dataset", epochs=50, imgsz=224)
If you share your dataset folder layout (just the directory tree) and what’s confusing you, I can point you to the exact next step.
asad121101
Hello , this new yolo12 is using what architecture in neck ? pan or fpn ? or some thing else ?
Sourabh0052
while working on classification model using YOLO12-cls and i do not make any .yaml file, just simply provide the data source path then will it work same or not
radadiavasu
I faced a problem that recently I put my model on training with yolo12x but at 98/100 epoch it stopped due to units are over on colab pro but when I start again and expect to start from 98 but it start from 1/100 instead of 98 even in results.csv I couldn't get anything. Why this problem occurs?
deldanr
When resuming a training session started with Yolov12, after the AMP check, the training session downloads a Yolov11 model to continue, which I assume is an error.
Attached is part of the log: YOLOv12l summary: 488 layers, 26,389,875 parameters, 26,389,859 gradients, 89.4 GFLOPs
Transferred 1245/1245 items from pretrained weights Freezing layer 'model.21.dfl.conv.weight' AMP: Running Automatic Mixed Precision (AMP) checks... Downloading https://github.com/ultralytics/assets/releases/download/v8.3.0/yolo11n.pt to 'yolo11n.pt'... <-- Here's the error
pvurda
Has anyone found a low-cost, low-latency way to generate a short semantic scene caption (e.g., “two people loading a van”) on top of YOLO12 detections in real time?