Dataset CIFAR-100#
Il dataset CIFAR-100 (Istituto canadese per la ricerca avanzata) è un benchmark di classificazione delle immagini composto da 60.000 immagini a colori di 32x32 pixel, distribuite uniformemente in 100 classi di dettaglio (600 immagini ciascuna), a loro volta raggruppate in 20 superclassi generiche. Creato da Alex Krizhevsky, include una suddivisione predefinita in 50.000 immagini di addestramento e 10.000 immagini di test, risultando così il fratello più difficile e dettagliato del dataset CIFAR-10.
Esplora CIFAR-100 su Ultralytics Platform per visualizzare in anteprima i campioni, esaminare le statistiche del dataset e clonarlo per l'addestramento.
Funzionalità principali#
- CIFAR-100 contiene 60.000 immagini a colori di 32x32 pixel, suddivise uniformemente in 100 classi.
- Ogni classe contiene esattamente 600 immagini — 500 per l'addestramento e 100 per il test — quindi il dataset è perfettamente bilanciato.
- Le 100 classi di dettaglio sono raggruppate in 20 superclassi generiche per la classificazione di livello superiore.
- Il dataset include una suddivisione predefinita tra addestramento e test, quindi non è necessaria alcuna suddivisione manuale o automatica.
- CIFAR-100 è un benchmark standard per la ricerca sulla classificazione delle immagini di dettaglio e sul riconoscimento degli oggetti.
Struttura del dataset#
CIFAR-100 include una suddivisione ufficiale predefinita, quindi non è necessaria alcuna partizione automatica o manuale:
- Classi: 100 classi di dettaglio, raggruppate in 20 superclassi generiche
- Immagini totali: 60.000 (a colori, 32x32)
- Set di addestramento: 50.000 immagini (500 per classe)
- Set di test: 10.000 immagini (100 per classe)
CIFAR-100 non dispone di una cartella di validazione separata, quindi per impostazione predefinita Ultralytics utilizza il set di test da 10.000 immagini come suddivisione di validazione durante l'addestramento. L'addestramento con data="cifar100" apprende le 100 classi di dettaglio.
Applicazioni#
CIFAR-100 è ampiamente utilizzato per addestrare e valutare modelli di classificazione delle immagini, dalle classiche reti neurali convoluzionali (CNNs) e macchine a vettori di supporto (SVMs) alle moderne architetture profonde. Le sue 100 classi di dettaglio e le immagini di piccole dimensioni lo rendono un benchmark impegnativo per la ricerca sul machine learning, il confronto tra algoritmi e la sperimentazione nella computer vision.
Utilizzo#
Addestra un modello YOLO su CIFAR-100 per 100 epoche con una dimensione delle immagini pari a 32. Per l'elenco completo degli argomenti disponibili, consulta la pagina Addestramento e la guida all'attività di classificazione delle immagini.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="cifar100", epochs=100, imgsz=32)
Immagini ed esempi di annotazioni#
Immagini di esempio del dataset CIFAR-100:
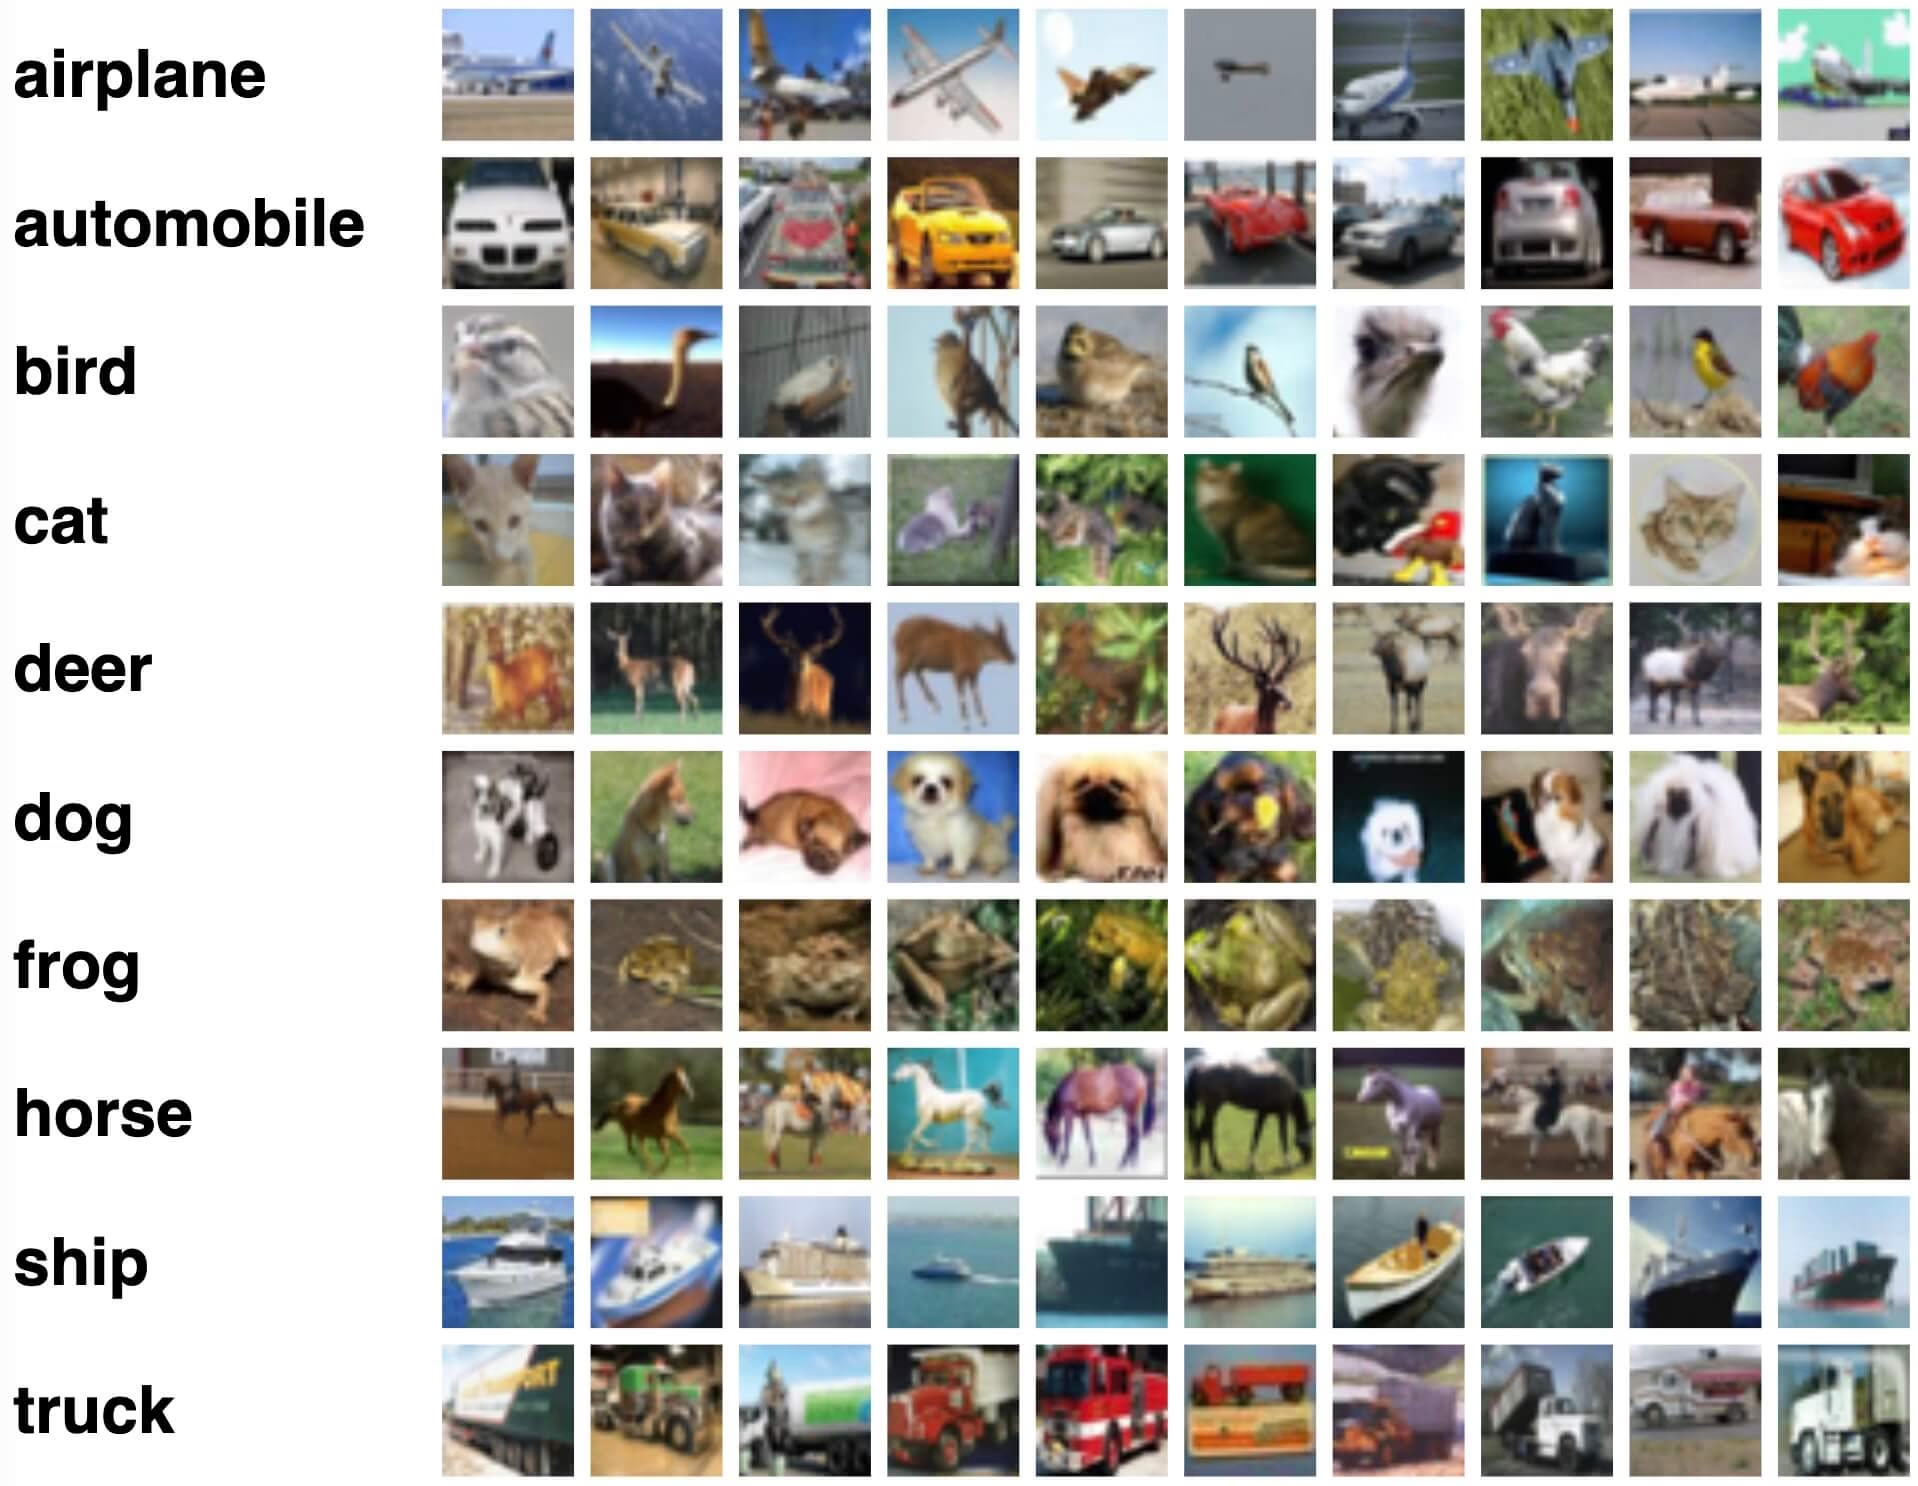
I campioni mostrano la varietà degli oggetti nel dataset CIFAR-100, evidenziando il valore di un dataset diversificato per l'addestramento di modelli di classificazione delle immagini robusti.
Citazioni e ringraziamenti#
Se utilizzi il dataset CIFAR-100 nella tua attività di ricerca o sviluppo, cita il seguente articolo:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Desideriamo ringraziare Alex Krizhevsky per aver creato e mantenuto il dataset CIFAR-100 come risorsa preziosa per la comunità di ricerca nel machine learning e nella computer vision. Per ulteriori informazioni sul dataset CIFAR-100 e sul suo creatore, visita il sito web del dataset CIFAR-100.
FAQ#
Il dataset CIFAR-100 è ampiamente utilizzato per addestrare e confrontare come benchmark modelli di classificazione delle immagini di dettaglio e di riconoscimento degli oggetti. Contiene 60.000 immagini a colori di 32x32 pixel distribuite in 100 classi raggruppate in 20 superclassi, rendendolo un benchmark più impegnativo di CIFAR-10 per algoritmi come le reti neurali convoluzionali (CNNs) e le macchine a vettori di supporto (SVMs), nonché per valutare modelli di deep learning realizzati con Ultralytics YOLO.
Per addestrare un modello Ultralytics YOLO su CIFAR-100, utilizza i frammenti di codice riportati di seguito. Il dataset viene scaricato automaticamente al primo utilizzo. Per un elenco completo degli argomenti, consulta la pagina Addestramento del modello.
Esempio di addestramentofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="cifar100", epochs=100, imgsz=32)CIFAR-100 contiene 100 classi di dettaglio — come mela, delfino, acero, motocicletta e razzo — con esattamente 600 immagini ciascuna, per un totale di 60.000 immagini. Queste 100 classi sono inoltre raggruppate in 20 superclassi generiche (ad esempio, la superclasse degli alberi comprende acero, quercia, palma, pino e salice). L'addestramento con
data="cifar100"utilizza le 100 classi di dettaglio.CIFAR-100 include una suddivisione predefinita composta da 50.000 immagini di addestramento e 10.000 immagini di test, con esattamente 500 immagini di addestramento e 100 immagini di test per classe. A differenza dei dataset di classificazione basati su cartelle, che Ultralytics suddivide automaticamente, la partizione ufficiale di CIFAR-100 viene utilizzata così com'è e il set di test funge da suddivisione di validazione durante l'addestramento per impostazione predefinita.
Sì. Ultralytics Platform ti consente di gestire i dataset, addestrare modelli di classificazione delle immagini e distribuirli senza dover scrivere molto codice. È un modo pratico per eseguire esperimenti con CIFAR-100 nel cloud; puoi inoltre esplorare altre opzioni nella nostra panoramica dei dataset di classificazione.