Dataset MNIST#
Il dataset MNIST (Istituto nazionale degli standard e della tecnologia modificato) è un benchmark di classificazione delle immagini composto da 70.000 immagini in scala di grigi di 28x28 pixel raffiguranti cifre scritte a mano, suddivise in 10 classi: le cifre da 0 a 9. Include una suddivisione predefinita in 60.000 immagini di addestramento e 10.000 immagini di test e da tempo rappresenta il benchmark standard per valutare gli algoritmi di machine learning e di visione artificiale. Per l'equivalente più difficile basato su immagini di abbigliamento, consulta il dataset correlato Fashion-MNIST; per le immagini a colori, consulta CIFAR-10.
Esplora MNIST sulla piattaforma Ultralytics per visualizzare in anteprima i campioni, esaminare le statistiche del dataset e clonarlo per l'addestramento.
Funzionalità principali#
- MNIST contiene 60.000 immagini di addestramento e 10.000 immagini di test di cifre scritte a mano, per un totale di 70.000 immagini.
- Ogni immagine è una rappresentazione in scala di grigi di 28x28 pixel di una singola cifra, normalizzata e antialiasing in un riquadro delimitatore fisso di 28x28 pixel.
- Le 10 classi comprendono le cifre da 0 a 9, con un numero di immagini per classe approssimativamente bilanciato.
- Include una suddivisione predefinita tra addestramento e test, quindi non è necessaria alcuna suddivisione manuale o automatica.
- MNIST è un benchmark standard per la ricerca sulla classificazione delle immagini e sul deep learning.
Struttura del dataset#
MNIST include una suddivisione ufficiale predefinita, quindi non è necessario alcun partizionamento automatico o manuale:
- Classi: 10 (cifre scritte a mano da 0 a 9)
- Immagini totali: 70.000 (28x28 in scala di grigi)
- Set di addestramento: 60.000 immagini
- Set di test: 10.000 immagini
MNIST non ha una cartella di validazione separata, quindi per impostazione predefinita Ultralytics utilizza il set di test da 10.000 immagini come suddivisione di validazione durante l'addestramento.
Ogni immagine è annotata con la cifra corrispondente (0–9), rendendo MNIST un dataset supervisionato ideale per le attività di classificazione.
Applicazioni#
MNIST è ampiamente utilizzato per addestrare e valutare modelli di classificazione delle immagini, dalle classiche reti neurali convoluzionali (CNN) e macchine a vettori di supporto (SVM) alle moderne architetture deep. Le sue piccole immagini in scala di grigi e le 10 classi di cifre lo rendono un benchmark rapido e riproducibile per confrontare gli algoritmi e sperimentare con la visione artificiale.
Alcune applicazioni comuni includono:
- Benchmarking di nuovi algoritmi di classificazione
- Scopi didattici per insegnare i concetti di machine learning
- Prototipazione di sistemi di riconoscimento delle immagini
- Test delle tecniche di ottimizzazione dei modelli
Utilizzo#
Addestra un modello YOLO per la classificazione su MNIST per 100 epoche con una dimensione dell'immagine pari a 28. Il dataset viene scaricato e memorizzato automaticamente nella cache al primo utilizzo; se preferisci il pieno controllo sul pre-processing, gli archivi gzip originali sono disponibili anche nel database MNIST. Per l'elenco completo degli argomenti disponibili, consulta la pagina Addestramento e la guida all'attività di classificazione delle immagini.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="mnist", epochs=100, imgsz=28)Ultralytics rende inoltre disponibile data="mnist160", un sottoinsieme di 160 immagini contenente le prime otto immagini di ciascuna cifra (0–9) da entrambe le suddivisioni di addestramento e test. Rispecchia la struttura delle directory di MNIST, quindi puoi sostituire i dataset senza modificare nessun altro argomento: è ideale per le pipeline di CI o per i controlli di integrità prima di impegnarti con il dataset completo da 70.000 immagini.
yolo classify train data=mnist160 model=yolo26n-cls.pt epochs=5 imgsz=28Immagini ed esempi di annotazioni#
Immagini di esempio del dataset MNIST:
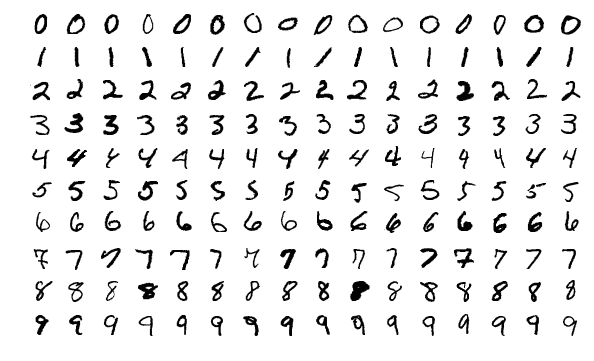
I campioni mostrano la varietà degli stili di scrittura a mano rappresentati dal dataset nelle 10 classi di cifre.
Citazioni e ringraziamenti#
Se utilizzi il dataset MNIST nella tua attività di ricerca o sviluppo, cita il seguente articolo:
@article{lecun2010mnist,
         title={MNIST handwritten digit database},
         author={LeCun, Yann and Cortes, Corinna and Burges, CJ},
         journal={ATT Labs [Online]},
         volume={2},
         year={2010}
}
Desideriamo ringraziare Yann LeCun, Corinna Cortes e Christopher J.C. Burges per aver creato e mantenuto il dataset MNIST come risorsa preziosa per la comunità di ricerca nel machine learning e nella visione artificiale. Per ulteriori informazioni sul dataset MNIST e sui suoi creatori, visita il sito web del dataset MNIST.
FAQ#
Il dataset MNIST è un benchmark composto da 70.000 immagini in scala di grigi di 28x28 pixel raffiguranti cifre scritte a mano, suddivise in 60.000 immagini di addestramento e 10.000 immagini di test nelle 10 classi da 0 a 9. È il riferimento standard per valutare gli algoritmi di classificazione delle immagini: il suo formato piccolo e uniforme consente a ricercatori e ingegneri di confrontare i metodi e monitorare i progressi con una configurazione minima, motivo per cui rimane un benchmark iniziale comune nel machine learning.
MNIST ha 10 classi — le cifre scritte a mano da 0 a 9 — e un totale di 70.000 immagini in scala di grigi, ciascuna di 28x28 pixel. Include una suddivisione predefinita in 60.000 immagini di addestramento e 10.000 immagini di test, con un numero di esempi per cifra approssimativamente uniforme.
Per addestrare un modello Ultralytics YOLO su MNIST, utilizza i frammenti di codice riportati di seguito. Il dataset viene scaricato automaticamente al primo utilizzo. Per un elenco dettagliato degli argomenti di addestramento disponibili, consulta la pagina Addestramento.
Esempio di addestramentofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="mnist", epochs=100, imgsz=28)MNIST include una suddivisione predefinita in 60.000 immagini di addestramento e 10.000 immagini di test. A differenza dei dataset di classificazione basati su cartelle, che Ultralytics suddivide automaticamente, la partizione ufficiale di MNIST viene utilizzata così com'è e, per impostazione predefinita, il set di test funge da suddivisione di validazione durante l'addestramento.
Il dataset MNIST contiene solo cifre scritte a mano, mentre il dataset Extended MNIST (EMNIST) include sia cifre sia lettere maiuscole e minuscole. EMNIST è stato sviluppato come successore di MNIST e utilizza lo stesso formato di 28x28 pixel, rendendolo compatibile con gli strumenti e i modelli progettati per il dataset MNIST originale. Questa gamma più ampia di caratteri rende EMNIST utile per una varietà maggiore di applicazioni di machine learning.
Sì. La piattaforma Ultralytics ti consente di caricare dataset, addestrare modelli di classificazione delle immagini e distribuirli senza dover scrivere molto codice. È un modo pratico per eseguire esperimenti con MNIST nel cloud: consulta la panoramica dei dataset di classificazione per le opzioni correlate.
MNIST è più semplice di molti dataset moderni come CIFAR-10 o ImageNet, il che lo rende ideale per i principianti e per la sperimentazione rapida. Sebbene i dataset più complessi offrano sfide maggiori con immagini a colori e categorie di oggetti diversificate, MNIST rimane prezioso per la sua semplicità, le dimensioni ridotte dei file e l'importanza storica nello sviluppo degli algoritmi di machine learning. Per un sostituto diretto più difficile con la stessa struttura, consulta Fashion-MNIST, che contiene capi di abbigliamento anziché cifre.