Dataset globale delle spighe di grano#
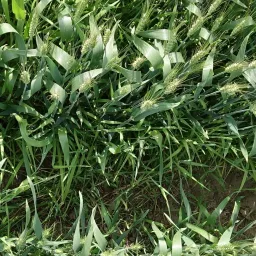
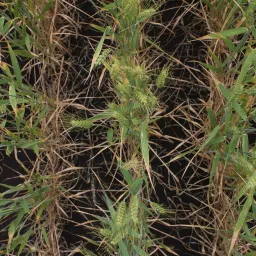
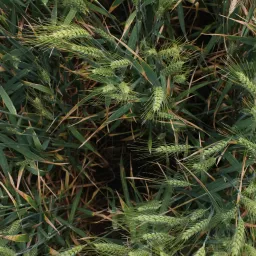
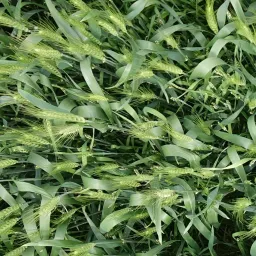
Il Global Wheat Head Dataset (GWHD) è un dataset a classe singola per il rilevamento di oggetti, pensato per rilevare le spighe di grano — le infiorescenze della pianta che portano i chicchi — in immagini di campi all'aperto. Comprende 3.422 immagini di addestramento, 748 di validazione e 1.276 di test, acquisite in diverse regioni di coltivazione, ed è stato creato dalla collaborazione di nove istituti di ricerca di sette paesi affinché i modelli generalizzino in ambienti diversi. Un rilevamento accurato delle spighe di grano è alla base delle stime della densità e delle dimensioni delle spighe e del potenziale di resa nella fenotipizzazione delle piante e nella gestione delle colture.
Funzionalità principali#
- Immagini reali di campi all'aperto che rappresentano la naturale variabilità nell'aspetto delle spighe di grano, nell'illuminazione e nelle fasi di crescita.
- Sviluppato da nove istituti di ricerca di sette paesi, copre le regioni di coltivazione europee, nordamericane, asiatiche e australiane per favorire una solida generalizzazione tra ambienti diversi.
- Annotazioni con riquadri delimitatori per una sola classe,
wheat_head, pronte per le pipeline di rilevamento di oggetti e tracciamento. - Le immagini di test provengono da genotipi e regioni non presenti nell'addestramento e offrono quindi un benchmark autentico per la generalizzazione.
Struttura del dataset#
Il Global Wheat Head Dataset è organizzato in tre sottoinsiemi definiti dalla configurazione GlobalWheat2020.yaml, tutti annotati con una sola classe, wheat_head:
| Subset | Immagini | Regioni |
|---|---|---|
| Addestra | 3,422 | Europa (Francia, Regno Unito, Svizzera), Nord America (Canada) |
| Validazione | 748 | Svizzera (ETH Zürich) |
| Test | 1,276 | Australia, Giappone, Cina |
Il set di convalida (748 immagini) è il sottoinsieme ethz_1, incluso anche nel set di addestramento: le metriche di convalida vengono quindi calcolate su immagini usate anche per addestrare il modello. Il set di test separato, composto da immagini provenienti da Australia, Giappone e Cina, misura la capacità di generalizzazione in ambienti non incontrati durante l'addestramento.
Applicazioni#
Il Global Wheat Head Dataset è ampiamente utilizzato per addestrare e valutare modelli di deep learning per il rilevamento delle spighe di grano. La varietà di immagini provenienti da diverse regioni, genotipi e condizioni lo rende una risorsa preziosa per la fenotipizzazione delle piante e la gestione delle colture, supportando la stima della resa, il monitoraggio della salute delle colture e l'analisi fenotipica.
Per annotare immagini di campi, addestrare modelli e gestire le versioni dei dataset nel browser, esegui l'intero flusso di lavoro con Ultralytics Platform.
YAML del dataset#
Un file YAML viene utilizzato per definire la configurazione del dataset. Specifica i percorsi, le classi e altri dettagli di configurazione del dataset. Per il Global Wheat Head Dataset, il file GlobalWheat2020.yaml è gestito in https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Global Wheat 2020 dataset https://www.global-wheat.com/ by University of Saskatchewan
# Documentation: https://docs.ultralytics.com/datasets/detect/globalwheat2020
# Example usage: yolo train data=GlobalWheat2020.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── GlobalWheat2020 ← downloads here (7.0 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: GlobalWheat2020 # dataset root dir
train: # train images (relative to 'path') 3422 images
  - images/arvalis_1
  - images/arvalis_2
  - images/arvalis_3
  - images/ethz_1
  - images/rres_1
  - images/inrae_1
  - images/usask_1
val: # val images (relative to 'path') 748 images (WARNING: train set contains ethz_1)
  - images/ethz_1
test: # test images (optional) 1276 images
  - images/utokyo_1
  - images/utokyo_2
  - images/nau_1
  - images/uq_1

# Classes
names:
  0: wheat_head

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  from pathlib import Path

  from ultralytics.utils.downloads import download

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = [
      "https://zenodo.org/record/4298502/files/global-wheat-codalab-official.zip",
      "https://github.com/ultralytics/assets/releases/download/v0.0.0/GlobalWheat2020_labels.zip",
  ]
  download(urls, dir=dir)

  # Make Directories
  for p in "annotations", "images", "labels":
      (dir / p).mkdir(parents=True, exist_ok=True)

  # Move
  for p in (
      "arvalis_1",
      "arvalis_2",
      "arvalis_3",
      "ethz_1",
      "rres_1",
      "inrae_1",
      "usask_1",
      "utokyo_1",
      "utokyo_2",
      "nau_1",
      "uq_1",
  ):
      (dir / "global-wheat-codalab-official" / p).rename(dir / "images" / p)  # move to /images
      f = (dir / "global-wheat-codalab-official" / p).with_suffix(".json")  # json file
      if f.exists():
f.rename((dir / "annotations" / p).with_suffix(".json")) # move to /annotationsUtilizzo#
Per addestrare un modello YOLO26n sul Global Wheat Head Dataset per 100 epoche con una dimensione delle immagini di 640, puoi usare i seguenti frammenti di codice. Il dataset (~7,0 GB) viene scaricato automaticamente al primo utilizzo. Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)
Immagini di esempio e annotazioni#
Il Global Wheat Head Dataset contiene una raccolta diversificata di immagini di campi all'aperto, che catturano la variabilità naturale nell'aspetto delle spighe di grano, negli ambienti e nelle condizioni. Ecco un'immagine di esempio del dataset con le relative annotazioni:
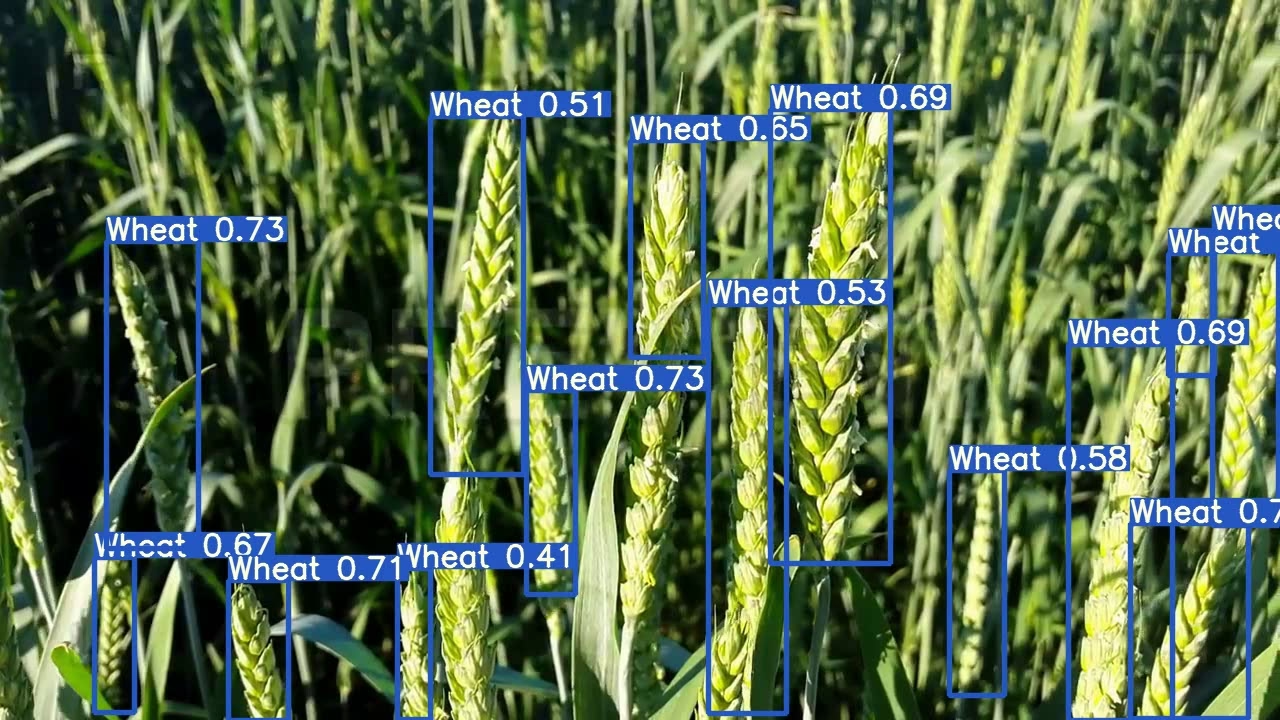
- Rilevamento delle spighe di grano: le spighe di grano sono annotate con riquadri di delimitazione per il rilevamento degli oggetti, in diverse condizioni di campo che riflettono la varietà e la complessità del dataset.
Citazioni e ringraziamenti#
Se utilizzi il Global Wheat Head Dataset per le tue attività di ricerca o sviluppo, cita il seguente articolo:
@article{david2020global,
         title={Global Wheat Head Detection (GWHD) Dataset: A Large and Diverse Dataset of High-Resolution RGB-Labelled Images to Develop and Benchmark Wheat Head Detection Methods},
         author={David, Etienne and Madec, Simon and Sadeghi-Tehran, Pouria and Aasen, Helge and Zheng, Bangyou and Liu, Shouyang and Kirchgessner, Norbert and Ishikawa, Goro and Nagasawa, Koichi and Badhon, Minhajul and others},
         journal={arXiv preprint arXiv:2005.02162},
         year={2020}
}
Desideriamo ringraziare i ricercatori e gli enti che hanno contribuito alla creazione e alla manutenzione del Global Wheat Head Dataset, una risorsa preziosa per la comunità di ricerca sulla fenotipizzazione delle piante e sulla gestione delle colture. Per ulteriori informazioni sul dataset e sui suoi creatori, visita il sito web del Global Wheat Head Dataset.
Domande frequenti#
Il Global Wheat Head Dataset viene utilizzato principalmente per sviluppare e addestrare modelli di deep learning destinati al rilevamento delle spighe di grano. Questo è fondamentale per le applicazioni di fenotipizzazione del grano e di gestione delle colture, perché consente di stimare con maggiore precisione densità e dimensioni delle spighe, nonché il potenziale complessivo di resa delle colture. Metodi di rilevamento accurati aiutano a valutare la salute e la maturità delle colture, aspetti essenziali per una gestione efficiente.
Il Global Wheat Head Dataset ha una sola classe,
wheat_head, ed è suddiviso in tre sottoinsiemi: 3.422 immagini di addestramento, 748 immagini di convalida e 1.276 immagini di test. Le immagini di addestramento e convalida provengono dall'Europa e dal Nord America, mentre il set di test comprende immagini provenienti da Australia, Giappone e Cina per valutare la capacità di generalizzazione in ambienti non incontrati.Per addestrare un modello YOLO26n sul Global Wheat Head Dataset, puoi usare i seguenti frammenti di codice. Assicurati di avere il file di configurazione
GlobalWheat2020.yamlcon i percorsi del dataset e le classi:Esempio di addestramentofrom ultralytics import YOLO # Carica un modello preaddestrato (consigliato per l'addestramento) model = YOLO("yolo26n.pt") # Addestra il modello results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello.
Il dataset (~7,0 GB) viene scaricato automaticamente la prima volta che avvii l'addestramento con
data="GlobalWheat2020.yaml": non è necessario alcun passaggio manuale. Ultralytics scarica immagini ed etichette e le estrae nella directory locale dei dataset. Puoi consultare dataset correlati nella panoramica dei dataset di rilevamento.Il file YAML di configurazione del Global Wheat Head Dataset, denominato
GlobalWheat2020.yaml, è disponibile su GitHub. Puoi accedervi da https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml. Il file contiene i percorsi del dataset, le classi e altri dettagli di configurazione necessari per addestrare modelli con Ultralytics YOLO.Il rilevamento delle spighe di grano è fondamentale per la gestione delle colture perché consente di stimarne con precisione la densità e le dimensioni, elementi essenziali per valutare la salute, la maturità e il potenziale di resa delle colture. Utilizzando modelli di deep learning addestrati su dataset come il Global Wheat Head Dataset, agricoltori e ricercatori possono monitorare e gestire meglio le colture, aumentando la produttività e ottimizzando l'uso delle risorse nelle pratiche agricole. Questo progresso tecnologico sostiene l'agricoltura sostenibile e le iniziative per la sicurezza alimentare.
Per ulteriori informazioni sulle applicazioni dell'IA in agricoltura, visita IA in agricoltura.