Dataset ADE20K#
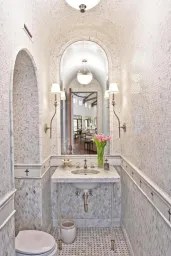
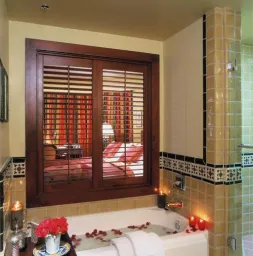
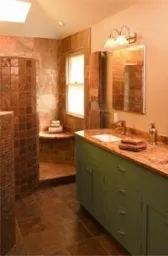
Il dataset ADE20K è un benchmark su larga scala di segmentazione semantica sviluppato da MIT CSAIL, con 20.210 immagini di addestramento e 2.000 immagini di validazione annotate dettagliatamente in 150 categorie di ambienti interni, esterni, oggetti e sfondo. È una risorsa standard per addestrare e valutare modelli di comprensione densa delle scene con Ultralytics YOLO.
Funzionalità principali#
- Il benchmark completo SceneParsing di ADE20K comprende 25.562 immagini: 20.210 per l'addestramento, 2.000 per la validazione e 3.352 per il test. Le annotazioni delle immagini di test non sono distribuite pubblicamente, quindi l'archivio scaricabile
ADEChallengeData2016e la configurazione Ultralyticsade20k.yamlusano solo gli split di addestramento e validazione. - Il dataset comprende 150 classi semantiche distribuite tra categorie di ambienti interni, esterni, oggetti e sfondo.
- Le annotazioni sono maschere di segmentazione dense a livello di pixel, adatte all'analisi delle scene.
Struttura del dataset#
La configurazione Ultralytics richiede la struttura ufficiale ADEChallengeData2016:
ADEChallengeData2016/
├── images/
│   ├── training/
│   └── validation/
└── annotations/
    ├── training/
└── validation/ADE20K non dispone di uno script per il download automatico. Scarica l'archivio ADEChallengeData2016.zip da ~1 GB ed estrailo direttamente nella cartella datasets/. La cartella principale dell'archivio si chiama già ADEChallengeData2016/, quindi otterrai datasets/ADEChallengeData2016/, conforme alla struttura precedente — non creare tu una cartella ADEChallengeData2016 ed estrai l'archivio al suo interno, altrimenti otterrai una directory annidata datasets/ADEChallengeData2016/ADEChallengeData2016/ che il file YAML non troverà.
Il campo masks_dir è impostato su annotations, quindi ogni immagine in images/ viene associata alla maschera corrispondente in annotations/. Le maschere ADE20K originali usano ID delle etichette di origine, dove 0 viene ignorato; la sezione label_mapping converte le etichette valide da 1 a 150 in ID di addestramento contigui da 0 a 149, mappando i pixel ignorati su 255.
Applicazioni#
ADE20K è ampiamente utilizzato per addestrare e valutare modelli di deep learning nella segmentazione semantica e nell'analisi delle scene. La varietà delle categorie e la complessità delle scene lo rendono prezioso per applicazioni come la navigazione autonoma, la robotica, la realtà aumentata e l'editing delle immagini.
L'ampia varietà di scene interne ed esterne rende inoltre ADE20K un benchmark efficace per valutare la generalizzazione dei modelli tra domini diversi. I modelli YOLO26 preaddestrati di segmentazione semantica raggiungono fino a 51,5 mIoU sul set di validazione ADE20K — consulta la pagina dei modelli di segmentazione semantica per la tabella completa del benchmark. I dataset in formato ADE20K sono inoltre pienamente compatibili con Ultralytics Platform per la gestione e l'addestramento dei dataset.
YAML del dataset#
Un file YAML del dataset definisce i percorsi di ADE20K, le classi, la directory delle maschere e la mappatura delle etichette. Il file ade20k.yaml è disponibile all'indirizzo https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/ade20k.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# ADE20K semantic segmentation dataset (150 classes)
# Documentation: https://docs.ultralytics.com/datasets/semantic/ade20k
# Example usage: yolo semantic train data=ade20k.yaml model=yolo26n-sem.pt
# parent
# ├── ultralytics
# └── datasets
#     └── ADEChallengeData2016 ← downloads here (1 GB)
#         └── images
#         └── annotations

# Dataset root directory
path: ADEChallengeData2016
train: images/training
val: images/validation

masks_dir: annotations # semantic mask directory

# ADE20K 150-class labels
names:
  0: wall
  1: building
  2: sky
  3: floor
  4: tree
  5: ceiling
  6: road
  7: bed
  8: windowpane
  9: grass
  10: cabinet
  11: sidewalk
  12: person
  13: earth
  14: door
  15: table
  16: mountain
  17: plant
  18: curtain
  19: chair
  20: car
  21: water
  22: painting
  23: sofa
  24: shelf
  25: house
  26: sea
  27: mirror
  28: rug
  29: field
  30: armchair
  31: seat
  32: fence
  33: desk
  34: rock
  35: wardrobe
  36: lamp
  37: bathtub
  38: railing
  39: cushion
  40: base
  41: box
  42: column
  43: signboard
  44: chest of drawers
  45: counter
  46: sand
  47: sink
  48: skyscraper
  49: fireplace
  50: refrigerator
  51: grandstand
  52: path
  53: stairs
  54: runway
  55: case
  56: pool table
  57: pillow
  58: screen door
  59: stairway
  60: river
  61: bridge
  62: bookcase
  63: blind
  64: coffee table
  65: toilet
  66: flower
  67: book
  68: hill
  69: bench
  70: countertop
  71: stove
  72: palm
  73: kitchen island
  74: computer
  75: swivel chair
  76: boat
  77: bar
  78: arcade machine
  79: hovel
  80: bus
  81: towel
  82: light
  83: truck
  84: tower
  85: chandelier
  86: awning
  87: streetlight
  88: booth
  89: television receiver
  90: airplane
  91: dirt track
  92: apparel
  93: pole
  94: land
  95: bannister
  96: escalator
  97: ottoman
  98: bottle
  99: buffet
  100: poster
  101: stage
  102: van
  103: ship
  104: fountain
  105: conveyor belt
  106: canopy
  107: washer
  108: plaything
  109: swimming pool
  110: stool
  111: barrel
  112: basket
  113: waterfall
  114: tent
  115: bag
  116: minibike
  117: cradle
  118: oven
  119: ball
  120: food
  121: step
  122: tank
  123: trade name
  124: microwave
  125: pot
  126: animal
  127: bicycle
  128: lake
  129: dishwasher
  130: screen
  131: blanket
  132: sculpture
  133: hood
  134: sconce
  135: vase
  136: traffic light
  137: tray
  138: ashcan
  139: fan
  140: pier
  141: crt screen
  142: plate
  143: monitor
  144: bulletin board
  145: shower
  146: radiator
  147: glass
  148: clock
  149: flag

# Map source label IDs to train IDs; ignore_label is converted to 255.
label_mapping:
  0: ignore_label
  1: 0
  2: 1
  3: 2
  4: 3
  5: 4
  6: 5
  7: 6
  8: 7
  9: 8
  10: 9
  11: 10
  12: 11
  13: 12
  14: 13
  15: 14
  16: 15
  17: 16
  18: 17
  19: 18
  20: 19
  21: 20
  22: 21
  23: 22
  24: 23
  25: 24
  26: 25
  27: 26
  28: 27
  29: 28
  30: 29
  31: 30
  32: 31
  33: 32
  34: 33
  35: 34
  36: 35
  37: 36
  38: 37
  39: 38
  40: 39
  41: 40
  42: 41
  43: 42
  44: 43
  45: 44
  46: 45
  47: 46
  48: 47
  49: 48
  50: 49
  51: 50
  52: 51
  53: 52
  54: 53
  55: 54
  56: 55
  57: 56
  58: 57
  59: 58
  60: 59
  61: 60
  62: 61
  63: 62
  64: 63
  65: 64
  66: 65
  67: 66
  68: 67
  69: 68
  70: 69
  71: 70
  72: 71
  73: 72
  74: 73
  75: 74
  76: 75
  77: 76
  78: 77
  79: 78
  80: 79
  81: 80
  82: 81
  83: 82
  84: 83
  85: 84
  86: 85
  87: 86
  88: 87
  89: 88
  90: 89
  91: 90
  92: 91
  93: 92
  94: 93
  95: 94
  96: 95
  97: 96
  98: 97
  99: 98
  100: 99
  101: 100
  102: 101
  103: 102
  104: 103
  105: 104
  106: 105
  107: 106
  108: 107
  109: 108
  110: 109
  111: 110
  112: 111
  113: 112
  114: 113
  115: 114
  116: 115
  117: 116
  118: 117
  119: 118
  120: 119
  121: 120
  122: 121
  123: 122
  124: 123
  125: 124
  126: 125
  127: 126
  128: 127
  129: 128
  130: 129
  131: 130
  132: 131
  133: 132
  134: 133
  135: 134
  136: 135
  137: 136
  138: 137
  139: 138
  140: 139
  141: 140
  142: 141
  143: 142
  144: 143
  145: 144
  146: 145
  147: 146
  148: 147
  149: 148
  150: 149
# Download URL (manual): https://data.csail.mit.edu/places/ADEchallenge/ADEChallengeData2016.zipUtilizzo#
Per addestrare un modello YOLO26n-sem sul dataset ADE20K per 100 epoche con una dimensione delle immagini di 512, puoi usare i seguenti frammenti di codice. Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-sem.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="ade20k.yaml", epochs=100, imgsz=512)
Citazioni, licenza e ringraziamenti#
Le immagini ADE20K sono distribuite esclusivamente per uso non commerciale a fini di ricerca e istruzione; il software di annotazione del dataset è concesso in licenza separatamente secondo BSD-3. L'uso commerciale richiede l'autorizzazione di MIT CSAIL.
Se utilizzi il dataset ADE20K nella tua attività di ricerca o sviluppo, cita il seguente articolo:
@inproceedings{zhou2017scene,
  title={Scene Parsing through ADE20K Dataset},
  author={Zhou, Bolei and Zhao, Hang and Puig, Xavier and Fidler, Sanja and Barriuso, Adela and Torralba, Antonio},
  booktitle={Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition},
  year={2017}
}
Desideriamo ringraziare il MIT CSAIL Computer Vision Group per aver creato e mantenuto questa preziosa risorsa per la comunità della computer vision. Per ulteriori informazioni sul dataset ADE20K e sui suoi creatori, visita il sito web del dataset ADE20K.
FAQ#
Il dataset ADE20K è un benchmark su larga scala per l'analisi delle scene, utilizzato per la segmentazione semantica, con 20.210 immagini di addestramento e 2.000 immagini di validazione distribuite pubblicamente in 150 categorie che comprendono classi di ambienti interni, esterni, oggetti e sfondo. I ricercatori utilizzano ADE20K per la varietà delle scene, l'insieme di categorie dettagliato e metriche di valutazione standardizzate come la media dell'intersezione sull'unione (mIoU), che lo rendono ideale per il benchmarking dei modelli di predizione densa.
Per addestrare un modello YOLO26n-sem sul dataset ADE20K per 100 epoche con una dimensione delle immagini di 512, puoi usare i seguenti frammenti di codice. Per un elenco dettagliato degli argomenti disponibili, consulta la pagina Addestramento del modello.
Esempio di addestramentofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-sem.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="ade20k.yaml", epochs=100, imgsz=512)Il dataset ADE20K segue la struttura ufficiale ADEChallengeData2016, con le immagini organizzate in
images/training/eimages/validation/e le maschere corrispondenti inannotations/training/eannotations/validation/. Il file YAML di Ultralytics associa ogni immagine alla relativa maschera tramite il campomasks_dir: annotationse usalabel_mappingper convertire gli ID delle etichette di origine da1a150in ID di addestramento contigui da0a149, mappando l'etichetta da ignorare su255.Sì. Scarica l'archivio
ADEChallengeData2016.zip(~1 GB) ed estrailo direttamente nella cartelladatasets/prima dell'addestramento — la cartella principale dell'archivio si chiama giàADEChallengeData2016/, quindi estraendolo in quella posizione (non in una cartella separataADEChallengeData2016creata da te) otterrai la strutturaimages/eannotations/richiesta daade20k.yaml.Le maschere di annotazione ADE20K memorizzano gli ID delle etichette di origine, dove
0indica la classe da ignorare o lo sfondo. La sezionelabel_mappingmappa le etichette valide da1a150in ID di addestramento contigui da0a149e assegna255ai pixel ignorati, così che vengano esclusi dalla funzione di perdita e dalle metriche durante l'addestramento e la validazione.No. Le immagini ADE20K sono distribuite secondo termini che ne limitano l'uso alla ricerca e all'istruzione non commerciali; il software di annotazione associato è concesso in licenza separatamente secondo BSD-3. Contatta MIT CSAIL per conoscere le opzioni di licenza commerciale.