Validazione incrociata K-Fold con Ultralytics
Introduzione#
Questa guida mostra come implementare la convalida incrociata K-Fold per i dataset di rilevamento di oggetti nell'ecosistema Ultralytics. Usa il formato di rilevamento YOLO e librerie Python come scikit-learn, pandas e PyYAML per illustrare la configurazione, la generazione di vettori di caratteristiche e la suddivisione del dataset con K-Fold.
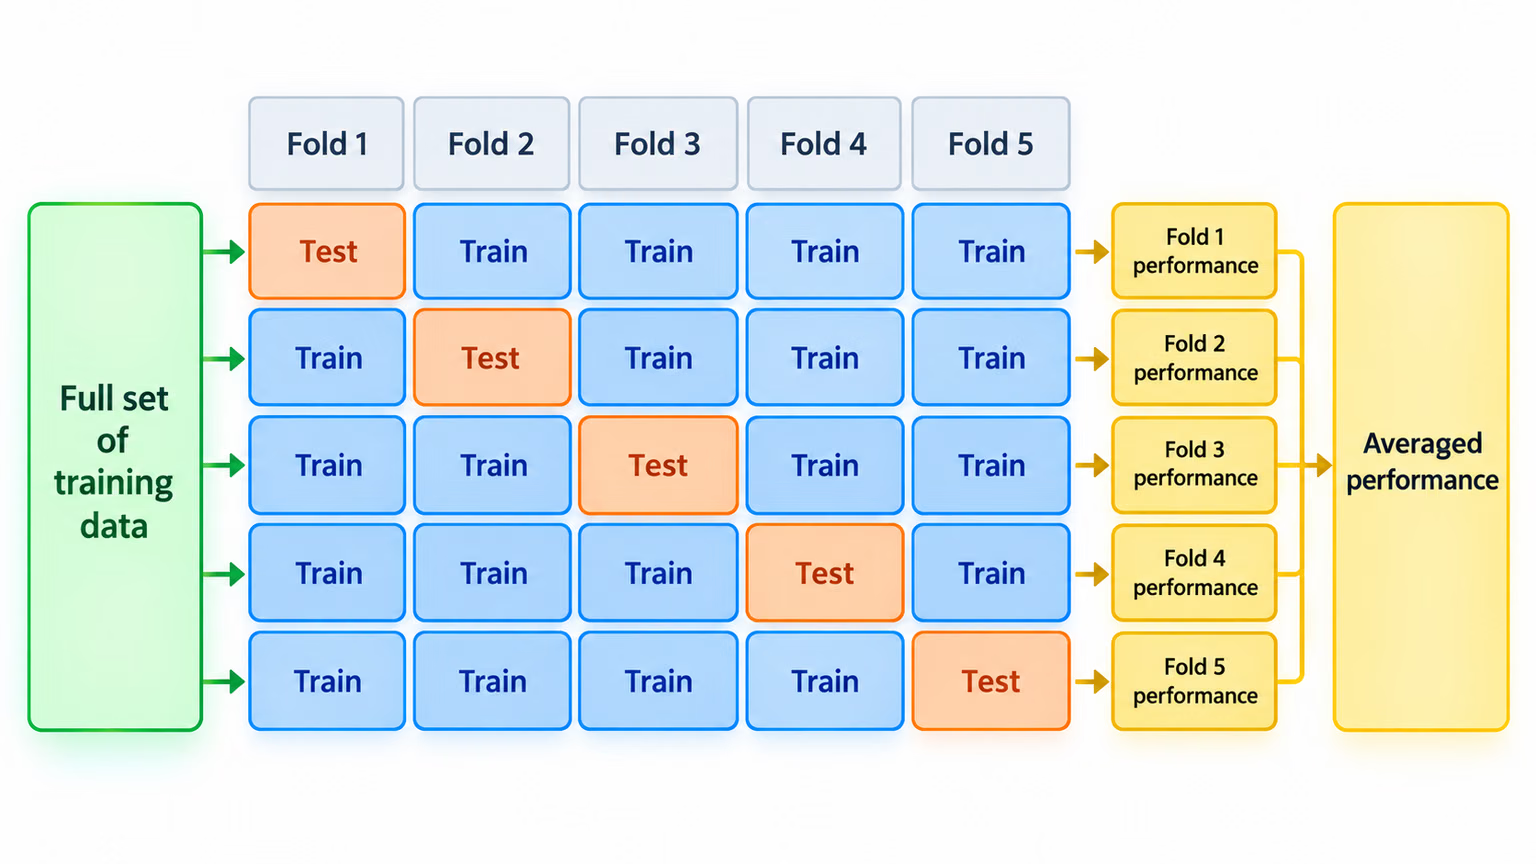
Che il tuo progetto riguardi il dataset Fruit Detection o una fonte di dati personalizzata, questo tutorial ti aiuta a comprendere e applicare la convalida incrociata K-Fold per migliorare l'affidabilità e la robustezza dei tuoi modelli di machine learning. Per questo tutorial applichiamo k=5 fold, ma tieni presente che il numero ottimale di fold può variare in base al dataset e alle specificità del progetto. La convalida incrociata K-Fold è particolarmente utile quando il dataset è piccolo, rumoroso o molto variabile; per dataset grandi e diversificati, di solito è sufficiente una suddivisione ben strutturata in set di addestramento, convalida e test.
Configurazione#
-
Le annotazioni devono essere nel formato di rilevamento YOLO.
-
Questa guida presuppone che i file di annotazione siano disponibili in locale.
-
Per la dimostrazione, usiamo il dataset Fruit Detection.
- Questo dataset contiene in totale 8479 immagini.
- Include 6 etichette di classe, con il numero totale di istanze per ciascuna indicato di seguito.
| Etichetta di classe | Numero di istanze |
|---|---|
| Mela | 7049 |
| Uva | 7202 |
| Ananas | 1613 |
| Arancia | 15549 |
| Banana | 3536 |
| Anguria | 1976 |
-
I pacchetti Python necessari includono:
ultralyticssklearnpandaspyyaml
-
Questo tutorial usa
k=5fold. Tuttavia, dovresti determinare il numero di fold più adatto al tuo dataset.
-
Crea e attiva un nuovo ambiente virtuale Python (
venv) per il tuo progetto. Usapip(o il gestore di pacchetti che preferisci) per installare:- La libreria Ultralytics:
pip install -U ultralytics. In alternativa, puoi clonare il repository ufficiale. - Scikit-learn, pandas e PyYAML:
pip install -U scikit-learn pandas pyyaml.
- La libreria Ultralytics:
-
Verifica che le annotazioni siano nel formato di rilevamento YOLO.
- Per questo tutorial, tutti i file di annotazione si trovano nella directory
Fruit-Detection/labels.
- Per questo tutorial, tutti i file di annotazione si trovano nella directory
Generazione dei vettori di caratteristiche per un dataset di rilevamento degli oggetti#
-
Per iniziare, crea un nuovo file Python
example.pyper eseguire i passaggi seguenti. -
Carica le immagini di addestramento e convalida elencate nel file YAML del dataset con la classe Ultralytics
YOLODataset, lasciando invariato il set di test.from pathlib import Path from ultralytics.data.dataset import YOLODataset from ultralytics.data.utils import check_det_dataset yaml_file = "path/to/data.yaml" data = check_det_dataset(yaml_file) dataset_path = Path(data["path"]) sources = [] for split in ("train", "val"): source = data.get(split) if source: sources.extend(source if isinstance(source, list) else [source]) dataset = YOLODataset(sources, data=data, augment=False) images = [Path(p) for p in dataset.im_files] -
Ora leggi il contenuto del file YAML del dataset ed estrai gli indici delle etichette di classe.
classes = data["names"] cls_idx = sorted(classes.keys()) -
Inizializza un DataFrame
pandasvuoto.import pandas as pd labels_df = pd.DataFrame(0.0, columns=cls_idx, index=images) -
Conta le istanze di ogni etichetta di classe presenti nei file di annotazione.
from collections import Counter for image, label in zip(images, dataset.labels): lbl_counter = Counter(label["cls"].flatten().astype(int)) labels_df.loc[image, list(lbl_counter)] = list(lbl_counter.values()) -
Ecco un esempio del DataFrame popolato:
                                                       0    1    2    3    4    5
'0000a16e4b057580_jpg.rf.00ab48988370f64f5ca8ea4...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.7e6dce029fb67f01eb19aa7...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.bc4d31cdcbe229dd022957a...'  0.0  0.0  0.0  0.0  0.0  7.0
'00020ebf74c4881c_jpg.rf.508192a0a97aa6c4a3b6882...'  0.0  0.0  0.0  1.0  0.0  0.0
'00020ebf74c4881c_jpg.rf.5af192a2254c8ecc4188a25...'  0.0  0.0  0.0  1.0  0.0  0.0
 ...                                                  ...  ...  ...  ...  ...  ...
'ff4cd45896de38be_jpg.rf.c4b5e967ca10c7ced3b9e97...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff4cd45896de38be_jpg.rf.ea4c1d37d2884b3e3cbce08...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff5fd9c3c624b7dc_jpg.rf.bb519feaa36fc4bf630a033...'  1.0  0.0  0.0  0.0  0.0  0.0
'ff5fd9c3c624b7dc_jpg.rf.f0751c9c3aa4519ea3c9d6a...'  1.0  0.0  0.0  0.0  0.0  0.0
'fffe28b31f2a70d4_jpg.rf.7ea16bd637ba0711c53b540...'  0.0  6.0  0.0  0.0  0.0  0.0
Le righe usano percorsi assoluti delle immagini e le colonne corrispondono agli indici delle etichette di classe. Le etichette mancanti restano righe di sfondo composte solo da zeri. Questa struttura dei dati consente di applicare la convalida incrociata K-Fold a un dataset di rilevamento di oggetti.
Suddivisione del dataset K-Fold#
-
Ora useremo la classe
KFolddisklearn.model_selectionper generareksuddivisioni del dataset.- Importante:
- Impostare
shuffle=Trueassicura una distribuzione casuale delle classi nelle suddivisioni. - Impostando
random_state=Msu un valore in cuiMè un intero scelto, puoi ottenere risultati ripetibili.
- Impostare
from sklearn.model_selection import KFold ksplit = 5 kf = KFold(n_splits=ksplit, shuffle=True, random_state=20) # impostazione di random_state per ottenere risultati ripetibili kfolds = list(kf.split(labels_df)) - Importante:
-
Il dataset è stato suddiviso in
kfold, ognuno dei quali contiene un elenco di indicitraineval. Creeremo un DataFrame per mostrare questi risultati più chiaramente.folds = [f"split_{n}" for n in range(1, ksplit + 1)] folds_df = pd.DataFrame(index=labels_df.index, columns=folds) for i, (train, val) in enumerate(kfolds, start=1): folds_df.loc[labels_df.index[train], f"split_{i}"] = "train" folds_df.loc[labels_df.index[val], f"split_{i}"] = "val" -
Ora calcoleremo la distribuzione delle etichette di classe per ciascun fold come rapporto tra le classi presenti in
vale quelle presenti intrain.fold_lbl_distrb = pd.DataFrame(index=folds, columns=cls_idx) for n, (train_indices, val_indices) in enumerate(kfolds, start=1): train_totals = labels_df.iloc[train_indices].sum() val_totals = labels_df.iloc[val_indices].sum() # To avoid division by zero, we add a small value (1E-7) to the denominator ratio = val_totals / (train_totals + 1e-7) fold_lbl_distrb.loc[f"split_{n}"] = ratioLo scenario ideale prevede che i rapporti di tutte le classi siano ragionevolmente simili per ogni suddivisione e tra le classi. Tuttavia, questo dipende dalle specificità del dataset.
-
Scrivi gli elenchi di immagini e un YAML del dataset per ogni suddivisione. Gli elenchi di testo evitano di copiare il dataset
kvolte.import yaml save_path = dataset_path.parent / f"{ksplit}-Fold_Cross-val" save_path.mkdir(parents=True, exist_ok=True) ds_yamls = [] for split in folds_df.columns: for partition in ("train", "val"): split_images = folds_df.index[folds_df[split] == partition] paths = "\n".join(map(str, split_images)) (save_path / f"{split}_{partition}.txt").write_text(f"{paths}\n") dataset_yaml = save_path / f"{split}.yaml" ds_yamls.append(dataset_yaml) with open(dataset_yaml, "w") as ds_y: yaml.safe_dump( { "path": save_path.as_posix(), "train": f"{split}_train.txt", "val": f"{split}_val.txt", "names": classes, }, ds_y, )
Salvataggio dei record (facoltativo)#
Facoltativamente, puoi salvare i record della suddivisione K-Fold e i DataFrame della distribuzione delle etichette come file CSV per consultarli in futuro.
folds_df.to_csv(save_path / "kfold_datasplit.csv")
fold_lbl_distrb.to_csv(save_path / "kfold_label_distribution.csv")
Addestrare YOLO con le suddivisioni dei dati K-Fold#
-
Per prima cosa, carica il modello YOLO.
from ultralytics import YOLO weights_path = "path/to/weights.pt" # usa yolo26n.pt per un modello piccolo model = YOLO(weights_path, task="detect") -
Poi scorri i file YAML del dataset per avviare l'addestramento. I risultati verranno salvati in una directory specificata dagli argomenti
projectename. Per impostazione predefinita, questa directory èruns/detect/train#, dove#è un indice intero.results = {} # Define your additional arguments here batch = 16 project = "kfold_demo" epochs = 100 for k, dataset_yaml in enumerate(ds_yamls): model = YOLO(weights_path, task="detect") results[k] = model.train( data=dataset_yaml, epochs=epochs, batch=batch, project=project, name=f"fold_{k + 1}" ) # include any additional train arguments -
Puoi anche usare la funzione autosplit di Ultralytics per suddividere automaticamente il dataset:
from ultralytics.data.split import autosplit

# Suddividi automaticamente il dataset in train/val/test
autosplit(path="path/to/images", weights=(0.8, 0.2, 0.0), annotated_only=True)
Conclusione#
In questa guida abbiamo esaminato il processo di utilizzo della validazione incrociata K-Fold per addestrare il modello YOLO di rilevamento degli oggetti. Abbiamo imparato a suddividere il gruppo di training e validazione in K partizioni e a usare la tabella dei rapporti generata per verificare il bilanciamento delle classi dopo una suddivisione casuale.
Abbiamo anche esaminato la procedura per creare DataFrame di report e visualizzare le suddivisioni dei dati e la distribuzione delle etichette tra le diverse suddivisioni, ottenendo una panoramica chiara della struttura dei set di addestramento e convalida.
Facoltativamente, abbiamo salvato i record per consultarli in futuro, una possibilità particolarmente utile nei progetti su larga scala o durante la risoluzione di problemi relativi alle prestazioni del modello.
Infine, abbiamo implementato l'addestramento vero e proprio del modello usando ogni suddivisione in un ciclo e salvando i risultati dell'addestramento per analisi e confronti successivi.
Questa tecnica di validazione incrociata K-Fold è un metodo efficace per sfruttare al meglio i dati disponibili e contribuisce a garantire prestazioni affidabili e coerenti del modello tra diversi sottoinsiemi di dati. Il risultato è un modello più generalizzabile e affidabile, meno soggetto a overfitting su specifici pattern dei dati.
Ricorda che, anche se in questa guida abbiamo usato YOLO, questi passaggi sono perlopiù applicabili anche ad altri modelli di machine learning. Comprendendo questi passaggi, puoi applicare efficacemente la validazione incrociata ai tuoi progetti di machine learning.
Domande frequenti#
La validazione incrociata K-Fold è una tecnica che divide il dataset in 'k' sottoinsiemi (fold) per valutare le prestazioni del modello in modo più affidabile. Ogni fold funge sia da dati di validazione che da dati di training. Nel rilevamento degli oggetti, la validazione incrociata K-Fold contribuisce a garantire che le prestazioni del tuo modello Ultralytics YOLO siano robuste e generalizzabili tra diverse suddivisioni dei dati, migliorandone l'affidabilità. Per istruzioni dettagliate sulla configurazione della validazione incrociata K-Fold con Ultralytics YOLO, consulta Validazione incrociata K-Fold con Ultralytics.
Per implementare la validazione incrociata K-Fold con Ultralytics YOLO, segui questi passaggi:
- Verifica che le annotazioni siano nel formato di rilevamento YOLO.
- Usa librerie Python come
sklearn,pandasepyyaml. - Crea vettori di caratteristiche a partire dal dataset.
- Suddividi il dataset usando
KFolddasklearn.model_selection. - Addestra il modello YOLO su ogni suddivisione.
Per una guida completa, consulta la sezione Suddivisione del dataset K-Fold nella nostra documentazione.
Il flusso di lavoro descritto in questa guida è pensato per il formato di rilevamento YOLO, ma lo stesso approccio si adatta a ogni task YOLO: il task cambia il modo in cui componi i fold, non l'utilità della validazione incrociata:
Attività Progettazione dei fold detectSuddividi a livello di immagine, bilanciando la distribuzione di oggetti e classi tra i fold. Mantieni le immagini correlate (stesso paziente, sequenza video, telecamera o sito) all'interno di un unico fold. segmentUsa la stessa strategia a livello di immagine del rilevamento, preservando inoltre la copertura delle maschere e delle classi in ogni fold. classifyPreferisci fold stratificati per mantenere bilanciate le frequenze delle classi tra training e validazione. poseSuddividi per soggetto o sequenza, in modo che la stessa persona o lo stesso animale non compaia mai su entrambi i lati di un fold. obbSuddividi a livello di immagine, mantenendo insieme le tessere o i ritagli della stessa scena, un aspetto particolarmente importante per le immagini aeree. Qualunque sia il compito, evita che campioni quasi duplicati o correlati finiscano in fold opposti: questo tipo di data leakage gonfia le metriche di convalida ben oltre i risultati che il modello otterrà in produzione.
Ultralytics YOLO offre un rilevamento degli oggetti all'avanguardia in tempo reale, con elevata accuratezza ed efficienza. È versatile e supporta diverse attività di visione artificiale, tra cui rilevamento, segmentazione delle istanze, segmentazione semantica e classificazione. Inoltre, si integra con strumenti come Ultralytics Platform per addestrare e distribuire modelli senza codice.
Le annotazioni devono seguire il formato di rilevamento YOLO. Ogni file di annotazione deve indicare la classe dell'oggetto e le coordinate del relativo riquadro di delimitazione nell'immagine. Il formato YOLO garantisce un'elaborazione dei dati semplificata e standardizzata per l'addestramento dei modelli di rilevamento degli oggetti. Per maggiori informazioni sulla formattazione corretta delle annotazioni, consulta la guida al formato di rilevamento YOLO.
Sì, puoi usare la validazione incrociata K-Fold con qualsiasi dataset personalizzato, purché le annotazioni siano nel formato di rilevamento YOLO. Sostituisci i percorsi del dataset e le etichette di classe con quelli specifici del tuo dataset personalizzato. Questa flessibilità consente a qualsiasi progetto di rilevamento degli oggetti di trarre vantaggio da una valutazione robusta del modello tramite la validazione incrociata K-Fold. Per un esempio pratico, consulta la sezione Generazione dei vettori di caratteristiche.


Commenti21
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
jingieboy
does this work with yolov8-cls? if so how would the folder structure look like? how are the data splits
 Glenn JocherUltralytics(modificato)
Yes—K‑Fold works the same for classification; use the standard ImageNet-style layout per fold, and train each fold separately (YOLO infers classes from folder names). For YOLO26 (recommended) you can do:
dataset/
  split_1/
    train/
      class_a/ ...
      class_b/ ...
    val/
      class_a/ ...
      class_b/ ...
  split_2/
    train/...
    val/...
  ...
from ultralytics import YOLO weights = "yolo26n-cls.pt" # swap to 'yolov8n-cls.pt' if you prefer YOLOv8 splits = ["dataset/split_1", "dataset/split_2", "dataset/split_3"] for d in splits: model = YOLO(weights) model.train(data=d, epochs=20, batch=16) # d must contain 'train/' and 'val/' subfoldersFor building folds, use
StratifiedKFoldon image-level labels derived from parent folder names to keep class balance, or use the random splitter shown in the autosplit reference if stratification isn’t required. Classification usage details are in the classification task docs.thank you for this! I have also notice that everytime I run model.val(), the accuracies and confusion matrix values are slightly different this time. Is this normal or during evaluation, there is a small randomness when calling the function.
- Glenn JocherUltralytics
@jingieboy minor variations can occur from non-deterministic CUDA ops or multi-threading; validation itself doesn’t add randomness by default—set seeds and force deterministic ops to lock results:
import random, numpy as np, torch

seed = 0
random.seed(seed); np.random.seed(seed); torch.manual_seed(seed)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False

model.val()  # run evaluation
If differences are still large, double-check your eval args in the validation mode docs.
Nehasq
Hi, I am applying K-fold validation using the leave-one-out technique. My dataset consists of a single class and includes 21 images in total. For each split, I use 20 images for training and 1 image for testing. I am implementing the leave-one-out technique with the code above, setting ksplit=21.
I am not using a separate validation dataset, only training and testing data. Here is the code I am using:
results = {}
Define additional arguments here
batch = 16 project = "kfold_demo" epochs = 100
for k in range(ksplit): dataset_yaml = ds_yamls[k] model = YOLO(weights_path, task="detect") model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project) # Include any train arguments results[k] = model.metrics # Save output metrics for further analysis
In my data.yaml file, I have provided the validation path as the test set. When it trains and validates on the "1 test data," does this mean the model is being tested on data it has never seen during training? This is my first point of confusion.
my data.yaml file for each split looks like this: names:
- pothole path: ../ 2024-12-10_21-Fold_Cross-val/split_1 train: train val: test
My second question is about calculating the final performance. When I ran the above code, it calculated scores for each individual split. Do I need to calculate the final performance metrics manually, or is there any functionality in YOLOv8 to compute the aggregated performance automatically?
- Glenn JocherUltralytics
@Nehasq to address your first question, yes, the model is being tested on unseen data during each split, as the test set (1 image) is excluded from training and only used for validation. Regarding your second question, YOLO does not automatically aggregate metrics across splits. You need to compute the final performance metrics manually by averaging the results from all splits. For reference, you can review the K-Fold Cross Validation guide.
Thanks for your reply. I understand your point. So, are you saying that, for example, in my case, where I have 21 scores (precision, recall, etc.), I should simply add all the precision values together and divide the sum by 21 to get the final precision of the model? Is that correct?
Also, in y case of 20 images( training) and 1 images for test, what batch size would you suggest?
- Glenn JocherUltralytics
Yes, to calculate the final precision (or any metric), you average the values across all splits, i.e., sum all precision scores and divide by the number of splits (21 in your case). As for the batch size, given your small dataset, you could keep it low (e.g., 1 or 2) to ensure efficient utilization of the data while avoiding overfitting.
Thanks, that really helps! With a batch size of 1, I am keeping the epochs at 10. Should it be fewer? Also, to check for overfitting, I need to review the result graphs for each split. However, I can't definitively determine if it is overfitting since each split is separate, right?
- Glenn JocherUltralytics
Keeping epochs at 10 with a batch size of 1 is reasonable given your small dataset size. To check for overfitting, reviewing result graphs from each split can help, but overfitting may be harder to detect since each split involves different training and test data. Consider comparing trends across splits for consistent insights. For further details, you can reference the K-Fold Cross Validation guide.
semyon-v-dot
After the loop:
for ext in supported_extensions:
    images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))
Should be this line of code:
images = sorted(images)For
imagesmatching withlabelslist:labels = sorted(dataset_path.rglob("*labels/*.txt"))Otherwise the script creates background images because some images missing their labels.
- Glenn JocherUltralytics
@semyon-v-dot thank you for your suggestion. Sorting the
imageslist after extending it with supported extensions is a good practice to ensure alignment with thelabelslist. This helps prevent issues with missing labels.1
 sangeun jo
K-폴드 데이터 세트 분할 4번에서
images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))이 코드를images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))로 변환해야 작동했습니다.- Glenn JocherUltralytics
@sangeun-jo thank you for pointing that out. Your modification to
images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))is indeed correct and ensures the code works as intended. If you have any further questions or need additional assistance, feel free to ask!
kh-diab
is it usefult to use this k fold approach when I just have one class only but my issue is the class is detected as background or vice versa as per the attached Confusion matrix
- Glenn JocherUltralytics
@kh-diab using K-Fold Cross Validation can still be beneficial even with a single class. It helps ensure that your model's performance is robust and not overly dependent on a particular subset of the data. This can be particularly useful if you're experiencing issues with class detection accuracy, as it allows you to validate the model's performance across multiple splits and identify any inconsistencies. If your class is being detected as background or vice versa, K-Fold Cross Validation can help diagnose whether this issue is consistent across different data splits or specific to certain subsets. For more details, you can refer to our guide on K-Fold Cross Validation: https://docs.ultralytics.com/guides/kfold-cross-validation/.
alexander-sony
Good guide, consider adding it in a colab notebook.
In section "Train YOLO using K-Fold Data Splits", model should be re-initialized foe every k, i.e. it should be inside the for-loop: for k in range(ksplit).
- Glenn JocherUltralytics
@alexander-sony thank you for your feedback and suggestion! 😊
You're absolutely right about re-initializing the model within the loop for each fold to ensure a fresh start for every training iteration. This can help avoid any potential carryover effects from previous folds. Here's the corrected code snippet for the training section:
from ultralytics import YOLO

weights_path = "path/to/weights.pt"
results = {}

# Define your additional arguments here
batch = 16
project = "kfold_demo"
epochs = 100

for k in range(ksplit):
    model = YOLO(weights_path, task="detect")  # Re-initialize the model inside the loop
    dataset_yaml = ds_yamls[k]
    model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project)  # include any train arguments
    results[k] = model.metrics  # save output metrics for further analysis
Regarding your suggestion to add this guide to a Colab notebook, that's a fantastic idea! It would make the process more interactive and accessible for users. We'll consider creating a Colab version of this guide in the future.
For more details on K-Fold Cross Validation, you can refer to our comprehensive guide.
Thanks again for your valuable input! If you have any more suggestions or questions, feel free to share. Happy coding! 🚀
Likhith-Sugganahalli
@alexander-sony
woudnt that be a new model trained on each split, giving us n different models trained on 1/nth of the dataset?
 Fazri Gading
Is there any way to implement Stratified K-Fold Cross Validation with YOLOv8?
 Paula DerrengerUltralytics
Yes, you can implement Stratified K-Fold Cross Validation with YOLOv8! Stratified K-Fold ensures that each fold has a similar distribution of class labels, which can be particularly useful for imbalanced datasets.
To achieve this, you can use
StratifiedKFoldfromsklearn.model_selectioninstead ofKFold. Here's a brief example of how to modify the K-Fold implementation:from sklearn.model_selection import StratifiedKFold # Assuming labels_df is your DataFrame with class counts ksplit = 5 skf = StratifiedKFold(n_splits=ksplit, shuffle=True, random_state=20) # Generate stratified splits kfolds = list(skf.split(labels_df, labels_df.idxmax(axis=1))) # The rest of the process remains the sameFor a detailed guide on K-Fold Cross Validation, please refer to the Ultralytics documentation. If you have any more questions, feel free to ask! 😊
1