Distillazione della conoscenza
Guida rapida#
Addestra un modello studente più piccolo con la guida di un modello insegnante più grande aggiungendo l'argomento distill_model:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
Che cos'è la distillazione della conoscenza?#
La distillazione della conoscenza trasferisce le conoscenze da un modello insegnante grande e accurato a un modello studente più piccolo. Lo studente impara a imitare le rappresentazioni interne delle caratteristiche dell'insegnante e spesso raggiunge un'accuratezza maggiore rispetto all'addestramento da zero.
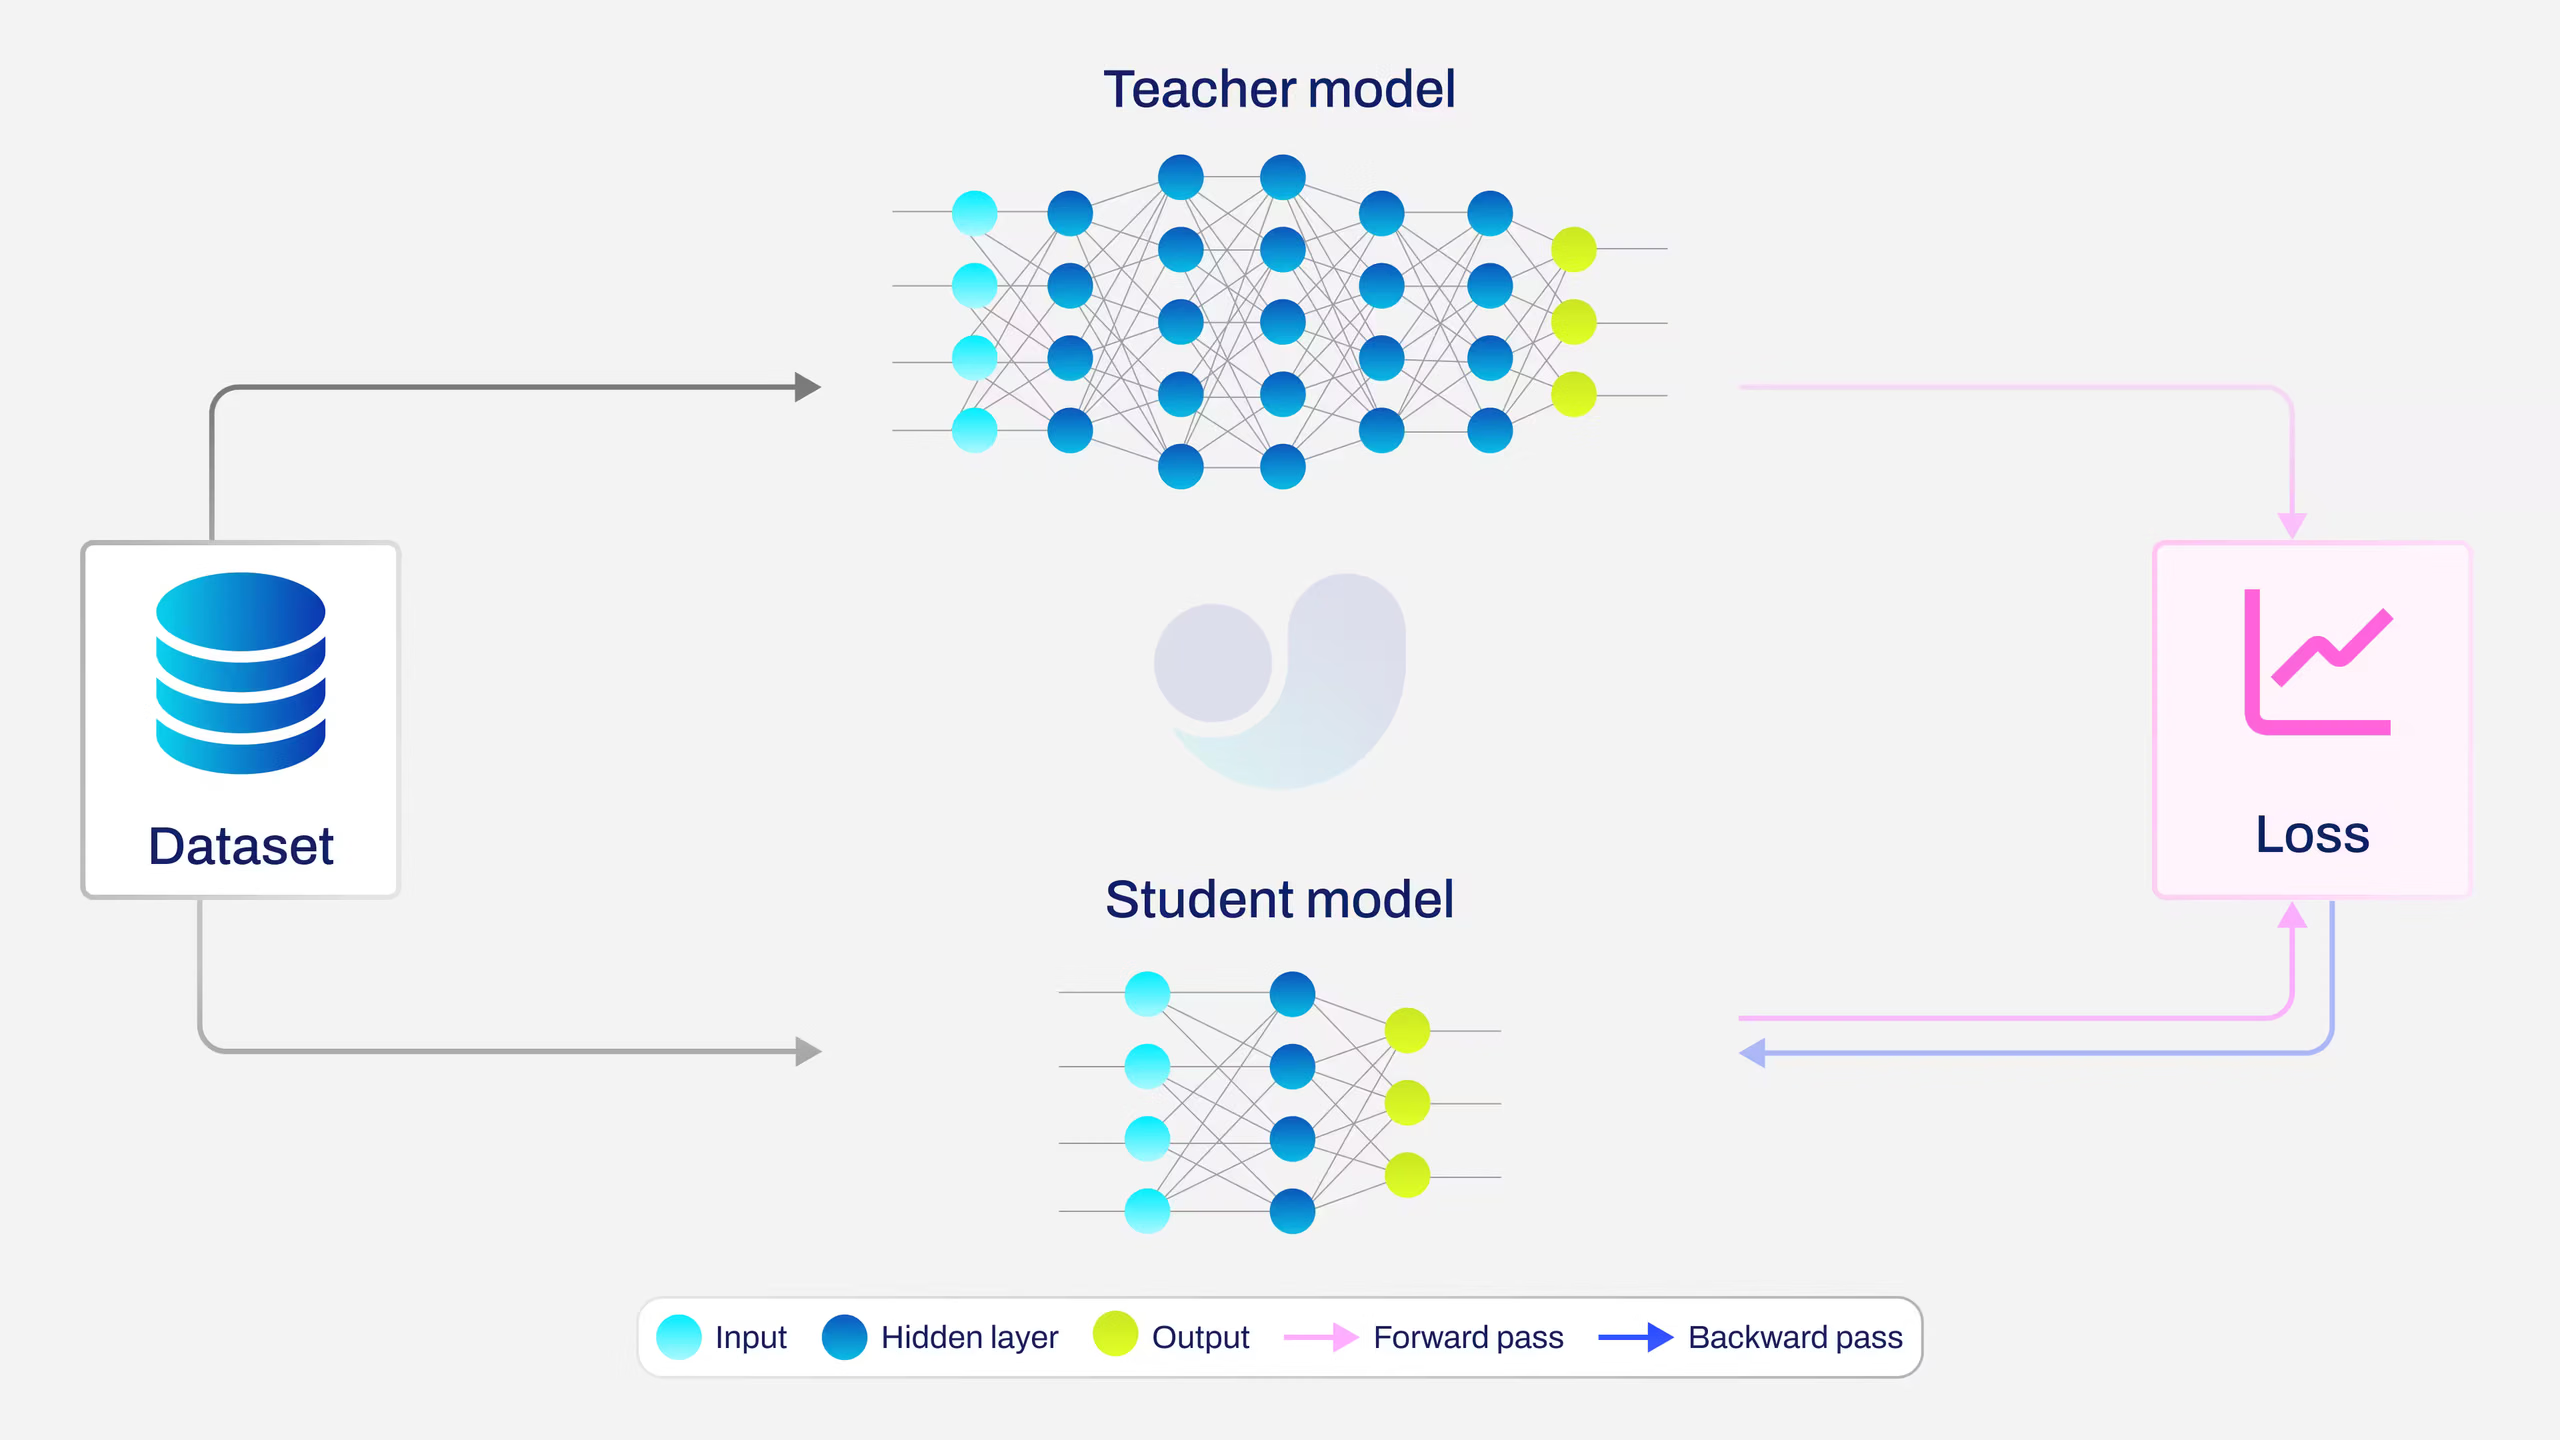
Usa la distillazione quando:
- Ti serve un modello più piccolo e veloce da distribuire
- Hai un modello insegnante ad alta accuratezza addestrato sugli stessi dati
- Vuoi ottenere un'accuratezza migliore rispetto all'addestramento standard
La distillazione della conoscenza è implementata per le attività detect, segment, pose e obb. Per ora, solo detect è stato verificato sperimentalmente per i miglioramenti di accuratezza.
Prestazioni#
La distillazione della conoscenza migliora la mAP dello studente per tutta la famiglia YOLO26 su COCO, senza costi aggiuntivi in fase di inferenza. La tabella seguente confronta i modelli YOLO26 standard (baseline) con gli stessi modelli addestrati tramite distillazione dal rispettivo insegnante consigliato.
| Modello | dimensione (pixel) | mAPval50-95 baseline | mAPval50-95 distillato | mAPval50-95 (e2e) baseline | mAPval50-95 (e2e) distillato |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- I valori mAPval si riferiscono a un singolo modello e a una singola scala sul dataset COCO val2017.
Riproduci una riga distillata conyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0; aggiunginms=Falseper la colonna e2e. - I valori e2e usano il percorso di inferenza senza NMS (
nms=False); i valori non e2e usano la post-elaborazione NMS predefinita (nms=None). Per i dettagli, consulta Rilevamento end-to-end.
Prerequisiti#
Prima di iniziare, assicurati di soddisfare i seguenti requisiti:
- Modello insegnante addestrato: un checkpoint
.ptdella stessa famiglia YOLO del modello studente. - Attività corrispondente: usa un insegnante per la stessa attività dello studente e addestralo su dati pertinenti.
- Risorse GPU: memoria sufficiente per contenere entrambi i modelli; l'insegnante esegue solo la propagazione in avanti, senza gradienti né stato dell'ottimizzatore.
Coppie di modelli consigliate#
| Studente | Insegnante consigliato |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
La distillazione tra famiglie diverse (ad es. un insegnante YOLO11 con uno studente YOLO26) non è supportata.
Parametri chiave#
| Parametro | Tipo | Predefinito | Descrizione |
|---|---|---|---|
distill_model | str | None | Percorso del file del modello insegnante (ad es. yolo26x.pt). Impostando questo parametro abiliti la distillazione della conoscenza. |
dis | float | 6.0 | Peso della funzione di perdita di distillazione. Determina quanto questa perdita contribuisce alla perdita totale di addestramento. |
Come funziona#
- Il modello insegnante rimane congelato in modalità
evaled esegue l'inferenza su ogni batch - Il modello studente viene addestrato con le perdite standard dell'attività, oltre alla guida della distillazione
- Le caratteristiche vengono estratte da entrambi i modelli nei tre livelli neck che alimentano la testa della famiglia Detect
- Un proiettore composto da due convoluzioni 1×1 con ReLU allinea ciascuna mappa delle caratteristiche dello studente ai canali dell'insegnante
- Una perdita L2 ponderata per punteggio confronta le caratteristiche proiettate dello studente con quelle dell'insegnante, ponderandole in base alla confidenza di classificazione dell'insegnante
- La perdita di distillazione si combina con le perdite standard utilizzando il peso
dis
Supporto delle attività#
L'implementazione della distillazione estrae le caratteristiche dai tre livelli neck che alimentano la testa della famiglia Detect del modello. Poiché le teste segment, pose e obb ereditano la stessa architettura Detect, la distillazione è tecnicamente compatibile anche con queste attività.
Classificazione, segmentazione semantica, stima della profondità e RT-DETR non utilizzano una testa compatibile della famiglia Detect e non sono supportati.
Solo detect è stato sottoposto a benchmark e verificato sperimentalmente. Puoi eseguire la distillazione per segment, pose o obb, ma i miglioramenti di accuratezza per queste attività non sono ancora stati convalidati.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")Addestramento#
Addestramento di base#
L'addestramento con distillazione è identico a quello standard. Specifica il percorso distill_model per abilitarla:
from ultralytics import YOLO

# Carica un modello studente
student = YOLO("yolo26m.pt")

# Addestra con la distillazione della conoscenza da un modello insegnante più grande
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Regolare il peso della perdita di distillazione#
Il parametro dis (predefinito: 6.0) controlla il contributo della perdita di distillazione:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Riprendere l'addestramento con distillazione#
L'addestramento con distillazione supporta la ripresa dai checkpoint. Il modello insegnante viene ricreato automaticamente a partire dal percorso distill_model registrato nel checkpoint:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
Output dell'addestramento#
Quando la distillazione è abilitata, nei log di addestramento compare una colonna aggiuntiva dis_loss:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
Il modello esportato contiene solo i pesi dello studente: le dimensioni del file e la velocità di inferenza corrispondono a quelle di un modello studente addestrato normalmente.
Domande frequenti#
- Verifica che l'insegnante e lo studente appartengano alla stessa generazione YOLO
- Controlla che il percorso
distill_modelsia corretto e che il file venga caricato - Prova ad aumentare
disse il valore della perdita è molto piccolo - Assicurati che il modello insegnante sia addestrato sullo stesso dataset
Aggiungi il parametro
distill_model: tutto il resto funziona allo stesso modo. Durante l'addestramento viene calcolata una loss di distillazione aggiuntiva, ma il modello salvato è un normale modello YOLO, senza sovraccarico.Sì. L'insegnante aggiunge una propagazione in avanti per ogni batch, quindi i costi aggiuntivi in termini di tempo e memoria dipendono dalla coppia insegnante/studente. L'insegnante opera in modalità
eval, senza gradienti né stato dell'ottimizzatore.La distillazione della conoscenza funziona con le attività detect, segment, pose e obb, perché distilla le caratteristiche dai tre livelli neck che alimentano la testa della famiglia Detect. Classify, semantic, depth e RT-DETR non sono supportati.
Solo detect è stato verificato sperimentalmente per quanto riguarda i miglioramenti dell'accuratezza. Segmentazione, pose e OBB sono tecnicamente compatibili, ma non sono ancora stati sottoposti a benchmark.
L'insegnante e lo studente devono appartenere alla stessa famiglia YOLO (ad es. YOLOv8, YOLO11 o YOLO26). La distillazione tra famiglie diverse (ad es. un insegnante YOLO11 con uno studente YOLO26) non è supportata.


Commenti5
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
CharbelMsallem
Cool! If same dataset, can the class mapping or the number of classes differ from parent to student but using the same images and split?
I mean classes of student be a subset of parent classes
 Glenn JocherUltralytics
Same images/splits can be reused, but for the supported distillation path the teacher and student should use the same task and
data.yamlclass configuration (nc,names, and class indices), per the Knowledge Distillation guide. If the student should learn only a subset, create a subset dataset/YAML with labels remapped to contiguous IDs and train or fine-tune a teacher on that same subset/mapping before using it asdistill_model.okat thanks!
andyrey
Very interesting and useful, thank you!