Guida rapida: Seeed Studio reCamera con Ultralytics YOLO26
reCamera è stata presentata alla community AI durante YOLO Vision 2024 (YV24), l'evento ibrido annuale di Ultralytics. È progettata principalmente per le applicazioni edge AI, offrendo elaborazione AI on-device e una distribuzione semplice.
Grazie al supporto per diverse configurazioni hardware e alle risorse open source, è adatta alla prototipazione e alla distribuzione di soluzioni di computer vision all'edge.
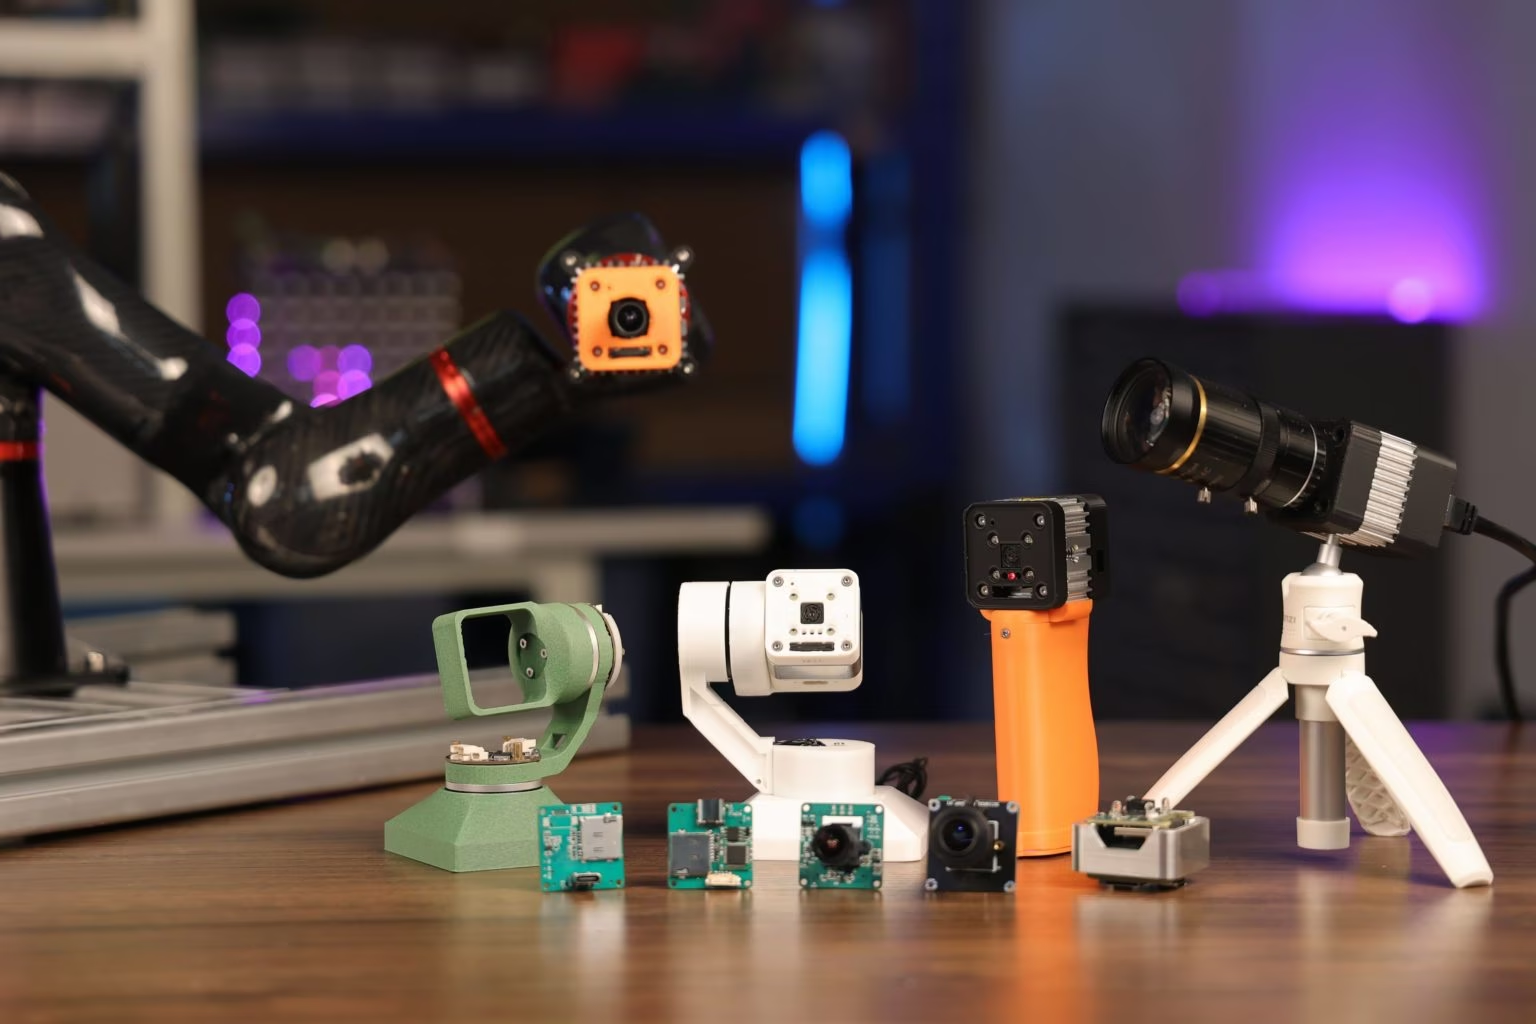
Perché scegliere reCamera?#
La serie reCamera è progettata appositamente per le applicazioni edge AI e risponde alle esigenze degli sviluppatori. Le sue funzionalità principali includono:
-
Prestazioni basate su RISC-V: il processore SG200X, basato sull'architettura RISC-V, è il cuore del dispositivo e offre prestazioni efficienti per le attività edge AI. Con una capacità di esecuzione di 1 trilione di operazioni al secondo (1 TOPS), è in grado di gestire attività come il rilevamento degli oggetti in tempo reale.
-
Tecnologie video ottimizzate: supporta standard avanzati di compressione video, tra cui H.264 e H.265, per ridurre i requisiti di archiviazione e larghezza di banda senza compromettere la qualità. Funzionalità come l'imaging HDR, la riduzione del rumore 3D e la correzione dell'obiettivo mantengono la qualità delle immagini anche in ambienti difficili.
-
Doppia elaborazione efficiente dal punto di vista energetico: mentre SG200X gestisce attività IA complesse, un microcontrollore a 8 bit più piccolo si occupa delle operazioni più semplici per risparmiare energia, rendendo reCamera ideale per configurazioni alimentate a batteria o a basso consumo.
-
Design modulare e aggiornabile: reCamera è realizzata con una struttura modulare composta da tre componenti principali: scheda core, scheda del sensore e scheda base. Questo design consente agli sviluppatori di sostituire o aggiornare i componenti man mano che i progetti evolvono.
Configurazione rapida dell'hardware reCamera#
Segui la pagina Introduzione a reCamera e seleziona il tuo dispositivo (ad esempio reCamera 2002 Series, Gimbal o HQ POE) per aprire la relativa Guida introduttiva e configurare il dispositivo, ad esempio collegandolo a una rete e accedendo all'interfaccia web di Node-RED per visualizzare rapidamente i risultati del rilevamento.
Inferenza con modelli YOLO preinstallati#
reCamera include quattro modelli Ultralytics YOLO preinstallati e puoi scegliere il modello che preferisci nella dashboard di Node-RED.
Passaggio 1: se hai collegato reCamera a una rete, inserisci il suo indirizzo IP in un browser web per aprire la dashboard di Node-RED. Se hai collegato reCamera a un PC tramite USB, puoi inserire 192.168.42.1. Il modello di rilevamento viene caricato per impostazione predefinita.
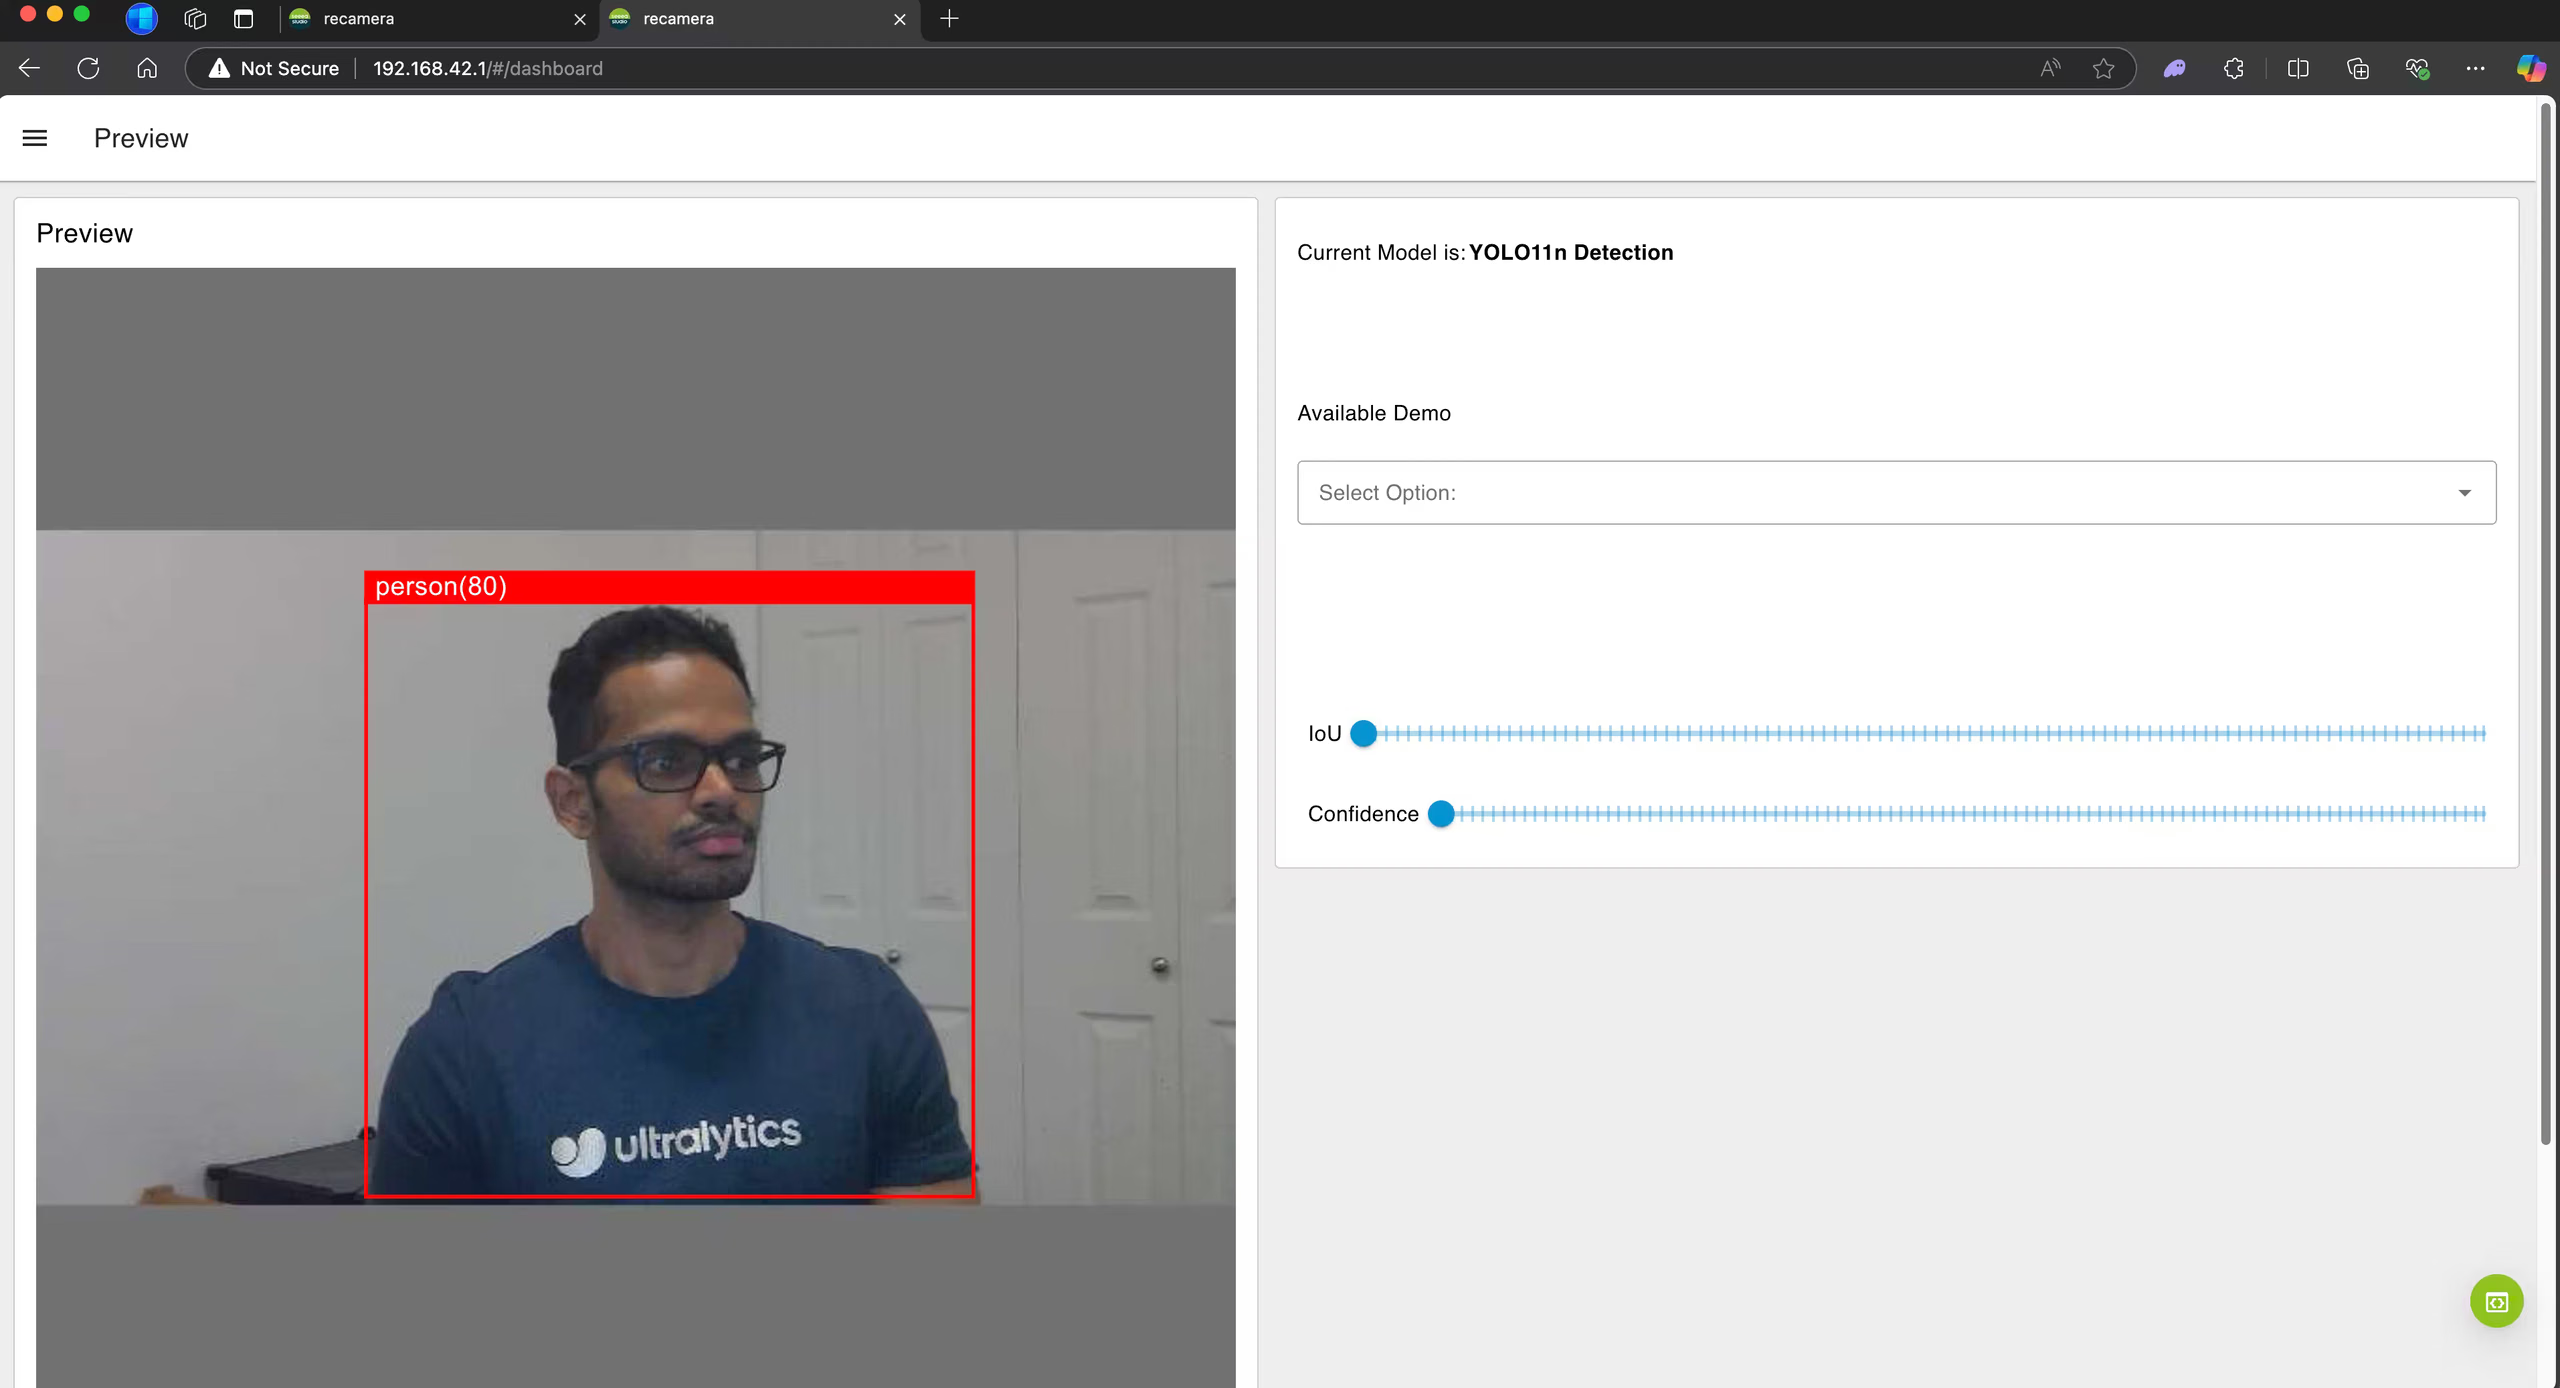
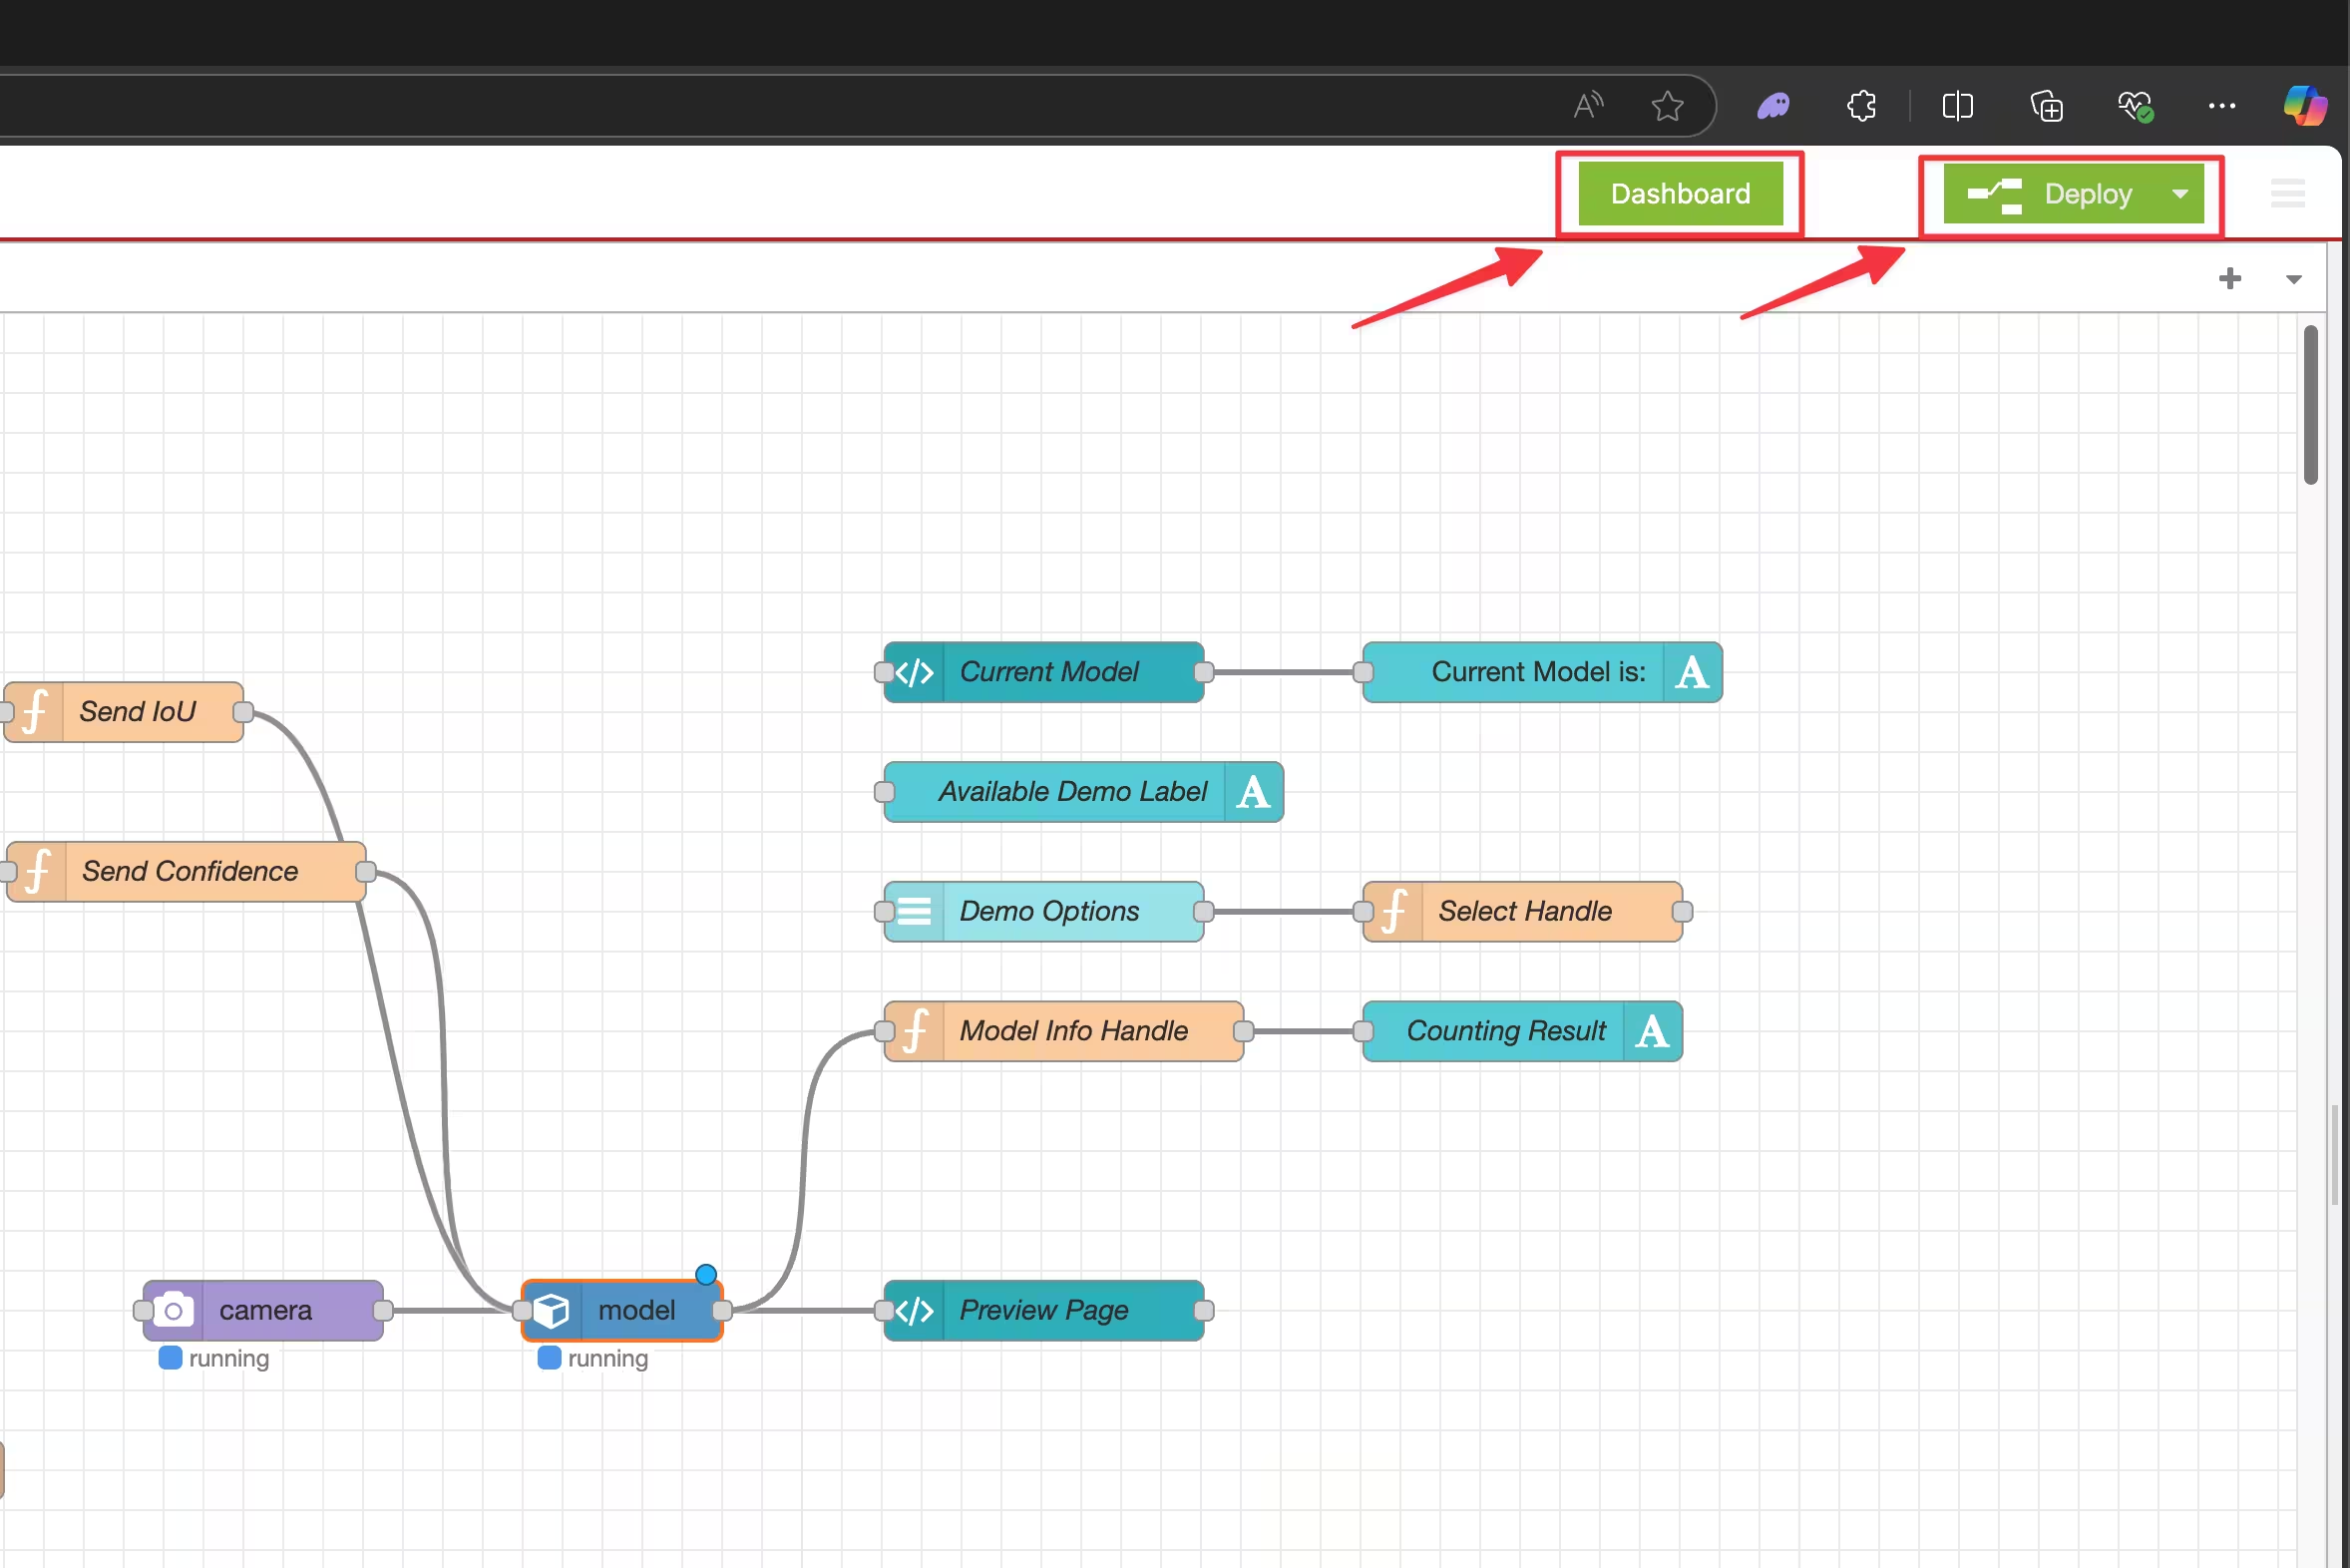
Passaggio 2: fai clic sul cerchio verde nell'angolo in basso a destra per accedere all'editor dei flussi di Node-RED.
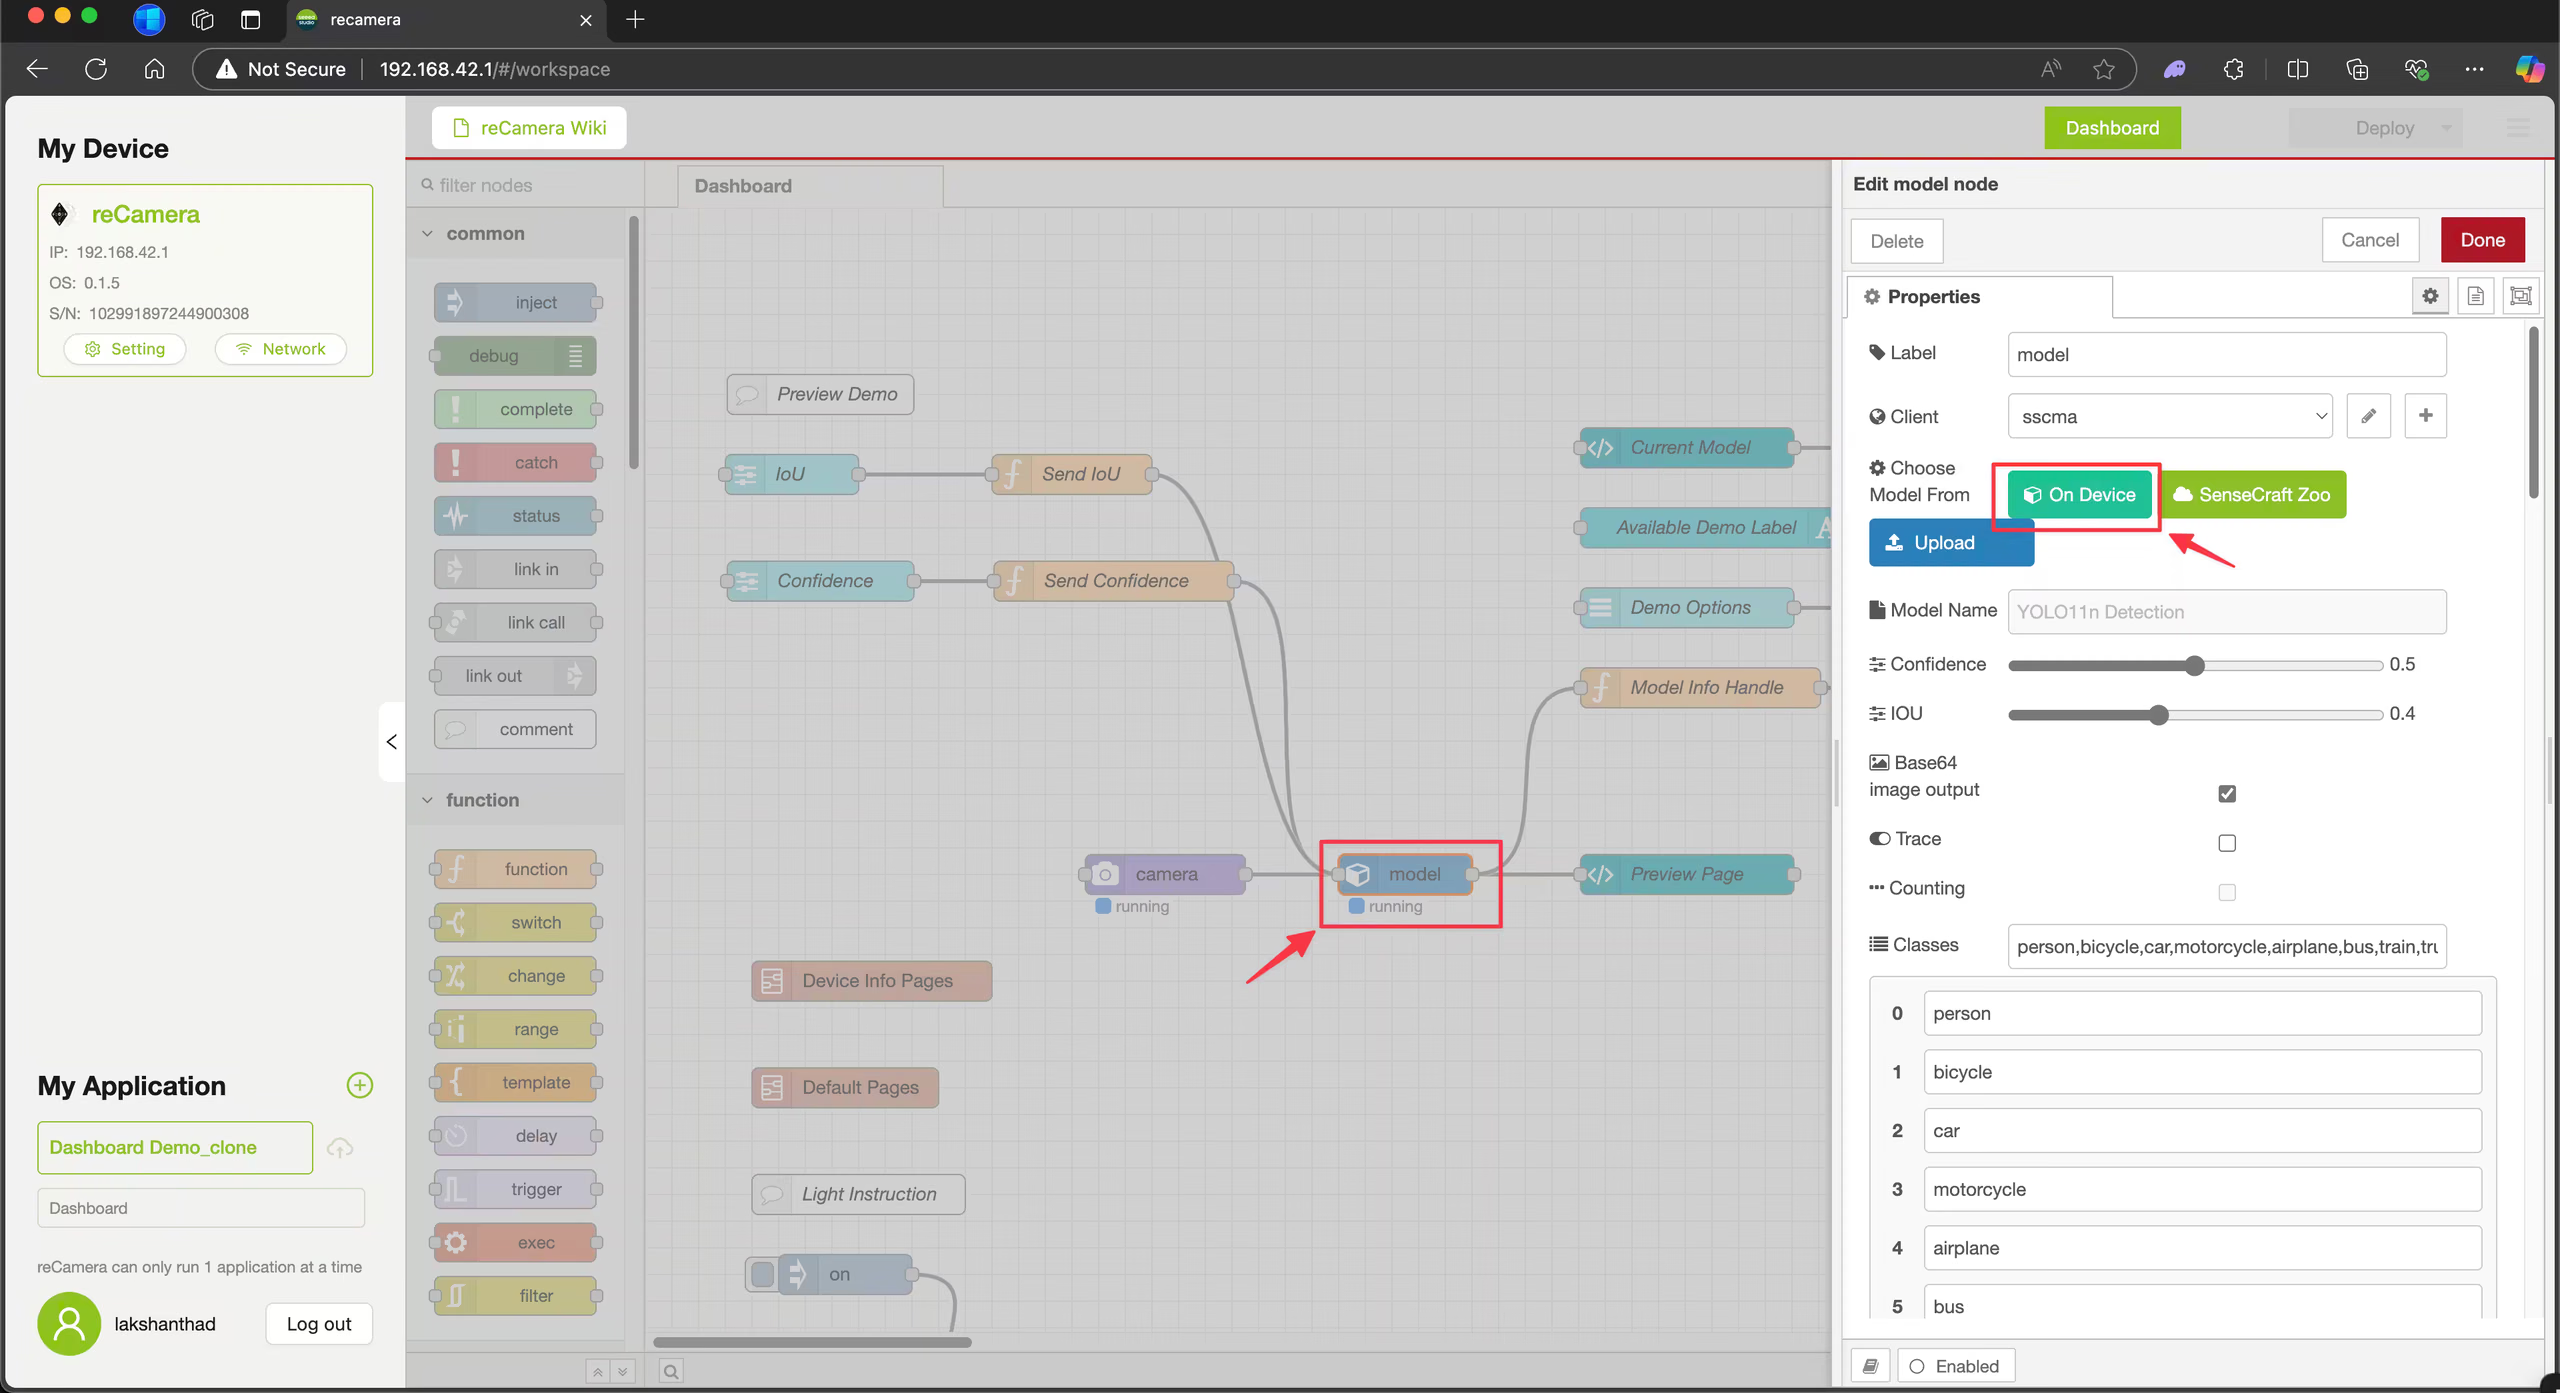
Passaggio 3: fai clic sul nodo model, quindi su On Device.
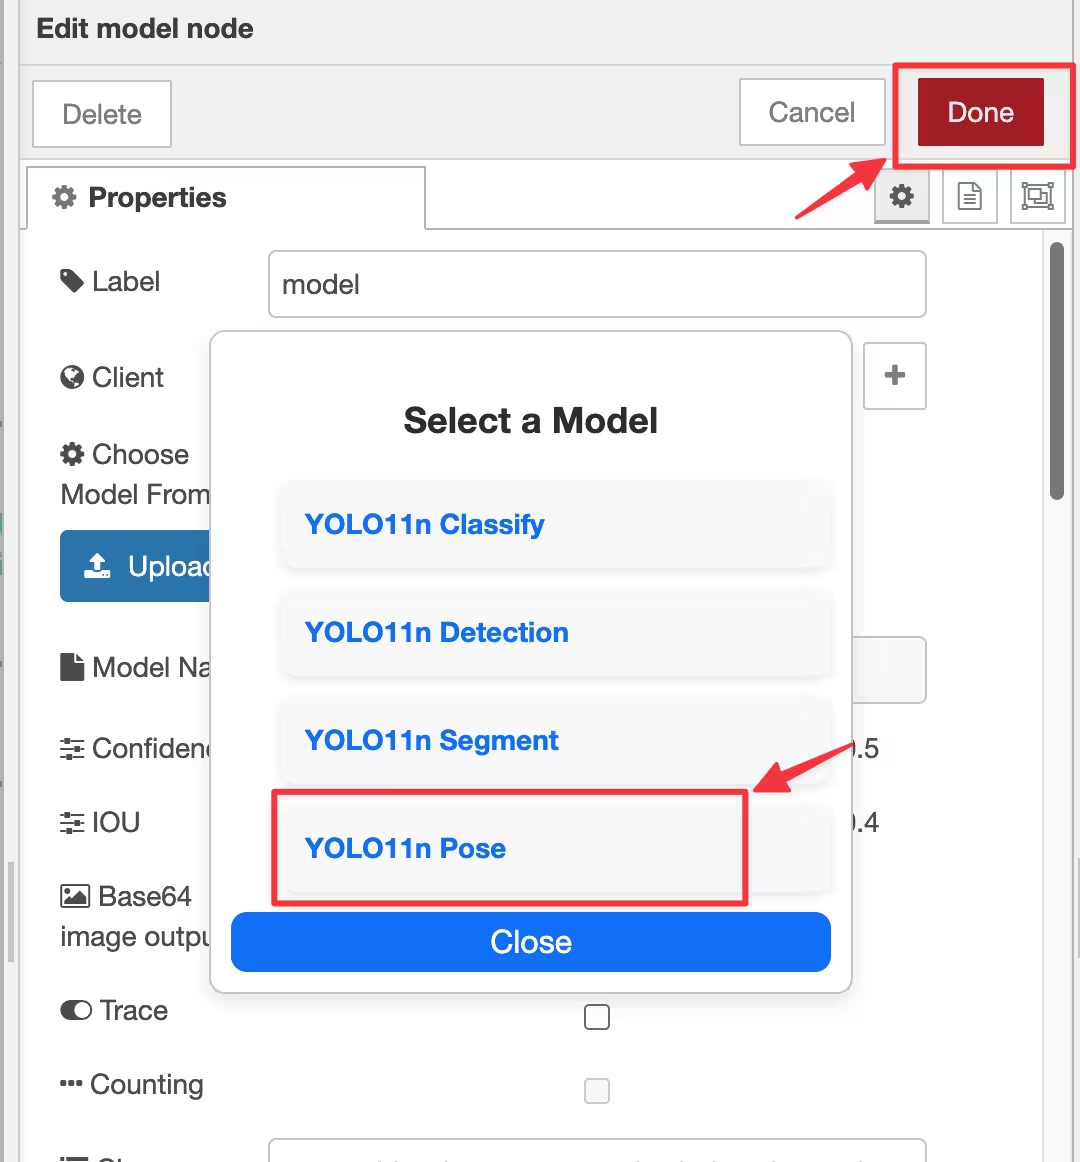
Passaggio 4: scegli uno dei quattro modelli preinstallati e fai clic su Done. In questo esempio viene selezionato il modello di stima della posa.
Passaggio 5: fai clic su Deploy e, una volta completata la distribuzione, fai clic su Dashboard.
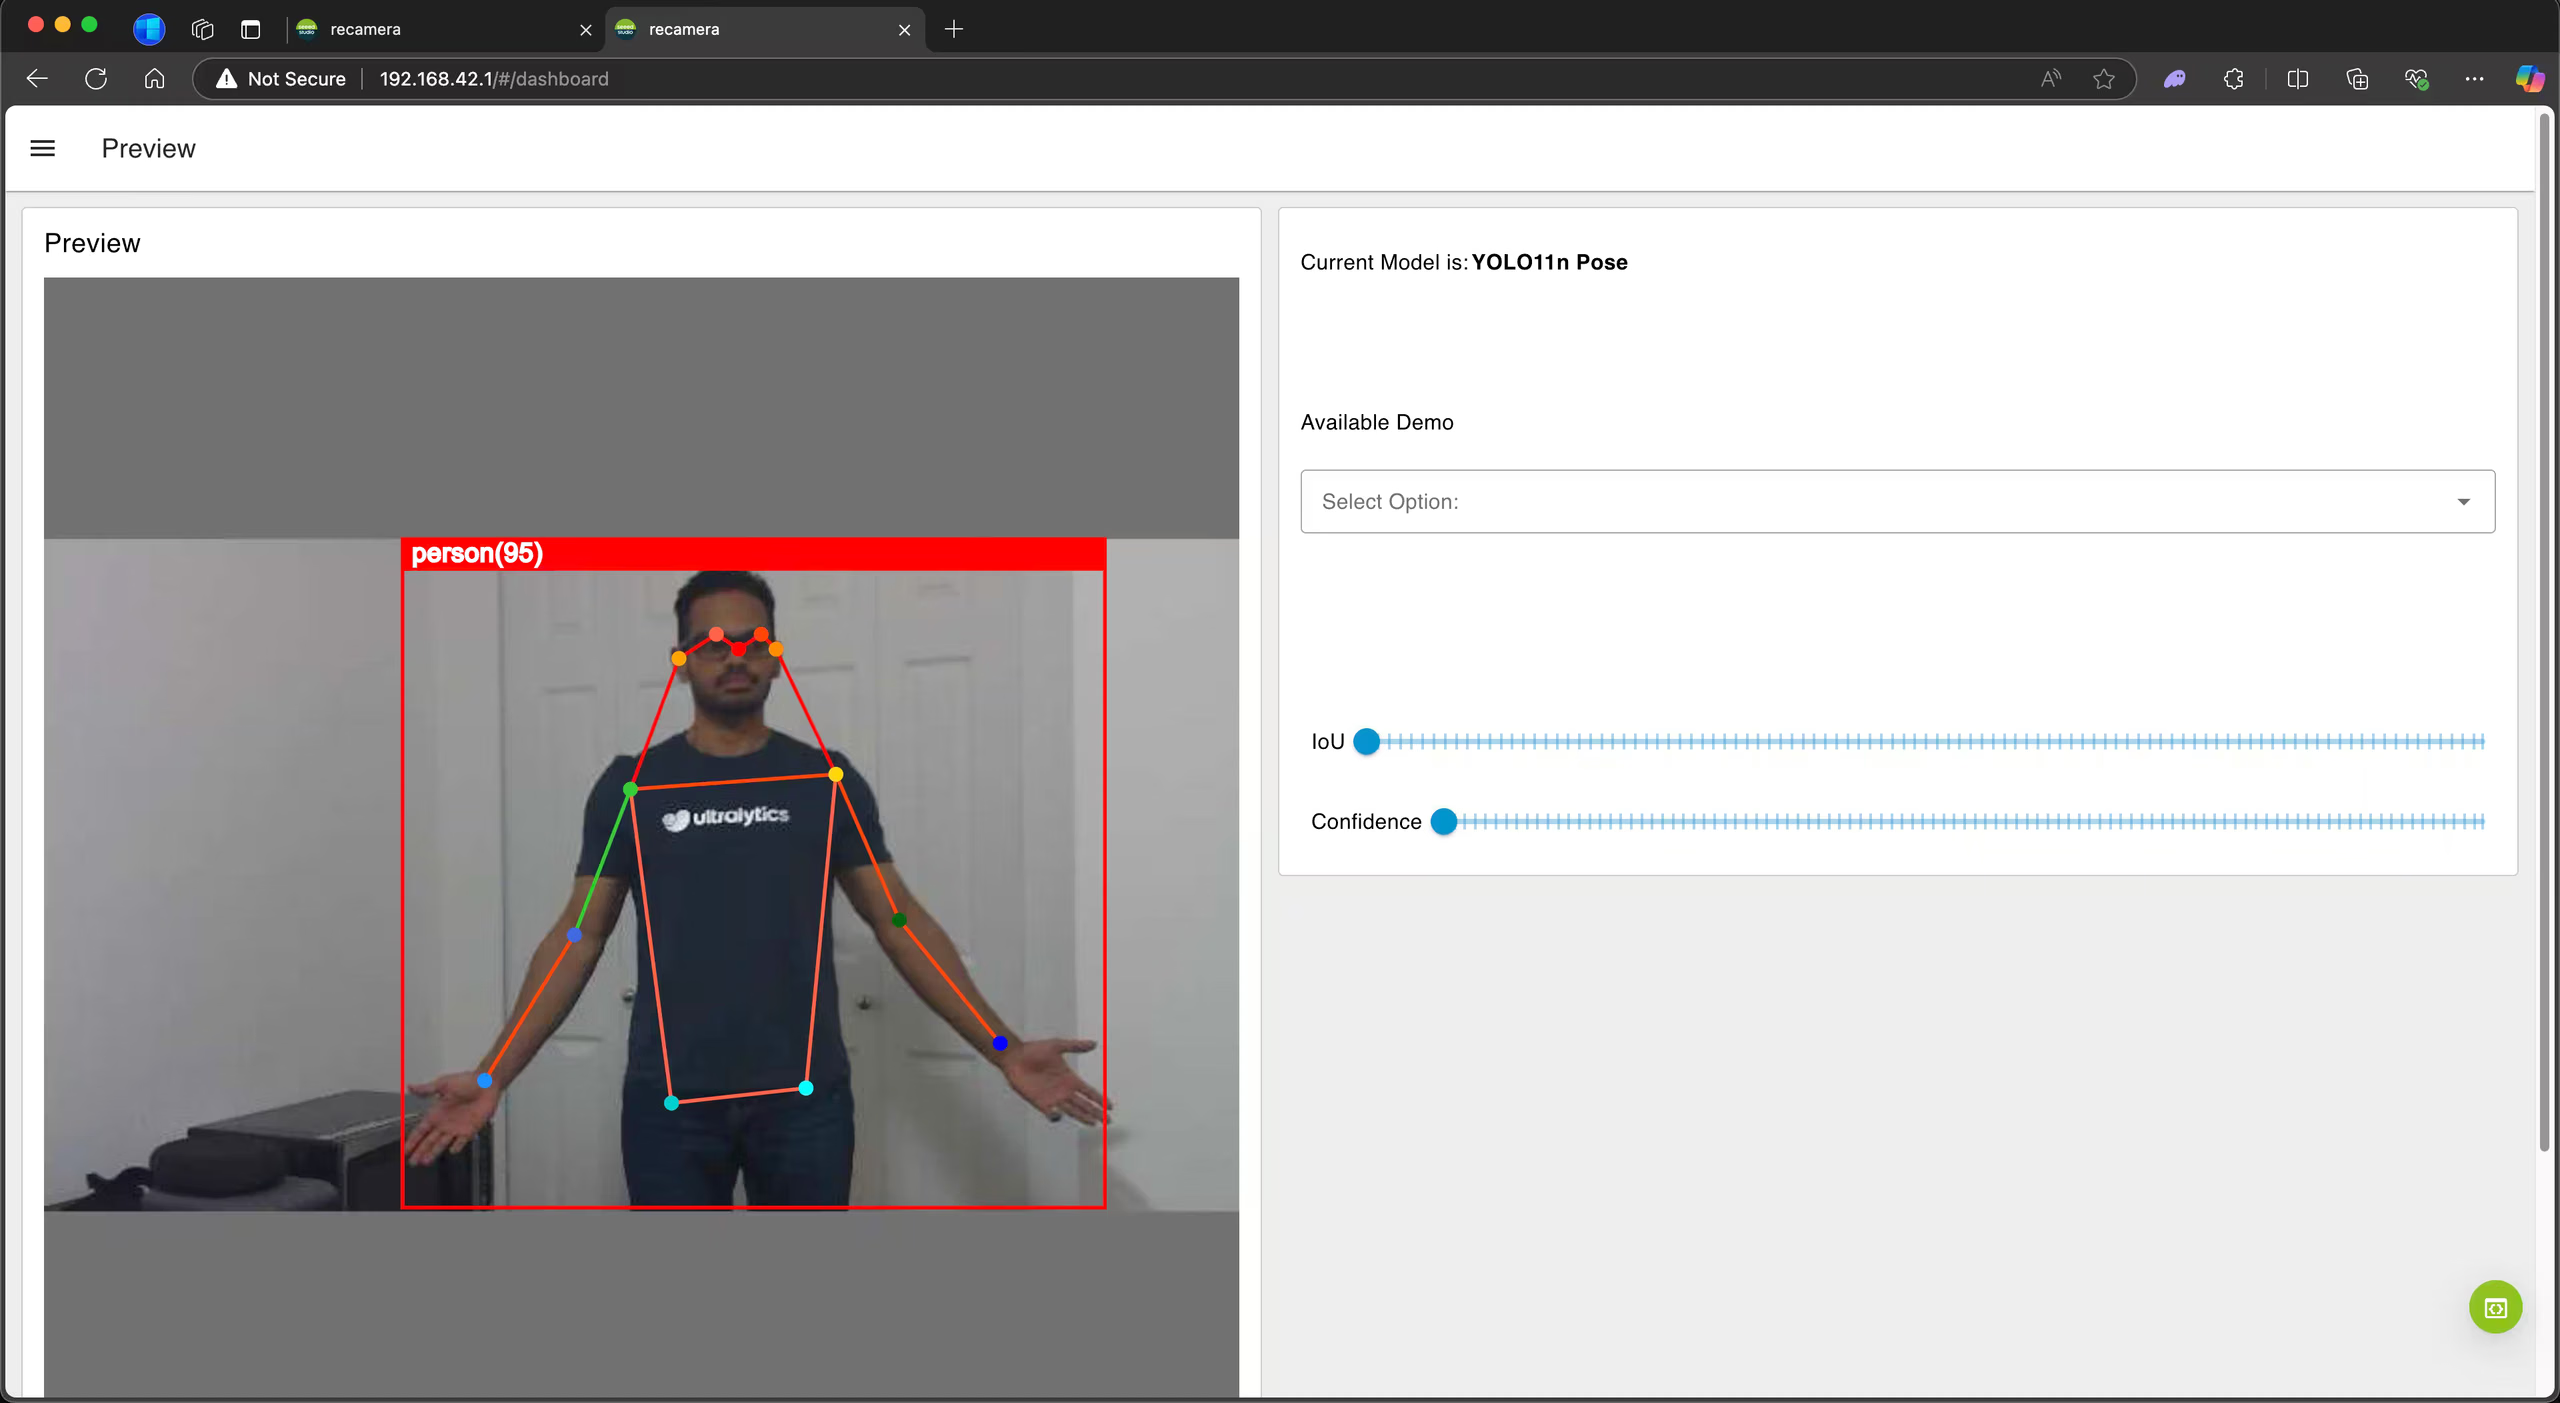
La dashboard ora mostra il modello di stima della posa in esecuzione sul flusso video della videocamera.
Esportazione in cvimodel: conversione del tuo modello YOLO26#
Se vuoi usare un modello YOLO26 addestrato su dati personalizzati con reCamera, segui i passaggi riportati di seguito.
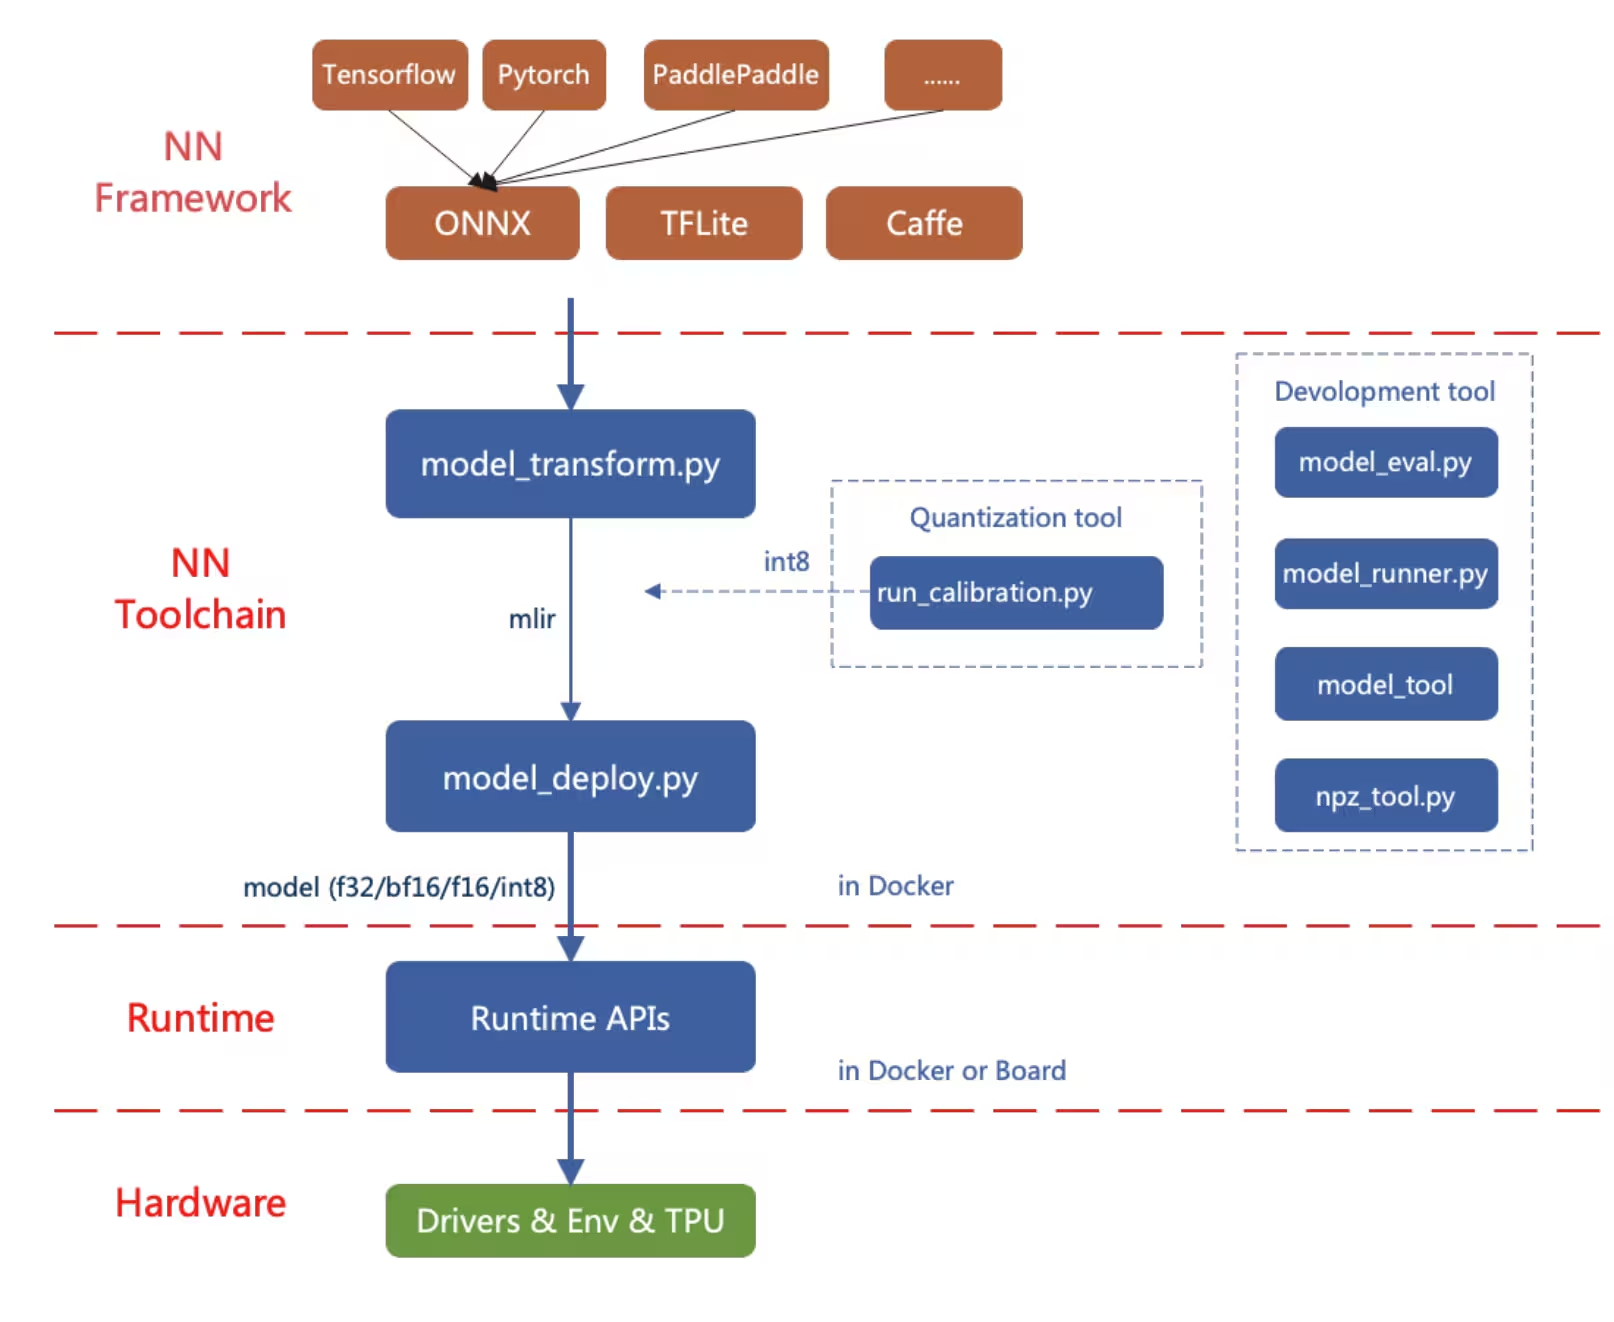
La conversione esporta prima un modello PyTorch in ONNX, poi lo converte nel formato modello MLIR e infine converte MLIR in cvimodel per eseguire l'inferenza sul dispositivo.
Esportazione in ONNX#
Esporta un modello Ultralytics YOLO26 nel formato ONNX.
Installazione#
Per installare i pacchetti necessari, esegui:
pip install ultralyticsPer istruzioni dettagliate e best practice sulla procedura di installazione, consulta la nostra guida all'installazione di Ultralytics. Se durante l'installazione dei pacchetti necessari per YOLO26 riscontri difficoltà, consulta la nostra guida ai problemi comuni per trovare soluzioni e suggerimenti.
Utilizzo#
from ultralytics import YOLO

# Carica un modello YOLO26
model = YOLO("yolo26n.pt")

# Esporta il modello in formato ONNX
model.export(format="onnx", opset=14)  # crea 'yolo26n.onnx'
Per ulteriori dettagli sul processo di esportazione, visita la pagina della documentazione Ultralytics dedicata all'esportazione.
Esporta ONNX in MLIR e cvimodel#
Dopo aver ottenuto un modello ONNX, consulta la pagina Converti e quantizza modelli AI per convertire il modello ONNX in MLIR e poi in cvimodel.
Applicazioni reali di reCamera#
La visione artificiale sul dispositivo e il design modulare di reCamera la rendono adatta a un'ampia gamma di scenari reali.
-
Rilevamento delle cadute: progettata per applicazioni di sicurezza e sanitarie, reCamera può rilevare le cadute in tempo reale, risultando particolarmente adatta all'assistenza agli anziani, agli ospedali e agli ambienti industriali in cui è fondamentale intervenire rapidamente.
-
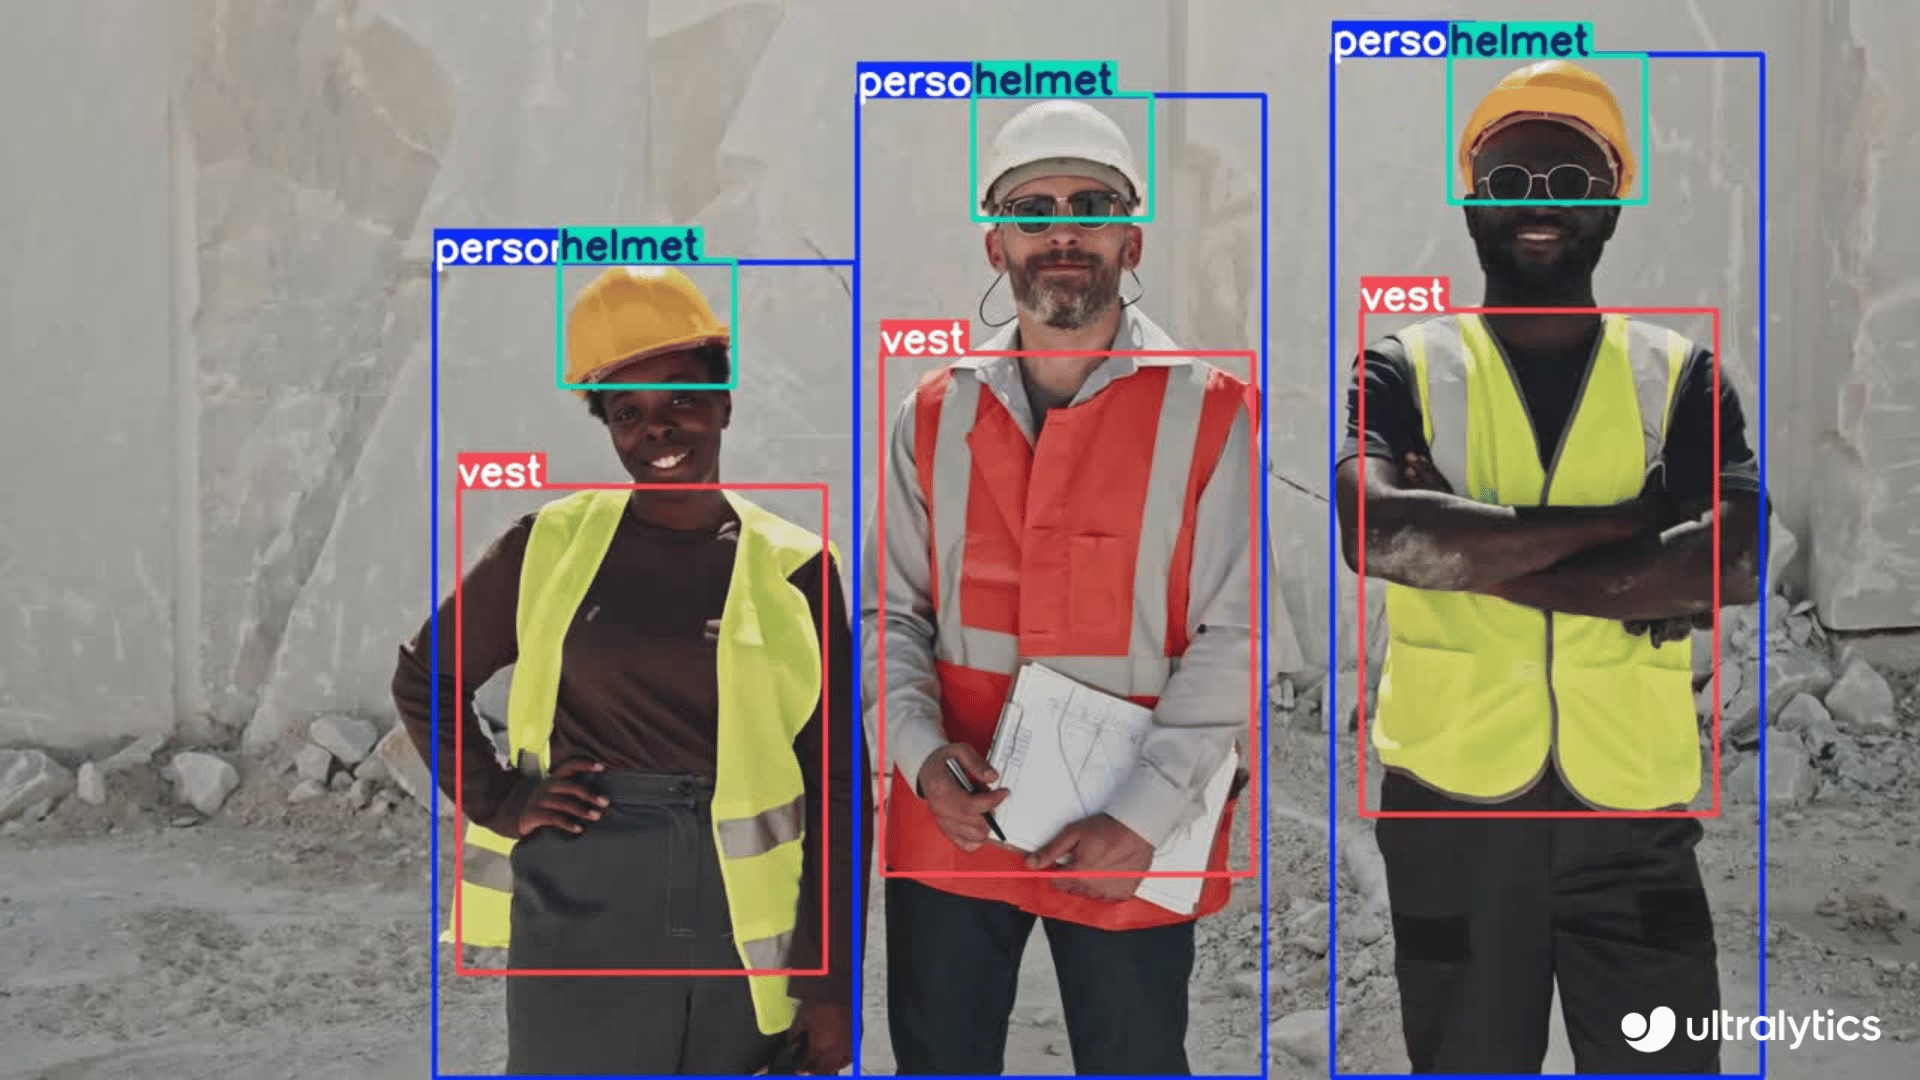
Rilevamento dei dispositivi di protezione individuale: reCamera può contribuire alla sicurezza sul lavoro rilevando in tempo reale il rispetto delle norme sui DPI. Aiuta a identificare se i lavoratori indossano caschi, guanti o altri dispositivi di protezione, riducendo i rischi negli ambienti industriali.
-
Rilevamento degli incendi: le capacità di elaborazione in tempo reale di reCamera la rendono particolarmente adatta al rilevamento degli incendi in aree industriali e residenziali, fornendo avvisi tempestivi per prevenire potenziali disastri.
-
Rilevamento dei rifiuti: può essere utilizzata anche per rilevare i rifiuti nel monitoraggio ambientale e nella gestione dei rifiuti con YOLO11.
-
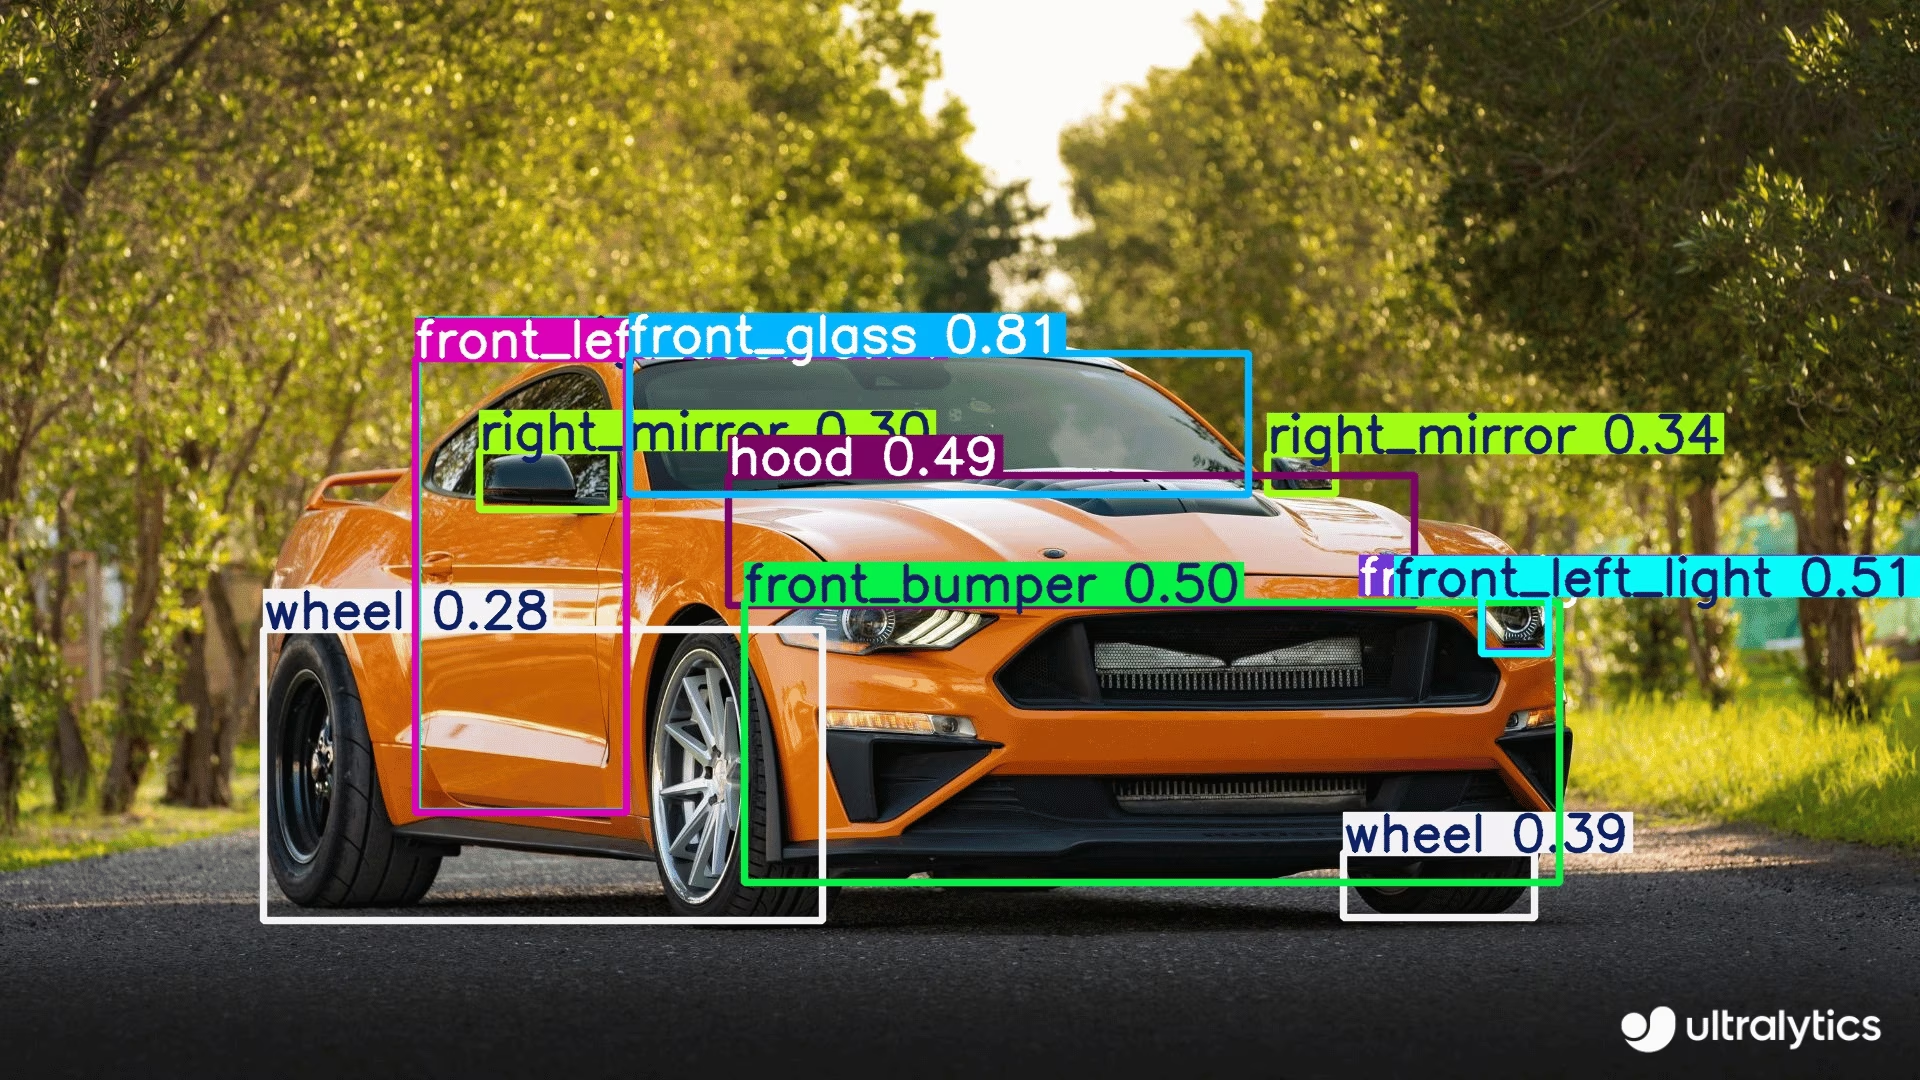
Rilevamento dei componenti automobilistici: Nei settori manifatturiero e automobilistico, aiuta a rilevare e analizzare i componenti delle auto per il controllo della qualità, il monitoraggio delle linee di assemblaggio e la gestione dell'inventario.
Domande frequenti#
Per configurare reCamera per la prima volta, segui questi passaggi:
- Collega reCamera a una fonte di alimentazione
- Collegala alla rete utilizzando la pagina Guida introduttiva a reCamera (seleziona il tuo dispositivo per aprire la relativa Guida rapida)
- Accedi all'interfaccia web di Node-RED inserendo l'indirizzo IP del dispositivo in un browser web (oppure usa
192.168.42.1se è collegato tramite USB) - Inizia subito a usare i modelli YOLO preinstallati tramite l'interfaccia della dashboard
Sì, puoi usare modelli YOLO26 addestrati su misura con reCamera. La procedura prevede di:
- Esportare il modello PyTorch in formato ONNX usando
model.export(format="onnx", opset=14) - Convertire il modello ONNX in formato MLIR
- Convertire MLIR in formato cvimodel per l'inferenza sul dispositivo
- Caricare il modello convertito su reCamera
Per istruzioni dettagliate, consulta la guida Convertire e quantizzare modelli di IA.
- Esportare il modello PyTorch in formato ONNX usando
A differenza delle tradizionali telecamere IP, che richiedono hardware esterno per l'elaborazione, reCamera:
- Integra l'elaborazione IA direttamente nel dispositivo grazie al processore RISC-V SG200X
- Offre una potenza di calcolo di 1 TOPS per applicazioni di IA edge in tempo reale
- Ha un design modulare che consente di aggiornare e personalizzare i componenti
- Supporta tecnologie video avanzate come la compressione H.264/H.265, le immagini HDR e la riduzione del rumore 3D
- Include modelli Ultralytics YOLO preinstallati, pronti per l'uso
Queste funzionalità rendono reCamera una soluzione autonoma per applicazioni di IA edge, senza bisogno di hardware esterno aggiuntivo per l'elaborazione.


Commenti50
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
tcpipchip
we wrote a book and trainned to yolo26 on ultralytics...i recall that works
 Glenn JocherUltralytics
Yes, a custom-trained
YOLO26model can run onreCamerausing theONNX -> MLIR -> cvimodelworkflow in the reCamera guide; if you hit a blocker, please share the exact step and full error here so the Ultralytics team can help.
HanJammer
This site mentions recamera comes with YOLO26 (which is why I bought two of them) yet YOLO11 is installed (which is visible on screenshots as well) and I can't load YOLO26 - how to do that? I can't find reliable guide :(
Ah nevermind, I think I got it, still it would be better not to advertise the camera "reCamera comes pre-installed with four Ultralytics YOLO26 models" which is basically not true.
I whipped out some 'single click' tool to convert YOLO26 onnx-es which makes it a bit easier... I need to test it a bit, for now it supports the base model. Perhaps I will push it to my github later this week.
This is fantastic.
When you finish it, i will add to the BOOK.
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
wow!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
i will test soon!
- Glenn JocherUltralytics
Thanks for sharing this; for anyone testing, the supported path today is still the reCamera integration guide together with Seeed’s model conversion guide, and we’ll review the docs wording around preinstalled models since some devices appear to ship with YOLO11 rather than YOLO26.
@glenn-jocher Have you a recamera ?
- Glenn JocherUltralytics
I don’t personally keep a reCamera on my desk, but the workflow in the Seeed Studio reCamera guide is the supported path; if you have a specific setup or export question, please drop it here and the Ultralytics team can take a look.
I tested on recamera with my trainned pose keypoint model... Same problem...no keypoint
Need to test on yolo8 on tdl sdk
- Glenn JocherUltralytics
Thanks for checking this; for custom pose models on reCamera, please drop the exact export and conversion steps here in the discussion so the Ultralytics team can take a look, since keypoints should work only after a correct
ONNX -> MLIR -> cvimodelpipeline as outlined in the reCamera guide and Seeed’s conversion guide, and it’s worth first confirming your exportedONNXmodel still produces keypoints before converting.
did you do calibration ? where the images to me to the calibration :(
- Glenn JocherUltralytics
Calibration isn’t done in the Ultralytics export step; for reCamera, you export to ONNX first with the reCamera guide, then calibration happens during Seeed’s ONNX→MLIR→
cvimodelflow using a small representative set of your own images, as described in Seeed’s Convert and Quantize AI Models guide. If you hit an error in that step, please drop the full log here and we’ll take a look.
still waiting...
send me your cvimodel too...yolo11 and yolo8
please, send me arguments used in your scripts...
did you train keypoints on animals and persons, right ?
tiruvijayakumar
NOO, i didnt train on animals, i trained on these classes for pose detection for persons using yolov11n-pose.pt weights. I fine‑tuned the YOLOv11n‑pose.pt model on my custom classes:
Running Walking Golf Skate Horse riding Kicking Diving I just uploaded animal detection model to justify that custom model deployment with quantization for object detection(yolo11n.pt) on recamera has no issues, it was another cvi model which i had no issues, it worked PERFECTLY. i only issue what i am facing is the pose detection quantized model where i am not able to see the keypoints on the inference output but bounding box is drawn along with predicted class label refer below:
now just trying to train the model for pose detection using yolov8 and then i would try quantizing the model and check if the keypoints are shown in the inference output
- Glenn JocherUltralytics
Thanks, that helps narrow it down — since detection
cvimodels work and only the quantized pose model loses keypoints, this looks more like a pose conversion or postprocessing issue in the ONNX → MLIR →cvimodelstep than a training problem. Please keep the details here so the Ultralytics team can see them, and share the exact conversion commands and full text logs from the reCamera guide and Seeed model conversion guide, plus whether the same pre-quantized ONNX shows keypoints before conversion. i ran predictions on ultralytics hub on the .pt model format, i attached the whole problem scenario and image content :https://github.com/orgs/ultralytics/discussions/22090?sort=new#discussioncomment-16346206 Any ways uploading the prediction on ultralytics hub in this thread also :
so on the model.pt file inference shows this data, this confirms that pose estimation model works. { "images": [ { "shape": [ 426, 640 ], "speed": { "preprocess": 1.41517, "inference": 130.14456, "postprocess": 0.99221 }, "results": [ { "name": "Kicking", "class": 5, "confidence": 0.80929, "box": { "x1": 0.26068, "y1": 0.10738, "x2": 0.55882, "y2": 0.85426 }, "keypoints": { "x": [ 0.41923001408576965, 0.42656999826431274, 0.4166699945926666, 0.45181000232696533, 0.42857998609542847, 0.488209992647171, 0.43380001187324524, 0.543470025062561, 0.41604000329971313, 0.5516700148582458, 0.4164600074291229, 0.46198999881744385, 0.4427199959754944, 0.357340008020401, 0.427839994430542, 0.29197001457214355, 0.43891000747680664 ], "y": [ 0.2315099984407425, 0.21907000243663788, 0.21740999817848206, 0.21602000296115875, 0.21322999894618988, 0.2783600091934204, 0.2824600040912628, 0.3255299925804138, 0.35097000002861023, 0.32879000902175903, 0.3619599938392639, 0.5179499983787537, 0.5104399919509888, 0.6517800092697144, 0.6389099955558777, 0.7586100101470947, 0.7324900031089783 ], "visible": [ 0.9994300007820129, 0.9990299940109253, 0.9990000128746033, 0.999019980430603, 0.9988300204277039, 0.9995700120925903, 0.9996600151062012, 0.998960018157959, 0.9992700219154358, 0.9985499978065491, 0.997439980506897, 0.9995700120925903, 0.9995700120925903, 0.9988800287246704, 0.9989299774169922, 0.982990026473999, 0.9852499961853027 ] } } ] } ], "metadata": { "imageCount": 1, "functionTimeAlive": 78321.917, "functionTimeCall": 0.138, "model": "best.pt", "version": { "ultralytics": "8.4.30", "torch": "2.11.0+cpu", "torchvision": "0.26.0+cpu", "python": "3.14.3" } }, "networkTime": 1.214 }
I didnt capture the conversion commands and text logs during the onnx->mlir->cvimodel, would repeat the same steps and paste the images in this thread itself.
Exported the yolov11n-pose.pt(finetuned) on google colab to onnx format
Uploaded the model on netron to view the structure, onnx is in the format IRv9 ,opset v20(would downgrade it). Classes are running, walking, golf-swing, skateboarding, riding-horse and kicking
Seeed studio guide for downgrading
Initial structure of workspace folder
Step1: pull sopho/tpuc_dev:v3.1
Step2: starting the container
Step3: installing onnx
Step4: Clone Downgrade Script
Step5: Downgrade Script settings IR v8 and Opset v17
Step6: Install TPU-MLIR tools inside container:
Step7: clone tpu-mlir
Step8: setup environment tpu-mlir(long step)
Step9: according to seeed studio guide, i have to include outputs before the model's head as the parameter for this particular step model_transform
--model_name yolo11n
--model_def yolo11n.onnx
--input_shapes "[[1,3,640,640]]"
--mean "0.0,0.0,0.0"
--scale "0.0039216,0.0039216,0.0039216"
--keep_aspect_ratio
--pixel_format rgb
--output_names "/model.23/cv2.0/cv2.0.2/Conv_output_0,/model.23/cv3.0/cv3.0.2/Conv_output_0,/model.23/cv2.1/cv2.1.2/Conv_output_0,/model.23/cv3.1/cv3.1.2/Conv_output_0,/model.23/cv2.2/cv2.2.2/Conv_output_0,/model.23/cv3.2/cv3.2.2/Conv_output_0"
--test_input ../image/dog.jpg
--test_result yolo11n_top_outputs.npz
--mlir yolo11n.mlir i have the onnx file, could someone of the team help me identify the outputs before the model's head? @glenn-jocher here is the onnx file https://drive.google.com/file/d/1UF25DK2zXx0GCWdcx55SPYHL71SylDeg/view?usp=sharing
and some animal pictures...