YOLOE: rilevamento e segmentazione in tempo reale con vocabolario aperto
Ultralytics YOLOE (Real-Time Seeing Anything) è un modello di rilevamento a vocabolario aperto e di segmentazione delle istanze: invece di usare un elenco di classi fissato durante l'addestramento, accetta le categorie desiderate al momento dell'inferenza, sotto forma di prompt testuale, esempio visivo o vocabolario integrato di 4.585 nomi. Basato sulle architetture YOLO di Ultralytics — YOLOv8, YOLO11 e YOLO26 — e ispirato a YOLO-World, YOLOE raggiunge un'elevata precisione zero-shot con una velocità vicina a quella di YOLO a classi chiuse.
Guarda: Come usare Ultralytics YOLOE-26 (novità) | Vocabolario aperto e riconoscimento di qualsiasi oggetto in tempo reale
Guida rapida#
Indica le classi desiderate e avvia il modello. YOLOE-26 restituisce riquadri e maschere di segmentazione delle istanze per categorie su cui non è mai stato addestrato.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# "double-decker bus" non è una classe COCO; YOLOE la individua basandosi solo sulle parole
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
La prima chiamata a set_classes() scarica un encoder testuale; consulta Installazione e requisiti prima di distribuire il modello su una macchina senza accesso alla rete.
Scegliere una modalità di prompt#
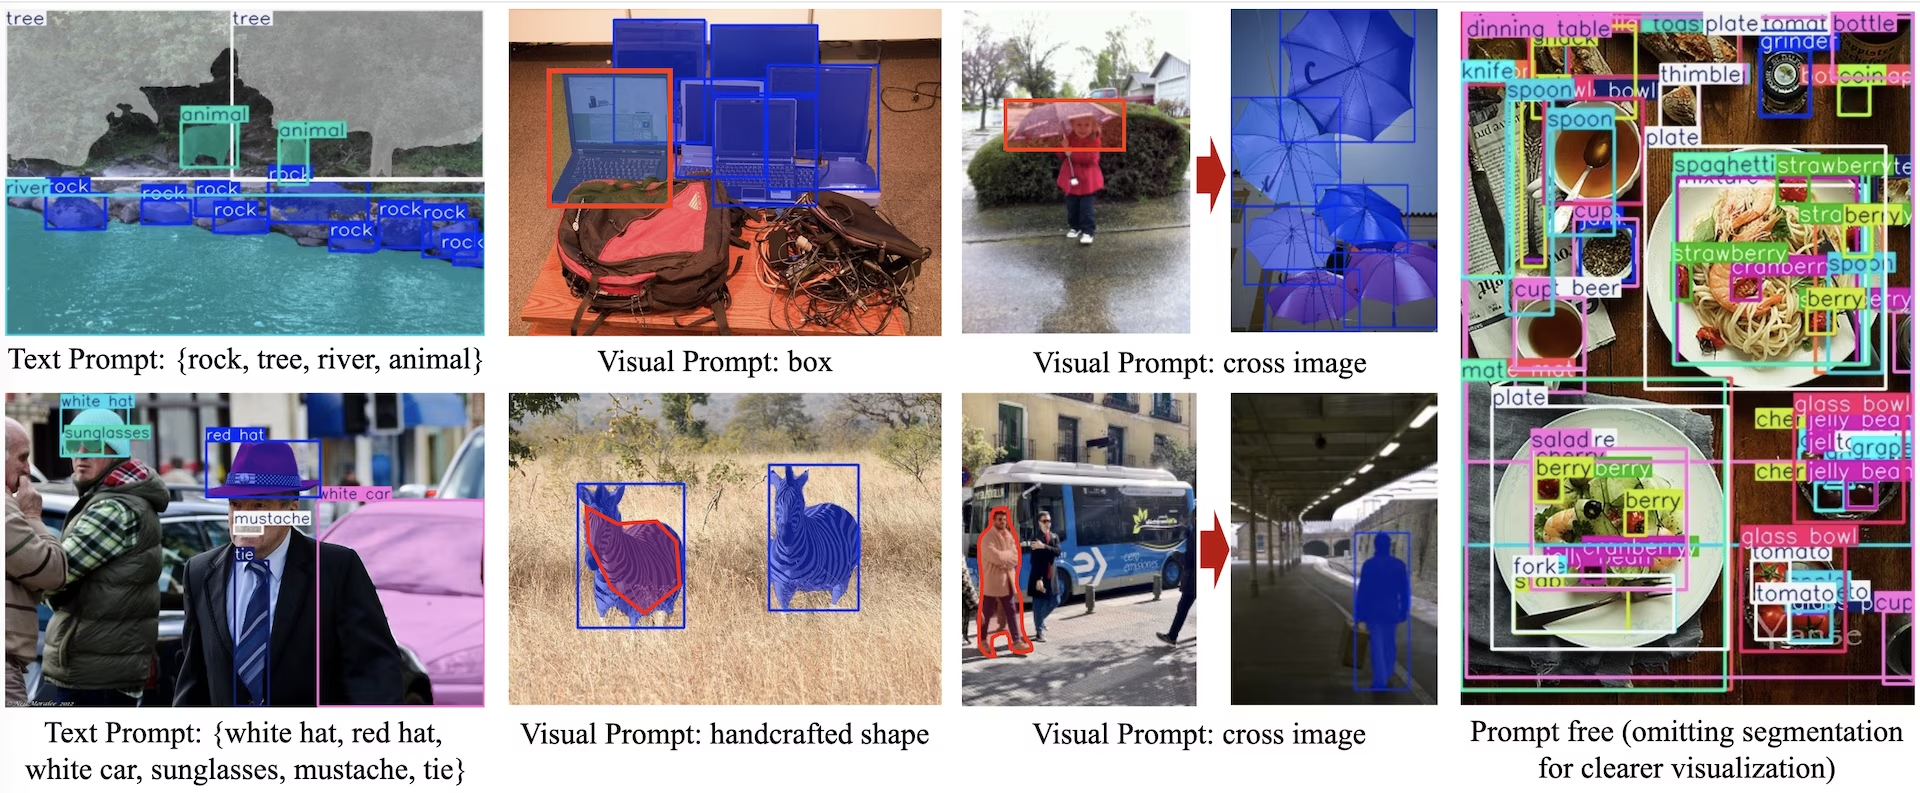
YOLOE supporta tre modalità di prompt; la scelta determina quale checkpoint caricare e l'aspetto delle etichette delle classi. Scegli la riga corrispondente a ciò che puoi fornire al momento dell'inferenza.
| Modalità | Checkpoint | Fornisci | Nomi delle classi nei risultati | Usalo quando |
|---|---|---|---|---|
| Prompt testuale | *-seg.pt | Nomi delle classi come stringhe | Esattamente i nomi che hai specificato | Puoi descrivere a parole l'oggetto da rilevare: è la scelta più comune |
| Prompt visivo | *-seg.pt | Riquadri di esempio su un'immagine di riferimento | object0 generici, object1, … | Non puoi descrivere a parole l'oggetto da rilevare: si tratta di una parte specifica, un logo o un difetto |
| Senza prompt | *-seg-pf.pt | Niente | Nomi dal vocabolario integrato di 4.585 nomi | Stai catalogando o esplorando e non sai in anticipo cosa cercare |
- I prompt visivi non includono le tue etichette. Gli ID delle classi in
visual_promptsraggruppano gli esempi; il modello li restituisce comeobject0,object1e così via. Devi associarli tu ai nomi che usi. - I checkpoint senza prompt rifiutano
set_classes(). Se lo chiami su un modello*-seg-pf.pt, viene generatoAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.Carica invece un checkpoint*-seg.ptquando hai bisogno delle tue classi.
Installazione e requisiti#
YOLOE è incluso nel pacchetto principale Ultralytics:
pip install -U ultralyticsIl prompt testuale richiede anche un encoder testuale, che viene scaricato al primo utilizzo e non durante l'installazione:
- La prima chiamata a
set_classes()installa ultralytics/CLIP da GitHub conpip(che fornisce il tokenizer) e scarica un encoder testuale TorchScript nella directory di lavoro corrente. YOLOE-26 scaricamobileclip2_b.ts, circa 254 MB; YOLOE-11 e YOLOE-v8 scaricanomobileclip_blt.ts. Esegui il download una volta dalla directory da cui avvierai il programma, oppure copia lì il file; altrimenti verrà scaricato di nuovo. - Entrambe le operazioni richiedono l'accesso alla rete, quindi esegui una predizione con prompt prima di distribuire il modello su una macchina offline o isolata dalla rete.
- I prompt visivi e i checkpoint senza prompt non richiedono affatto un encoder testuale.
I checkpoint YOLOE-26 richiedono ultralytics 8.4.0 o versione successiva; le famiglie YOLOE-11 e YOLOE-v8 sono disponibili nelle versioni precedenti. Una predizione con prompt testuale verifica l'intero flusso: download del checkpoint, installazione di CLIP, encoder testuale e inferenza:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Per evitare del tutto il download dell'encoder testuale al momento dell'inferenza, incorpora i prompt nei pesi una volta sola e riutilizzali: consulta Riutilizzare gli embedding dei prompt.
Panoramica dell'architettura#

YOLOE mantiene la struttura YOLO standard — un backbone convoluzionale per l'estrazione delle caratteristiche, un neck per la fusione multiscala e una head disaccoppiata e senza anchor che predice classi e riquadri — e aggiunge tre moduli, uno per ogni modalità di prompt:
- Allineamento riparametrizzabile regione-testo (RepRTA) affina gli embedding testuali di CLIP tramite una piccola rete ausiliaria. Questa rete viene eseguita una volta per chiamata
set_classes()e rimossa durante l'esportazione, quindi non comporta costi per frame. A ogni passaggio forward viene invece eseguito il confronto tra gli embedding dei prompt archiviati e le caratteristiche delle regioni; consulta Limitazioni per i costi associati a un insieme ampio di prompt. - Encoder dei prompt visivi con attivazione semantica (SAVPE) codifica le caratteristiche semantiche e di attivazione di un riquadro di esempio, condizionando il modello sugli oggetti che gli somigliano. È il flusso one-shot per gli oggetti difficili da nominare, come un logo o una parte specifica.
- Contrasto regione-prompt lazy (LRPC) confronta gli embedding delle regioni con un vocabolario integrato di 4.585 nomi, così i checkpoint senza prompt riconoscono oggetti senza prompt esterni e senza encoder testuale.
La segmentazione delle istanze è ottenuta tramite un ramo delle maschere sulla testa di rilevamento, come in YOLOv8-Seg, e ogni previsione contiene una maschera su results[0].masks. Una volta esportato il modello, i moduli open-world vengono riparametrizzati in una testa YOLO standard, così il file esportato esegue il normale percorso di rilevamento/segmentazione.
Modelli disponibili#
Tutti i checkpoint elencati di seguito sono modelli di segmentazione delle istanze e supportano val, predict, export e track. Carica un file *-seg.pt per i prompt testuali o visivi e un file *-seg-pf.pt per l'inferenza senza prompt; i due tipi non sono intercambiabili. Consulta Scelta della modalità di prompting. Solo i file *-seg.pt supportano train; un checkpoint senza prompt viene prodotto a partire da un modello addestrato con prompt testuali. Consulta Addestramento dei modelli ufficiali da zero.
| Modello | Prompt testuale/visivo | Senza prompt |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
Prestazioni di YOLOE su LVIS#
Risultati zero-shot sul minival di LVIS a 640 pixel, tratti dal paper Ultralytics YOLO26.
Prompt testuali e visivi#
Ogni cella relativa a precisione e parametri riporta prompt testuale / prompt visivo; i FLOPs sono indicati una sola volta. I parametri e i FLOPs si riferiscono alla configurazione di rilevamento valutata nel paper. La precisione corrisponde al valore Non-E2E del paper, l'unico protocollo riportato per tutti i modelli del confronto; la head end-to-end di YOLOE-26 è inferiore al massimo di 1,1 AP con prompt testuali e di 2,6 AP con prompt visivi.
| Modello | mAP50-95 | mAPr | mAPc | mAPf | parametri (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
Senza prompt#
I checkpoint senza prompt forniscono risultati usando il vocabolario integrato, senza che venga specificato alcun prompt. Ogni cella della precisione riporta end-to-end / Non-E2E, i due protocolli con cui il paper valuta YOLOE-26; la pagina YOLO26 riporta la colonna Non-E2E.
| Modello | mAP50-95 | mAPr | mAPc | mAPf | parametri (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
Con prompt testuali e visivi, i modelli YOLOE-26 superano i rispettivi modelli YOLOE-11 e YOLOE-v8 a ogni scala corrispondente in mAP50-95, mantenendosi al di sotto della linea v8 per numero di parametri e FLOPs. Sulla stessa suddivisione, il paper riporta YOLO-Worldv2 a 24.4 (S), 32.4 (M) e 35.5 (L), e i rilevatori basati su Transformer GLIP-T a 26.0, GDINO-T a 27.4 e DetCLIP-T a 34.4, ciascuno con 155-232 M di parametri. Il paper originale di YOLOE aggiunge due risultati per i modelli con scala v8 che ha introdotto. Su LVIS, YOLOE-v8s supera YOLO-Worldv2-S di 3.5 AP con un terzo del costo di addestramento e una velocità di inferenza 1.4× superiore. Trasferito su COCO, YOLOE-v8l guadagna 0.6 box AP e 0.4 mask AP rispetto a YOLOv8-L a insieme chiuso, con un tempo di addestramento quasi 4× inferiore.
Il paper di YOLO26 valuta una configurazione di rilevamento. I pesi rilasciati sono checkpoint di segmentazione e includono un ramo per le maschere, SAVPE e la proiezione testuale, perciò un yoloe-26l-seg.pt caricato riporta 35.4 M e 142.0 B invece dei 25.5 M e 89.0 B indicati sopra. In entrambi i casi, il valore FLOPs esclude la similarità tra regione e testo, quindi il costo effettivo aumenta con la dimensione dell'insieme di prompt anche se la colonna non cambia; vedi Limitazioni.
Esempi d'uso#
Ogni esempio YOLOE qui sotto viene eseguito tramite API Python. La predizione con prompt testuale, la validazione, l'esportazione, il tracking e il semplice addestramento funzionano anche tramite CLI; le ricette di fine-tuning passano una classe trainer e il prompting visivo passa array di prompt NumPy, accettati solo dall'API Python.
Utilizzo dell'addestramento#
Esegui il fine-tuning di qualsiasi checkpoint rilasciato *-seg.pt sul tuo dataset YOLO. Questa procedura segue perlopiù la procedura standard di addestramento di YOLO; cambia il trainer da specificare. YOLOEPESegTrainer integra i nomi delle tue classi nella head e avvia da lì il fine-tuning, che è ciò che ti serve per le tue etichette; il trainer predefinito non viene addestrato sulle tue classi. Il checkpoint risultante predice direttamente le classi del tuo dataset: la sua head non legge più i prompt, quindi set_classes() genera un errore se le classi cambiano, e lo stesso vale per i prompt visivi. Usa il checkpoint originale per specificare altre classi.
Guarda: Come addestrare YOLOE sul dataset di segmentazione dei componenti automobilistici | Modello a vocabolario aperto, previsione ed esportazione
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Importante: il trainer per il fine-tuning, non quello predefinito
)Ogni checkpoint rilasciato è un modello di segmentazione. Per addestrare un rilevatore, crea il modello a partire dallo YAML corrispondente, carica i pesi di segmentazione della stessa scala e sostituisci il trainer con quello di rilevamento. Tutto il resto rimane invariato.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Uso di predict#
La chiamata con prompt testuale è quella mostrata in Avvio rapido. Il prompting visivo aggiunge un argomento visual_prompts, mentre la predizione senza prompt carica invece un checkpoint -pf:
I prompt visivi mostrano al modello un esempio invece di descriverlo. visual_prompts accetta un array bboxes di riquadri di esempio e un array cls di ID di classe, uno per riquadro. Gli ID sono raggruppamenti temporanei, non etichette: devono essere sequenziali a partire da 0 e i risultati vengono restituiti come object0, object1, … e non con i nomi scelti da te.
I riquadri di esempio possono trovarsi sull'immagine su cui stai eseguendo la predizione:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# Un riquadro di esempio per ogni oggetto target, ciascuno con il proprio ID di classe
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # persona, occhiali
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
Oppure possono trovarsi su un'immagine di riferimento separata passata come refer_image; in tal caso, bboxes e cls descrivono gli oggetti nell'immagine di riferimento, non nel target:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Immagine target
    refer_image="ultralytics/assets/bus.jpg",  # Dove si trovano i riquadri di esempio
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image imposta anche le classi in modo permanente, quindi le chiamate successive non richiedono alcun prompt
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # E l'esportazione le mantieneQuando source è un video o uno stream, il primo frame diventa automaticamente refer_image, quindi i prompt passati vengono applicati a quel frame e mantenuti per il resto del video. Passa esplicitamente refer_image per scegliere un altro frame.
Sia source sia refer_image accettano direttamente tensori torch, utile quando le immagini provengono già da una pipeline esistente. Fornisci i riquadri nelle coordinate dei pixel del tensore:
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # (1, 3, H, W) tensore float in [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Per eseguire la predizione su più immagini contemporaneamente, annida i prompt un livello più in profondità: un array bboxes e un array cls per ogni immagine sorgente, nello stesso ordine delle sorgenti.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: persona, occhiali
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: persona
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Uso di val#
La validazione si esegue come con qualsiasi altro modello su un dataset di segmentazione:
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # oppure yoloe-26s/m-seg.pt per altre dimensioni

metrics = model.val(data="coco128-seg.yaml")
data può anche essere un file NDJSON o un URI di dataset della piattaforma ul://; viene convertito nel formato YOLO prima di creare i prompt testuali o visivi.
Due varianti della stessa chiamata coprono le altre modalità di prompting:
- Prompt visivi —
model.val(data="coco128-seg.yaml", load_vp=True)estrae un embedding visivo per categoria direttamente dal dataset. Aggiungirefer_data="coco.yaml"per usare gli embedding di un dataset diverso, che deve contenere esattamente le stesse categorie. - Senza prompt — carica un checkpoint
*-seg-pf.pte passasingle_cls=True.
Utilizzo dell'esportazione#
Gli embedding dei prompt possono essere salvati una volta e riutilizzati per creare esportazioni statiche come ONNX, OpenVINO, TensorRT, CoreML, LiteRT e RKNN. Il profilo NPZ viene caricato dal modello PyTorch originale prima dell'esportazione; non è un input aggiuntivo in fase di esecuzione e il modello esportato non richiede il file NPZ.
Le classi configurate con set_classes() (o tramite refer_image per i prompt visivi) vengono incorporate nei pesi esportati. Dopo l'esportazione, il modello non può più accettare nuovi prompt: una chiamata a set_classes() o il passaggio di visual_prompts=... a predict() su un'esportazione caricata genererà un errore. Per modificare le classi rilevate, esegui una nuova esportazione dal checkpoint .pt originale con i nuovi prompt configurati. Il file esportato si comporta come un modello YOLO standard e può anche essere caricato con YOLO() invece che con YOLOE().
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# Il profilo è associato al checkpoint sorgente e può essere riutilizzato per le esportazioni successive.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
Lo stesso profilo dei prompt può anche configurare un modello di solo rilevamento creato a partire dall'architettura YOLOE corrispondente. In questo modo si rimuove il ramo delle maschere mantenendo le classi specificate dai prompt:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)Tracciamento#
Le classi specificate dai prompt passano direttamente al tracking, così puoi seguire oggetti su cui il tracker non è mai stato addestrato:
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True mantiene stabili gli ID di tracking tra i frame
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
Confronto tra YOLOE e altri modelli#
YOLOE si colloca tra un rilevatore a insieme chiuso e un modello open-vocabulary di grandi dimensioni. Tre confronti aiutano a stabilire se è la scelta giusta:
- Rispetto a un modello YOLO a insieme chiuso. Una volta impostati i prompt, YOLOE esegue la predizione tramite il normale percorso di rilevamento/segmentazione e si esporta come qualsiasi altro modello. Il vantaggio è poter modificare l'elenco delle classi in fase di inferenza invece di riaddestrare; il costo è un'accuratezza zero-shot molto inferiore a quella di un modello addestrato sulle tue classi.
- Rispetto alle precedenti famiglie YOLOE. YOLOE-26 eredita la head end-to-end senza NMS di YOLO26 e copre cinque scale (n/s/m/l/x) rispetto alle tre precedenti (s/m/l), ottenendo risultati migliori a ogni scala corrispondente nella sezione Prestazioni.
- Rispetto ai rilevatori open-vocabulary basati su Transformer. GLIP e OWL-ViT eseguono un Transformer visione-linguaggio in fase di inferenza. YOLOE codifica i prompt una sola volta e poi li confronta con le feature delle regioni all'interno di una head convoluzionale.
Le alternative più simili accettano tutte un prompt testuale, ma solo YOLOE e SAM 3 restituiscono maschere; i tre modelli rispondono a domande diverse:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Progettato per | Rilevamento e segmentazione in tempo reale di classi specificate per nome | Segmentazione di concetti e tracking guidato da prompt | Rilevamento open-vocabulary in tempo reale |
| Maschere | Sì, con i checkpoint *-seg.pt | Sì | No, solo riquadri |
| Prompt visivi | Sì (SAVPE) | Sì | No |
| Modalità senza prompt | Sì, vocabolario di 4,585 nomi | No | No |
| Sceglilo quando | Ti serve throughput e puoi specificare le classi | Ti serve la migliore segmentazione di concetti e puoi sostenere il costo computazionale | Lo stai già usando — vedi la nota sulla migrazione qui sotto |
Stai passando da YOLO-World? L'API ha la stessa struttura: sostituisci YOLOWorld con YOLOE, carica un checkpoint *-seg.pt e lascia invariata la chiamata set_classes(). Ottieni maschere e prompt visivi; la nota sull'esportazione relativa alle classi bloccate vale per entrambi.
Casi d'uso e applicazioni#
Il rilevamento open-vocabulary elimina la necessità di riaddestrare il modello per ogni classe, un vantaggio importante soprattutto quando l'elenco dei target non è noto in anticipo:
- Rilevamento in scenari aperti — robotica e sistemi di sicurezza che incontrano oggetti non enumerati durante l'addestramento.
- Rilevamento one-shot a partire da un esempio — i prompt visivi individuano un componente, un logo o un difetto specifico a partire da un singolo riquadro di riferimento, una funzione utile nell'ispezione industriale.
- Catalogazione delle classi a coda lunga — il vocabolario integrato di 4,585 nomi è abbastanza ampio per attività di monitoraggio della biodiversità o inventario retail.
- Creazione iniziale del dataset — pre-etichetta immagini con riquadri e maschere prima della revisione umana, quindi addestra sul risultato un modello veloce a insieme chiuso.
- Segmentazione di target arbitrari — i checkpoint
*-seg.ptrilasciati restituiscono una maschera con ogni predizione, così l'imaging medico e l'analisi satellitare ottengono risultati precisi a livello di pixel senza un secondo modello.
Un approccio comune combina due modalità: esegui una volta la modalità senza prompt per scoprire cosa è presente, poi passa ai prompt testuali per le categorie rilevanti.
Limitazioni#
YOLOE sacrifica l'accuratezza per consentire di modificare le classi in fase di inferenza. Ecco cosa conviene sapere prima di adottarlo:
- L'accuratezza zero-shot è molto inferiore a quella di un modello addestrato sulle tue classi. I checkpoint con prompt raggiungono circa 22-40 mAP su LVIS minival; un modello YOLO a insieme chiuso addestrato sui tuoi dati otterrà risultati migliori su quelle classi. Scegli YOLOE per coprire classi per cui non puoi addestrare un modello, non per sostituire l'addestramento.
- Le categorie rare sono il punto debole. La colonna mAPr in Prestazioni riporta specificamente l'accuratezza sulle classi rare di LVIS e, con i prompt testuali, è inferiore alle colonne delle classi comuni e frequenti in ogni riga. Se i tuoi target sono insoliti, controlla questo valore invece del mAP principale.
- Un prompt descrive l'aspetto, non le relazioni. Il rilevamento funziona confrontando le feature delle regioni con l'embedding del prompt, quindi i prompt che dipendono da stato, contesto o confronto — «danneggiato», «il più a sinistra», «quello che viene trasportato» — non offrono un riferimento affidabile da abbinare. Preferisci formulazioni simili ai nomi di categorie di uso comune.
- Gli insiemi di prompt grandi aumentano la latenza. Gli embedding dei prompt vengono calcolati una sola volta, ma a ogni passaggio forward sono confrontati con le feature delle regioni. Su CPU con
yoloe-26s-seg.pt, il tempo di un passaggio forward aumenta di circa il 19% passando da 80 a 1,203 classi e di circa l'89% con il vocabolario completo di 4,585 nomi. I FLOPs riportati non cambiano affatto, perché la similarità tra regione e testo non viene conteggiata, quindi il profilo non ti avviserà. - I nomi delle classi sono segnaposto finché non imposti i prompt. Un checkpoint
*-seg.ptappena caricato restituiscenc=80con nomi numerici ("0","1", …), quindi chiamaset_classes()prima di leggere le etichette. I checkpoint senza prompt includono già l'intero vocabolario.
Note sulla distribuzione#
- Hardware. L'inferenza richiede una GPU NVIDIA con 4-8 GB di VRAM; le scale
nesfunzionano su GPU edge come Jetson oppure su CPU a risoluzione ridotta. Il fine-tuning richiede una singola GPU. - Per impostazione predefinita, NMS non distingue le classi. YOLOE esegue la predizione con
agnostic_nms=True. Per impostazione predefinita, questa sopprime i riquadri sovrapposti con punteggio inferiore tra classi diverse, invece di agire solo all'interno della stessa classe, evitando i duplicati quando un oggetto corrisponde a più categorie. Connms=False, YOLOE-26 non applica alcuna soppressione IoU; la modalità agnostica mantiene solo la classe migliore per anchor, invece di consentire a un anchor di produrre più etichette di classe. Passaagnostic_nms=Falseper modificare questo comportamento. - Per i prompt visivi, il valore predefinito è
conf=0.05. Le box dei prompt visivi sono corrette più spesso di quanto suggeriscano i loro punteggi: su LVIS minival, usando come prompt un'istanza di una classe,conf=0.25non rileva dal 44 al 55% delle altre istanze che YOLOE-26 rileva conconf=0.05. Le scene dense con oggetti quasi identici, come gli scaffali dei negozi o le cellule, possono richiedere valori più bassi; connms=False, la testa one-to-one di YOLOE-26 ottiene punteggi ancora più bassi, con la soglia ottimale vicina a0.01. Tutte le altre chiamate mantengonoconf=0.25, incluse quelle successive, gli embedding salvati e le esportazioni che riutilizzano le classi impostate darefer_image. Passaconfper sovrascrivere questo valore. - Elaborazione in batch. L'inferenza in batch funziona direttamente e i prompt visivi possono essere diversi per ogni immagine nella stessa chiamata.
Addestrare da zero i modelli ufficiali#
La maggior parte dei lettori non ne ha bisogno. Questa procedura riproduce i checkpoint open-vocabulary pubblicati a partire da Objects365, GQA e Flickr30k — circa 1.4 M di campioni di addestramento su 8× RTX 4090 — e non riguarda il fine-tuning sui tuoi dati, descritto sopra in Utilizzo dell'addestramento.
Tutti i trainer che ereditano da YOLOETrainer rifiutano compile=True, compresi il YOLOESegTrainer predefinito e tutti i trainer da zero qui sotto. Passa compile=False (il valore predefinito). I due trainer per il fine-tuning usati sopra, YOLOEPESegTrainer e YOLOEPETrainer, non hanno questa limitazione.
L'addestramento richiede annotazioni di segmentazione. Puoi scaricare i file elaborati qui sotto oppure generarne di tuoi con lo script fornito dal team ufficiale, basato su SAM 2.1. La validazione usa LVIS minival.
| Dataset | Tipo | Campioni | Riquadri | Annotazioni di segmentazione elaborate |
|---|---|---|---|---|
| Objects365v1 | Rilevamento | 609k | 9621k | objects365_train_segm.json |
| GQA | Grounding | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Grounding | 149k | 641k | final_flickr_separateGT_train_segm.json |
Il modello con prompt testuali viene addestrato per primo; le altre due modalità di prompting sono sue versioni perfezionate:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # oppure il percorso a un file YAML con la stessa struttura
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
I checkpoint visual-prompt e prompt-free partono dal modello text-prompt addestrato e aggiornano un modulo ciascuno. YOLOESegVPTrainer è la ricetta visual-prompt e YOLOEPEFreeTrainer quella prompt-free, ma nessuna delle due classi congela qualcosa autonomamente: l'addestramento selettivo dipende dall'elenco freeze che passi insieme alla classe, che include tutti i componenti secondari della head tranne savpe (rispettivamente, ogni torre di classificazione); l'esecuzione prompt-free richiede inoltre single_cls=True. Il repository YOLOE upstream contiene le ricette complete per i modelli di scala v8.
Un'esecuzione prompt-free completata viene riparametrizzata in un checkpoint che riporta i nomi senza prompt durante l'inferenza, usando get_vocab e set_vocab:
from ultralytics import YOLOE

# I pesi scritti dall'esecuzione prompt-free e dall'esecuzione text-prompt da cui è partita. Ogni
# riesecuzione crea una nuova directory (train-2, train-3, ...), quindi usa i percorsi stampati dalle esecuzioni.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # esecuzione prompt-free, la sua head è già fusa
text_model = YOLOE("runs/segment/train/weights/best.pt")  # esecuzione text-prompt, la sua head non è ancora fusa

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # il vocabolario di 4,585 nomi o un tuo elenco
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt")  # non sovrascrivere mai il checkpoint rilasciato
get_vocab restituisce il ramo selezionato dal flag end2end del modello e set_vocab riparametrizza quel ramo. I file YOLOE-26 rilasciati contengono invece un vocabolario per ramo, che consente a nms di scegliere tra i due; riproduci questo comportamento prendendo il secondo vocabolario da un'altra copia del modello text-prompt. YOLOE-11 e YOLOE-v8 hanno un solo ramo, quindi usano la chiamata precedente senza modifiche.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab fonde la head che legge, quindi carica una seconda copia
one2one_model.model.end2end = True  # leggi il ramo senza NMS

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Citazioni e ringraziamenti#
Se YOLOE ha contribuito alla tua ricerca o al tuo progetto, cita il documento originale di Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han e Guiguang Ding della Tsinghua University:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Per approfondire, il documento originale di YOLOE è disponibile su arXiv. Puoi accedere al codice sorgente del progetto e ad altre risorse tramite il repository GitHub.
Domande frequenti#
Ultralytics YOLOE aggiunge due funzionalità assenti in YOLO-World: prompt visivi, in cui un riquadro di esempio sostituisce il nome della classe, e checkpoint prompt-free che rispondono usando un vocabolario integrato di 4,585 nomi, senza alcun prompt. Ogni predizione dei checkpoint
*-seg.ptrilasciati include anche una maschera di segmentazione delle istanze. In termini di accuratezza, il documento originale di YOLOE mostra che YOLOE-v8s supera YOLO-Worldv2-S di 3.5 AP su LVIS, con un terzo del costo di addestramento e una velocità di inferenza 1.4× superiore. Per la migrazione basta una modifica di una riga: consulta Confronto tra YOLOE e altri modelli.Ultralytics YOLOE supporta tre modalità di prompting. Un prompt testuale consiste in nomi di classi sotto forma di stringhe con un checkpoint
*-seg.pted è la scelta più comune. Un prompt visivo consiste in uno o più riquadri di esempio su un'immagine di riferimento, per oggetti difficili da descrivere a parole. L'inferenza prompt-free usa un checkpoint*-seg-pf.ptseparato, che risponde usando un vocabolario integrato di 4,585 nomi senza che tu debba fornire nulla. I prompt testuali e visivi usano gli stessi checkpoint; quelli prompt-free sono file diversi e rifiutanoset_classes(). Consulta Scelta di una modalità di prompting per il confronto completo.Inizia con
yoloe-26s-seg.pt: la famiglia YOLOE-26 è superiore a YOLOE-11 e YOLOE-v8 a ogni scala corrispondente, e la scalasè la più piccola con oltre 30 mAP su LVIS minival. Passa am,loxquando l'accuratezza sulle categorie rare conta più della latenza: confronta la colonna mAPr in Prestazioni. Sceglinsolo per la distribuzione su dispositivi edge. Quando vuoi usare il vocabolario integrato anziché i tuoi nomi di classe, carica il file*-seg-pf.ptdella stessa scala.Etichette come
object0eobject1indicano che la predizione proviene da un prompt visivo, che raggruppa i riquadri di esempio in classi numerate temporanee anziché usare i tuoi nomi. Gli ID di classe che passi invisual_prompts["cls"]servono solo a creare questi gruppi. Il modello li restituisce comeobject0,object1e così via, nell'ordine degli ID assegnati, quindi riconducili alle tue etichette nei risultati. Se vuoi che nell'output compaiano i tuoi nomi, usa invece un prompt testuale.I checkpoint senza prompt (
*-seg-pf.pt) risolvono le classi tramite il proprio vocabolario integrato e rifiutanoset_classes()conAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.; i prompt visivi generanoAssertionError: Visual prompts need an unfused YOLOE model.. Carica un checkpoint*-seg.ptquando ti serve un elenco di classi personalizzato. Consulta Scelta di una modalità di prompting.Al primo prompt testuale, Ultralytics YOLOE installa ultralytics/CLIP da GitHub con
pipe scarica un encoder di testo TorchScript nella directory di lavoro corrente: circa 254 MB per YOLOE-26. Consulta Installazione e requisiti per conoscere l'asset esatto per ogni famiglia di modelli. I prompt visivi e i checkpoint prompt-free non richiedono né l'uno né l'altro. Per evitare il download sulla macchina di destinazione, imposta i prompt una volta e salvali consave_prompt_embeddings(), oppure esporta il modello con le classi già configurate.No: YOLOE incorpora nei pesi le classi specificate con i prompt al momento dell'esportazione, quindi un modello esportato caricato rifiuta sia
set_classes()siavisual_prompts=. Riesporta il checkpoint originale.ptdopo aver configurato i nuovi prompt. Il file esportato si comporta come un modello YOLO standard e può essere caricato conYOLO()eYOLOE().Usa YOLOE quando ti serve un throughput in tempo reale e puoi specificare i nomi delle classi; usa SAM 3 quando la qualità della segmentazione di un concetto conta più della velocità. Entrambi accettano esempi visivi; solo YOLOE offre una modalità prompt-free. Il confronto completo è disponibile in Confronto tra YOLOE e altri modelli.


Commenti60
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(modificato)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(modificato)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.