モデルデプロイのベストプラクティス
はじめに#
モデルデプロイは、モデルを開発段階から実世界のアプリケーションに移行させるコンピュータービジョンプロジェクトの工程です。モデルデプロイの選択肢にはさまざまなものがあります。クラウドデプロイは拡張性とアクセスのしやすさに優れ、エッジデプロイはモデルをデータソースに近づけてレイテンシを削減し、ローカルデプロイはプライバシーと制御性を確保します。適切な戦略はアプリケーションのニーズによって異なり、速度、セキュリティ、拡張性のバランスを考慮する必要があります。
視聴: AIモデルの最適化とデプロイ方法:ベストプラクティス、トラブルシューティング、セキュリティ上の考慮事項
モデルのデプロイは、パフォーマンスの有効性や信頼性に大きく影響するため、ベストプラクティスに従うことも重要です。このガイドでは、モデルをスムーズかつ効率的に、安全にデプロイする方法に焦点を当てます。
モデルのデプロイ方法#
多くの場合、モデルのトレーニング、評価、テストが完了した後、クラウド、エッジ、ローカルデバイスなど、さまざまな環境で効果的にデプロイするために特定の形式へ変換する必要があります。
YOLO26では、デプロイのニーズに応じてモデルをさまざまな形式にエクスポートできます。たとえば、YOLO26をONNXにエクスポートするのは簡単で、フレームワーク間でモデルを移行するのに適しています。統合方法をさらに確認し、さまざまな環境でスムーズにデプロイするには、モデル統合カタログをご覧ください。
デプロイ環境の選択#
コンピュータービジョンモデルのデプロイ先は、複数の要素によって異なります。環境ごとにメリットと課題が異なるため、ニーズに最も合った環境を選ぶことが重要です。
クラウドデプロイ#
クラウドデプロイは、迅速なスケールアップや大量のデータ処理が必要なアプリケーションに適しています。AWS、Google Cloud、Azureなどのプラットフォームを利用すれば、トレーニングからデプロイまでモデルを簡単に管理できます。Amazon SageMaker、Google Vertex AI、Azure Machine Learningなどのサービスが、プロセス全体を支援します。Ultralytics Platformでは、世界42のリージョンにある専用エンドポイントにもYOLOモデルをデプロイできます。
ただし、クラウドの利用は、特にデータ使用量が多い場合にコストがかさむことがあります。また、ユーザーがデータセンターから遠い場合は、レイテンシの問題が発生する可能性があります。コストとパフォーマンスを管理するには、リソースの使用を最適化し、データプライバシー規則への準拠を徹底することが重要です。
エッジデプロイ#
エッジデプロイは、リアルタイム応答と低レイテンシが必要なアプリケーション、特にインターネット接続が限られている、または利用できない環境に適しています。スマートフォンやIoTデバイスなどのエッジデバイスにモデルをデプロイすると、処理が高速になり、データをローカルに保持できるため、プライバシーが向上します。また、クラウドに送信するデータが減るため、エッジデプロイは帯域幅の節約にもなります。
ただし、エッジデバイスは処理能力が限られていることが多いため、モデルの最適化が必要です。LiteRTやNVIDIA Jetsonなどのランタイムやハードウェアプラットフォームが役立ちます。利点がある一方で、多数のデバイスの保守や更新は困難な場合があります。
ローカルデプロイ#
データのプライバシーが重要な場合や、インターネット接続が不安定または利用できない場合は、ローカルデプロイが最適です。ローカルサーバーやデスクトップでモデルを実行すれば、完全な制御が可能になり、データの安全性も保たれます。サーバーがユーザーの近くにある場合は、レイテンシの削減にもつながります。
ただし、ローカル環境でのスケーリングは難しく、保守にも時間がかかる場合があります。コンテナ化にDocker、管理にKubernetesなどのツールを使用すると、ローカルデプロイをより効率的に行えます。すべてを円滑に稼働させるには、定期的な更新と保守が必要です。
スムーズなデプロイを実現するコンテナ化#
コンテナ化では、モデルとすべての依存関係を、コンテナと呼ばれる標準化された単位にパッケージ化します。この手法により、異なる環境でも一貫したパフォーマンスを確保し、デプロイプロセスを簡素化できます。
モデルのデプロイにDockerを使用するメリット#
Dockerが機械学習のデプロイにおけるコンテナ化の業界標準となっているのには、いくつかの理由があります。
- 環境の一貫性: Dockerコンテナはモデルとすべての依存関係を内包します。開発、テスト、本番環境で一貫した動作を確保し、「自分の環境では動く」という問題を解消します。
- 分離: コンテナはアプリケーションを互いに分離し、異なるソフトウェアバージョンやライブラリ間の競合を防ぎます。
- 移植性: DockerコンテナはDockerに対応するあらゆるシステムで実行できるため、変更を加えずにさまざまなプラットフォームへモデルを簡単にデプロイできます。
- 拡張性: コンテナは需要に応じて簡単にスケールアップまたはスケールダウンでき、Kubernetesなどのオーケストレーションツールでこのプロセスを自動化できます。
- バージョン管理: Dockerイメージをバージョン管理できるため、変更を追跡し、必要に応じて以前のバージョンにロールバックできます。
YOLO26のデプロイにDockerを導入する#
YOLO26モデルをコンテナ化するには、必要な依存関係と設定をすべて指定したDockerfileを作成します。基本的な例を以下に示します。
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
この方法により、開発、テスト、本番環境で再現性と一貫性のあるモデルデプロイを実現できます。
モデル最適化の手法#
コンピュータービジョンモデルを最適化すると、特にエッジデバイスのようなリソースが限られた環境にデプロイする際に、効率よく実行できるようになります。モデルを最適化する主な手法を以下に紹介します。
モデルのプルーニング#
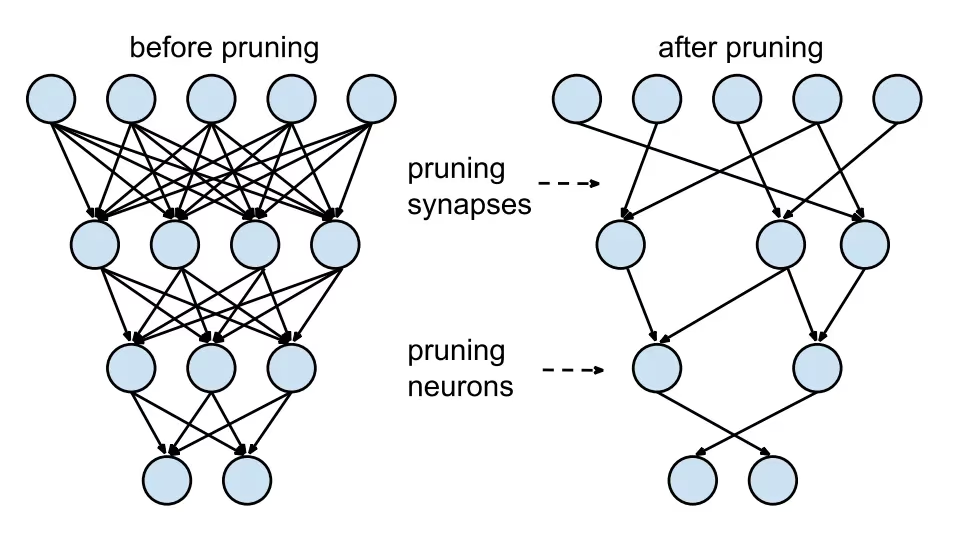
プルーニングでは、最終出力への寄与が小さい重みを削除して、モデルのサイズを小さくします。精度に大きな影響を与えずに、モデルを小型化して高速化できます。プルーニングでは不要なパラメーターを特定して削除することで、必要な計算能力が少ない軽量なモデルを実現します。リソースが限られたデバイスにモデルをデプロイする場合に特に有効です。
モデルの量子化#
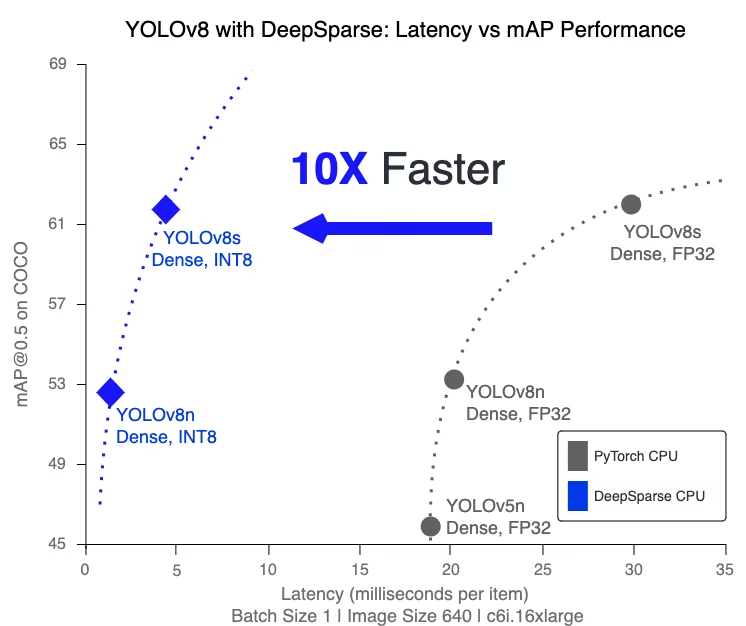
量子化では、モデルの重みとアクティベーションを高精度(32ビット浮動小数点数など)から低精度(8ビット整数など)に変換します。モデルサイズを小さくすることで、推論を高速化できます。量子化対応トレーニング(QAT)は、量子化を考慮してモデルをトレーニングする手法であり、トレーニング後の量子化よりも精度を維持しやすくなります。トレーニング段階で量子化を扱うことで、モデルは低精度に適応することを学習し、計算負荷を抑えながらパフォーマンスを維持します。Ultralytics YOLOでは、トレーニング後のINT8量子化にはエクスポート時にquantize=8を設定し、QATにはトレーニング時に設定します。
知識蒸留#
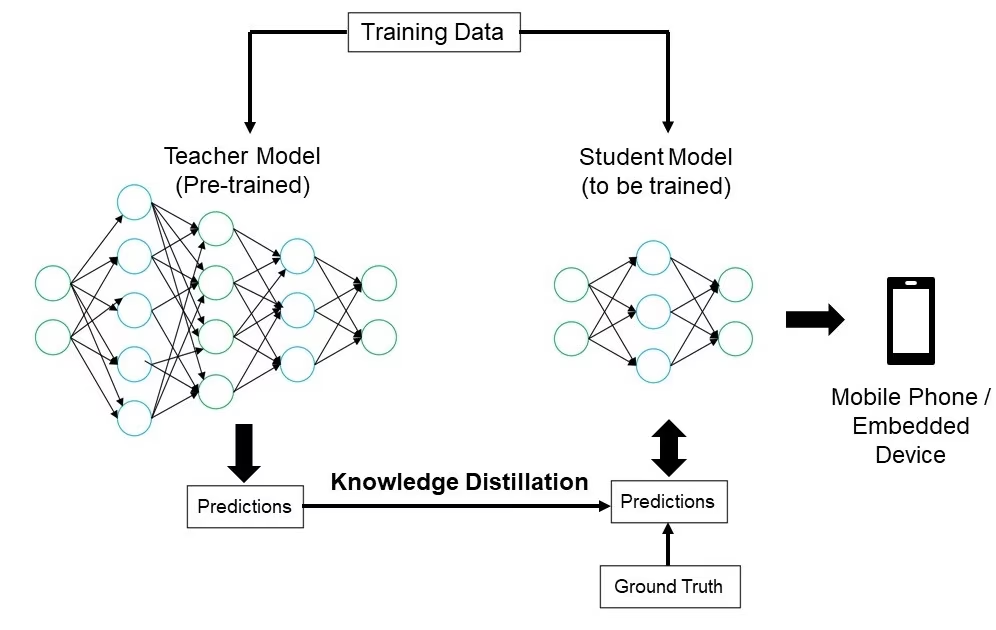
知識蒸留では、大規模で複雑なモデル(教師モデル)の出力を模倣するように、小規模でシンプルなモデル(生徒モデル)をトレーニングします。生徒モデルは教師モデルの予測を近似するよう学習し、教師モデルの精度を多く維持したコンパクトなモデルになります。この手法は、リソースが限られたエッジデバイスへのデプロイに適した効率的なモデルの作成に有効です。Ultralytics YOLOでは、トレーニング引数distill_modelを使用して知識蒸留をサポートしています。
デプロイ時の問題のトラブルシューティング#
コンピュータービジョンモデルのデプロイ時に問題が発生することがありますが、よくある問題と解決策を理解しておくと、プロセスをスムーズに進められます。デプロイ時の問題に対処するための一般的なトラブルシューティングのヒントとベストプラクティスを紹介します。
デプロイ後にモデルの精度が低下する#
デプロイ後にモデルの精度が低下する原因はさまざまです。問題を特定して解決するための手順を以下に示します。
- データの一貫性を確認する: デプロイ後にモデルが処理するデータが、トレーニングに使用したデータと一貫していることを確認します。データ分布、品質、形式の違いは、パフォーマンスに大きな影響を与える可能性があります。
- 前処理手順を検証する: 学習時に適用したすべての前処理手順が、デプロイ時にも一貫して適用されていることを確認します。画像のリサイズ、ピクセル値の正規化、その他のデータ変換が含まれます。
- モデルの実行環境を評価する: デプロイ時に使用するハードウェアとソフトウェアの構成が、学習時の構成と一致していることを確認します。ライブラリ、バージョン、ハードウェア性能の違いによって、差異が生じる可能性があります。
- モデルの推論を監視する: 推論パイプラインのさまざまな段階で入力と出力を記録し、異常がないか検出します。データの破損やモデル出力の不適切な処理などの問題を特定するのに役立ちます。
- モデルのエクスポートと変換を確認する: モデルを再エクスポートし、変換プロセスによってモデルの重みとアーキテクチャの整合性が維持されていることを確認します。
- 管理されたデータセットでテストする: 管理下にあるデータセットを使ってテスト環境にモデルをデプロイし、学習時の結果と比較します。問題の原因がデプロイ環境にあるのか、データにあるのかを特定できます。
YOLO26のデプロイ時には、複数の要因がモデルの精度に影響する可能性があります。TensorRTなどの形式へのモデル変換では、重みの量子化やレイヤーの融合などの最適化が行われ、わずかな精度低下が生じることがあります。FP32(単精度)の代わりにFP16(半精度)を使用すると推論を高速化できますが、数値精度の誤差が発生する可能性があります。また、Jetson NanoのようにCUDAコア数やメモリ帯域幅が限られたハードウェアも、パフォーマンスに影響する可能性があります。
推論に予想以上の時間がかかる#
機械学習モデルをデプロイする際は、効率的に実行できることが重要です。推論に予想以上の時間がかかると、ユーザー体験やアプリケーションの有効性に影響する可能性があります。問題を特定して解決するための手順を紹介します。
- ウォームアップ実行を行う: 初回の実行にはセットアップのオーバーヘッドが含まれることが多く、レイテンシの測定値に影響します。レイテンシを測定する前に、ウォームアップ推論を数回実行します。初回の実行を除外すると、モデルのパフォーマンスをより正確に測定できます。
- 推論エンジンを最適化する: 推論エンジンが、使用するGPUアーキテクチャに合わせて十分に最適化されていることを再確認します。最大限のパフォーマンスと互換性を確保するため、ハードウェアに適した最新のドライバーとソフトウェアバージョンを使用します。
- 非同期処理を使用する: 非同期処理によって、ワークロードをより効率的に管理できます。複数の推論を同時に処理する非同期処理の手法を使うと、負荷を分散し、待ち時間を短縮できます。
- 推論パイプラインをプロファイリングする: 推論パイプラインのボトルネックを特定すると、遅延の原因を絞り込めます。プロファイリングツールを使って推論プロセスの各段階を分析し、非効率なレイヤーやデータ転送の問題など、大きな遅延を引き起こす段階を特定して対処します。
- 適切な精度を使用する: 必要以上に高い精度を使用すると、推論時間が長くなる可能性があります。FP32(単精度)の代わりに、エクスポート時に
quantize=16を指定してFP16などの低精度を使用することを検討してください。FP16は推論時間を短縮できますが、モデルの精度に影響する可能性がある点にも留意してください。
YOLO26のデプロイ時にこの問題が発生する場合は、YOLO26にはさまざまなモデルサイズがあることを考慮してください。たとえば、メモリ容量が少ないデバイスにはYOLO26n(ナノ)、より高性能なGPUにはYOLO26x(特大サイズ)が適しています。ハードウェアに合ったモデルのバリエーションを選ぶと、メモリ使用量と処理時間のバランスを取りやすくなります。
また、入力画像のサイズがメモリ使用量と処理時間に直接影響する点にも注意してください。解像度を下げるとメモリ使用量を抑えて推論を高速化できます。一方、解像度を上げると精度が向上しますが、より多くのメモリと処理能力が必要です。
モデルのデプロイにおけるセキュリティ上の考慮事項#
デプロイにおけるもう1つの重要な要素はセキュリティです。デプロイしたモデルのセキュリティは、機密データや知的財産を保護するうえで不可欠です。モデルを安全にデプロイするために実践できるベストプラクティスを紹介します。
データ転送の保護#
クライアントとサーバー間で送信されるデータを保護することは、傍受や不正アクセスを防ぐために不可欠です。TLS(トランスポート層セキュリティ)などの暗号化プロトコルを使用して、データの送信中に暗号化できます。第三者がデータを傍受しても、その内容を読み取ることはできません。また、送信元から宛先までデータを保護するエンドツーエンド暗号化を使用すれば、途中の第三者がデータにアクセスできなくなります。
アクセス制御#
不正な利用を防ぐため、モデルとそのデータにアクセスできるユーザーを制御することが不可欠です。モデルへのアクセスを試みるユーザーやシステムの身元を確認するために強力な認証方式を使用し、多要素認証(MFA)による追加のセキュリティ対策も検討します。ロールベースアクセス制御(RBAC)を設定してユーザーの役割に応じて権限を割り当て、必要な範囲にのみアクセスできるようにします。モデルとそのデータへのすべてのアクセスや変更を追跡する詳細な監査ログを保持し、不審なアクティビティがないか定期的に確認します。
モデルの難読化#
モデルの難読化によって、モデルのリバースエンジニアリングや不正利用を防止できます。ニューラルネットワークの重みやバイアスなどのモデルパラメーターを暗号化し、不正なユーザーがモデルの内容を理解したり変更したりするのを困難にします。また、レイヤーやパラメーターの名前を変更したり、ダミーレイヤーを追加したりしてモデルのアーキテクチャを難読化すると、攻撃者によるリバースエンジニアリングがさらに困難になります。セキュアエンクレーブやトラステッド実行環境(TEE)などの安全な環境でモデルをサービングすると、推論中の保護をさらに強化できます。
まとめと次のステップ#
コンピュータービジョンモデルのデプロイ時に実践すべきベストプラクティスをいくつか紹介しました。データの保護、アクセス制御、モデルの詳細の難読化によって、モデルを円滑に稼働させながら機密情報を保護できます。また、ウォームアップ実行、エンジンの最適化、非同期処理、パイプラインのプロファイリング、適切な精度の選択などの方法を使って、精度低下や推論の遅延といった一般的な問題に対処する方法も説明しました。
モデルのデプロイ後は、アプリケーションの監視、保守、ドキュメント化が次のステップです。定期的な監視により問題をすばやく検出して修正でき、保守によってモデルを最新かつ正常な状態に保てます。また、適切なドキュメントで変更や更新をすべて記録できます。これらの手順は、コンピュータービジョンプロジェクトの目標の達成に役立ちます。
よくある質問#
機械学習モデル、特にUltralytics YOLO26をデプロイする際は、効率性と信頼性を確保するためにいくつかのベストプラクティスがあります。まず、ニーズに合ったデプロイ環境として、クラウド、エッジ、ローカルのいずれかを選びます。リソースが限られた環境で効率的にデプロイできるよう、プルーニング、量子化、知識蒸留などの手法でモデルを最適化します。異なる環境間で一貫性を確保するため、Dockerによるコンテナ化の使用を検討します。最後に、パフォーマンスを維持できるよう、データの一貫性と前処理手順を学習時の設定に合わせます。詳しいガイドラインについては、モデルのデプロイオプションも参照してください。
デプロイ時の問題は、いくつかの重要な手順に分けてトラブルシューティングできます。デプロイ後にモデルの精度が低下した場合は、データの一貫性を確認し、前処理手順を検証して、ハードウェアとソフトウェアの環境が学習時のものと一致していることを確認します。推論が遅い場合は、ウォームアップ実行を行い、推論エンジンを最適化し、非同期処理を使用して、推論パイプラインをプロファイリングします。ベストプラクティスの詳細については、デプロイ時の問題のトラブルシューティングを参照してください。
エッジデバイス向けにUltralytics YOLO26モデルを最適化するには、プルーニングによるモデルサイズの縮小、量子化による重みの低精度化、知識蒸留による大規模モデルを模倣する小型モデルの学習などの手法を使用します。これらの手法によって、計算能力が限られたデバイスでもモデルを効率的に実行できます。LiteRTやNVIDIA Jetsonなどのツールは、こうした最適化に特に役立ちます。これらの手法について詳しくは、モデルの最適化のセクションをご覧ください。
機械学習モデルのデプロイでは、セキュリティが最も重要です。TLSなどの暗号化プロトコルを使って、安全なデータ転送を確保します。強力な認証やロールベースアクセス制御(RBAC)など、堅牢なアクセス制御を実装します。モデルパラメーターの暗号化や、トラステッド実行環境(TEE)などの安全な環境でのモデルのサービングといった難読化手法によって、保護を強化できます。具体的な対策については、セキュリティ上の考慮事項を参照してください。


コメント10
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
 TaoBenHui
shafa~hahaha
Taufiq-Ahmed
Hi, I Have trained my custom dataset on yolov8s model. Now I want to optimized the model by using pruning and quantization. could you please tell me How I can implement it and what is the python code of it?
 Paula DerrengerUltralytics
@Taufiq-Ahmed to optimize your YOLOv8 model using pruning and quantization, you can follow these steps:
-
Pruning: This involves removing weights that contribute little to the final output, making the model smaller and faster. You can use libraries like TensorFlow Model Optimization Toolkit or PyTorch's pruning methods.
-
Quantization: This converts the model's weights and activations from high precision (e.g., 32-bit floats) to lower precision (e.g., 8-bit integers), reducing model size and speeding up inference. You can use TensorFlow Lite for post-training quantization or PyTorch's quantization tools.
For detailed guidance and code examples, please refer to the Ultralytics documentation on model optimization. This resource provides comprehensive instructions and best practices for deploying and optimizing your models effectively.
-
Thank you so much for your reply. One think I would like to know, is it possible to do pruning and quantization in my YOLOv8 best.pt model with TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. Do do I need to convert it and also need to convert my dataset from YOLO format to any other format?
- Paula DerrengerUltralytics
Yes, you can perform pruning and quantization on your YOLOv8 model using TensorFlow Model Optimization Toolkit or PyTorch's pruning methods. You don't need to convert your dataset format, but you may need to convert your model to a compatible format like ONNX if using TensorFlow tools. For PyTorch, you can directly apply pruning and quantization techniques. For detailed steps, please refer to the Ultralytics documentation on model deployment practices.
Thank you for your reply. could you please give me any git hub repositories or any coding example on how to apply pruning and quantization techniques on the best.pt model on custom dataset. and how will i maintain the accuracy of the model.
- Paula DerrengerUltralytics
@Taufiq-Ahmed for pruning and quantization of your YOLOv8 model, you can use PyTorch's built-in functionalities. You don't need to convert your dataset format. For pruning, you can use
torch.nn.utils.prune, and for quantization, you can usetorch.quantization. If you need specific code examples, please let me know. For more detailed guidance, you can refer to the Ultralytics documentation on model deployment practices. Thank you for your reply. it would be better for me if you share a coding example of how to prune and quantize the model on the custom data to reduce it's size and weights using pytorch and how to ´maintain it's accuracy. do I need to train it again or there is some other way to maintain it's accuracy.
Hi could you please check whether this idea works:
import torch import torch.nn as nn from torch.nn.utils import prune from ultralytics import YOLO
model = YOLO('best.pt')
def gradual_prune_model(model, prune_step=0.05, prune_iterations=10): for i in range(prune_iterations):
    for name, module in model.model.named_modules():
        if isinstance(module, nn.Conv2d):
            prune.l1_unstructured(module, name='weight', amount=prune_step)
            prune.remove(module, 'weight')  # Remove pruning reparameterization

    print(f'Fine-tuning after pruning iteration {i+1}/{prune_iterations}')
    model.train(data='dataset.yaml', epochs=2, lr=1e-4)
gradual_prune_model(model, prune_step=0.05, prune_iterations=10)
print('Final fine-tuning after pruning') model.train(data='/path/to/your/dataset.yaml', epochs=10, lr=1e-5)
model.save('pruned_yolov8.pt')
is this pruned technique works? and after pruning is this the right way to regain it's accuracy?
- Paula DerrengerUltralytics
Your approach to pruning looks good. Gradual pruning followed by fine-tuning can help maintain accuracy. After pruning, fine-tuning with a lower learning rate is essential to regain any lost accuracy. For quantization, you can use PyTorch's quantization tools. Ensure you validate the model's performance after each step. For more detailed guidance, refer to the Ultralytics documentation on model deployment practices.