SAM 3:概念であらゆるものをセグメント化
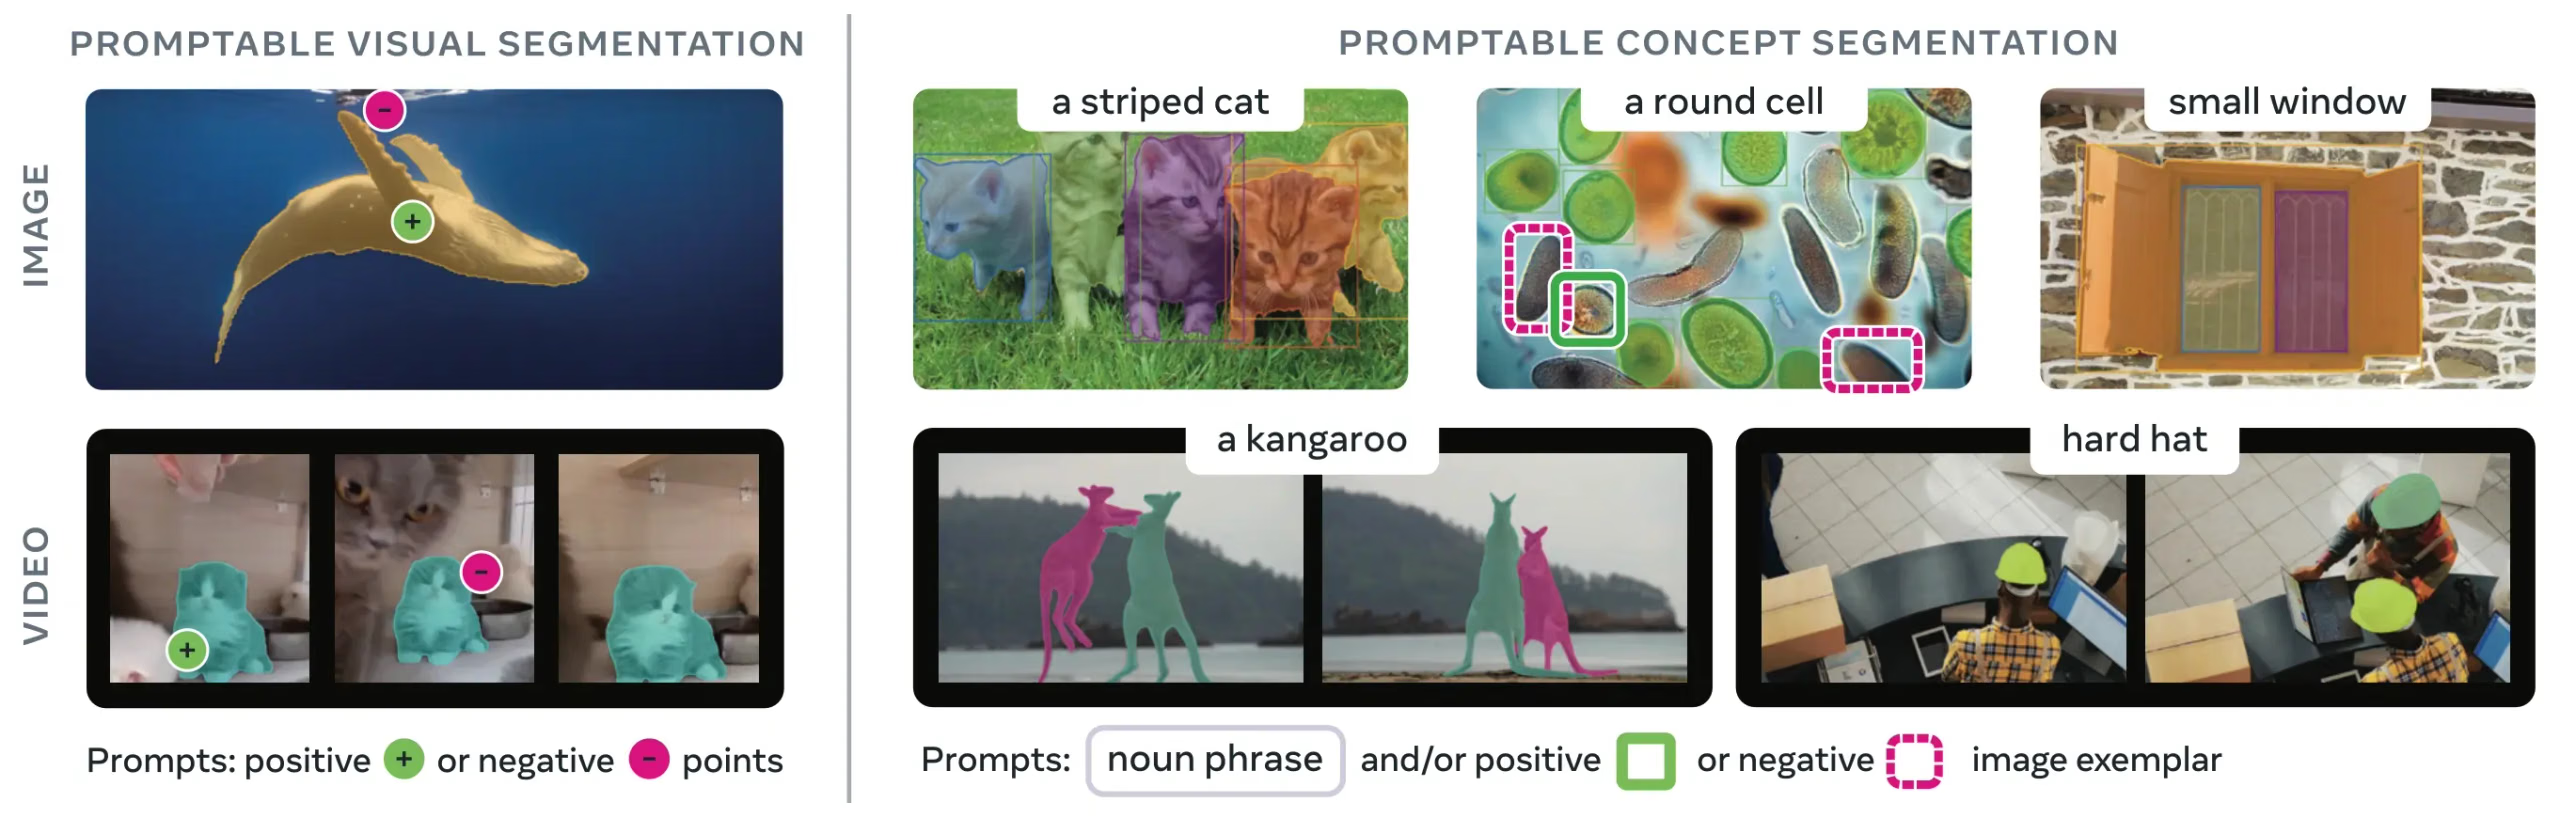
SAM 3(Segment Anything Model 3)は、Promptable Concept Segmentation(PCS)向けのMetaの基盤モデルです。SAM 2を基盤として、SAM 3では新たな機能が導入されています。テキストプロンプト、画像の例、またはその両方で指定した視覚的概念について、すべてのインスタンスを検出、セグメント化、追跡できます。プロンプトごとに単一の物体をセグメント化する従来のSAMバージョンとは異なり、SAM 3は画像や動画内のあらゆる場所に現れる概念の全出現箇所を検出してセグメント化でき、現代のインスタンスセグメンテーションにおけるオープンボキャブラリーの目標に沿っています。
視聴: Ultralytics で Meta Segment Anything 3 を使う方法 | 画像・動画のテキストプロンプトセグメンテーション
SAM 3はultralyticsパッケージに完全に統合されており、テキストプロンプト、画像の例示プロンプト、動画追跡を使用した概念セグメンテーションをネイティブにサポートします。新しいSAM 3.1チェックポイントは、画像予測に対応しています。
概要#
SAM 3はPromptable Concept Segmentationにおいて既存システムを上回る2倍の性能向上を達成すると同時に、インタラクティブな画像セグメンテーションにおけるSAM 2の機能を維持・強化しています。このモデルはオープンボキャブラリーセグメンテーションに優れており、簡単な名詞句(例:「黄色いスクールバス」「縞模様の猫」)や対象物の例画像を使って、概念を指定できます。Ultralyticsでは、SAM 3はpredictモードで動作し、追跡用に専用の動画予測器を提供しています。
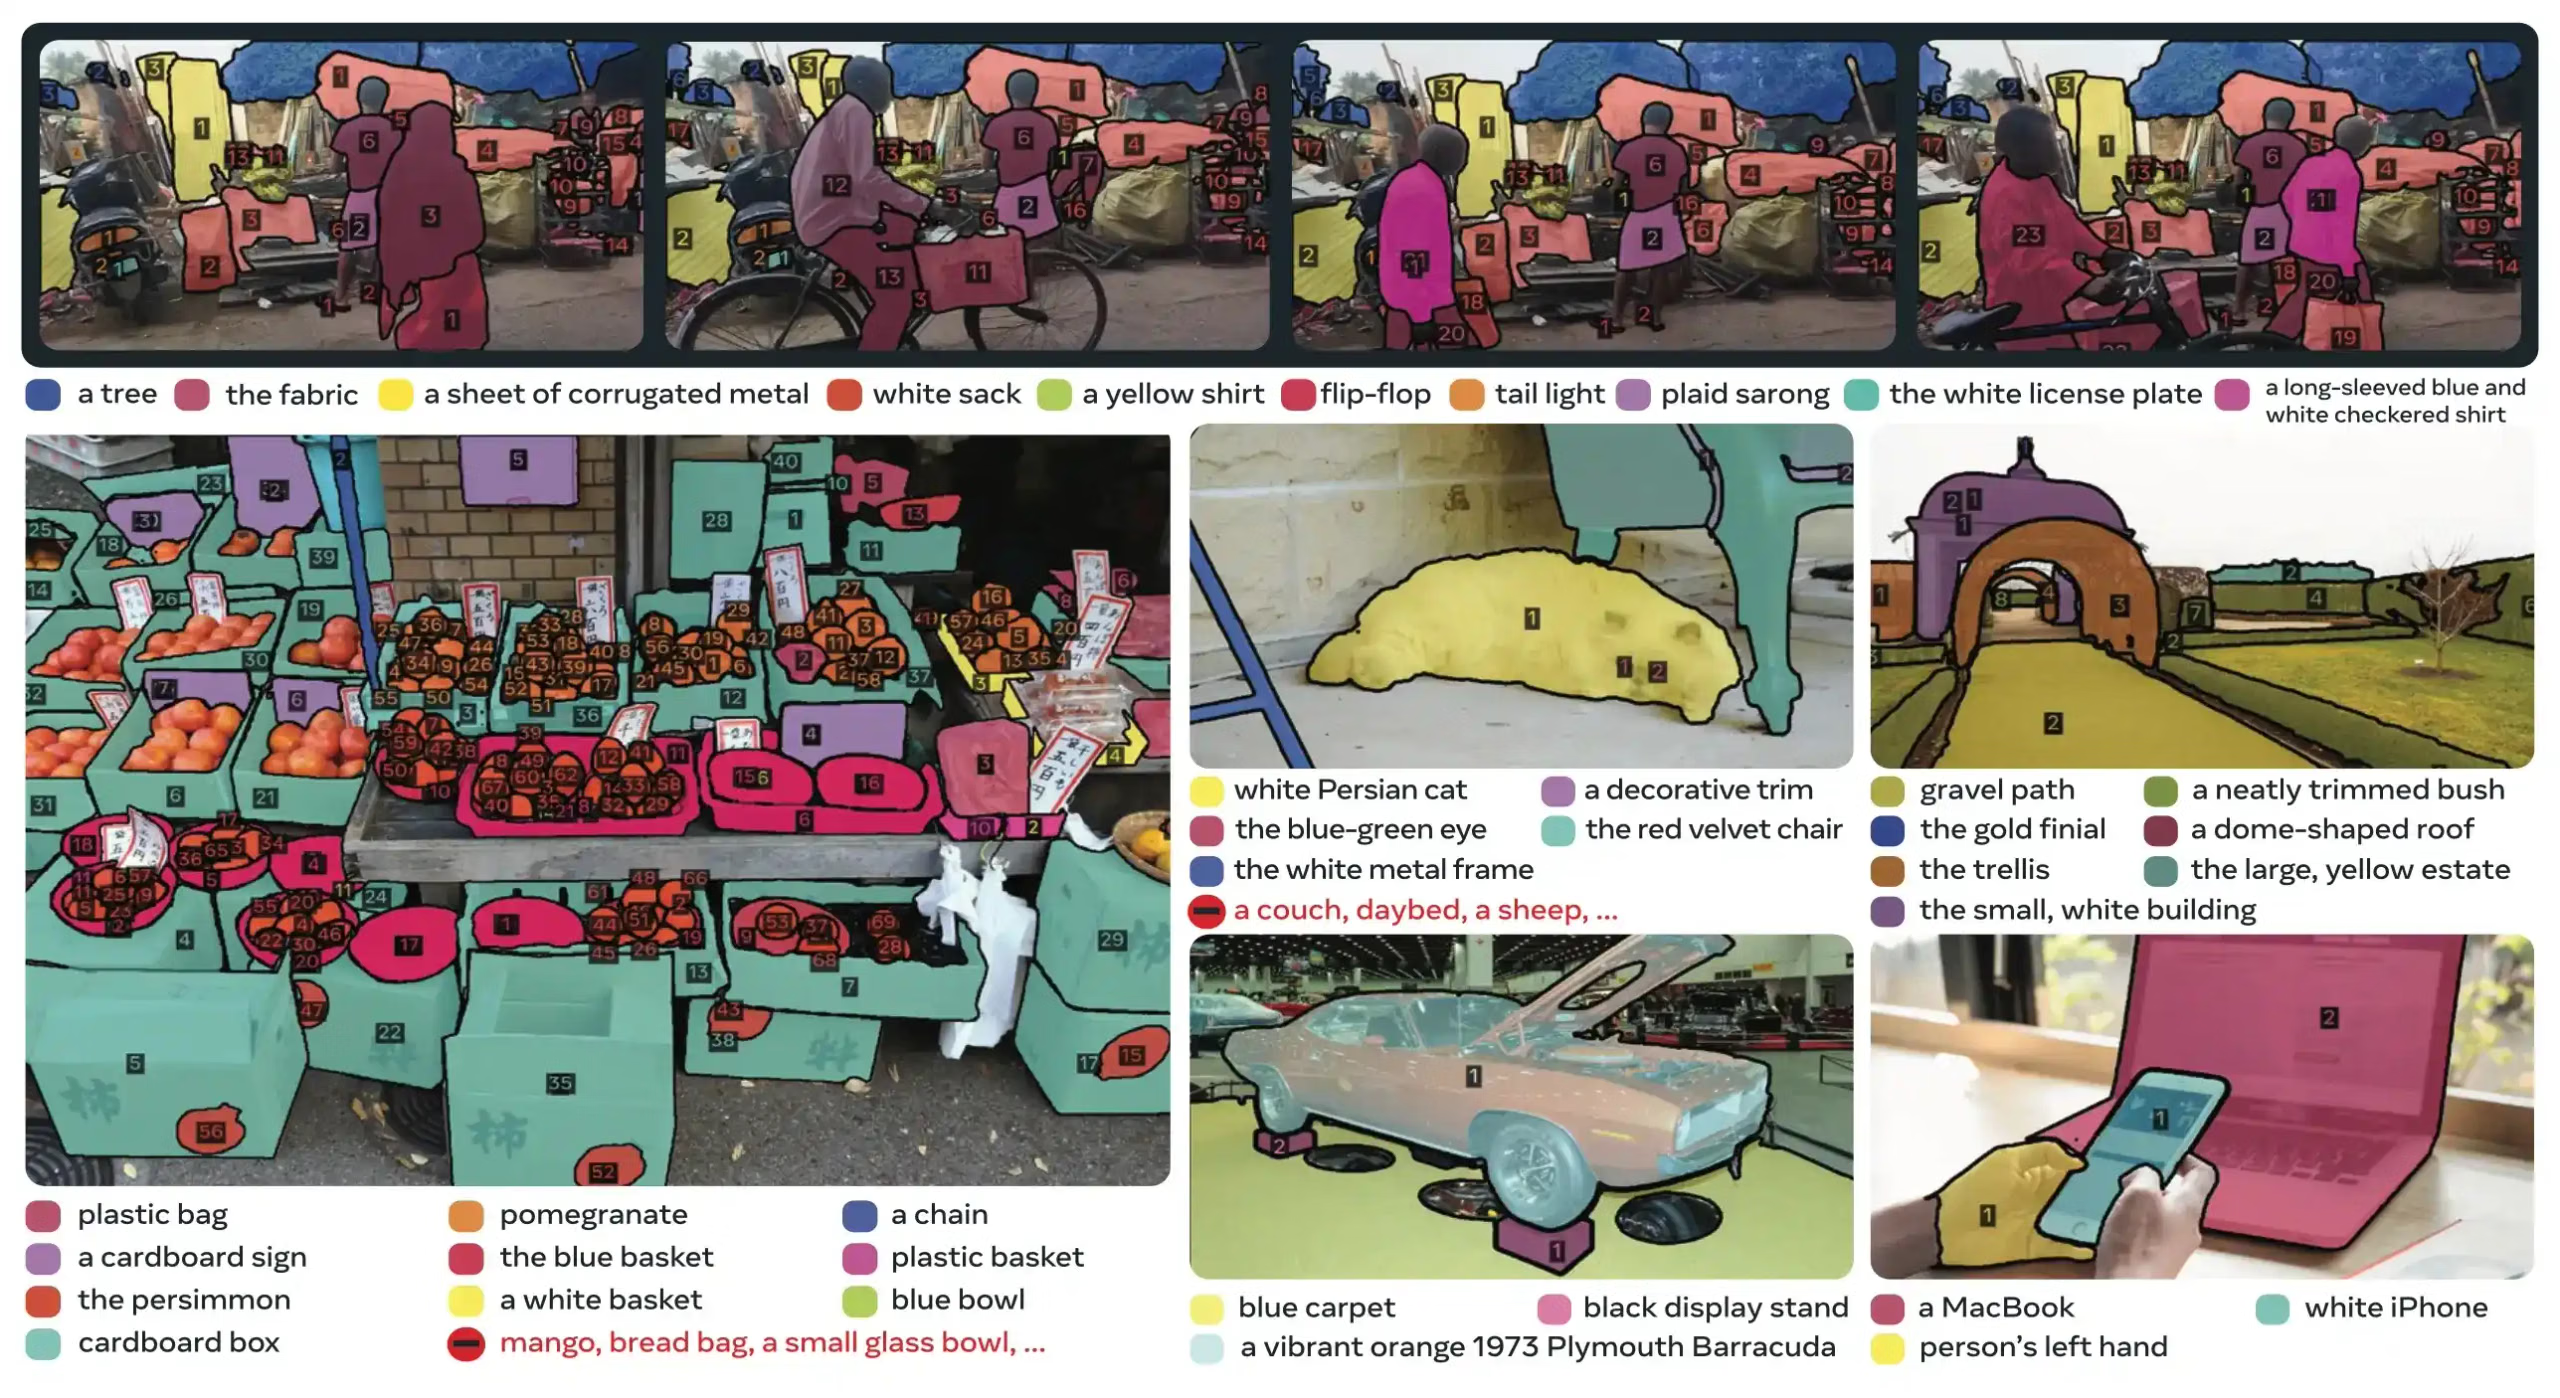
プロンプト可能な概念セグメンテーション(PCS)とは何ですか?#
PCSタスクは概念プロンプトを入力として受け取り、一致するすべての物体インスタンスに対して、一意のIDを持つセグメンテーションマスクを返します。概念プロンプトには次のものを指定できます。
- テキスト:「赤いリンゴ」や「帽子をかぶった人」などの簡単な名詞句で、ゼロショット学習に似ています。
- 画像の例示:素早く汎化できるように、対象物の例(ポジティブまたはネガティブ)をバウンディングボックスで指定します。
- 組み合わせ:テキストと画像の例示を併用して、正確に制御します。
これは、元祖SAMファミリーで広く知られるようになった、ポイント、ボックス、マスクなどの従来の視覚プロンプトが、特定の単一の物体インスタンスのみをセグメント化するのとは異なります。
主な性能指標#
| 指標 | SAM 3の達成値 |
|---|---|
| LVISゼロショットマスクAP | 47.0(従来の最高値38.5に対して22%向上) |
| SA-Coベンチマーク | 既存システムを2倍上回る |
| 推論速度(H200 GPU) | 100個以上の物体を検出する場合、画像あたり30 ms |
| 動画性能 | 約5個のオブジェクトを同時に扱う場合、ほぼリアルタイム~ |
| MOSEv2 VOSベンチマーク | 60.1 J&F(SAM 2.1を25.5%、従来のSOTAを17%上回る) |
| インタラクティブな調整 | 例示プロンプト3件の後にCGF1が+18.6向上 |
| 人間の性能との差 | SA-Co/Goldで推定された下限値の88%を達成 |
本番環境におけるモデル指標とトレードオフの背景については、モデル評価の分析とYOLOの性能指標をご覧ください。
SAM 3.1#
2026年3月27日にMetaが公開したSAM 3.1は、マルチオブジェクト動画追跡に共有メモリ方式のObject Multiplexを追加する、新しいSAM 3チェックポイントです。追跡対象を個別に処理する代わりに、SAM 3.1は対象を固定容量のバケットにまとめて同時に処理します。Metaによると、単一のH100 GPUで128個のオブジェクトを処理した場合、速度が約7倍向上します。画像検出器とインタラクティブなポイントプロンプトヘッドは、SAM 3のアーキテクチャを維持しています。
| ベンチマーク | 指標 | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V(テスト) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B(テスト) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses(テスト) | cgF1 | 36.4 | 36.3 |
| MOSEv1(検証) | J&F | 78.4 | 79.6 |
| DAVIS17(検証) | J&F | 92.2 | 92.7 |
| SA-V(テスト) | J&F | 84.4 | 85.1 |
| YTVOS19(検証) | G | 89.7 | 89.3 |
| MOSEv2(検証) | J&Ḟ | 60.3 | 62.3 |
UltralyticsはSAM 3.1チェックポイント(sam3.1_multiplex.pt)をSAM 3の画像予測器に読み込みます。ポイントプロンプトとボックスプロンプトにはSAM("sam3.1_multiplex.pt")を、テキストプロンプトと例示プロンプトにはSAM3SemanticPredictorを使用します。Object Multiplexによる動画追跡はまだサポートされていないため、引き続きsam3.ptとSAM3VideoPredictor、SAM3VideoSemanticPredictorを使用してください。
アーキテクチャ#
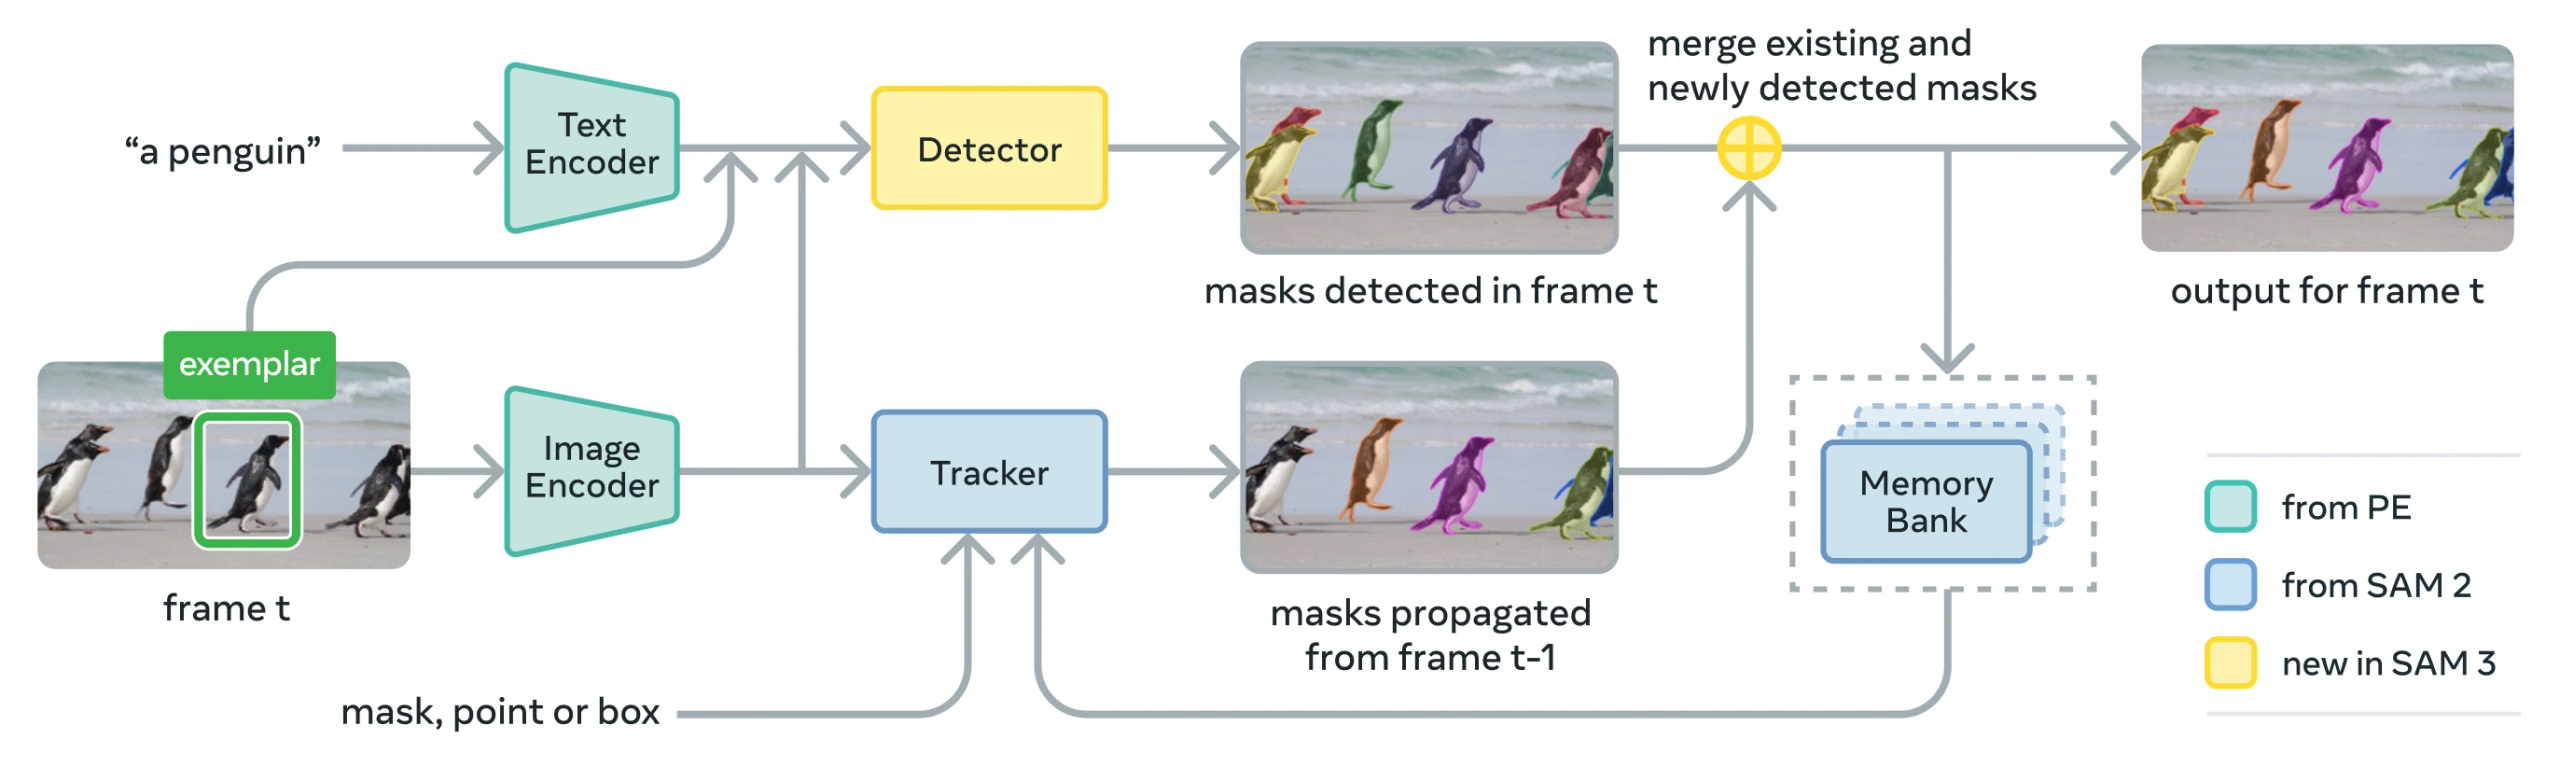
SAM 3は、Perception Encoder(PE)ビジョンバックボーンを共有する検出器とトラッカーで構成されています。この分離設計により、タスク間の競合を避けながら、画像レベルの検出と動画レベルの追跡の両方を実現し、UltralyticsのPythonの使用方法とCLIの使用方法に対応するインターフェースを提供します。
主要コンポーネント#
-
検出器:DETRベースのアーキテクチャによる画像レベルの概念検出
- 名詞句プロンプト用のテキストエンコーダー
- 画像ベースのプロンプト用の例示エンコーダー
- プロンプトに基づいて画像特徴を条件付けるフュージョンエンコーダー
- 認識(「何」)と位置特定(「どこ」)を分離する新しい存在ヘッド
- インスタンスセグメンテーションマスクを生成するマスクヘッド
-
トラッカー:SAM 2から継承した、メモリベースの動画セグメンテーション
- プロンプトエンコーダー、マスクデコーダー、メモリエンコーダー
- フレーム間で物体の外観を保存するメモリバンク
-
Presence Token:対象の概念が画像またはフレーム内に存在するかを予測する学習済みのグローバルトークンです。認識と位置特定を分離することで、検出精度を向上させます。
主な革新点#
- 認識と位置特定の分離: presence headは概念の存在をグローバルに予測し、proposal queryは位置特定のみに焦点を当てることで、競合する目的を回避します。
- 概念プロンプトと視覚プロンプトの統合: 1つのモデルでPCS(概念プロンプト)とPVS(SAM 2のクリックやボックスなどの視覚プロンプト)の両方をサポートします。
- インタラクティブな例示画像の調整: ユーザーは正例または負例の画像例を追加して結果を段階的に調整できます。モデルは個々のインスタンスを修正するだけでなく、類似したオブジェクトにも汎化します。
- 時間的な曖昧さの解消: maskletの検出スコアと定期的なプロンプトの再入力を使用して、動画内のオクルージョン、混雑したシーン、トラッキングの失敗に対処し、インスタンスセグメンテーションとトラッキングのベストプラクティスに沿って処理します。
SA-Coデータセット#
SAM 3はSegment Anything with Concepts (SA-Co)でトレーニングされています。これはMetaがこれまでに構築した中で最大かつ最も多様なセグメンテーションデータセットであり、COCOやLVISなどの一般的なベンチマークを超える範囲をカバーします。
トレーニングデータ#
| データセットの構成要素 | 説明 | 規模 |
|---|---|---|
| SA-Co/HQ | 4段階のデータエンジンで作成された、高品質な人手アノテーション付き画像データ | 520万枚の画像、400万個の固有の名詞句 |
| SA-Co/SYN | 人手を介さずAIがラベル付けした合成データセット | 3,800万個の名詞句、14億個のマスク |
| SA-Co/EXT | ハードネガティブを追加した15個の外部データセット | ソースによって異なります |
| SA-Co/VIDEO | 時間方向のトラッキングを含む動画アノテーション | 5万2,500本の動画、2万4,800個の固有の名詞句 |
ベンチマークデータ#
SA-Co評価ベンチマークには、12万6,000本の画像と動画にわたる21万4,000個の固有フレーズが含まれており、既存のベンチマークの50倍を超える概念を提供します。次の項目が含まれます。
- SA-Co/Gold: 7つのドメインを対象とし、人間の性能上限を測定するために3名がアノテーション
- SA-Co/Silver: 10のドメインを対象とし、人手によるアノテーションは1回
- SA-Co/BronzeおよびSA-Co/Bio: 概念セグメンテーション向けに適応した9つの既存データセット
- SA-Co/VEval: 3つのドメイン(SA-V、YT-Temporal-1B、SmartGlasses)を含む動画ベンチマーク
データエンジンの革新点#
SAM 3のスケーラブルな人間とモデルが連携するデータエンジンは、次の仕組みによりアノテーション処理量を2倍にします。
- AIアノテーター:Llamaベースのモデルが、ハードネガティブを含む多様な名詞句を提案します
- AI検証器: ファインチューニング済みのマルチモーダルLLMが、ほぼ人間と同等の性能でマスクの品質と網羅性を検証します
- アクティブマイニング: AIが苦手とする難しい失敗事例に人間の作業を集中させます
- オントロジー駆動: Wikidataに基づく大規模オントロジーを使用して、概念の網羅性を高めます
インストール#
ultralyticsパッケージをインストールまたはアップグレードします。
pip install -U ultralytics他のUltralyticsモデルとは異なり、SAM 3のウェイト(sam3.pt)は自動的にダウンロードされません。まずHugging FaceのSAM 3モデルページでモデルウェイトへのアクセスをリクエストし、承認後にそのページからsam3.ptをダウンロードしてください。ダウンロードしたsam3.ptファイルを作業ディレクトリに配置するか、モデルの読み込み時にフルパスを指定してください。
SAM 3.1のウェイト(sam3.1_multiplex.pt)も、SAM 3.1のモデルページで同様にアクセスが制限されています。以下の画像の例でsam3.ptを使用している箇所では、sam3.1_multiplex.ptを指定してください。
予測時に上記のエラーが発生する場合は、正しくないclipパッケージがインストールされています。次のコマンドを実行して、正しいclipパッケージをインストールしてください。
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
SAM 3の使い方: 概念セグメンテーションの柔軟性#
SAM 3は、異なるpredictorインターフェースを通じて、プロンプト可能な概念セグメンテーション(PCS)とプロンプト可能な視覚セグメンテーション(PVS)の両方のタスクをサポートします。
サポート対象のタスクとモデル#
| タスクの種類 | プロンプトの種類 | 出力 |
|---|---|---|
| 概念セグメンテーション(PCS) | テキスト(名詞句)、画像の例 | 概念に一致するすべてのインスタンス |
| 視覚セグメンテーション(PVS) | ポイント、ボックス、マスク | 単一オブジェクトのインスタンス(SAM 2形式) |
| インタラクティブな調整 | 例示画像またはクリックを段階的に追加・削除 | 精度を向上させたセグメンテーション結果 |
概念セグメンテーションの例#
テキストプロンプトによるセグメンテーション#
テキストによる説明を使って、概念のすべてのインスタンスを検出してセグメント化します。テキストプロンプトにはSAM3SemanticPredictorインターフェースが必要です。
from ultralytics.models.sam import SAM3SemanticPredictor

# 設定を指定してpredictorを初期化
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # 推論を高速化するためにFP16を使用
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# 複数のクエリで画像を一度だけ設定
predictor.set_image("path/to/image.jpg")

# 複数のテキストプロンプトでクエリ
results = predictor(text=["person", "bus", "glasses"])

# 説明的なフレーズにも対応
results = predictor(text=["person with red cloth", "person with blue cloth"])

# 単一の概念でクエリ
results = predictor(text=["a person"])画像の例を使ったセグメンテーション#
類似するすべてのインスタンスを見つけるための視覚プロンプトとして、バウンディングボックスを使用します。概念ベースのマッチングにはSAM3SemanticPredictorも必要です。
from ultralytics.models.sam import SAM3SemanticPredictor

# predictorを初期化
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# 画像を設定
predictor.set_image("path/to/image.jpg")

# 類似オブジェクトをセグメント化するための例として、バウンディングボックスを指定
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# 同じ視覚概念の例として複数のバウンディングボックスを指定
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])効率を高める特徴量ベースの推論#
画像特徴量を一度抽出して複数のセグメンテーションクエリで再利用すると、効率が向上します。
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# predictorを初期化
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# 1つ目のpredictorから特徴量を抽出
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# 2つ目のpredictorをセットアップし、特徴量を再利用
predictor2.setup_model()

# 共有特徴量とテキストプロンプトを使って推論を実行
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# 共有特徴量とバウンディングボックスプロンプトを使って推論を実行
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# 結果を可視化
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
cv2.waitKey(0)動画の概念セグメンテーション#
バウンディングボックスで動画全体の概念をトラッキング#
バウンディングボックスのプロンプトを使って、動画のフレーム全体でオブジェクトのインスタンスを検出してトラッキングします。
from ultralytics.models.sam import SAM3VideoPredictor

# 動画predictorを作成
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# バウンディングボックスのプロンプトを使ってオブジェクトをトラッキング
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# 結果を処理して表示
for r in results:
r.show() # セグメンテーションマスクを重ねたフレームを表示テキストプロンプトで概念をトラッキング#
テキストで指定した概念のすべてのインスタンスを、動画のフレーム全体でトラッキングします。
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# セマンティック動画predictorを初期化
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# テキストプロンプトを使って概念をトラッキング
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# 結果を処理する
for r in results:
    r.show()  # トラッキング対象のオブジェクトを含むフレームを表示

# 別の方法: バウンディングボックスのプロンプトでトラッキング
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # 正例ラベル
    stream=True,
)
視覚プロンプト(SAM 2との互換性)#
SAM 3は、単一オブジェクトのセグメンテーションにおいて、SAM 2の視覚プロンプトとの完全な後方互換性を維持します。
基本のSAMインターフェースはSAM 2とまったく同じように動作し、視覚プロンプト(ポイント、ボックス、マスク)で示された特定の領域のみをセグメント化します。
from ultralytics import SAM

model = SAM("sam3.pt")

# 単一点プロンプト - 特定の位置にあるオブジェクトをセグメント化します
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# 複数点プロンプト - 複数の点ヒントを使って単一のオブジェクトをセグメント化します
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# ボックスプロンプト - バウンディングボックス内のオブジェクトをセグメント化します
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()ビジュアルプロンプト(点/ボックス/マスク)でSAM("sam3.pt")を使用すると、SAM 2と同様に、その位置にある特定のオブジェクトのみをセグメント化します。概念のすべてのインスタンスをセグメント化するには、上記のようにテキストまたは見本プロンプトでSAM3SemanticPredictorを使用します。
性能ベンチマーク#
画像セグメンテーション#
SAM 3は、LVISやセグメンテーション向けCOCOなどの実世界データセットを含む、複数のベンチマークで最高水準の結果を達成しています。
| ベンチマーク | 指標 | SAM 3 | 従来の最高値 | 改善幅 |
|---|---|---|---|---|
| LVIS(ゼロショット) | Mask AP | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34.3(OWLv2) | +89.5% |
| COCO(ゼロショット) | Box AP | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847(セマンティックセグメンテーション) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes(セマンティックセグメンテーション) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Ultralyticsのデータセットで、すぐに試せるデータセットのオプションをご確認ください。
動画セグメンテーション性能#
SAM 3は、DAVIS 2017やYouTube-VOSなどの動画ベンチマークで、SAM 2および従来の最先端手法を大きく上回ります。
| ベンチマーク | 指標 | SAM 3 | SAM 2.1 L | 改善幅 |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
少数ショット適応#
SAM 3は少数の例で新しいドメインに適応できるため、データ中心AIのワークフローで役立ちます。
| ベンチマーク | 0ショット AP | 10ショット AP | 従来の最高値(10ショット) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
インタラクティブな修正の効果#
SAM 3の見本を使った概念ベースのプロンプトは、ビジュアルプロンプトよりもはるかに速く収束します。
| 追加したプロンプト | CGF1スコア | テキストのみの場合との向上幅 | PVSベースラインとの向上幅 |
|---|---|---|---|
| テキストのみ | 46.4 | ベースライン | ベースライン |
| +1個の見本 | 57.6 | +11.2 | +6.7 |
| +2個の見本 | 62.2 | +15.8 | +9.7 |
| +3個の見本 | 65.0 | +18.6 | +11.2 |
| +4個の見本 | 65.7 | +19.3 | +11.5(プラトー) |
オブジェクトカウント精度#
SAM 3は、すべてのインスタンスをセグメント化することで正確なカウントを実現します。これはオブジェクトカウントでよく求められる機能です。
| ベンチマーク | 精度 | MAE | 最高のMLLMとの比較 |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
SAM 3、SAM 2、YOLOの比較#
ここでは、SAM 2やYOLO26モデルと比較して、SAM 3の機能を紹介します。
| 機能 | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| 概念セグメンテーション | ✅ テキスト/見本からすべてのインスタンスを検出 | ❌ 非対応 | ❌ 非対応 |
| ビジュアルセグメンテーション | ✅ 単一インスタンス(SAM 2互換) | ✅ 単一インスタンス | ✅ すべてのインスタンス |
| ゼロショット機能 | ✅ オープンボキャブラリー | ✅ 幾何学的プロンプト | ❌ クローズドセット |
| インタラクティブな調整 | ✅ 見本とクリック | ✅ クリックのみ | ❌ 非対応 |
| 動画トラッキング | ✅ ID付きの複数オブジェクト | ✅ 複数オブジェクト | ✅ 複数オブジェクト |
| LVIS Mask AP(ゼロショット) | 47.0 | 該当なし | 該当なし |
| MOSEv2 J&F | 60.1 | 47.9 | 該当なし |
| 速度(GPU、ms/画像) | 2921 | 857 | 8.4 |
| モデルサイズ | 3.45 GB | 162 MB(ベース) | 6.4 MB |
速度は、NVIDIA RTX PRO 6000でtorch==2.9.1およびultralytics==8.4.19を使用してベンチマークしました。
主なポイント:
- SAM 3: オープンボキャブラリーの概念セグメンテーションに最適です。テキストまたは見本プロンプトを使って、概念のすべてのインスタンスを検出します
- SAM 2: 幾何学的プロンプトを使って、画像や動画内の単一オブジェクトをインタラクティブにセグメント化するのに最適です
- YOLO26: オプションでNMSなしのエンドツーエンド推論に対応した、リアルタイムの高速セグメンテーションに最適です。多くの形式にエクスポートして、GPU、CPU、エッジデバイスにデプロイできます
- YOLOE:テキストまたは視覚的なプロンプトを使用した、リアルタイムのオープンボキャブラリー検出およびセグメンテーションに最適です
SAMとYOLOの比較#
UltralyticsのYOLOセグメンテーションモデル(YOLOv8、YOLO11、YOLO26)とSAM 3、SAM 2、SAM、MobileSAM、FastSAMを、サイズ、パラメーター数、GPU推論速度の観点から比較します。
| モデル | サイズ (MB) | パラメーター (M) | 速度(GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-sとYOLOv8のバックボーン | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7(515倍小型) | 3.4(139.1倍少ない) | 17.4(167倍高速) |
| Ultralytics YOLO11n-seg | 5.9(585倍小型) | 2.9(163.1倍少ない) | 12.6(231倍高速) |
| Ultralytics YOLO26n-seg | 6.4(539倍小型) | 2.7(175.2倍少ない) | 8.4(347倍高速) |
この比較から、SAMの各バリアントとYOLOのセグメンテーションモデルでは、モデルサイズと速度に大きな違いがあることがわかります。SAMは独自の自動セグメンテーション機能を備えていますが、YOLOモデル、特にYOLOv8n-seg、YOLO11n-seg、YOLO26n-segは、大幅に小型で高速かつ計算効率に優れています。
テストは、torch==2.9.1とultralytics==8.4.19を使用し、VRAM 96GBのNVIDIA RTX PRO 6000で実行しました。このテストを再現するには、次の手順に従ってください。
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# SAM3、SAM2-t、SAM2-b、SAM-b、MobileSAMのプロファイルを取得
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# FastSAM-sのプロファイルを取得
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# YOLOモデルのプロファイルを取得
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
model(ASSETS, nms=False) # YOLO26のNMSフリーヘッド。YOLOv8/YOLO11では何もしません評価指標#
SAM 3では、PCSタスク向けに新しい指標が導入され、F1スコア、適合率、再現率などの一般的な指標を補完します。
分類ゲート付きF1(CGF1)#
位置特定と分類を組み合わせた主要な指標です。
CGF1 = 100 × pmF1 × IL_MCC
各項目の説明:
- pmF1(陽性マクロF1):陽性例における位置特定の品質を測定します
- IL_MCC(画像レベルのマシューズ相関係数):二値分類の精度(「その概念が存在するか」)を測定します
これらの指標を使用する理由#
従来のAP指標ではキャリブレーションが考慮されないため、モデルを実用で使うのが困難です。信頼度が0.5を超える予測のみを評価することで、SAM 3の指標は良好なキャリブレーションを求め、インタラクティブな予測・追跡ループにおける実際の使用パターンを再現します。
主なアブレーションと知見#
Presence Headの影響#
Presence Headは認識と位置特定を分離し、大幅な改善をもたらします。
| 設定 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| presenceなし | 57.6 | 0.77 | 74.7 |
| presenceあり | 63.3 | 0.82 | 77.1 |
Presence Headにより、主に認識能力(IL_MCC +6.5%)が向上し、CGF1が+5.7ポイント(+9.9%)改善します。
ハードネガティブの効果#
| 画像あたりのハードネガティブ数 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
ハードネガティブはオープンボキャブラリー認識に不可欠であり、IL_MCCを54.5%(0.44 → 0.68)改善します。
学習データのスケーリング#
| データソース | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 外部データのみ | 30.9 | 0.46 | 66.3 |
| 外部データ+合成データ | 39.7 | 0.57 | 70.6 |
| 外部データ+高品質データ | 51.8 | 0.71 | 73.2 |
| 3種類すべて | 54.3 | 0.74 | 73.5 |
高品質な人手アノテーションは、合成データまたは外部データのみの場合と比べて大きな改善をもたらします。データ品質管理の実践については、データ収集とアノテーションをご覧ください。
用途#
SAM 3の概念セグメンテーション機能により、新たなユースケースが可能になります。
- コンテンツモデレーション:メディアライブラリ全体から、特定の種類のコンテンツをすべて検出します
- Eコマース:カタログ画像内の特定種類の商品をすべてセグメント化し、自動アノテーションを支援します
- 医用画像: 特定の組織タイプや異常のすべての出現箇所を特定します
- 自律システム:交通標識、歩行者、車両をカテゴリー別にすべて追跡します
- ビデオ分析:特定の服装をしている人や、特定の動作をしている人をすべてカウントして追跡します
- データセットのアノテーション:希少な物体カテゴリーのすべてのインスタンスを迅速にアノテーションします
- 科学研究:特定の条件に合致する標本をすべて定量化して分析します
SAM 3 Agent:拡張言語推論#
SAM 3は、複雑なクエリに対応するため、マルチモーダル大規模言語モデル(MLLM)と組み合わせることができます。これは、OWLv2やT-Rexのようなオープンボキャブラリーシステムと同様のアプローチです。
推論タスクでの性能#
| ベンチマーク | 指標 | SAM 3 Agent(Gemini 2.5 Pro) | 従来の最高値 |
|---|---|---|---|
| ReasonSeg(検証) | gIoU | 76.0 | 65.0(最高水準) |
| ReasonSeg(テスト) | gIoU | 73.8 | 61.3(最高水準) |
| OmniLabel(検証) | AP | 46.7 | 36.5(REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3(LISA) |
複雑なクエリの例#
SAM 3 Agentは、推論を必要とする次のようなクエリに対応できます。
- 「座っていて、手にギフトボックスを持っていない人」
- 「首輪をしていない、カメラに最も近い犬」
- 「人の手より大きい赤い物体」
MLLMはSAM 3に簡単な名詞句のクエリを提示し、返されたマスクを分析して、満足するまで処理を繰り返します。
制限事項#
SAM 3には次の制限があります。
- フレーズの複雑さ:簡単な名詞句に最適です。長い指示表現や複雑な推論には、MLLMとの統合が必要になる場合があります
- 曖昧さへの対応:「小さな窓」や「居心地のよい部屋」など、一部の概念には本質的な曖昧さが残ります
- 計算要件: YOLOのような専用検出モデルよりもサイズが大きく、速度が遅いです
- 語彙の範囲:視覚的な基本概念に特化しており、MLLMの支援がなければ合成的な推論には限界があります
- 希少な概念:学習データに十分含まれていない、極めて希少または粒度の細かい概念では、性能が低下する可能性があります
引用#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}よくある質問#
SAM 3は2025年11月19日にMetaがリリースし、
ultralyticsパッケージに完全に統合されています。専用予測器を通じて、画像予測と動画追跡に対応しています。はい。SAM 3はUltralytics Pythonパッケージに完全に統合されており、概念セグメンテーション、SAM 2形式の視覚プロンプト、複数物体の動画追跡に対応しています。SAM 3とSAM 3.1は、Ultralytics Platformのスマートアノテーション機能も支えています。SAM 3.1がデフォルトモデルで、数回のクリックだけで画像にアノテーションを付けられます。1~200クラスの検出データセットでは、SAM 3 TextとSAM 3.1 Textがクラス名から自動でアノテーションを付けることもできます。また、VLM Leaderboardでは、視覚言語モデルと精度を比較できます。
はい、画像の予測に対応しています。このページの画像の例で
sam3.ptを使用している箇所では、代わりにsam3.1_multiplex.ptを読み込んでください。ポイントとボックスのプロンプトにはSAM("sam3.1_multiplex.pt")、テキストと例示プロンプトにはSAM3SemanticPredictorを使用します。Object Multiplexのビデオトラッキングにはまだ対応していないため、ビデオ予測には引き続きsam3.ptを使用してください。Metaのベンチマークについては、SAM 3.1をご覧ください。PCSはSAM 3で導入された新しいタスクで、画像や動画内の視覚的概念のすべてのインスタンスをセグメント化します。特定の物体インスタンスを対象とする従来のセグメンテーションとは異なり、PCSはカテゴリーの出現箇所をすべて検出します。たとえば、次のように指定できます。
- テキストプロンプト:「黄色いスクールバス」→シーン内の黄色いスクールバスをすべてセグメント化します
- 画像の例示: 1匹の犬を囲む → 画像内のすべての犬をセグメント化します
- 組み合わせ: 「縞模様の猫」+ 例示ボックス → 例に一致するすべての縞模様の猫をセグメント化します
機能 SAM 2 SAM 3 タスク プロンプトごとに単一のオブジェクト 概念に該当するすべてのインスタンス プロンプトの種類 ポイント、ボックス、マスク + テキストフレーズ、画像の例示 検出機能 外部検出器が必要 オープンボキャブラリー検出器を内蔵 認識 形状情報のみに基づく テキストと視覚による認識 アーキテクチャ トラッカーのみ プレゼンスヘッドを備えた検出器 + トラッカー ゼロショット性能 該当なし(視覚プロンプトが必要) LVISで47.0 AP、SA-Coでは2倍の性能 インタラクティブな調整 クリックのみ クリック + 例示の汎化 SAM 3は、SAM 2の視覚プロンプトとの後方互換性を維持しながら、概念ベースの機能を追加しています。
SAM 3は、概念を用いたSegment Anything(SA-Co)データセットでトレーニングされています。
トレーニングデータ:
- 520万枚の画像と400万個の固有の名詞句(SA-Co/HQ)—高品質な人手アノテーション
- 5万2,500本の動画と2万4,800個の固有の名詞句(SA-Co/VIDEO)
- 38億個の名詞句にわたる14億個の合成マスク(SA-Co/SYN)
- ハードネガティブを追加した15件の外部データセット(SA-Co/EXT)
ベンチマークデータ:
- 12万6,000枚の画像・動画にわたる21万4,000個の固有の概念
- 既存のベンチマークの50倍の概念数(例: LVISは~4,000個の概念)
- 人間の性能範囲を測定するため、SA-Co/Goldに3重のアノテーションを実施
この規模と多様性が、オープンボキャブラリーの概念に対するSAM 3のゼロショット汎化を支えています。
SAM 3とYOLO26は、それぞれ異なる用途に適しています。
SAM 3の利点:
- オープンボキャブラリー: トレーニングなしで、テキストプロンプトからあらゆる概念をセグメント化できます
- ゼロショット: 新しいカテゴリにもすぐに対応できます
- インタラクティブ: 例示に基づく調整を、類似オブジェクトにも汎化できます
- 概念ベース: カテゴリに該当するすべてのインスタンスを自動的に検出します
- 精度: LVISのゼロショットインスタンスセグメンテーションで47.0 AP
YOLO26の利点:
- 速度: 推論は桁違いに高速で、オプションとしてNMSフリーのエンドツーエンドヘッドを利用できます
- 効率性: モデルサイズを539分の1に削減(6.4MB対3.45GB)
- リソース効率: エッジデバイスやモバイルデバイスで動作します
- リアルタイム: 本番環境へのデプロイ向けに最適化されています
推奨:
- テキストや例で説明された概念に該当するすべてのインスタンスを見つける必要がある、柔軟なオープンボキャブラリーセグメンテーションにはSAM 3を使用してください
- カテゴリが事前に分かっている本番環境への高速なデプロイにはYOLO26を使用してください
- 幾何学的プロンプトを使ったインタラクティブな単一オブジェクトのセグメンテーションにはSAM 2を使用してください
SAM 3は、シンプルな名詞句(例: 「赤いリンゴ」「帽子をかぶった人」)向けに設計されています。推論が必要な複雑なクエリには、SAM 3とMLLMを組み合わせてSAM 3 Agentとして使用してください。
シンプルなクエリ(SAM 3標準機能):
- 「黄色いスクールバス」
- 「縞模様の猫」
- 「赤い帽子をかぶった人」
複雑なクエリ(MLLMを使ったSAM 3 Agent):
- 「座っていて、ギフトボックスを持っていない人々」
- 「首輪をしていない、カメラに最も近い犬」
- 「人の手より大きい赤い物体」
SAM 3 Agentは、SAM 3のセグメンテーションとMLLMの推論機能を組み合わせることで、ReasonSeg検証セットにおいて76.0 gIoUを達成しています(従来の最高値65.0に対し、16.9%向上)。
人手で3重にアノテーションしたSA-Co/Goldベンチマークでの結果:
- 人間の下限値: 74.2 CGF1(最も保守的なアノテーター)
- SAM 3の性能: 65.0 CGF1
- 達成度: 推定される人間の下限値の88%
- 人間の上限値: 81.4 CGF1(最も寛容なアノテーター)
SAM 3は、オープンボキャブラリーの概念セグメンテーションで人間に近い精度を実現しており、主な差は曖昧または主観的な概念(例: 「小さな窓」「居心地のよい部屋」)に見られます。


コメント105
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
 Glenn JocherUltralytics(編集済み)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(編集済み)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(編集済み)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(編集済み)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(編集済み)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.