Kaggle을 사용하여 YOLO26 모델을 학습하는 방법 안내
AI를 배우고 소규모 프로젝트를 진행하고 있지만 아직 강력한 컴퓨팅 리소스를 이용하기 어렵고 고성능 하드웨어가 부담스러울 수 있습니다. Google이 소유한 플랫폼인 Kaggle은 GPU 리소스를 이용하고 대규모 데이터 세트를 처리하며 다양한 데이터 과학자 및 머신러닝 애호가 커뮤니티와 협업할 수 있는 무료 클라우드 기반 환경을 제공합니다.
Kaggle은 Ultralytics YOLO26 모델을 학습하고 실험하기에 실용적인 선택지입니다. Kaggle Notebooks에는 널리 사용되는 머신러닝 라이브러리와 프레임워크가 사전 설치되어 있습니다. 이 가이드에서는 Kaggle의 주요 기능을 살펴보고 플랫폼에서 YOLO26 모델을 학습하는 방법을 설명합니다.
Kaggle이란 무엇인가요?#
Kaggle은 전 세계 데이터 과학자들이 협업하고 배우며 실제 데이터 과학 문제 해결을 위해 경쟁할 수 있도록 지원하는 플랫폼입니다. Anthony Goldbloom과 Jeremy Howard가 2010년에 시작하고 Google이 2017년에 인수한 Kaggle에서는 사용자가 서로 연결되고, 데이터 세트를 찾아 공유하고, GPU 기반 노트북을 사용하고, 데이터 과학 대회에 참여할 수 있습니다. 이 플랫폼은 숙련된 전문가와 학습자 모두를 대상으로 합니다.
2022년 기준 사용자가 1,000만 명을 넘는 Kaggle은 머신러닝 모델을 개발하고 실험하기에 풍부한 환경을 제공합니다. 로컬 머신의 사양이나 설정은 걱정할 필요가 없습니다. Kaggle 계정과 웹 브라우저만 있으면 됩니다.
설치#
Kaggle에서 YOLO26 모델 학습을 시작하기 전에 노트북 환경이 올바르게 구성되었는지 확인해야 합니다. 다음 단계를 따르세요.
인터넷 액세스 활성화#
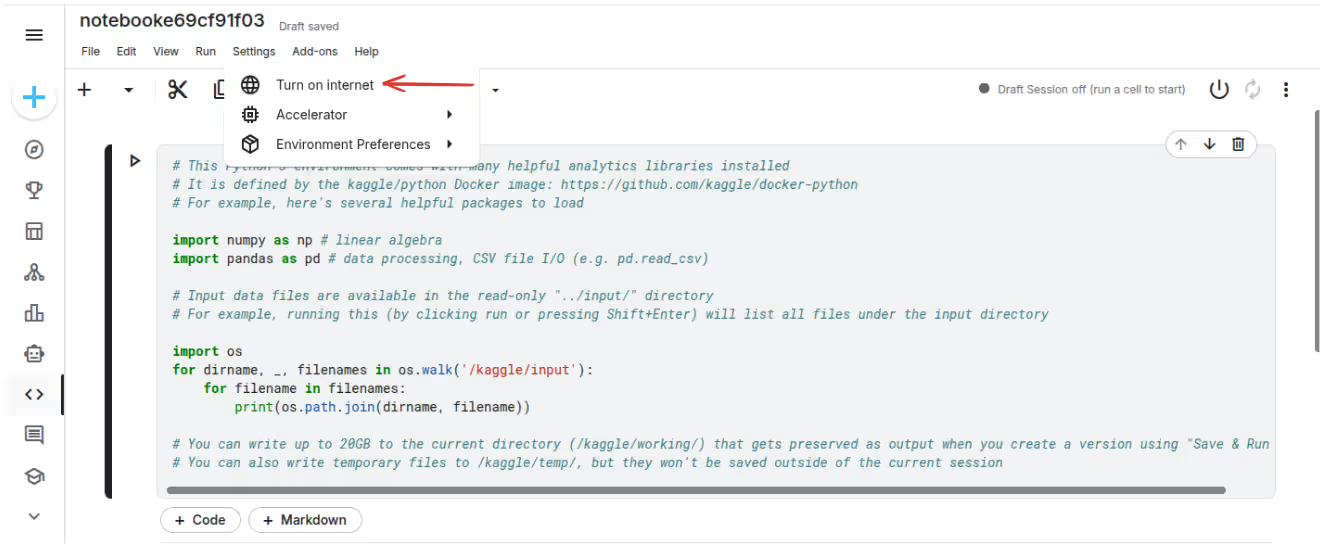
Kaggle 노트북에서 패키지와 종속 항목을 다운로드하려면 인터넷 액세스가 필요합니다. Kaggle 노트북에서 인터넷을 활성화하려면 다음을 수행하세요:
- Kaggle 노트북을 엽니다.
- 노트북 인터페이스 오른쪽에 있는 Settings 패널을 클릭합니다.
- 아래로 스크롤하여 Internet 섹션으로 이동합니다.
- 스위치를 ON으로 전환하여 인터넷 연결을 활성화합니다.
참고: Ultralytics 패키지를 설치하고 사전 학습된 모델이나 데이터 세트를 다운로드하려면 인터넷 액세스가 필요합니다. 인터넷을 활성화하지 않으면 패키지 설치가 실패합니다.
Ultralytics 설치#
인터넷 액세스를 활성화한 후 노트북 셀에서 다음 명령을 실행하여 Ultralytics 패키지를 설치합니다:
!pip install ultralytics최신 개발 버전을 설치하려면 GitHub에서 직접 설치할 수 있습니다:
!pip install git+https://github.com/ultralytics/ultralytics.git종속성 충돌 해결#
설치 중에 특히 opencv-python, numpy 또는 torch와 같은 패키지에서 종속성 충돌이 발생할 수 있습니다. 일반적인 해결 방법은 다음과 같습니다:
방법 1: --upgrade를 사용하여 강제 재설치#
기존 패키지와 충돌이 발생하면 업그레이드를 강제 실행합니다:
!pip install --upgrade --force-reinstall ultralytics방법 2: 설치 후 커널 다시 시작#
가져오기 문제를 해결하려면 설치 후 커널을 다시 시작해야 할 수도 있습니다:
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu
일반적인 오류 해결 방법#
오류: "No module named 'ultralytics'"
- 해결 방법: 인터넷이 활성화되어 있는지 확인한 다음 설치 명령을 다시 실행합니다.
- 설치 후 커널을 다시 시작합니다.
오류: "ERROR: pip's dependency resolver does not currently take into account..."
- 해결 방법: 이는 대개 경고이므로 무시해도 됩니다. 이 메시지가 표시되어도 설치는 일반적으로 성공합니다.
오류: 설치 후 "ModuleNotFoundError" 발생
- 해결 방법: 노트북 인터페이스의 다시 시작 버튼을 사용하여 커널을 다시 시작합니다.
- 새 셀에서 가져오기 문을 다시 실행합니다.
설치 확인#
설치가 완료되면 다음 명령을 실행하여 Ultralytics가 올바르게 설치되었는지 확인합니다:
import ultralytics

ultralytics.checks()
이 명령은 시스템 정보를 표시하고 모든 종속 항목이 올바르게 설치되었는지 확인합니다.
Kaggle에서 YOLO26 학습하기#
Kaggle의 무료 GPU를 사용하면 YOLO26 모델을 간편하게 학습할 수 있습니다.
시작하려면 Kaggle의 Ultralytics YOLO26 튜토리얼 노트북을 여세요. Kaggle 환경에는 TensorFlow 및 PyTorch와 같은 라이브러리가 사전 설치되어 있어 설정이 간편합니다.
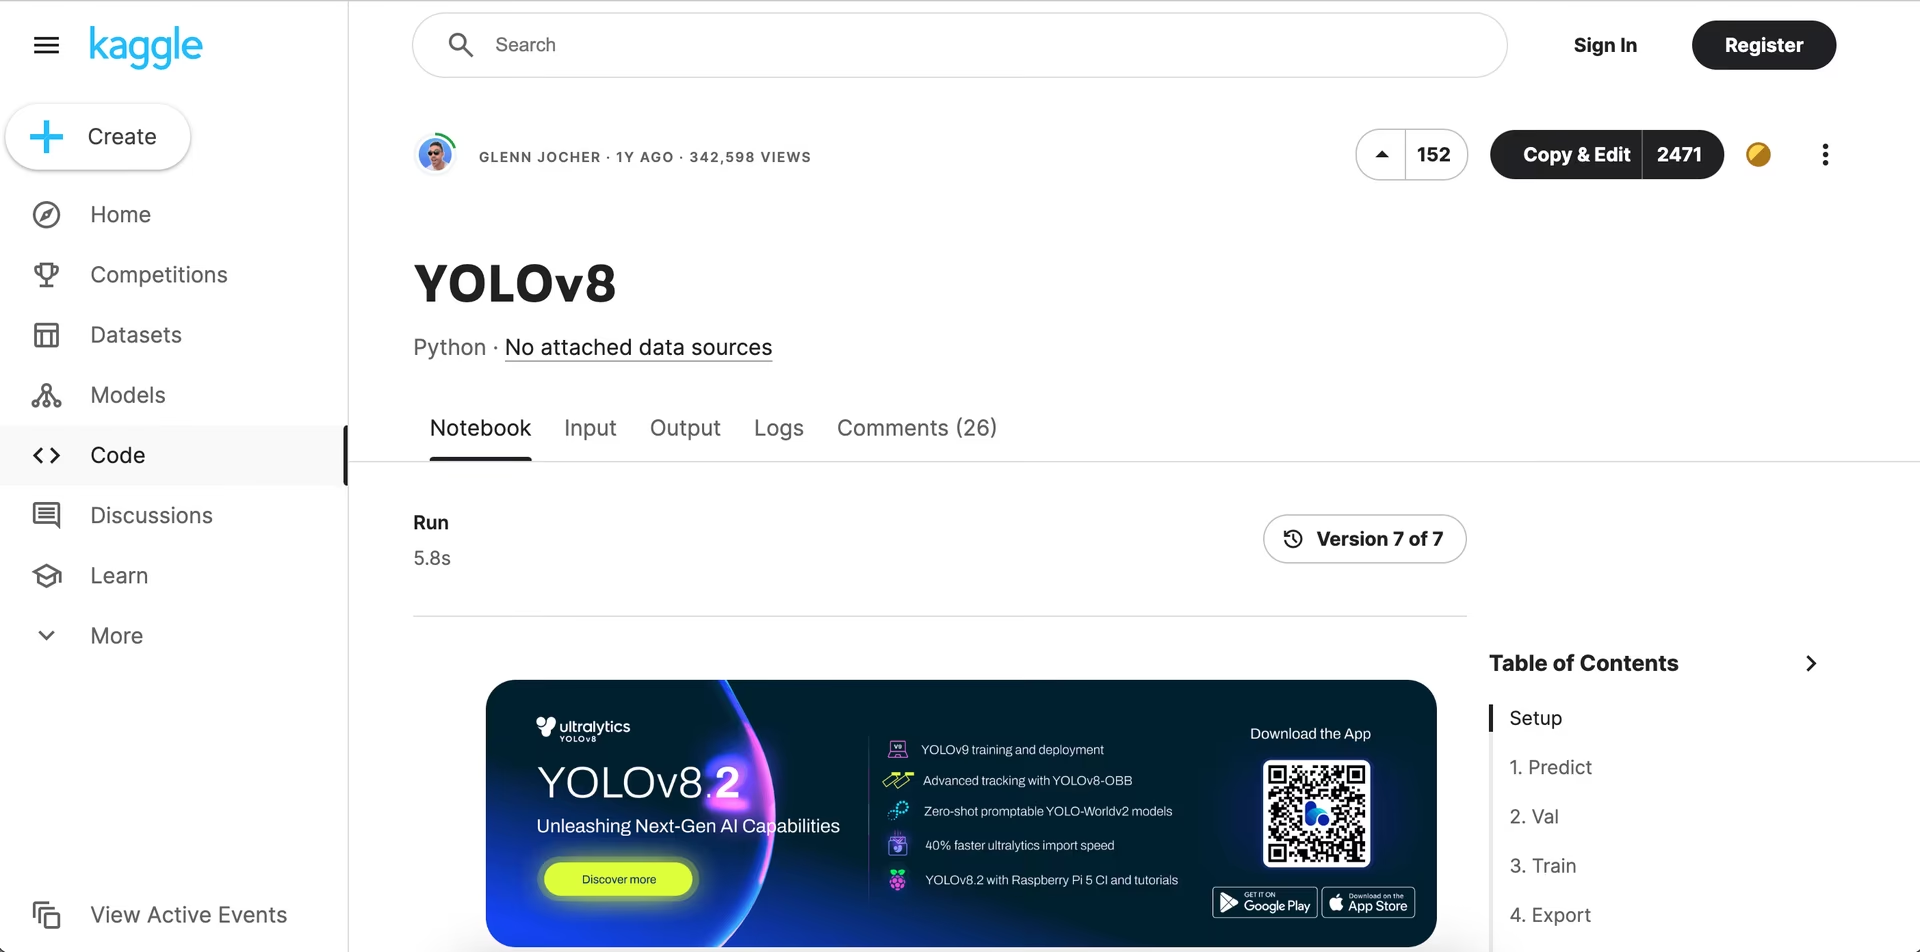
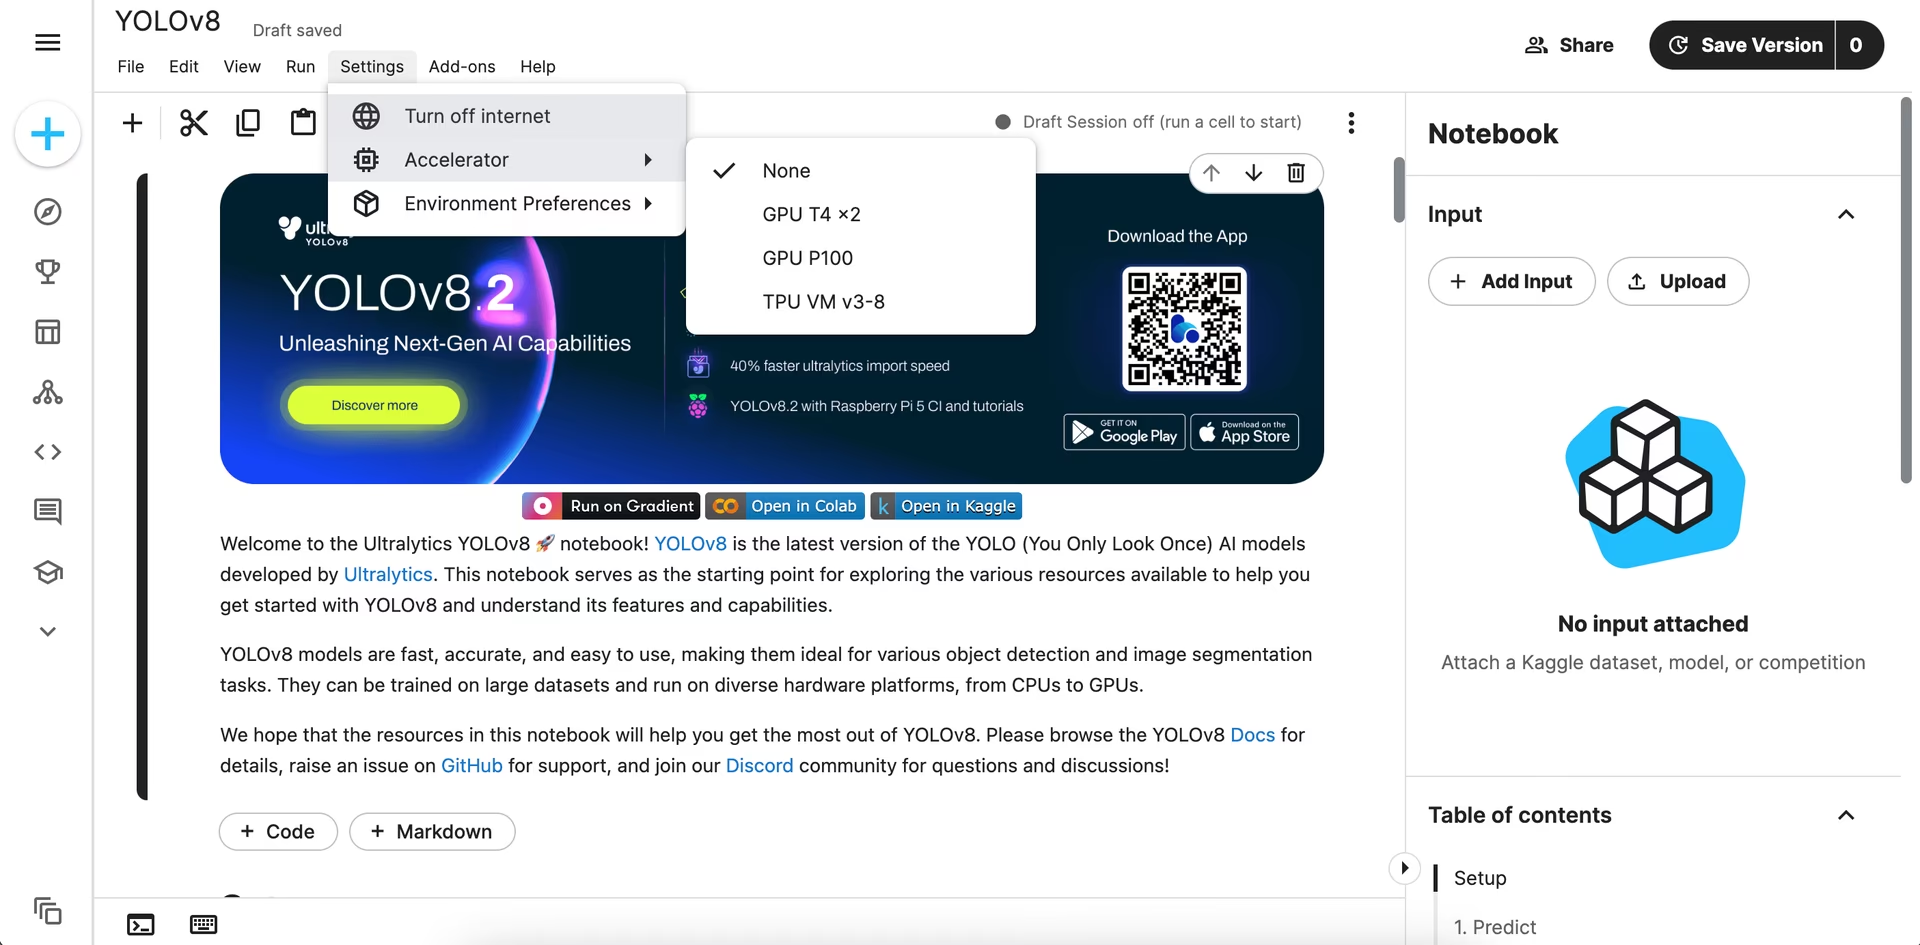
Kaggle 계정에 로그인하면 노트북이 편집 가능한 사본으로 열립니다. 가속기 설정에서 GPU를 선택한 다음 노트북의 셀을 실행하여 모델 학습을 시작하세요. 모델 학습 프로세스와 모범 사례를 자세히 알아보려면 YOLO26 모델 학습 가이드를 참조하세요.
Kaggle 사용 중 자주 발생하는 문제#
Kaggle을 사용하다 보면 몇 가지 일반적인 문제가 발생할 수 있습니다. 플랫폼을 원활하게 이용하는 데 도움이 되는 주요 사항은 다음과 같습니다:
- GPU 액세스: Kaggle 노트북에서 언제든지 GPU를 활성화할 수 있으며, 사용 시간은 주당 최대 30시간입니다. Kaggle은 메모리 16GB의 NVIDIA Tesla P100 GPU와 NVIDIA T4 x2 옵션도 제공합니다. GPU 가속을 사용하면 모델 학습과 추론 속도를 훨씬 높일 수 있습니다.
- Kaggle Kernels: Kaggle Kernels는 GPU를 통합할 수 있는 무료 Jupyter 노트북 서버로, 클라우드 컴퓨터에서 머신러닝 작업을 수행할 수 있습니다. 따라서 개인 컴퓨터의 CPU에 의존할 필요가 없어 과부하를 방지하고 로컬 리소스를 확보할 수 있습니다.
- Kaggle 데이터셋: Kaggle 데이터셋은 무료로 다운로드할 수 있습니다. 다만 사용 제한을 파악하려면 각 데이터셋의 라이선스를 확인해야 합니다. 일부 데이터셋은 학술 출판물이나 상업적 사용에 제한이 있을 수 있습니다. 데이터셋은 노트북에 직접 다운로드하거나 Kaggle API를 통해 다른 위치에 다운로드할 수 있습니다.
- 노트북 저장 및 커밋: Kaggle에서 노트북을 저장하고 커밋하려면 "Save Version"을 클릭합니다. 그러면 노트북의 현재 상태가 저장됩니다. 백그라운드 커널에서 출력 파일 생성이 완료되면 기본 노트북 페이지의 Output 탭에서 해당 파일에 액세스할 수 있습니다.
- 협업: Kaggle은 협업을 지원하지만 여러 사용자가 동시에 노트북을 편집할 수는 없습니다. Kaggle의 협업은 비동기 방식이므로 사용자는 서로 다른 시간에 동일한 노트북을 공유하고 함께 작업할 수 있습니다.
- 이전 버전으로 되돌리기: 노트북을 이전 버전으로 되돌리려면 노트북을 열고 오른쪽 위 모서리의 세로 점 세 개를 클릭한 다음 "View Versions"를 선택합니다. 되돌리려는 버전을 찾고 옆에 있는 "..." 메뉴를 클릭한 후 "Revert to Version"을 선택합니다. 노트북이 이전 상태로 복원되면 "Save Version"을 클릭하여 변경 사항을 커밋합니다.
Kaggle의 주요 기능#
Kaggle이 데이터 과학 및 머신러닝을 위해 제공하는 주요 기능은 다음과 같습니다.
- 데이터 세트: Kaggle은 다양한 주제의 데이터 세트를 대규모로 호스팅합니다. 이러한 데이터 세트를 검색하여 프로젝트에 사용할 수 있으며, YOLO26 모델의 학습 및 테스트에 특히 유용합니다.
- 대회: Kaggle 대회에서는 데이터 과학자와 머신러닝 실무자가 실제 문제를 해결할 수 있습니다. 대회에 참가하면 기술을 향상하고 새로운 기법을 배우며 커뮤니티에서 인정받을 수 있습니다.
- TPU 무료 이용: Kaggle은 TPU를 지원하는 프레임워크에 TPU 무료 액세스를 제공합니다. Ultralytics YOLO26 학습은 Kaggle의 GPU 또는 CPU에서 실행되며 TPU에서는 실행되지 않습니다.
- GitHub 통합: Kaggle에서는 GitHub 저장소를 연결하여 노트북을 업로드하고 작업 내용을 저장할 수 있습니다. 이 통합 기능을 사용하면 파일을 편리하게 관리하고 액세스할 수 있습니다.
- 커뮤니티 및 토론: Kaggle에는 데이터 과학자와 머신러닝 실무자로 구성된 대규모 커뮤니티가 있습니다. 토론 포럼과 공유 노트북은 학습 및 문제 해결에 유용한 리소스입니다. 도움을 얻고 지식을 공유하며 다른 사람과 협업할 수 있습니다.
YOLO26 프로젝트에 Kaggle을 사용해야 하는 이유#
머신러닝 모델을 학습하고 평가할 수 있는 플랫폼은 다양합니다. 머신러닝 프로젝트에 Kaggle을 사용할 때의 이점은 다음과 같습니다.
- 공개 노트북: Kaggle 노트북을 공개하면 다른 사용자가 작업을 보고, 투표하고, 포크하고, 토론할 수 있습니다. Kaggle은 협업, 피드백 및 아이디어 공유를 장려하여 YOLO26 모델을 개선하는 데 도움을 줍니다.
- 노트북 커밋의 전체 기록: Kaggle은 노트북 커밋의 상세한 기록을 생성합니다. 이를 통해 시간에 따른 변경 사항을 검토하고 추적할 수 있어 프로젝트의 발전 과정을 파악하고 필요한 경우 이전 버전으로 되돌리기가 더 쉬워집니다.
- 콘솔 액세스: Kaggle은 콘솔을 제공하여 환경을 더 많이 제어할 수 있도록 합니다. 이 기능을 사용하면 명령줄에서 바로 다양한 작업을 수행할 수 있습니다.
- 리소스 제공: Kaggle의 각 노트북 편집 세션에는 CPU 및 GPU 세션의 경우 12시간, TPU 세션의 경우 9시간의 실행 시간과 자동 저장되는 20GB의 디스크 공간이 제공됩니다.
- 노트북 예약: Kaggle에서는 노트북을 특정 시간에 실행하도록 예약할 수 있습니다. 예를 들어 정기적인 모델 학습과 같은 반복 작업을 수동 개입 없이 자동화할 수 있습니다.
Kaggle에 대해 더 알아보기#
Kaggle에 대해 자세히 알아보고 싶다면 다음 자료를 참고하세요:
- Kaggle Learn: Kaggle Learn에서 다양한 무료 대화형 튜토리얼을 살펴보세요. 이 과정에서는 실습을 통해 필수 데이터 과학 주제를 다룹니다.
- Kaggle 시작하기: 대회 참가부터 첫 노트북 만들기까지 Kaggle 사용의 기본 사항을 안내합니다.
- Kaggle Medium 페이지: Kaggle의 Medium 페이지에서 튜토리얼, 업데이트, 커뮤니티 기여 내용을 살펴보세요.
- Kaggle 통합을 사용해 Ultralytics YOLO 모델 학습하기: 이 블로그 게시물에서는 Ultralytics YOLO 모델에 Kaggle을 사용하는 방법을 구체적으로 설명합니다.
요약#
Kaggle은 YOLO26 프로젝트의 모델 학습 및 평가에 GPU를 무료로 제공하며, 빠른 설정을 위해 라이브러리를 사전 설치합니다. Ultralytics YOLO26과 Kaggle을 함께 사용하면 고가의 하드웨어 없이 컴퓨터 비전 모델을 개발하고 학습하고 배포할 수 있습니다.
자세한 내용은 Kaggle 문서를 참조하세요.
자주 묻는 질문#
Kaggle에 Ultralytics YOLO26을 설치하려면 다음 단계를 따르세요:
- 인터넷 활성화: Settings 패널로 이동하여 Internet 토글을 ON으로 설정합니다.
- 패키지 설치: 노트북 셀에서
!pip install ultralytics을 실행합니다. - 설치 확인: 확인을 위해
import ultralytics; ultralytics.checks()을 실행합니다.
종속성 충돌이 발생하면
!pip install --upgrade --force-reinstall ultralytics을 시도하거나 설치 후 커널을 다시 시작하세요. 자세한 문제 해결 방법은 위의 설치 섹션을 참조하세요.Kaggle에서 YOLO26 모델을 학습하는 과정은 간단합니다. 먼저 Kaggle의 Ultralytics YOLO26 튜토리얼 노트북을 여세요. Kaggle 계정에 로그인한 다음 가속기 설정에서 GPU를 선택합니다. 노트북 셀을 실행하여 학습을 시작하세요. 자세한 단계는 YOLO26 모델 학습 가이드를 참조하세요.
Kaggle은 YOLO26 모델 학습에 여러 가지 이점을 제공합니다:
- GPU 무료 액세스: NVIDIA Tesla P100 또는 T4 x2와 같은 GPU를 주당 최대 30시간 사용할 수 있습니다.
- 사전 설치된 라이브러리: TensorFlow 및 PyTorch와 같은 라이브러리가 사전 설치되어 있어 설정이 간편합니다.
- 커뮤니티 협업: 데이터 과학자와 머신러닝 애호가로 구성된 대규모 커뮤니티에 참여할 수 있습니다.
- 버전 관리: 노트북의 여러 버전을 관리하고 필요하면 이전 버전으로 되돌릴 수 있습니다.
일반적인 문제는 다음과 같습니다:
- GPU 액세스: 노트북 설정에서 GPU를 활성화했는지 확인하세요. Kaggle에서는 주당 최대 30시간까지 GPU를 사용할 수 있습니다.
- 인터넷 비활성화: 패키지를 설치하기 전에 Settings 패널에서 인터넷을 활성화해야 합니다.
- 종속성 충돌:
!pip install --upgrade --force-reinstall ultralytics을 사용합니다. - 데이터셋 라이선스: 사용 제한을 파악하려면 각 데이터셋의 라이선스를 확인하세요.
- 노트북 저장 및 커밋: "Save Version"을 클릭하여 노트북 상태를 저장하고 Output 탭에서 출력 파일에 액세스하세요.
- 협업: Kaggle은 비동기 협업을 지원하므로 여러 사용자가 동시에 노트북을 편집할 수 없습니다.
문제 해결 팁은 설치 섹션과 일반적인 문제 가이드를 참조하세요.
Kaggle에는 Google Colab과 차별화되는 여러 기능이 있습니다.
- 공개 노트북: 피드백과 협업을 위해 커뮤니티와 작업을 공유할 수 있습니다.
- 전체 기록: 노트북 커밋의 상세 기록으로 시간에 따른 변경 사항을 추적할 수 있습니다.
- 리소스 제공: 각 노트북 세션에는 CPU 및 GPU 세션의 경우 12시간의 실행 시간을 포함한 충분한 리소스가 제공됩니다.
이전 버전으로 되돌리려면 다음 단계를 따르세요:
- 노트북을 열고 오른쪽 위 모서리의 세로 점 세 개를 클릭합니다.
- "View Versions"를 선택합니다.
- 되돌리려는 버전을 찾고 옆에 있는 "..." 메뉴를 클릭한 다음 "Revert to Version"을 선택합니다.
- "Save Version"을 클릭하여 변경 사항을 커밋합니다.


댓글3
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?