SAM 3: 개념을 사용한 세그먼트 애니씽
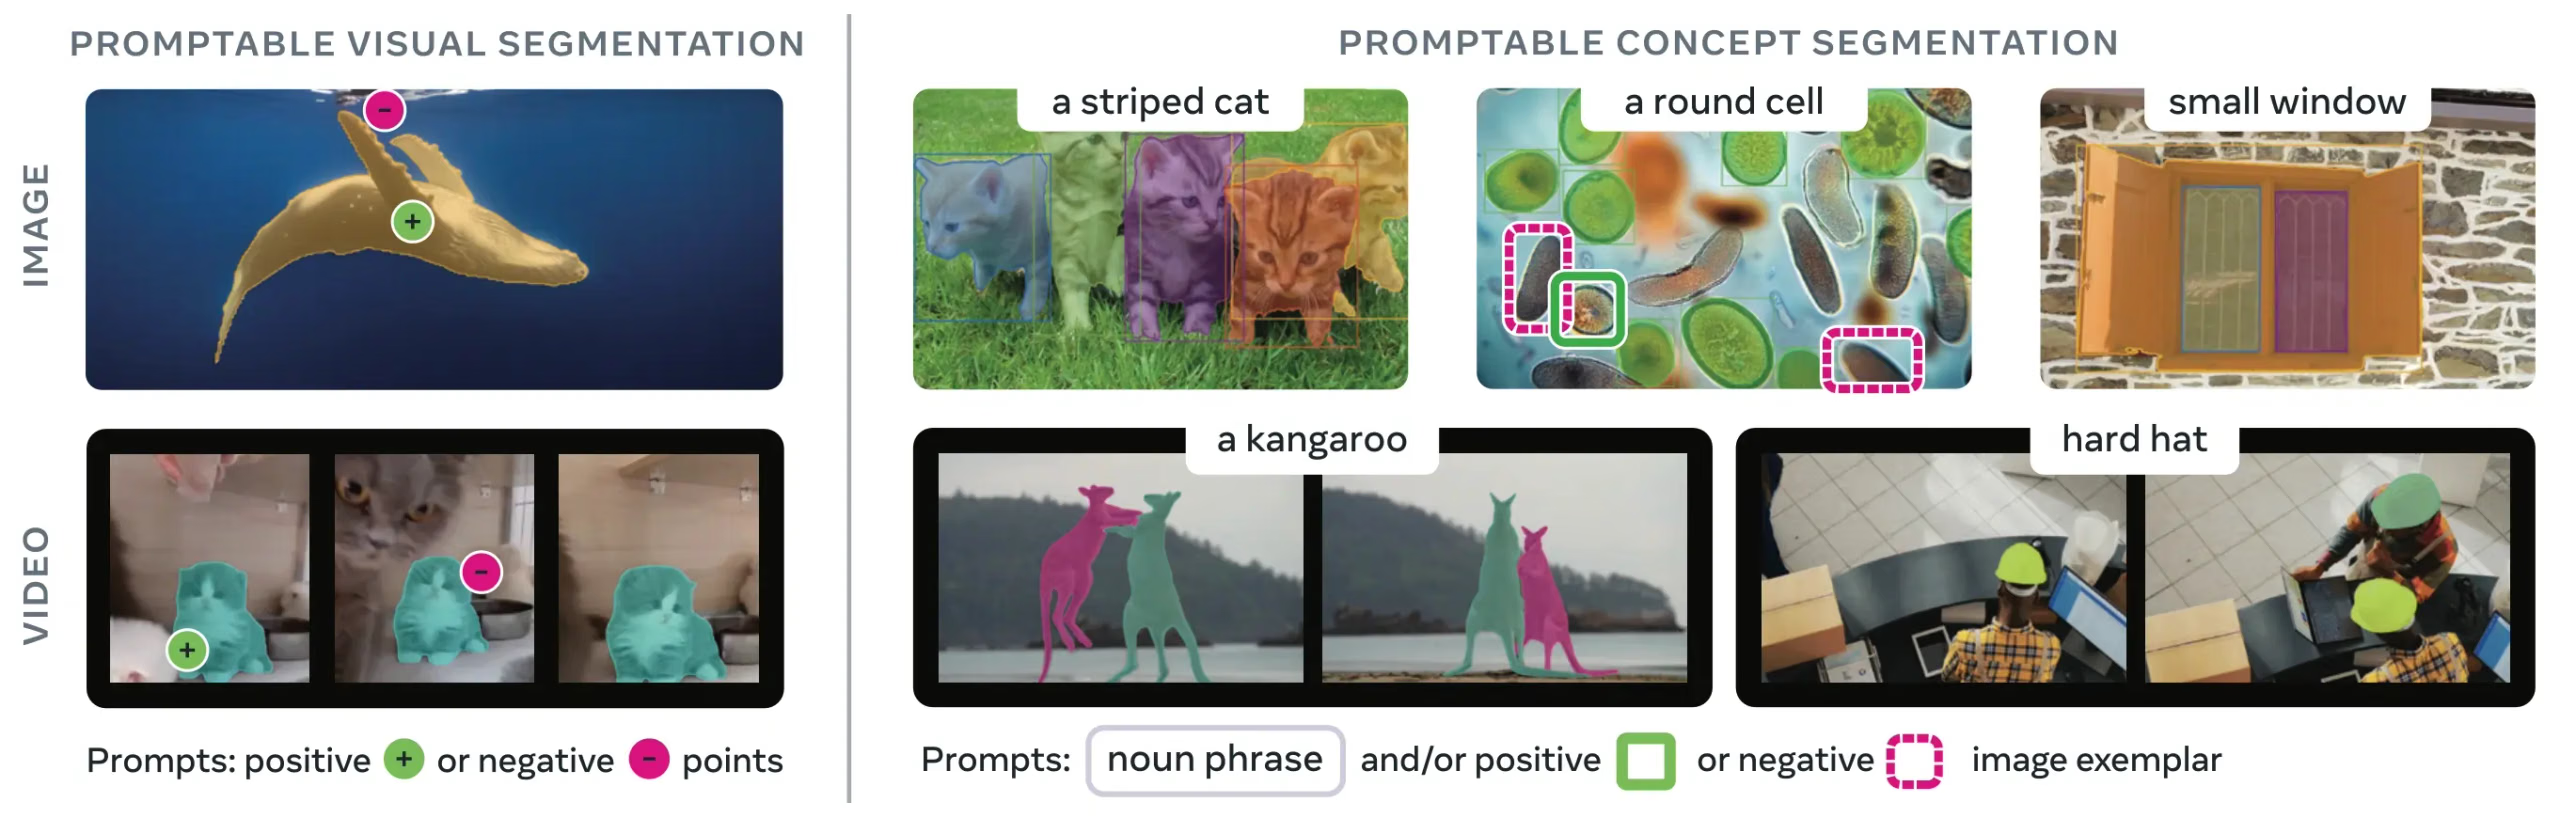
SAM 3(세그먼트 애니싱 모델 3)는 프롬프트 기반 개념 분할(PCS)을 위한 Meta의 파운데이션 모델입니다. SAM 2를 기반으로 하는 SAM 3는 텍스트 프롬프트, 이미지 예시 또는 둘 모두로 지정한 시각적 개념의 모든 인스턴스를 감지, 분할, 추적하는 새로운 기능을 제공합니다. 프롬프트당 단일 객체를 분할하는 이전 SAM 버전과 달리 SAM 3는 이미지나 동영상 어디에 나타나든 개념의 모든 출현 항목을 찾아 분할할 수 있어 현대적인 인스턴스 분할의 오픈 보캐뷸러리 목표에 부합합니다.
시청: Ultralytics에서 Meta Segment Anything 3를 사용하는 방법 | 이미지 및 동영상의 텍스트 프롬프트 분할
SAM 3는 ultralytics 패키지에 완전히 통합되어 텍스트 프롬프트와 이미지 예시 프롬프트를 사용한 개념 분할 및 동영상 추적을 기본적으로 지원합니다. 이미지 예측에는 최신 SAM 3.1 체크포인트가 지원됩니다.
개요#
SAM 3는 프롬프트 기반 개념 분할에서 기존 시스템보다 2배 향상된 성능을 달성하며, 대화형 시각적 분할을 위한 SAM 2의 기능을 유지하고 개선합니다. 이 모델은 오픈 보캐뷸러리 분할에 탁월하며, 사용자가 간단한 명사구(예: "노란 스쿨버스", "줄무늬 고양이")를 사용하거나 대상 객체의 예시 이미지를 제공해 개념을 지정할 수 있습니다. Ultralytics에서 SAM 3는 predict 모드로 실행되며, 추적을 위한 전용 동영상 예측기도 제공합니다.
프롬프트 기반 개념 분할(PCS)이란 무엇인가요?#
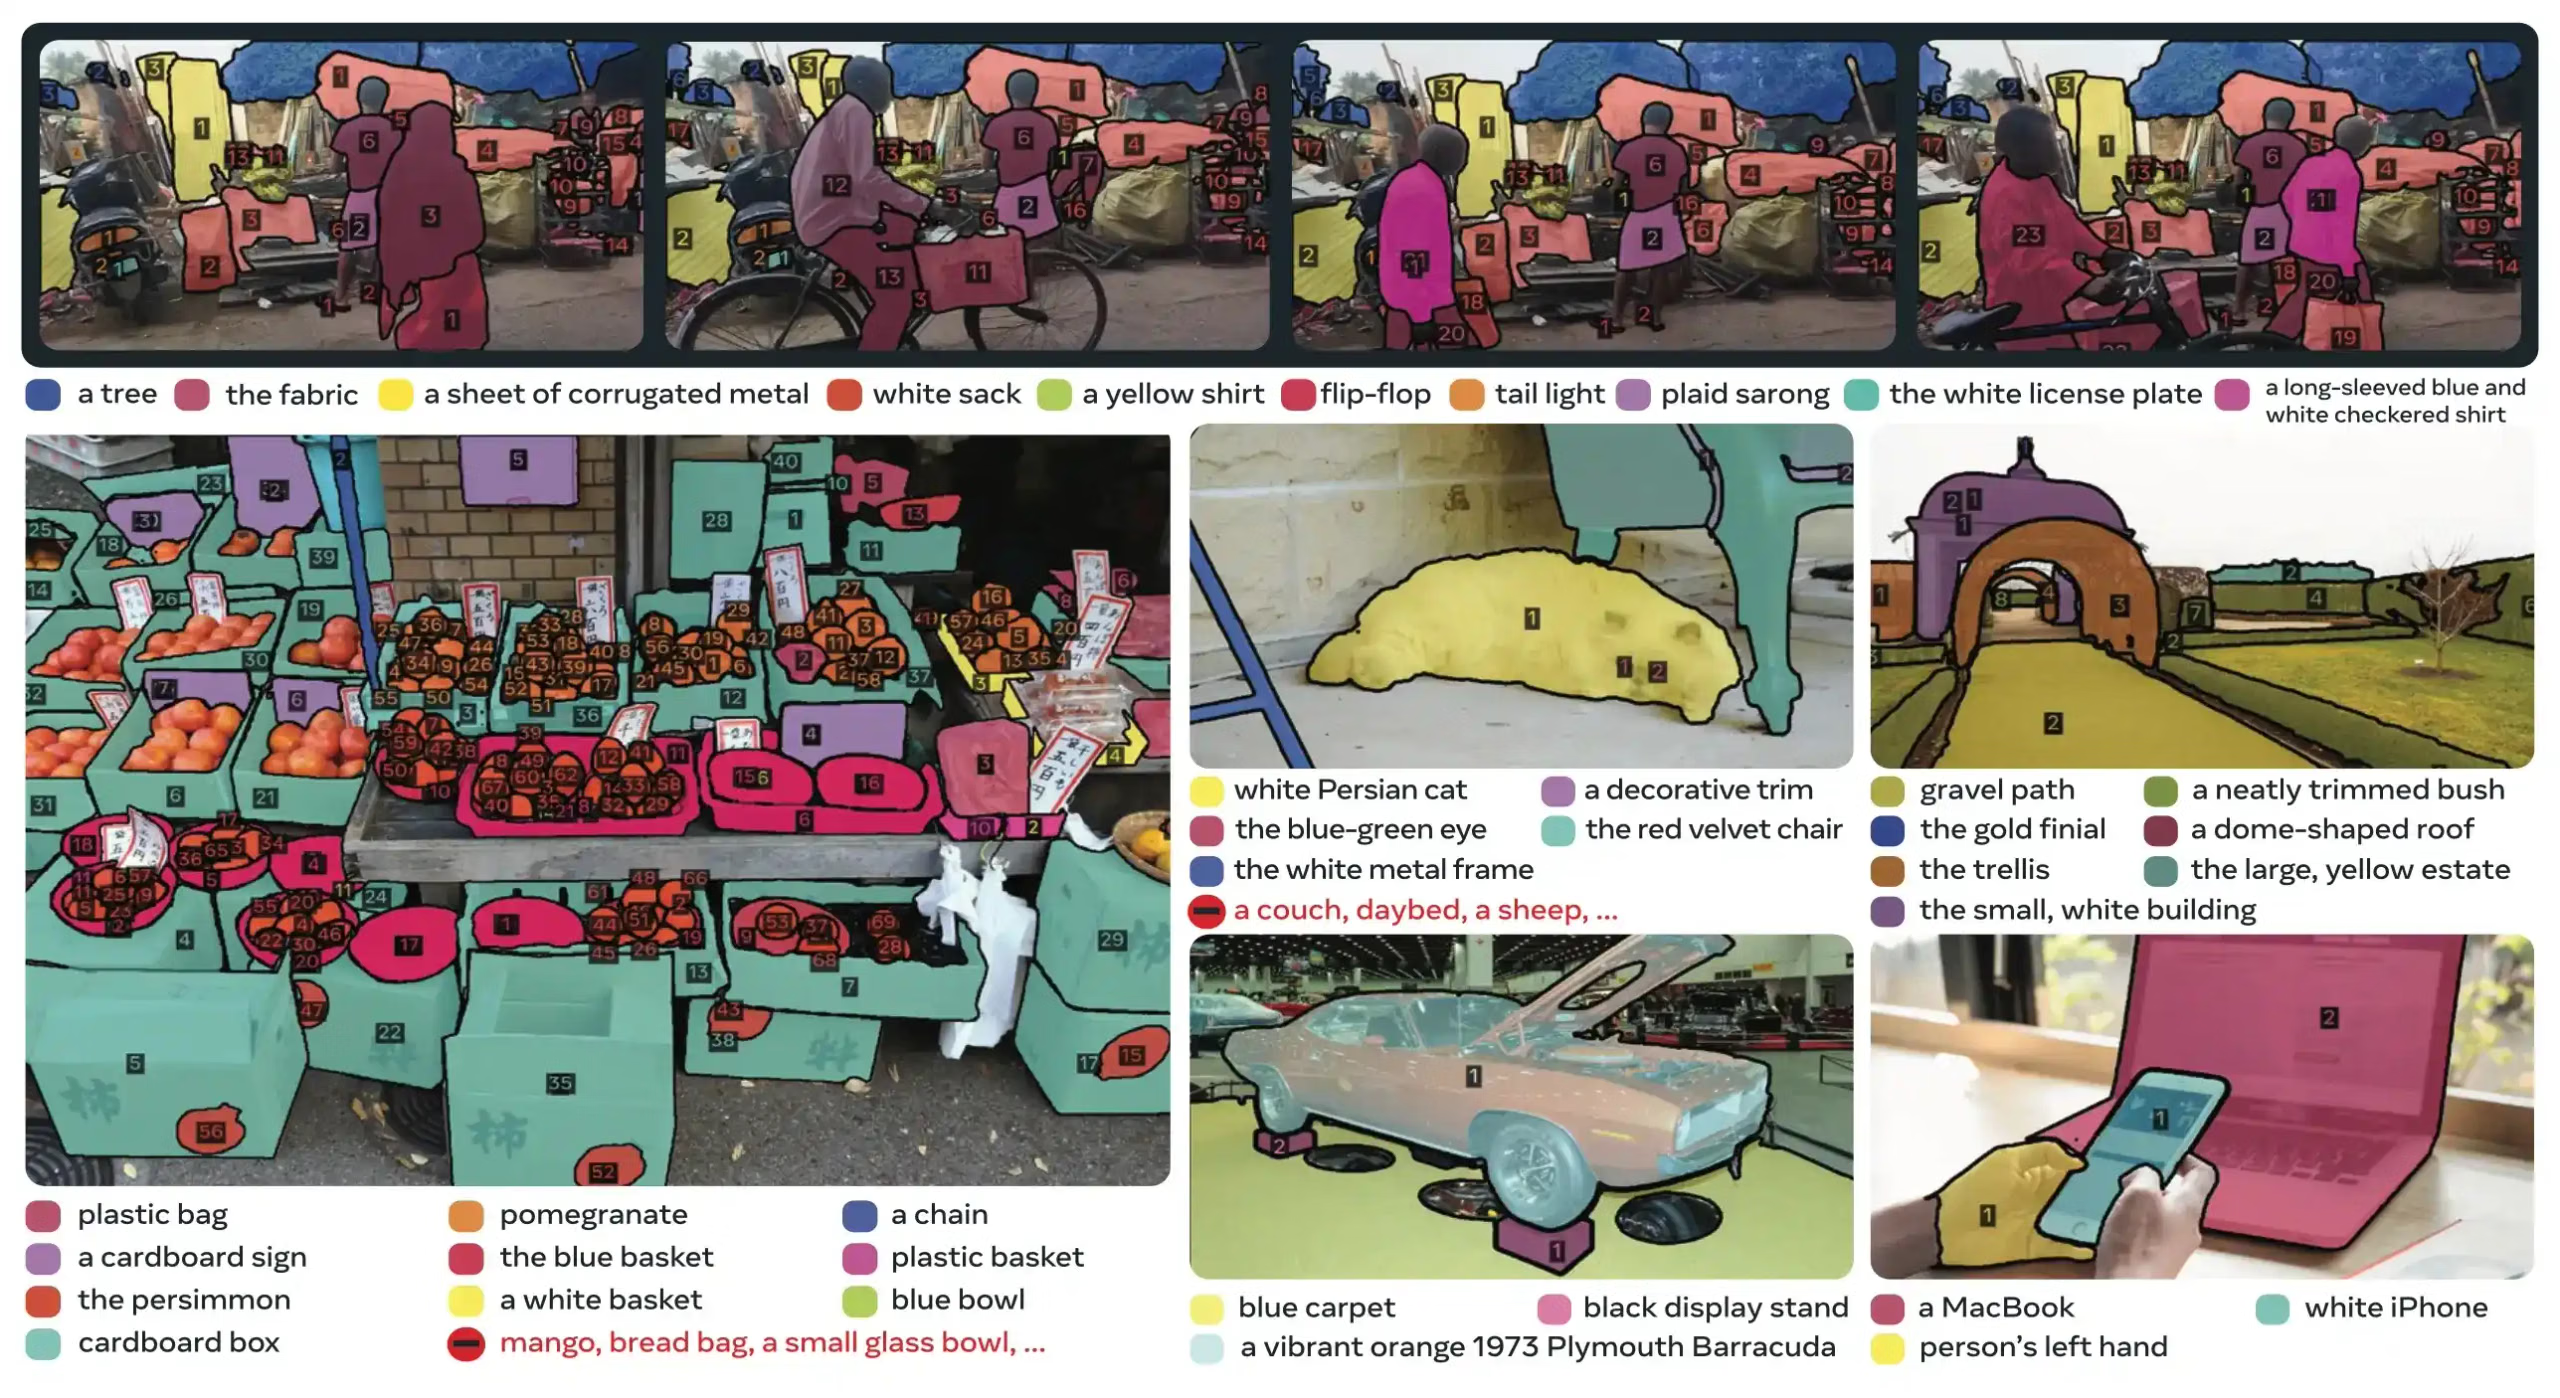
PCS 작업은 입력으로 개념 프롬프트를 받고, 일치하는 모든 객체 인스턴스에 대해 고유한 식별자가 포함된 분할 마스크를 반환합니다. 개념 프롬프트는 다음과 같습니다:
- 텍스트: "빨간 사과" 또는 "모자를 쓴 사람"과 같은 간단한 명사구로, 제로샷 학습과 유사합니다.
- 이미지 예시: 빠른 일반화를 위해 예시 객체 주변에 지정하는 바운딩 박스(긍정 또는 부정)
- 결합: 정밀한 제어를 위해 텍스트와 이미지 예시를 함께 사용
이는 원래 SAM 제품군으로 널리 알려진 점, 박스, 마스크 등의 기존 시각적 프롬프트가 특정 단일 객체 인스턴스만 분할하는 것과 다릅니다.
주요 성능 지표#
| 지표 | SAM 3 성과 |
|---|---|
| LVIS 제로샷 마스크 AP | 47.0 (이전 최고 38.5 대비 +22% 향상) |
| SA-Co 벤치마크 | 기존 시스템보다 2배 우수 |
| 추론 속도(H200 GPU) | 객체 100개 이상 탐지 시 이미지당 30 ms |
| 동영상 성능 | 동시 객체 ~5개에서 거의 실시간 성능 |
| MOSEv2 VOS 벤치마크 | 60.1 J&F (SAM 2.1 대비 +25.5%, 이전 SOTA 대비 +17%) |
| 대화형 개선 | 예시 프롬프트 3개 적용 후 +18.6 CGF1 향상 |
| 인간 성능 격차 | SA-Co/Gold의 추정 하한선 대비 88% 달성 |
프로덕션 환경에서의 모델 지표와 트레이드오프를 이해하려면 모델 평가 인사이트와 YOLO 성능 지표를 참조하세요.
SAM 3.1#
Meta가 2026년 3월 27일 공개한 SAM 3.1은 멀티 객체 동영상 추적을 위한 공유 메모리 방식인 Object Multiplex를 추가한 새로운 SAM 3 체크포인트입니다. 추적 대상 객체를 각각 독립적으로 처리하는 대신, SAM 3.1은 객체를 고정 용량 버킷으로 그룹화해 함께 처리합니다. Meta에 따르면 단일 H100 GPU에서 객체 128개를 처리할 때 속도가 약 7배 향상됩니다. 이미지 검출기와 대화형 포인트 프롬프트 헤드는 SAM 3 아키텍처를 유지합니다.
| 벤치마크 | 지표 | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V(테스트) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B(테스트) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses(테스트) | cgF1 | 36.4 | 36.3 |
| MOSEv1(검증) | J&F | 78.4 | 79.6 |
| DAVIS17(검증) | J&F | 92.2 | 92.7 |
| SA-V(테스트) | J&F | 84.4 | 85.1 |
| YTVOS19(검증) | G | 89.7 | 89.3 |
| MOSEv2(검증) | J&Ḟ | 60.3 | 62.3 |
Ultralytics는 SAM 3.1 체크포인트(sam3.1_multiplex.pt)를 SAM 3 이미지 예측기에 불러옵니다. 포인트 및 박스 프롬프트에는 SAM("sam3.1_multiplex.pt")을, 텍스트 및 예시 프롬프트에는 SAM3SemanticPredictor를 사용합니다. Object Multiplex 동영상 추적은 아직 지원되지 않으므로, SAM3VideoPredictor 및 SAM3VideoSemanticPredictor와 함께 sam3.pt을 계속 사용하세요.
아키텍처#
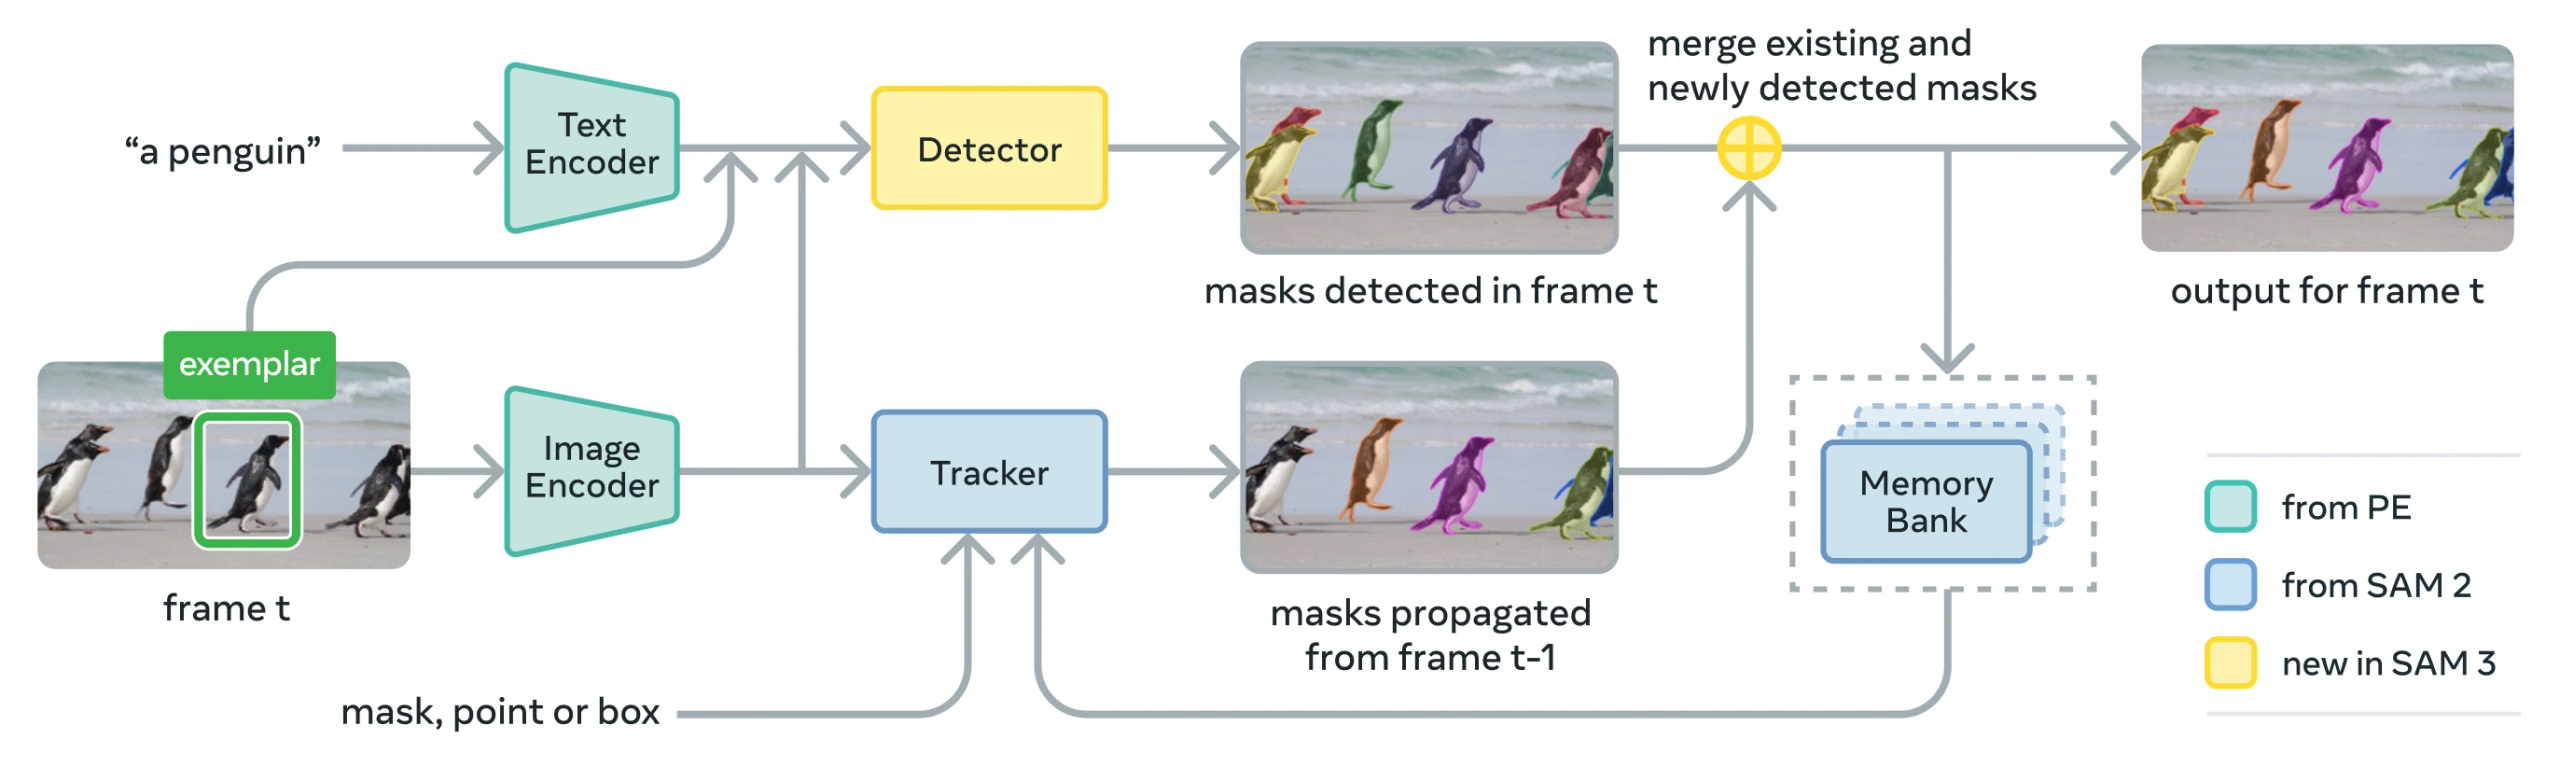
SAM 3는 Perception Encoder(PE) 비전 백본을 공유하는 검출기와 추적기로 구성됩니다. 이 분리형 설계는 작업 간 충돌을 방지하는 동시에 이미지 수준의 검출과 동영상 수준의 추적을 모두 지원하며, Ultralytics의 Python 사용법 및 CLI 사용법과 호환되는 인터페이스를 제공합니다.
핵심 구성 요소#
-
검출기: 이미지 수준의 개념 검출을 위한 DETR 기반 아키텍처
- 명사구 프롬프트용 텍스트 인코더
- 이미지 기반 프롬프트용 예시 인코더
- 프롬프트를 바탕으로 이미지 특징을 조건화하는 융합 인코더
- 인식("무엇")과 위치 파악("어디")을 분리하는 새로운 존재 헤드
- 인스턴스 분할 마스크 생성을 위한 마스크 헤드
-
추적기: SAM 2에서 이어받은 메모리 기반 동영상 분할
- 프롬프트 인코더, 마스크 디코더, 메모리 인코더
- 프레임 전반에 걸쳐 객체의 외형을 저장하는 메모리 뱅크
-
존재 토큰: 대상 개념이 이미지 또는 프레임에 존재하는지 예측하는 학습된 전역 토큰으로, 인식과 위치 파악을 분리하여 검출 성능을 향상시킵니다.
주요 혁신#
- 인식과 위치 추정의 분리: 존재성 헤드는 개념의 존재 여부를 전역적으로 예측하고, 프로포절 쿼리는 위치 추정에만 집중하여 서로 충돌하는 목표를 방지합니다.
- 개념 프롬프트와 시각 프롬프트의 통합: 단일 모델에서 PCS(프롬프트 기반 개념 분할)와 PVS( SAM 2의 클릭/박스와 같은 시각 프롬프트)를 모두 지원합니다.
- 대화형 예시 이미지 개선: 사용자는 긍정 또는 부정 이미지 예시를 추가해 결과를 반복적으로 개선할 수 있으며, 모델은 개별 인스턴스만 수정하는 대신 유사한 객체에 일반화합니다.
- 시간적 모호성 해소: 마스크렛 감지 점수와 주기적인 프롬프트 재입력을 사용해 동영상의 가림, 혼잡한 장면, 추적 실패를 처리하며, 인스턴스 분할 및 추적의 모범 사례를 따릅니다.
SA-Co 데이터셋#
SAM 3은 현재까지 Meta가 구축한 가장 크고 다양한 분할 데이터셋인 Segment Anything with Concepts(SA-Co)로 학습되며, COCO 및 LVIS와 같은 일반적인 벤치마크를 넘어섭니다.
학습 데이터#
| 데이터셋 구성 요소 | 설명 | 규모 |
|---|---|---|
| SA-Co/HQ | 4단계 데이터 엔진으로 구축한 고품질 인간 주석 이미지 데이터 | 이미지 520만 개, 고유 명사구 400만 개 |
| SA-Co/SYN | 사람의 개입 없이 AI가 라벨링한 합성 데이터셋 | 명사구 3,800만 개, 마스크 14억 개 |
| SA-Co/EXT | 어려운 부정 예시를 보강한 외부 데이터셋 15개 | 출처에 따라 다름 |
| SA-Co/VIDEO | 시간적 추적 정보가 포함된 동영상 주석 | 동영상 52.5K개, 고유 명사구 24.8K개 |
벤치마크 데이터#
SA-Co 평가 벤치마크에는 이미지와 동영상 126K개에 걸쳐 고유 구문 214K개가 포함되어 있으며, 기존 벤치마크보다 개념이 50배 이상 많습니다. 다음 항목으로 구성됩니다:
- SA-Co/Gold: 7개 도메인, 인간 성능의 상한선을 측정하기 위해 3중 주석 적용
- SA-Co/Silver: 10개 도메인, 단일 인간 주석 적용
- SA-Co/Bronze 및 SA-Co/Bio: 개념 분할에 맞게 조정한 기존 데이터셋 9개
- SA-Co/VEval: 3개 도메인(SA-V, YT-Temporal-1B, SmartGlasses)으로 구성된 동영상 벤치마크
데이터 엔진 혁신#
SAM 3의 확장 가능한 인간 및 모델 참여형 데이터 엔진은 다음을 통해 주석 처리량을 2배로 높입니다:
- AI 어노테이터: Llama 기반 모델이 하드 네거티브를 비롯한 다양한 명사구를 제안합니다.
- AI 검증 도구: 미세 조정된 멀티모달 LLM이 거의 인간 수준의 성능으로 마스크 품질과 완전성을 검증합니다.
- 능동 마이닝: AI가 어려움을 겪는 까다로운 실패 사례에 사람의 작업을 집중합니다.
- 온톨로지 기반: 개념 범위를 포괄하기 위해 Wikidata에 기반한 대규모 온톨로지를 사용합니다.
설치#
ultralytics 패키지를 설치하거나 업그레이드합니다:
pip install -U ultralytics다른 Ultralytics 모델과 달리 SAM 3 가중치(sam3.pt)는 자동으로 다운로드되지 않습니다. 먼저 Hugging Face의 SAM 3 모델 페이지에서 모델 가중치 액세스를 요청한 다음, 승인을 받으면 해당 페이지에서 sam3.pt를 다운로드해야 합니다. 다운로드한 sam3.pt 파일을 작업 디렉터리에 두거나 모델을 로드할 때 전체 경로를 지정합니다.
SAM 3.1 가중치(sam3.1_multiplex.pt)도 SAM 3.1 모델 페이지에서 동일한 방식으로 액세스가 제한됩니다. 아래 이미지 예제에서 sam3.pt를 사용하는 모든 위치에 sam3.1_multiplex.pt을 전달합니다.
예측 중 위 오류가 발생하면 잘못된 clip 패키지가 설치된 것입니다. 다음 명령을 실행하여 올바른 clip 패키지를 설치합니다:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
SAM 3 사용 방법: 개념 분할의 다양한 활용#
SAM 3은 서로 다른 예측기 인터페이스를 통해 프롬프트 기반 개념 분할(PCS)과 프롬프트 기반 시각 분할(PVS) 작업을 모두 지원합니다:
지원 작업 및 모델#
| 작업 유형 | 프롬프트 유형 | 출력 |
|---|---|---|
| 개념 분할(PCS) | 텍스트(명사구), 이미지 예시 | 해당 개념과 일치하는 모든 인스턴스 |
| 시각 분할(PVS) | 포인트, 박스, 마스크 | 단일 객체 인스턴스(SAM 2 방식) |
| 대화형 개선 | 예시 이미지 또는 클릭을 반복적으로 추가/제거합니다. | 정확도가 향상된 분할 결과 |
개념 분할 예제#
텍스트 프롬프트로 분할#
텍스트 설명을 사용해 개념의 모든 인스턴스를 찾고 분할합니다. 텍스트 프롬프트에는 SAM3SemanticPredictor 인터페이스가 필요합니다.
from ultralytics.models.sam import SAM3SemanticPredictor

# 설정으로 예측기를 초기화합니다.
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # 더 빠른 추론을 위해 FP16을 사용합니다.
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# 여러 쿼리에 사용할 이미지를 한 번 설정합니다.
predictor.set_image("path/to/image.jpg")

# 여러 텍스트 프롬프트로 쿼리합니다.
results = predictor(text=["person", "bus", "glasses"])

# 설명형 구문을 사용할 수 있습니다.
results = predictor(text=["person with red cloth", "person with blue cloth"])

# 단일 개념으로 쿼리합니다.
results = predictor(text=["a person"])
이미지 예시로 분할#
바운딩 박스를 시각 프롬프트로 사용해 유사한 모든 인스턴스를 찾습니다. 개념 기반 매칭에도 SAM3SemanticPredictor이 필요합니다.
from ultralytics.models.sam import SAM3SemanticPredictor

# 예측기를 초기화합니다.
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# 이미지를 설정합니다.
predictor.set_image("path/to/image.jpg")

# 유사한 객체를 분할할 수 있도록 바운딩 박스 예시를 제공합니다.
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# 동일한 시각적 개념의 예시로 여러 바운딩 박스를 사용합니다.
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
효율성을 위한 특징 기반 추론#
이미지 특징을 한 번 추출한 뒤 여러 분할 쿼리에 재사용해 효율성을 높입니다.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# 예측기를 초기화합니다.
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# 첫 번째 예측기에서 특징을 추출합니다.
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# 두 번째 예측기를 설정하고 특징을 재사용합니다.
predictor2.setup_model()

# 공유 특징과 텍스트 프롬프트를 사용해 추론을 수행합니다.
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# 공유 특징과 바운딩 박스 프롬프트를 사용해 추론을 수행합니다.
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# 결과를 시각화합니다.
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
동영상 개념 분할#
바운딩 박스로 동영상 전체에서 개념 추적#
바운딩 박스 프롬프트를 사용해 동영상 프레임 전체에서 객체 인스턴스를 감지하고 추적합니다.
from ultralytics.models.sam import SAM3VideoPredictor

# 동영상 예측기를 생성합니다.
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# 바운딩 박스 프롬프트를 사용해 객체를 추적합니다.
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# 결과를 처리하고 표시합니다.
for r in results:
    r.show()  # 분할 마스크가 있는 프레임을 표시합니다.
텍스트 프롬프트로 개념 추적#
텍스트로 지정한 개념의 모든 인스턴스를 동영상 프레임 전체에서 추적합니다.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# 시맨틱 동영상 예측기를 초기화합니다.
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# 텍스트 프롬프트를 사용해 개념을 추적합니다.
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# 결과를 처리합니다
for r in results:
    r.show()  # 추적된 객체가 있는 프레임을 표시합니다.

# 대안: 바운딩 박스 프롬프트로 추적합니다.
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # 긍정 레이블
    stream=True,
)
시각 프롬프트(SAM 2 호환성)#
SAM 3은 단일 객체 분할을 위한 SAM 2의 시각 프롬프트 기능과 완전한 하위 호환성을 유지합니다:
기본 SAM 인터페이스는 SAM 2와 정확히 동일하게 작동하며, 시각 프롬프트(포인트, 박스 또는 마스크)로 지정된 특정 영역만 분할합니다.
from ultralytics import SAM

model = SAM("sam3.pt")

# 단일 포인트 프롬프트 - 특정 위치의 객체를 분할합니다
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# 다중 포인트 - 여러 포인트 힌트를 사용해 단일 객체를 분할합니다
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# 박스 프롬프트 - 바운딩 박스 안의 객체를 분할합니다
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()
시각적 프롬프트(포인트/박스/마스크)와 함께 SAM("sam3.pt")을 사용하면 SAM 2와 마찬가지로 해당 위치의 특정 객체만 분할합니다. 개념의 모든 인스턴스를 분할하려면 위에 표시된 것처럼 텍스트 또는 예시 프롬프트와 함께 SAM3SemanticPredictor을 사용합니다.
성능 벤치마크#
이미지 분할#
SAM 3는 LVIS 및 분할용 COCO와 같은 실제 데이터셋을 포함해 여러 벤치마크에서 최고 수준의 결과를 달성합니다:
| 벤치마크 | 지표 | SAM 3 | 이전 최고 성능 | 개선 폭 |
|---|---|---|---|---|
| LVIS (제로샷) | 마스크 AP | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34.3(OWLv2) | +89.5% |
| COCO (제로샷) | 박스 AP | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (시맨틱 분할) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (시맨틱 분할) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Ultralytics 데이터셋에서 빠르게 실험할 수 있는 데이터셋 옵션을 살펴보세요.
비디오 분할 성능#
SAM 3는 DAVIS 2017 및 YouTube-VOS와 같은 비디오 벤치마크에서 SAM 2 및 이전 최첨단 모델보다 크게 향상된 성능을 보입니다:
| 벤치마크 | 지표 | SAM 3 | SAM 2.1 L | 개선 폭 |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
퓨샷 적응#
SAM 3는 적은 수의 예시만으로 새로운 도메인에 적응하므로 데이터 중심 AI 워크플로에 유용합니다:
| 벤치마크 | 제로샷 AP | 10샷 AP | 이전 최고 성능(10샷) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
대화형 세분화 효과#
예시를 사용하는 SAM 3의 개념 기반 프롬프팅은 시각적 프롬프팅보다 훨씬 빠르게 수렴합니다:
| 추가한 프롬프트 | CGF1 점수 | 텍스트만 사용한 경우 대비 향상 | PVS 기준선 대비 향상 |
|---|---|---|---|
| 텍스트만 사용 | 46.4 | 기준선 | 기준선 |
| +예시 1개 | 57.6 | +11.2 | +6.7 |
| +예시 2개 | 62.2 | +15.8 | +9.7 |
| +예시 3개 | 65.0 | +18.6 | +11.2 |
| +예시 4개 | 65.7 | +19.3 | +11.5 (정체 구간) |
객체 계수 정확도#
SAM 3는 모든 인스턴스를 분할해 정확한 계수를 제공하며, 이는 객체 계수에서 자주 요구되는 기능입니다:
| 벤치마크 | 정확도 | MAE | 최고 MLLM 대비 |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
SAM 3와 SAM 2 및 YOLO 비교#
여기서는 SAM 3의 기능을 SAM 2 및 YOLO26 모델과 비교합니다:
| 기능 | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| 개념 분할 | ✅ 텍스트/예시를 사용해 모든 인스턴스 분할 | ❌ 지원되지 않음 | ❌ 지원되지 않음 |
| 시각적 분할 | ✅ 단일 인스턴스(SAM 2 호환) | ✅ 단일 인스턴스 | ✅ 모든 인스턴스 |
| 제로샷 기능 | ✅ 오픈 보캐뷸러리 | ✅ 기하학적 프롬프트 | ❌ 폐쇄형 세트 |
| 대화형 개선 | ✅ 예시 + 클릭 | ✅ 클릭만 사용 | ❌ 지원되지 않음 |
| 비디오 추적 | ✅ ID가 있는 다중 객체 추적 | ✅ 다중 객체 추적 | ✅ 다중 객체 추적 |
| LVIS 마스크 AP (제로샷) | 47.0 | 해당 없음 | 해당 없음 |
| MOSEv2 J&F | 60.1 | 47.9 | 해당 없음 |
| 속도(GPU, ms/im) | 2921 | 857 | 8.4 |
| 모델 크기 | 3.45 GB | 162 MB (베이스) | 6.4 MB |
속도는 NVIDIA RTX PRO 6000에서 torch==2.9.1 및 ultralytics==8.4.19을 사용해 벤치마크했습니다.
핵심 요점:
- SAM 3: 오픈 보캐뷸러리 개념 분할에 가장 적합하며, 텍스트 또는 예시 프롬프트로 개념의 모든 인스턴스를 찾습니다.
- SAM 2: 기하학적 프롬프트를 사용해 이미지와 비디오에서 단일 객체를 대화형으로 분할하는 데 가장 적합합니다.
- YOLO26: 실시간 고속 분할에 가장 적합하며, 선택적으로 NMS가 필요 없는 엔드투엔드 추론을 지원합니다. GPU, CPU 및 엣지 디바이스 배포를 위해 다양한 형식으로 내보낼 수 있습니다.
- YOLOE: 텍스트 또는 시각적 프롬프트를 사용하는 실시간 오픈 보캐뷸러리 탐지 및 세그멘테이션에 가장 적합합니다
SAM과 YOLO 비교#
크기, 파라미터 및 GPU 추론 속도 측면에서 SAM 3, SAM 2, SAM, MobileSAM, FastSAM과 Ultralytics YOLO 분할 모델(YOLOv8, YOLO11, YOLO26)을 비교합니다:
| 모델 | 크기 (MB) | 매개변수 (M) | 속도(GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s와 YOLOv8 백본 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (515배 더 작음) | 3.4 (139.1배 더 적음) | 17.4 (167배 더 빠름) |
| Ultralytics YOLO11n-seg | 5.9 (585배 더 작음) | 2.9 (163.1배 더 적음) | 12.6 (231배 더 빠름) |
| Ultralytics YOLO26n-seg | 6.4 (539배 더 작음) | 2.7 (175.2배 더 적음) | 8.4 (347배 더 빠름) |
이 비교는 SAM 변형 모델과 YOLO 세그멘테이션 모델 간 모델 크기와 속도의 상당한 차이를 보여줍니다. SAM은 고유한 자동 세그멘테이션 기능을 제공하지만, 특히 YOLOv8n-seg, YOLO11n-seg, YOLO26n-seg와 같은 YOLO 모델은 크기가 훨씬 작고 속도가 빠르며 연산 효율성이 더 높습니다.
테스트는 torch==2.9.1 및 ultralytics==8.4.19을 사용해 VRAM 96GB의 NVIDIA RTX PRO 6000에서 실행했습니다. 이 테스트를 재현하려면:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM 프로파일링
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# FastSAM-s 프로파일링
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# YOLO 모델 프로파일링
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # YOLO26 NMS 없는 헤드; YOLOv8/YOLO11에서는 작동하지 않음
평가 지표#
SAM 3는 PCS 작업을 위해 새 지표를 도입했으며, 익숙한 F1 점수, 정밀도, 재현율과 같은 지표를 보완합니다.
분류 게이트 F1(CGF1)#
위치 지정과 분류를 결합하는 기본 지표입니다.
CGF1 = 100 × pmF1 × IL_MCC
항목은 다음과 같습니다.
- pmF1(Positive Macro F1): 양성 예제에 대한 위치 지정 품질을 측정합니다.
- IL_MCC(Image-Level Matthews 상관계수): 이진 분류 정확도("해당 개념이 있는가?")를 측정합니다.
이러한 지표를 사용하는 이유#
기존 AP 지표는 보정 상태를 고려하지 않아 실제 환경에서 모델을 사용하기 어렵습니다. 신뢰도 0.5를 초과하는 예측만 평가하면 SAM 3의 지표는 적절한 보정을 보장하고 대화형 예측 및 추적 루프의 실제 사용 패턴을 모방합니다.
주요 어블레이션 및 인사이트#
존재 헤드의 영향#
존재 헤드는 인식과 위치 지정을 분리하여 상당한 성능 향상을 제공합니다.
| 구성 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 존재 헤드 없음 | 57.6 | 0.77 | 74.7 |
| 존재 헤드 적용 | 63.3 | 0.82 | 77.1 |
존재 헤드는 CGF1을 +5.7 향상(+9.9%)시키며, 주로 인식 능력을 개선합니다(IL_MCC +6.5%).
하드 네거티브의 효과#
| 이미지당 하드 네거티브 수 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
하드 네거티브는 개방형 어휘 인식에 매우 중요하며, IL_MCC를 54.5% 향상시킵니다(0.44 → 0.68).
학습 데이터 규모 확장#
| 데이터 소스 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 외부 데이터만 | 30.9 | 0.46 | 66.3 |
| 외부 데이터 + 합성 데이터 | 39.7 | 0.57 | 70.6 |
| 외부 데이터 + 고품질 데이터 | 51.8 | 0.71 | 73.2 |
| 세 가지 모두 | 54.3 | 0.74 | 73.5 |
고품질 인적 주석은 합성 데이터 또는 외부 데이터만 사용하는 경우보다 큰 성능 향상을 제공합니다. 데이터 품질 관리 방법은 데이터 수집 및 주석을 참조하세요.
응용 분야#
SAM 3의 개념 세그멘테이션 기능은 새로운 활용 사례를 가능하게 합니다.
- 콘텐츠 관리: 미디어 라이브러리에서 특정 콘텐츠 유형의 모든 인스턴스를 찾습니다.
- 전자상거래: 카탈로그 이미지에서 특정 유형의 모든 제품을 세그먼트화하여 자동 주석을 지원합니다.
- 의료 영상: 특정 조직 유형이나 이상이 나타나는 모든 위치를 식별합니다.
- 자율 시스템: 교통 표지판, 보행자 또는 차량의 모든 인스턴스를 범주별로 추적합니다.
- 비디오 분석: 특정 복장을 착용하거나 특정 행동을 하는 모든 사람을 세고 추적합니다.
- 데이터셋 주석: 희귀 객체 범주의 모든 인스턴스에 빠르게 주석을 추가합니다.
- 과학 연구: 특정 기준에 부합하는 모든 표본을 정량화하고 분석합니다.
SAM 3 Agent: 확장된 언어 추론#
SAM 3는 추론이 필요한 복잡한 쿼리를 처리하도록 멀티모달 대규모 언어 모델(MLLM)과 결합할 수 있으며, OWLv2 및 T-Rex와 같은 개방형 어휘 시스템과 유사한 접근 방식입니다.
추론 작업 성능#
| 벤치마크 | 지표 | SAM 3 Agent(Gemini 2.5 Pro) | 이전 최고 성능 |
|---|---|---|---|
| ReasonSeg(검증) | gIoU | 76.0 | 65.0(최첨단) |
| ReasonSeg(테스트) | gIoU | 73.8 | 61.3(최첨단) |
| OmniLabel(검증) | AP | 46.7 | 36.5(REAL) |
| RefCOCO+ | 정확도 | 91.2 | 89.3(LISA) |
복잡한 쿼리 예시#
SAM 3 Agent는 추론이 필요한 쿼리를 처리할 수 있습니다.
- "선물 상자를 손에 들고 있지 않은 채 앉아 있는 사람들"
- "목걸이를 착용하지 않은 개 중 카메라와 가장 가까운 개"
- "사람의 손보다 큰 빨간색 물체"
MLLM은 SAM 3에 간단한 명사구 쿼리를 제안하고, 반환된 마스크를 분석하며, 만족스러운 결과를 얻을 때까지 반복합니다.
제한 사항#
SAM 3에는 다음과 같은 한계가 있습니다:
- 구문의 복잡성: 간단한 명사구에 가장 적합하며, 긴 참조 표현이나 복잡한 추론에는 MLLM 통합이 필요할 수 있습니다.
- 모호성 처리: 일부 개념은 본질적으로 모호합니다(예: "작은 창문", "아늑한 방").
- 컴퓨팅 요구 사항: YOLO 같은 특화된 감지 모델보다 크고 느립니다.
- 어휘 범위: 원자적 시각 개념에 초점을 맞추며, MLLM의 지원 없이는 조합적 추론이 제한됩니다.
- 희귀 개념: 학습 데이터에 충분히 나타나지 않은 매우 희귀하거나 세분화된 개념에서는 성능이 저하될 수 있습니다.
인용#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
자주 묻는 질문#
SAM 3는 Meta가 2025년 11월 19일에 출시했으며,
ultralytics패키지에 완전히 통합되어 전용 예측기를 통한 이미지 예측과 동영상 추적을 지원합니다.예. SAM 3는 개념 분할, SAM 2 스타일의 시각적 프롬프트, 다중 객체 동영상 추적을 포함해 Ultralytics Python 패키지에 완전히 통합되어 있습니다. SAM 3와 SAM 3.1은 Ultralytics Platform의 스마트 어노테이션 기능도 지원합니다. 이 기능은 SAM 3.1을 기본 모델로 사용하며 몇 번의 클릭만으로 이미지를 어노테이션할 수 있습니다. 1~200개 클래스를 포함하는 감지 데이터셋에서는 SAM 3 Text와 SAM 3.1 Text가 클래스 이름을 기반으로 자동 어노테이션도 수행하며, VLM 리더보드에서 두 모델의 정확도를 비전 언어 모델과 비교할 수 있습니다.
예, 이미지 예측을 지원합니다. 이 페이지의 이미지 예제에서
sam3.pt을 사용하는 위치에sam3.1_multiplex.pt을 불러오세요. 포인트 및 박스 프롬프트에는SAM("sam3.1_multiplex.pt")를, 텍스트 및 예시 프롬프트에는SAM3SemanticPredictor을 사용하세요. Object Multiplex 비디오 추적은 아직 지원되지 않으므로 비디오 예측기에는 계속sam3.pt를 사용하세요. Meta의 벤치마크는 SAM 3.1을 참조하세요.PCS는 SAM 3에서 도입된 새로운 작업으로, 이미지 또는 비디오에서 시각적 개념의 모든 인스턴스를 세그먼트화합니다. 특정 객체 인스턴스를 대상으로 하는 기존 세그멘테이션과 달리, PCS는 범주의 모든 출현을 찾습니다. 예를 들면 다음과 같습니다.
- 텍스트 프롬프트: "노란색 스쿨버스" → 장면에 있는 노란색 스쿨버스를 모두 세그먼트화합니다.
- 이미지 예시: 개 한 마리 주위에 상자를 그리면 이미지의 모든 개를 분할합니다
- 결합: "줄무늬 고양이" + 예시 상자 → 예시와 일치하는 모든 줄무늬 고양이를 분할합니다
기능 SAM 2 SAM 3 작업 프롬프트당 단일 객체 개념의 모든 인스턴스 프롬프트 유형 포인트, 박스, 마스크 + 텍스트 구문, 이미지 예시 감지 기능 외부 detector 필요 내장된 오픈 보캐뷸러리 detector 인식 기하학 정보 기반만 지원 텍스트 및 시각적 인식 아키텍처 트래커만 포함 존재 여부 헤드가 포함된 detector + 트래커 제로샷 성능 해당 없음(시각적 프롬프트 필요) LVIS에서 47.0 AP, SA-Co에서 2배 향상 대화형 개선 클릭만 지원 클릭 + 예시 일반화 SAM 3는 개념 기반 기능을 추가하면서 SAM 2의 시각적 프롬프트와의 하위 호환성을 유지합니다.
SAM 3는 Segment Anything with Concepts (SA-Co) 데이터셋으로 학습됩니다:
학습 데이터:
- 이미지 5.2M개와 고유 명사구 4M개 (SA-Co/HQ) - 고품질 사람 주석
- 비디오 52.5K개와 고유 명사구 24.8K개 (SA-Co/VIDEO)
- 합성 마스크 1.4B개, 명사구 38M개에 걸쳐 구성 (SA-Co/SYN)
- 어려운 음성 샘플을 추가한 외부 데이터셋 15개 (SA-Co/EXT)
벤치마크 데이터:
- 고유 개념 214K개, 이미지/비디오 126K개에 걸쳐 구성
- 기존 벤치마크보다 개념이 50배 더 많습니다(예: LVIS에는 개념이 ~4K개 있음).
- 사람 성능 범위를 측정하기 위해 SA-Co/Gold에 삼중 주석을 적용했습니다.
이러한 규모와 다양성은 오픈 보캐뷸러리 개념 전반에 걸친 SAM 3의 제로샷 일반화 능력을 뒷받침합니다.
SAM 3와 YOLO26은 서로 다른 사용 사례를 지원합니다:
SAM 3의 장점:
- 오픈 보캐뷸러리: 학습 없이 텍스트 프롬프트를 통해 모든 개념을 분할합니다.
- 제로샷: 새로운 카테고리에도 즉시 적용할 수 있습니다.
- 대화형: 예시 기반 개선 결과를 유사한 객체에 일반화합니다.
- 개념 기반: 카테고리의 모든 인스턴스를 자동으로 찾습니다.
- 정확도: LVIS 제로샷 인스턴스 분할에서 47.0 AP
YOLO26의 장점:
- 속도: NMS가 필요 없는 엔드투엔드 헤드를 선택적으로 사용할 수 있으며, 추론 속도가 몇 자릿수 더 빠릅니다.
- 효율성: 모델 크기가 539배 더 작습니다(6.4MB 대 3.45GB).
- 리소스 효율성: 엣지 디바이스와 모바일에서 실행됩니다.
- 실시간: 프로덕션 배포에 최적화되어 있습니다.
권장 사항:
- 텍스트나 예시로 설명한 개념의 모든 인스턴스를 찾아야 하는 유연한 오픈 보캐뷸러리 분할에는 SAM 3를 사용하세요.
- 카테고리를 미리 알고 있는 고속 프로덕션 배포에는 YOLO26을 사용하세요.
- 기하학적 프롬프트를 사용한 대화형 단일 객체 분할에는 SAM 2를 사용하세요.
SAM 3는 간단한 명사구(예: "빨간 사과", "모자를 쓴 사람")에 맞게 설계되었습니다. 추론이 필요한 복잡한 질의에는 SAM 3를 MLLM과 결합하여 SAM 3 Agent로 사용하세요:
간단한 질의(SAM 3 기본 기능):
- "노란 스쿨버스"
- "줄무늬 고양이"
- "빨간 모자를 쓴 사람"
복잡한 질의(MLLM을 사용하는 SAM 3 Agent):
- "선물 상자를 들고 있지 않은 채 앉아 있는 사람들"
- "목걸이를 하지 않은 개 중 카메라에 가장 가까운 개"
- "사람의 손보다 큰 빨간색 물체"
SAM 3 Agent는 SAM 3의 분할 기능과 MLLM의 추론 기능을 결합하여 ReasonSeg 검증 세트에서 76.0 gIoU를 달성합니다(이전 최고 기록 65.0 대비 +16.9% 향상).
사람이 세 번 주석을 작성한 SA-Co/Gold 벤치마크 기준:
- 사람 성능 하한: 74.2 CGF1(가장 보수적인 주석 작성자)
- SAM 3 성능: 65.0 CGF1
- 달성 수준: 추정된 사람 성능 하한의 88%
- 사람 성능 상한: 81.4 CGF1(가장 관대한 주석 작성자)
SAM 3는 오픈 보캐뷸러리 개념 분할에서 사람 수준의 정확도에 근접하는 우수한 성능을 보이며, 주로 모호하거나 주관적인 개념(예: "작은 창문", "아늑한 방")에서 차이가 나타납니다.


댓글105
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.
 Glenn JocherUltralytics(수정됨)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(수정됨)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(수정됨)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(수정됨)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(수정됨)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.