Neural Magic의 DeepSparse로 YOLOv5 배포하기#
Neural Magic은 2025년 1월 Red Hat에 인수되었으며, 2025년 6월 2일 DeepSparse, SparseML, SparseZoo, Sparsify의 커뮤니티 버전에 대한 지원을 중단했습니다. 도구는 계속 실행되지만 더 이상 업데이트나 지원을 제공하지 않습니다. 지속적으로 유지 관리되는 CPU 가속을 원한다면 OpenVINO 및 ONNX 통합을 참조하세요.
소프트웨어로 제공되는 AI에 오신 것을 환영합니다.
이 가이드에서는 Neural Magic의 DeepSparse로 YOLOv5를 배포하는 방법을 설명합니다.
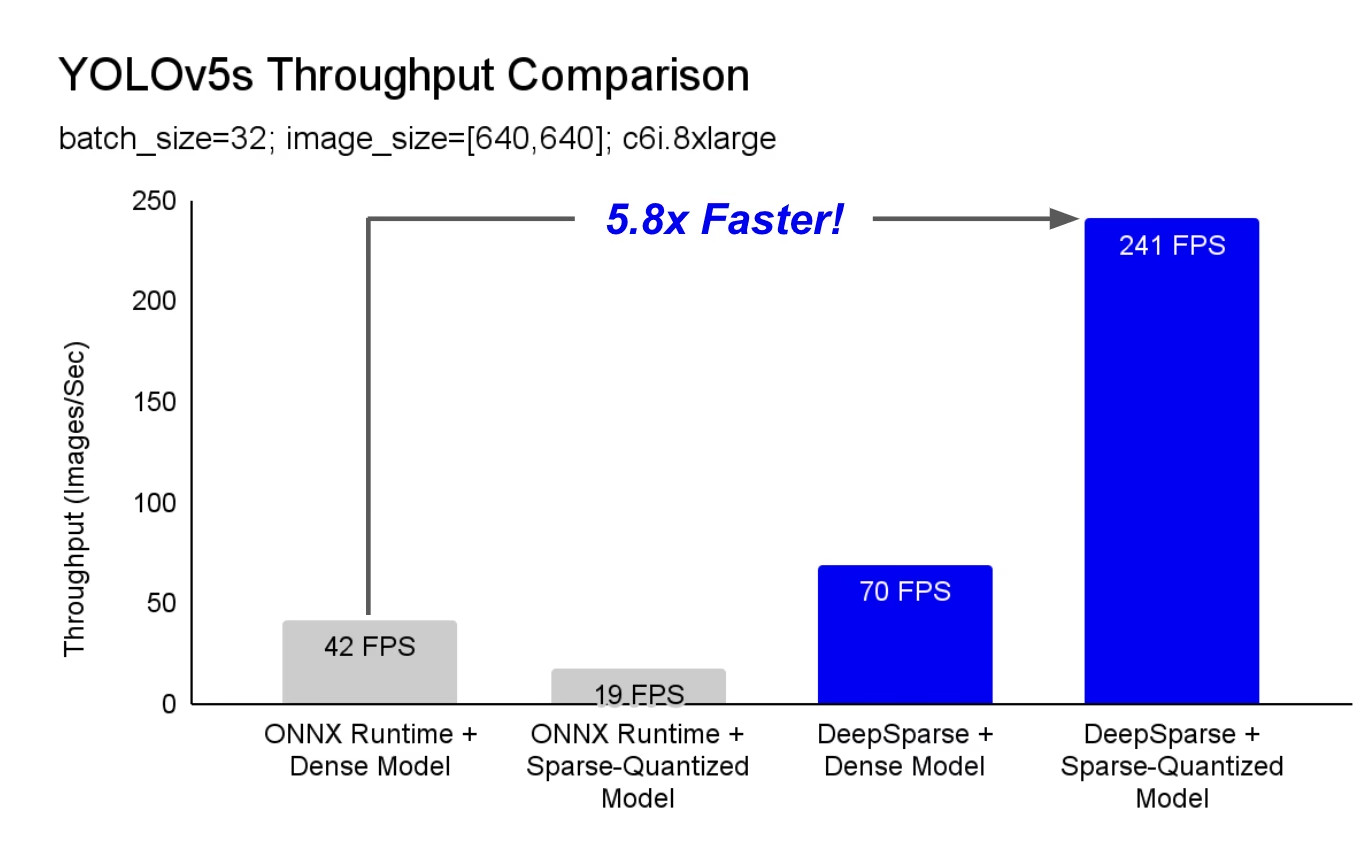
DeepSparse는 CPU에서 뛰어난 성능을 제공하는 추론 런타임입니다. 예를 들어, ONNX Runtime 기준 성능과 비교할 때 DeepSparse는 동일한 시스템에서 YOLOv5s를 실행해 5.8배의 속도 향상을 제공합니다!
이제 처음으로, 딥러닝 워크로드가 하드웨어 가속기의 복잡성과 비용 없이 프로덕션 환경의 성능 요구를 충족할 수 있습니다. 간단히 말해, DeepSparse는 GPU의 성능과 소프트웨어의 단순성을 제공합니다:
- 유연한 배포: Intel부터 AMD, ARM에 이르기까지 어떤 하드웨어 제공업체를 사용하더라도 클라우드, 데이터 센터, 엣지 전반에서 일관되게 실행됩니다.
- 무한한 확장성: 수직 확장을 통해 수백 개의 코어를 활용하거나, 표준 Kubernetes를 사용해 확장하거나, 완전히 추상화된 Serverless 환경을 이용할 수 있습니다.
- 간편한 통합: 모델을 애플리케이션에 통합하고 프로덕션 환경에서 모니터링할 수 있는 깔끔한 API를 제공합니다.
DeepSparse는 어떻게 GPU급 성능을 제공하나요?#
DeepSparse는 모델의 희소성을 활용해 성능을 높입니다.
가지치기와 양자화를 통한 희소화는 널리 연구된 기법으로, 높은 정확도를 유지하면서 네트워크 실행에 필요한 크기와 연산량을 몇 자릿수까지 줄일 수 있습니다. DeepSparse는 희소성을 인식하므로 값이 0으로 설정된 파라미터를 건너뛰어 순전파의 연산량을 줄입니다. 희소 연산이 메모리 제약을 받으므로 DeepSparse는 네트워크를 깊이 방향으로 실행하며, 문제를 캐시에 적합한 연산의 세로 스트라이프인 Tensor Column으로 분할합니다.
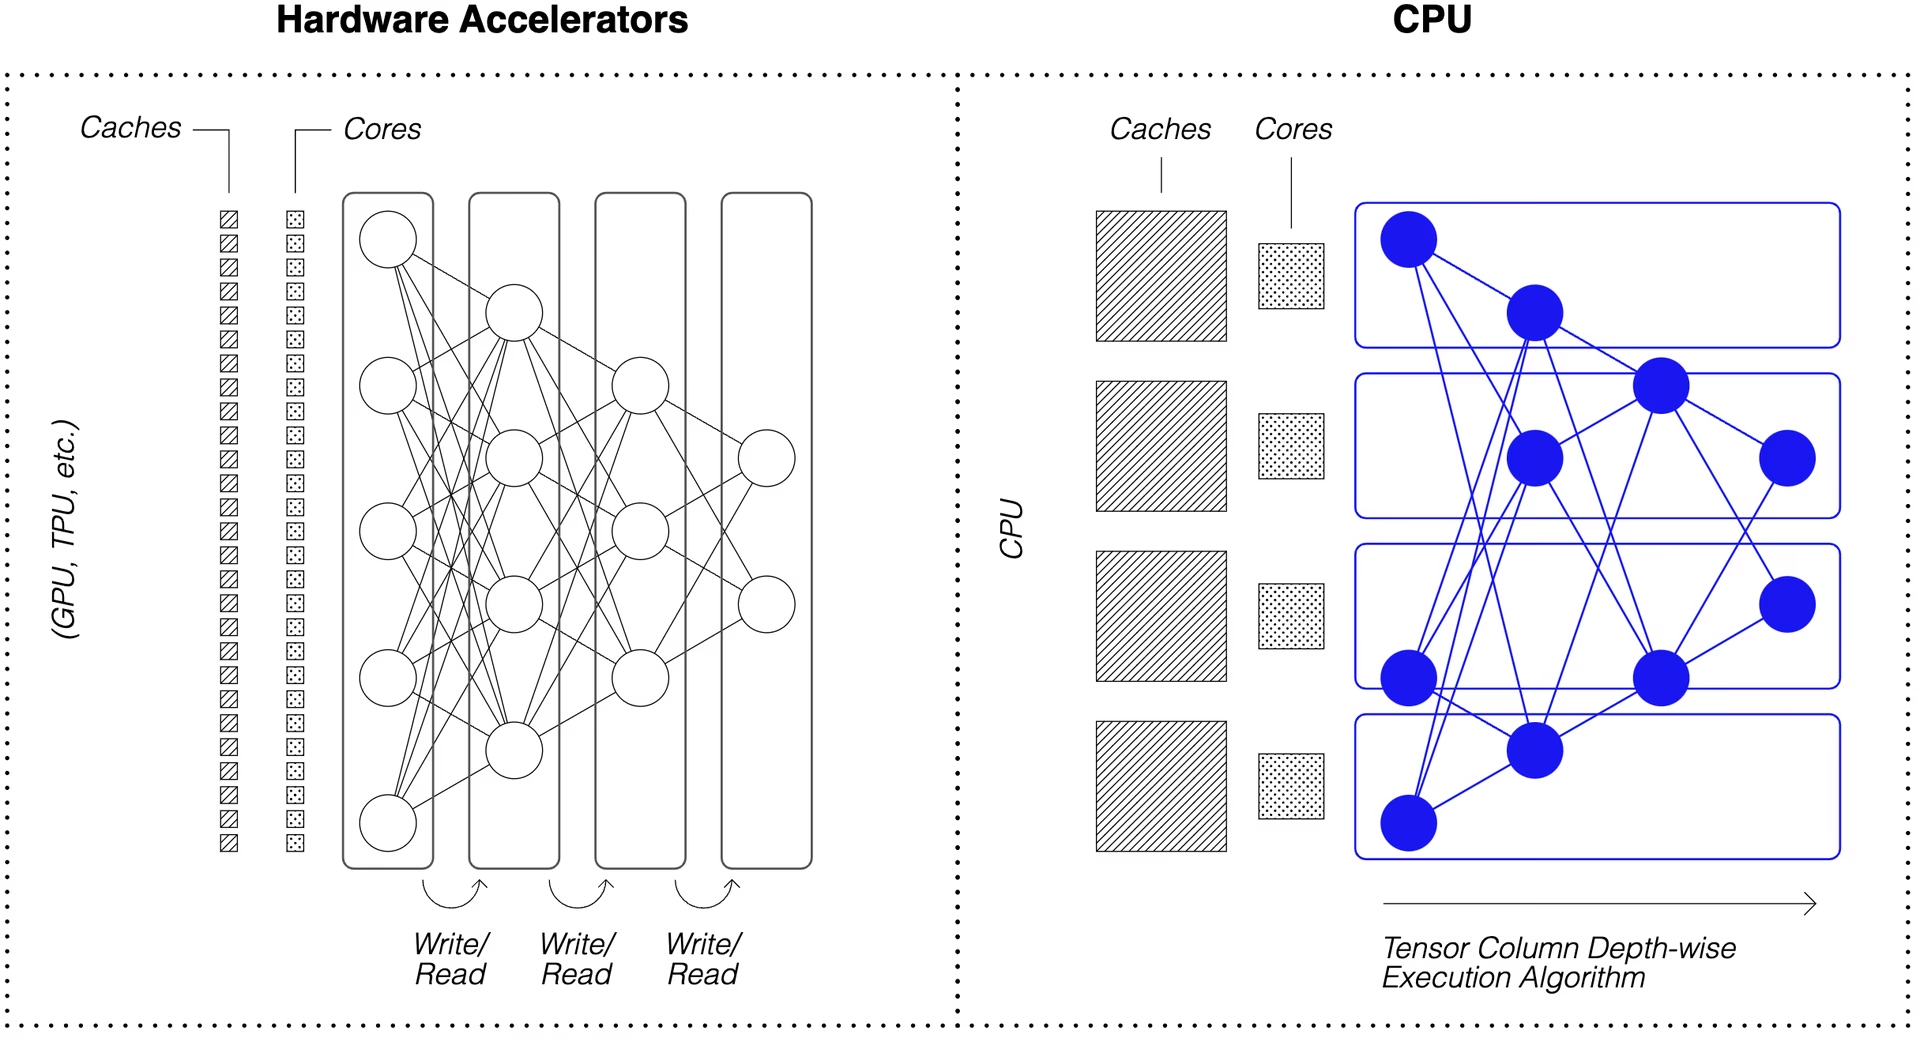
연산을 압축하고 캐시에서 깊이 방향으로 실행하는 희소 네트워크를 통해 DeepSparse는 CPU에서 GPU급 성능을 제공합니다!
내 데이터로 학습한 YOLOv5의 희소 버전은 어떻게 만드나요?#
Neural Magic의 오픈 소스 모델 저장소인 SparseZoo에는 각 YOLOv5 모델의 사전 희소화 체크포인트가 포함되어 있습니다. Ultralytics와 통합된 SparseML을 사용하면 CLI 명령 하나로 희소 체크포인트를 데이터에 맞게 파인튜닝할 수 있습니다.
자세한 내용은 SparseML YOLOv5 통합을 참조하세요.
DeepSparse 사용법#
DeepSparse로 YOLOv5s의 희소 버전을 벤치마킹하고 배포하는 예제를 살펴보겠습니다.
DeepSparse 설치#
다음 명령을 실행해 DeepSparse를 설치하세요. Python 가상 환경을 사용하는 것이 좋습니다.
pip install "deepsparse[server,yolo,onnxruntime]"ONNX 파일 가져오기#
DeepSparse는 다음 중 한 가지 형태로 전달된 ONNX 형식의 모델을 지원합니다.
- SparseZoo에 있는 ONNX 파일을 식별하는 SparseZoo 스텁
- 파일 시스템의 ONNX 모델을 가리키는 로컬 경로
아래 예제에서는 다음 SparseZoo 스텁으로 식별되는 표준 dense 및 가지치기-양자화 YOLOv5s 체크포인트를 사용합니다.
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
모델 배포#
DeepSparse는 모델을 애플리케이션에 통합할 수 있는 편리한 API를 제공합니다.
아래 배포 예제를 실행하려면 다음 명령을 사용해 샘플 이미지를 가져와 basilica.jpg으로 저장하세요.
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgPython API#
Pipelines은 런타임 전후에 전처리 및 출력 후처리를 적용해 DeepSparse를 애플리케이션에 간편하게 추가할 수 있는 인터페이스를 제공합니다. DeepSparse-Ultralytics 통합에는 원본 이미지를 입력받아 경계 상자를 출력하는 기본 제공 Pipeline이 포함되어 있습니다.
Pipeline을 생성하고 추론을 실행하세요.
from deepsparse import Pipeline

# 로컬 파일 시스템의 이미지 목록
images = ["basilica.jpg"]

# Pipeline 생성
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# 이미지에 대해 추론을 실행하고 경계 상자와 클래스를 받습니다.
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
클라우드에서 실행할 때 OpenCV가 libGL.so.1을 찾지 못한다는 오류가 발생할 수 있습니다. 누락된 라이브러리를 설치하거나 다음을 수행할 수 있습니다.
apt-get install libgl1또는 GUI 종속성을 완전히 제거한 headless OpenCV 빌드를 사용하세요.
pip install opencv-python-headlessHTTP 서버#
DeepSparse Server는 널리 사용되는 웹 프레임워크 FastAPI와 웹 서버 Uvicorn 위에서 실행됩니다. CLI 명령 하나만으로 DeepSparse 모델 서비스 엔드포인트를 쉽게 설정할 수 있습니다. Server는 YOLOv5를 사용한 객체 감지를 포함해 DeepSparse의 모든 Pipeline을 지원하므로, 엔드포인트에 원본 이미지를 보내고 경계 상자를 받을 수 있습니다.
가지치기-양자화 YOLOv5s로 Server를 실행하세요.
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Python의 requests 패키지를 사용하는 요청 예제입니다.
import json
from contextlib import ExitStack

import requests

# 추론을 위한 이미지 목록(클라이언트 측 로컬 파일)
path = ["basilica.jpg"]

# HTTP를 통해 /predict/from_files 엔드포인트로 요청 전송
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# 응답은 JSON으로 반환됩니다.
annotations = json.loads(resp.text)  # 주석 처리 결과 딕셔너리
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]
주석 추가 CLI#
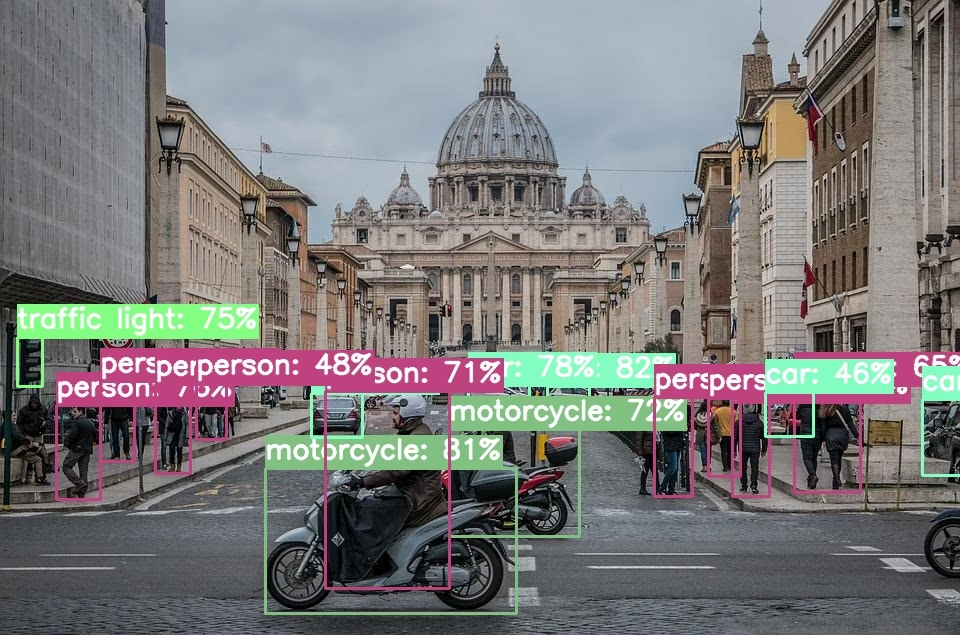
annotate 명령을 사용하면 엔진이 주석이 추가된 사진을 디스크에 저장하도록 할 수도 있습니다. --source 0을 사용해 실시간 웹캠 피드에 주석을 추가해 보세요!
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpg위 명령을 실행하면 annotation-results 폴더가 생성되고 주석이 추가된 이미지가 해당 폴더에 저장됩니다.
성능 벤치마크#
DeepSparse의 벤치마킹 스크립트를 사용하여 YOLOv5s에서 DeepSparse와 ONNX Runtime의 처리량을 비교합니다.
벤치마크는 AWS c6i.8xlarge 인스턴스(16코어)에서 실행했습니다.
배치 크기 32 성능 비교#
ONNX Runtime 기준 성능#
배치 크기 32에서 ONNX Runtime은 표준 dense YOLOv5s로 초당 42개 이미지를 처리합니다.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
DeepSparse의 Dense 모델 성능#
DeepSparse는 최적화된 sparse 모델에서 최고의 성능을 제공하지만, 표준 dense YOLOv5s에서도 뛰어난 성능을 발휘합니다.
배치 크기 32에서 DeepSparse는 표준 dense YOLOv5s로 초당 70개 이미지를 처리하여 ORT보다 성능이 1.7배 향상됩니다!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
DeepSparse의 Sparse 모델 성능#
모델에 sparsity를 적용하면 ONNX Runtime 대비 DeepSparse의 성능 향상이 더욱 두드러집니다.
배치 크기 32에서 DeepSparse는 pruning 및 양자화된 YOLOv5s로 초당 241개 이미지를 처리하여 ORT보다 성능이 5.8배 향상됩니다!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
배치 크기 1 성능 비교#
DeepSparse는 지연 시간에 민감한 배치 크기 1 환경에서도 ONNX Runtime보다 빠른 속도를 제공합니다.
ONNX Runtime 기준 성능#
배치 크기 1에서 ONNX Runtime은 표준 dense YOLOv5s로 초당 48개 이미지를 처리합니다.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
DeepSparse의 Sparse 모델 성능#
배치 크기 1에서 DeepSparse는 pruning 및 양자화된 YOLOv5s로 초당 135개 항목을 처리하여 ONNX Runtime보다 성능이 2.8배 향상됩니다!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
c6i.8xlarge 인스턴스에는 VNNI 명령어가 있으므로, 가중치를 4개 단위 블록으로 pruning하면 DeepSparse의 처리량을 더욱 높일 수 있습니다.
배치 크기 1에서 DeepSparse는 4개 단위 블록으로 pruning 및 양자화된 YOLOv5s를 사용해 초당 180개 항목을 처리하여 ONNX Runtime보다 성능이 3.7배 향상됩니다!
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
DeepSparse 시작하기#
연구 또는 테스트를 진행하시나요? DeepSparse Community는 연구 및 테스트에 무료로 사용할 수 있습니다. DeepSparse README를 참고하여 시작해 보세요.
DeepSparse로 YOLOv5를 배포하는 방법에 대한 자세한 내용은 DeepSparse YOLOv5 예제와 DeepSparse 통합에 관한 Ultralytics 블로그 게시물을 확인하세요.
자주 묻는 질문#
아니요. DeepSparse는 CPU 런타임이며, 위 벤치마크는 가속기 없이 16코어 AWS
c6i.8xlarge인스턴스에서 측정했습니다.python export.py --weights best.pt --include onnx을 사용해 ONNX로 내보낸 다음, SparseZoo stub 대신 파일 경로를model_path로 전달하세요. Dense 모델도 런타임의 이점을 얻으며, pruning 및 양자화된 모델에서 가장 큰 성능 향상을 얻을 수 있습니다.사전에 sparsity가 적용된 SparseZoo 체크포인트 중 하나를 SparseML로 자체 데이터에 맞게 파인튜닝하세요. SparseML은 학습 중 sparsity 구조를 유지하며, 그런 다음 ONNX로 내보내면 됩니다.
아니요. 커뮤니티 버전은 2025년 6월 2일에 지원이 종료되었으며, PyPI 패키지는 더 이상 업데이트되지 않습니다. 기존 파이프라인은 계속 작동하지만, 새 배포에는 활발히 유지 관리되고 있는 OpenVINO 또는 ONNX Runtime 경로를 고려해야 합니다.