Ultralytics YOLO26에서 지원하는 컴퓨터 비전 작업
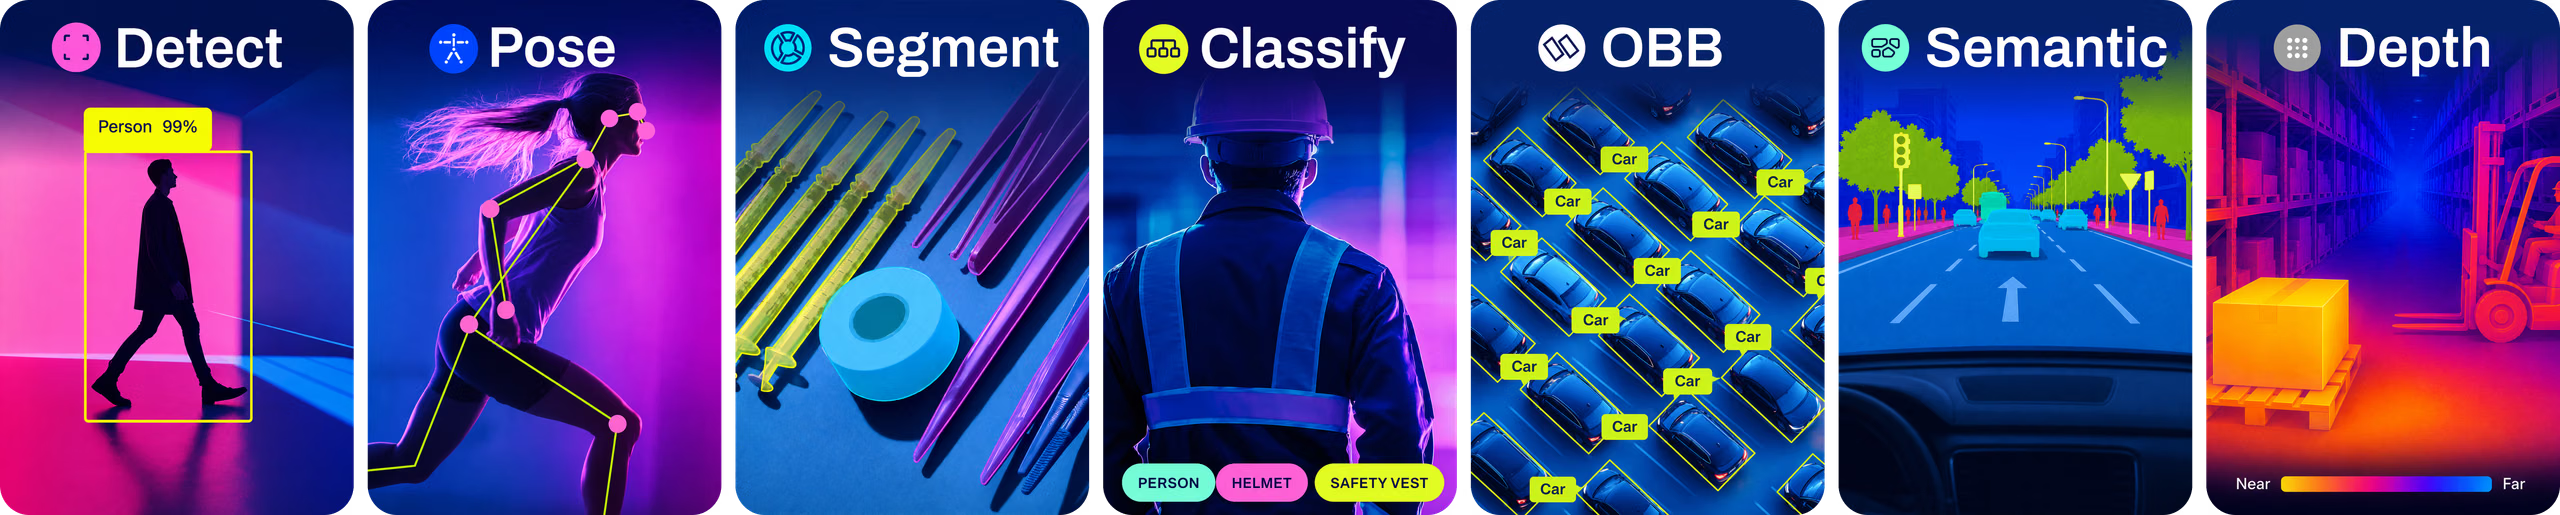
Ultralytics YOLO26은 여러 컴퓨터 비전 작업을 지원합니다. 여기에는 감지, 분할, 시맨틱 분할, 깊이 추정, 분류, 포즈 추정, OBB가 포함됩니다. 각 작업은 목표와 사용 사례가 다르므로 단일 프레임워크로 다양한 컴퓨터 비전 문제를 해결할 수 있습니다.
예정된 YOLO27 지원에 대한 내용은 YOLO27 미리보기를 참조하세요. YOLO27은 곧 출시될 예정이며 아직 사용할 수 없습니다. 이 가이드에서는 출시된 YOLO26 모델을 사용합니다.
시청: Ultralytics YOLO26 작업 살펴보기: 객체 감지, 인스턴스 분할, 시맨틱 분할, 깊이 추정, 분류, 포즈 추정 및 OBB.
탐지#
객체 감지는 YOLO26이 지원하는 주요 작업입니다. 이미지나 비디오 프레임에서 객체를 식별하고 객체 주위에 바운딩 박스를 그리는 작업입니다. 감지된 객체는 특징을 바탕으로 여러 범주로 분류됩니다. YOLO26은 단일 이미지나 비디오 프레임에서 여러 객체를 실시간 애플리케이션에 충분한 속도로 감지하므로 감시 시스템 및 자율주행 차량에 적합합니다.
인스턴스 세그멘테이션#
인스턴스 분할은 객체 감지에서 더 나아가 각 객체의 픽셀 단위 마스크를 생성합니다. 이러한 정밀도는 의료 영상, 농업 분석, 제조 품질 관리와 같은 애플리케이션에 유용합니다.
시맨틱 분할#
시맨틱 분할은 이미지의 모든 픽셀에 클래스 레이블을 지정하여 장면 전체의 조밀한 클래스 맵을 생성합니다. 인스턴스 분할과 달리 같은 클래스에 속한 개별 객체를 구분하지 않습니다. 따라서 개별 객체 식별보다 전체 공간 배치에 대한 이해가 중요한 자율주행, 장면 파싱, 토지 피복 매핑에 적합합니다.
깊이 추정#
단안 깊이 추정은 단일 RGB 이미지에서 픽셀별 깊이 맵을 미터 단위로 예측합니다. 출력은 입력 이미지와 정렬된 조밀한 부동 소수점 맵이므로, 단일 카메라에서 공간 배치를 추론해야 하는 3D 장면 재구성, 로봇 내비게이션, AR/VR 애플리케이션에 적합합니다.
분류#
이미지 분류는 이미지의 콘텐츠를 바탕으로 이미지 전체를 분류하는 작업입니다. 이 작업은 전자상거래의 제품 분류, 콘텐츠 조정, 야생동물 모니터링과 같은 애플리케이션에 유용합니다.
포즈 추정#
포즈 추정은 움직임을 추적하거나 포즈를 추정하기 위해 이미지나 비디오 프레임에서 특정 키포인트를 감지합니다. 키포인트는 사람의 관절, 얼굴 특징 또는 기타 주요 관심 지점을 나타낼 수 있습니다. YOLO26 포즈 모델은 키포인트를 실시간으로 감지하므로 피트니스 애플리케이션, 스포츠 분석, 인간-컴퓨터 상호작용에 유용합니다.
OBB#
방향성 바운딩 박스(OBB) 감지는 회전한 객체의 위치를 더 정확히 파악하도록 방향 각도를 추가해 기존 객체 감지 기능을 향상합니다. 이 기능은 객체가 여러 각도로 나타나는 항공 영상 분석, 문서 처리, 산업 애플리케이션에서 특히 유용합니다. YOLO26 OBB 모델은 DOTAv1 항공 영상 데이터셋으로 사전 학습되었습니다.
다음 단계#
작업을 선택하셨나요? 데이터셋 가이드를 참고하여 해당 작업에 맞게 데이터를 구성한 다음, 자체 이미지로 학습하세요.
자주 묻는 질문#
Ultralytics YOLO26은 다음 컴퓨터 비전 작업을 지원합니다.
- 객체 감지: 이미지 또는 비디오 프레임에서 객체 주변에 바운딩 박스를 그려 객체를 식별하고 위치를 찾습니다.
- 인스턴스 세그멘테이션: 감지된 각 객체에 대해 픽셀 단위 마스크를 생성하며, 의료 영상과 같은 애플리케이션에 유용합니다.
- 시맨틱 세그멘테이션: 장면을 조밀하게 이해할 수 있도록 이미지의 모든 픽셀에 클래스 레이블을 할당합니다.
- 깊이 추정: 단일 RGB 이미지에서 픽셀별 깊이 맵을 미터 단위로 예측합니다.
- 분류: 이미지 콘텐츠를 기반으로 전체 이미지를 분류합니다.
- 포즈 추정: 움직임이나 포즈를 추적하기 위해 이미지 또는 비디오 프레임에서 특정 키포인트를 감지합니다.
- 방향성 객체 감지(OBB): 정확도를 높이기 위해 방향 각도를 추가하여 회전된 객체를 감지합니다.
Ultralytics YOLO26으로 객체 감지를 수행하려면 다음 단계를 따르세요:
- 데이터셋을 적절한 형식으로 준비합니다.
- 감지 작업을 사용하여 YOLO26 모델을 학습합니다.
- 새 이미지나 비디오 프레임을 입력하여 모델로 예측을 수행합니다.
예제from ultralytics import YOLO # 사전 학습된 YOLO 모델을 로드합니다(필요에 따라 모델 유형 조정). model = YOLO("yolo26n.pt") # n, s, m, l, x 버전을 사용할 수 있습니다 # 이미지에서 객체 탐지 수행 results = model.predict(source="image.jpg") # 비디오, 디렉터리, URL 등도 사용할 수 있습니다 # 결과를 표시합니다 results[0].show() # 첫 번째 이미지 결과를 표시합니다자세한 안내는 감지 예제를 참조하세요.
세그멘테이션 작업에 YOLO26을 사용하면 다음과 같은 여러 이점을 얻을 수 있습니다:
- 높은 정확도: 세그멘테이션 작업은 정확한 픽셀 단위 마스크를 제공합니다.
- 속도: YOLO26은 실시간 애플리케이션에 최적화되어 있어 고해상도 이미지도 빠르게 처리합니다.
- 다양한 애플리케이션: 의료 영상, 자율 주행 및 세부적인 이미지 세그멘테이션이 필요한 기타 애플리케이션에 적합합니다.
이미지 세그멘테이션 섹션에서 YOLO26의 세그멘테이션 관련 이점과 사용 사례를 자세히 알아보세요.
예. YOLO26 포즈 모델은 이미지와 비디오 프레임에서 사람의 관절과 같은 키포인트를 감지하고 이를 연결해 포즈를 구성합니다. 스포츠 분석, 의료 및 인간-컴퓨터 상호작용 애플리케이션에서 움직임을 추적하는 데 유용합니다.
자세한 내용과 구현 팁은 포즈 추정 예제를 참조하세요.
YOLO26의 방향성 객체 감지(OBB)는 각 박스에 각도 매개변수를 추가로 예측하므로, 축 정렬 박스보다 회전한 객체의 위치를 더 정확하게 파악합니다. 항공 영상 분석이나 창고 자동화처럼 회전한 객체의 정확한 위치 파악이 필요한 애플리케이션에 유용합니다.
- 더 정밀한 박스: 회전 박스는 배경을 더 적게 포함하므로 밀집되거나 기울어진 객체를 구분하는 데 도움이 됩니다.
- 다양한 애플리케이션: 지공간 분석, 로보틱스 등의 작업에 유용합니다.
자세한 내용과 예제는 방향성 객체 감지 섹션을 참조하세요.


댓글15
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(수정됨)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(수정됨)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(수정됨)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1