Ultralytics YOLOv5 아키텍처#
YOLOv5(v6.0/6.1)는 Ultralytics에서 개발한 강력한 객체 탐지 알고리즘입니다. 이 문서에서는 YOLOv5 아키텍처, 데이터 증강 전략, 학습 방법론, 손실 계산 기법을 자세히 살펴봅니다. 이러한 내용을 종합적으로 이해하면 감시, 자율주행차, 이미지 인식 등 다양한 분야에서 객체 탐지를 실제로 적용하는 데 도움이 됩니다.
1. 모델 구조#
YOLOv5 아키텍처는 세 가지 주요 부분으로 구성됩니다:
- 백본: 네트워크의 주요 본체입니다. YOLOv5 백본은 이전 버전에서 사용된 Darknet 아키텍처를 수정한
CSPDarknet53구조로 설계되었습니다. - 넥: 백본과 헤드를 연결하는 부분입니다. YOLOv5에서는
SPPF(공간 피라미드 풀링 - 고속) 및PANet(경로 집계 네트워크) 구조를 사용합니다. - 헤드: 최종 출력을 생성하는 부분입니다. YOLOv5는 이를 위해
YOLOv3 Head을 사용합니다.
아래 이미지에 모델 구조가 나와 있습니다. 모델 구조에 대한 자세한 내용은 models/yolov5l.yaml에서 확인할 수 있습니다.
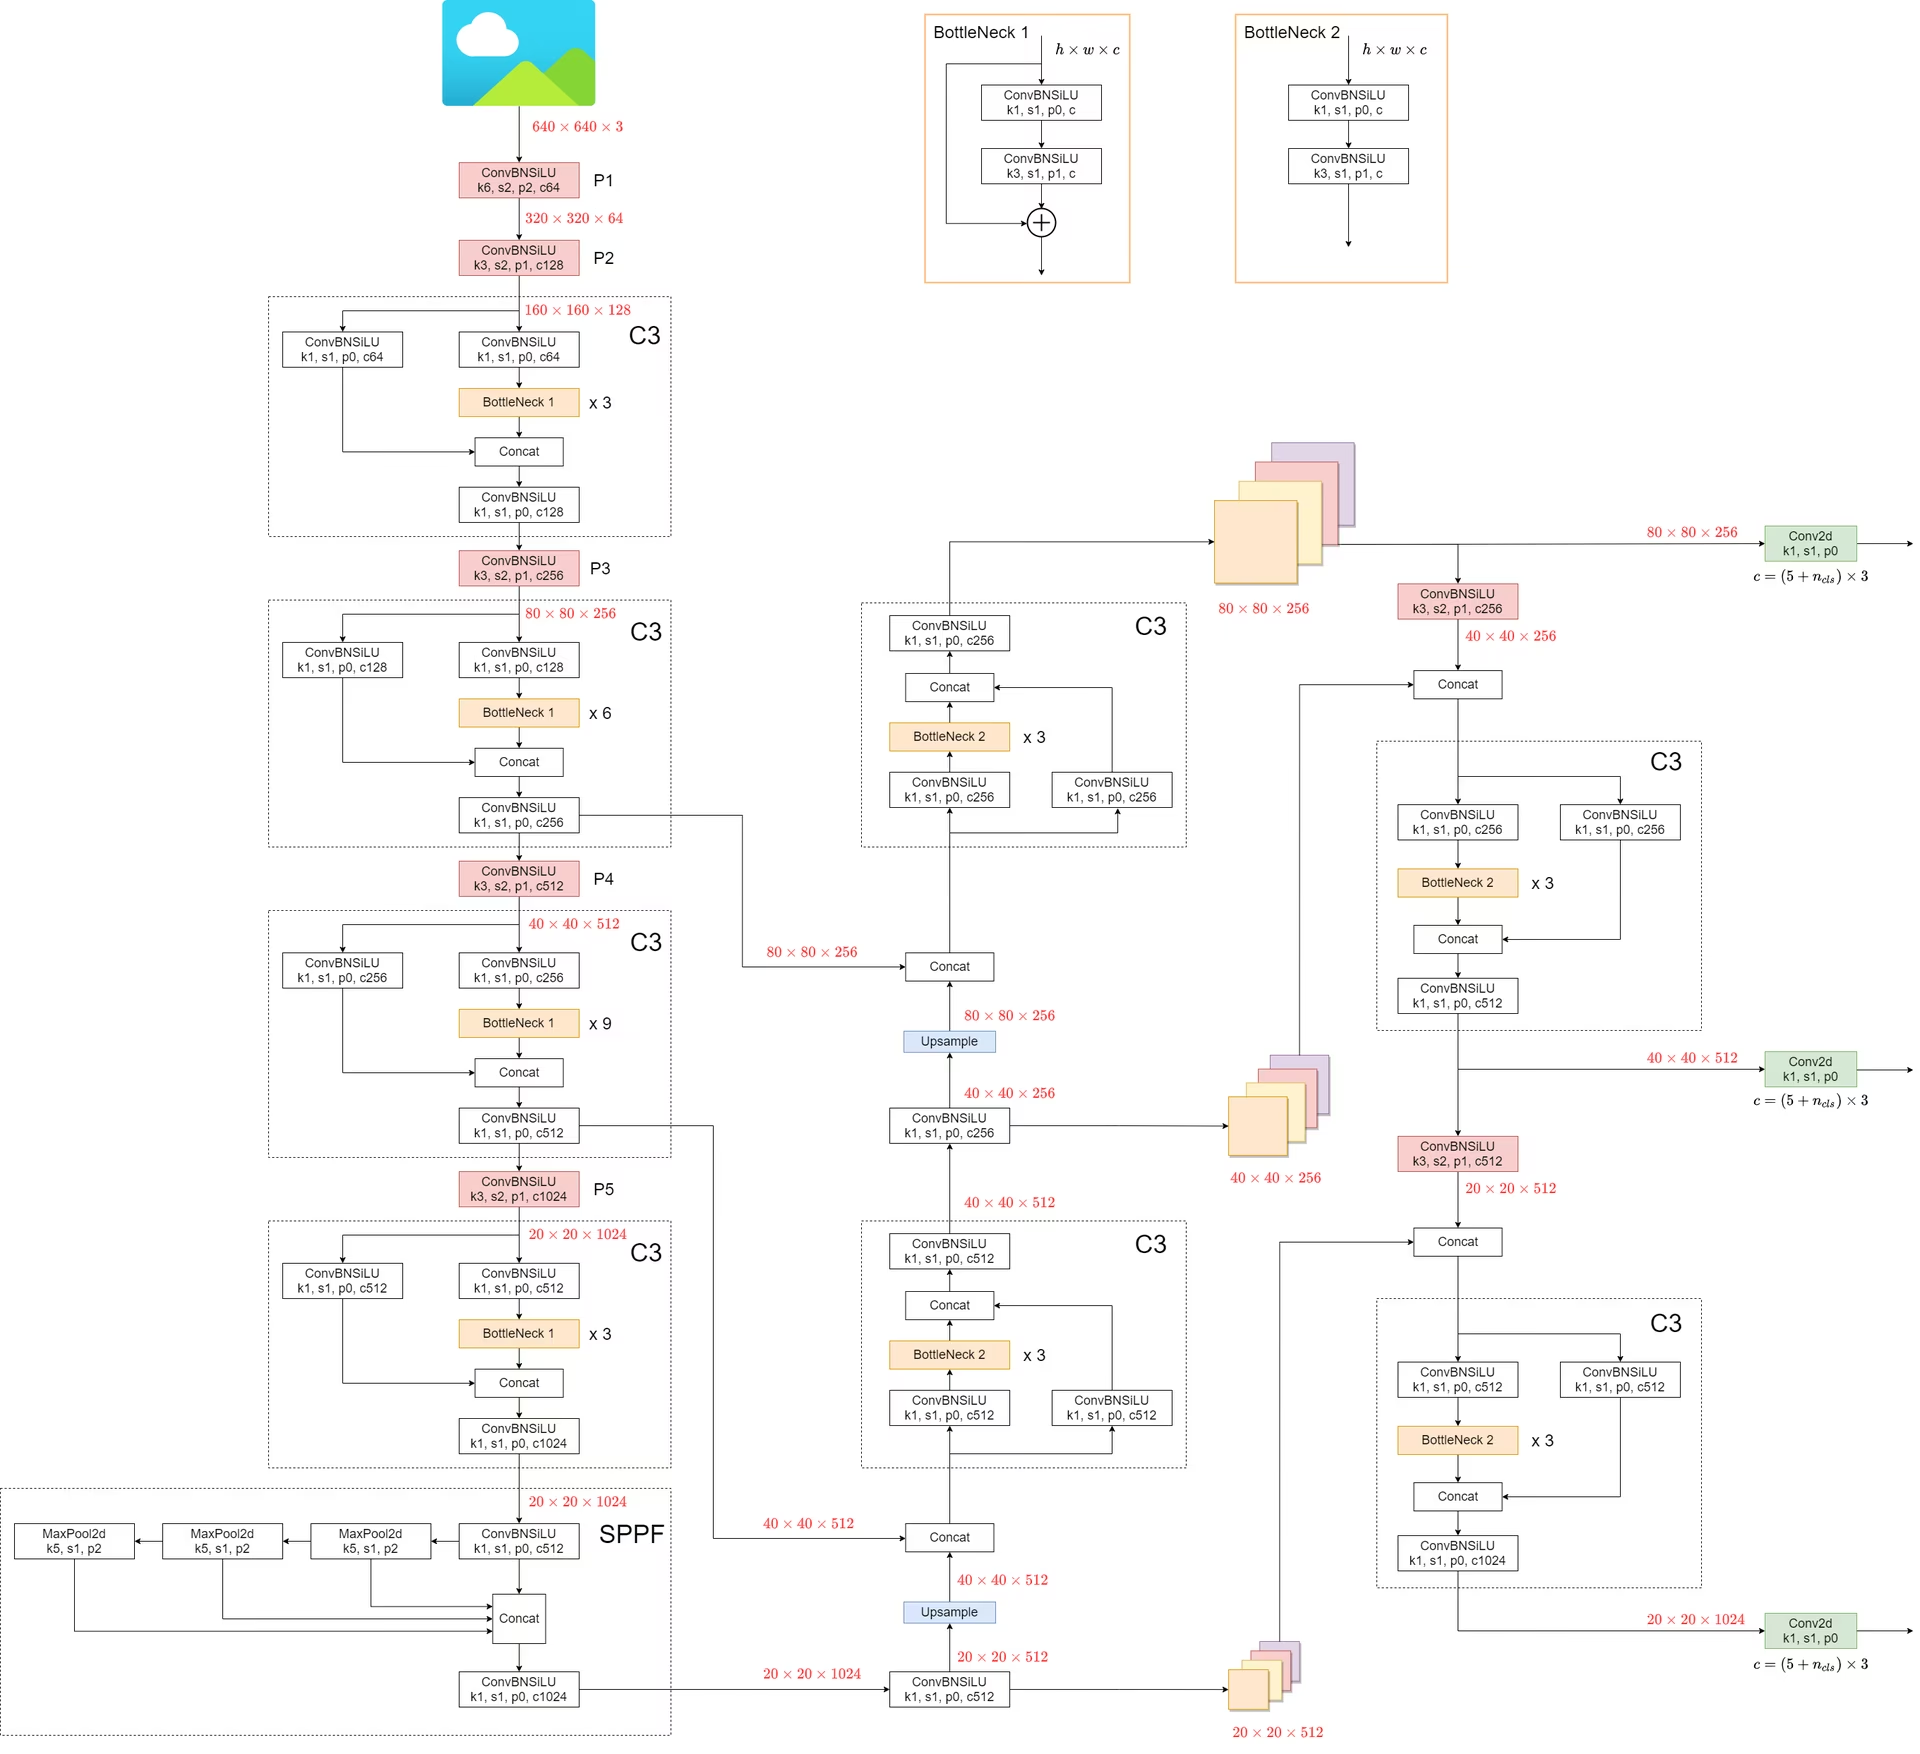
YOLOv5에는 이전 버전과 비교해 주목할 만한 개선 사항이 있습니다:
- 이전 버전에서 사용하던
Focus구조를6x6 Conv2d구조로 대체했습니다. 이 변경으로 효율성이 향상됩니다 #4825. SPP구조를SPPF로 대체했습니다. 이 변경으로 동일한 출력을 유지하면서 처리 속도가 두 배 이상 빨라집니다.
SPP 및 SPPF의 속도를 테스트하려면 다음 코드를 사용할 수 있습니다:
SPP와 SPPF 속도 프로파일링 예시(클릭하여 열기)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
결과:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. 데이터 증강 기법#
YOLOv5는 모델의 일반화 능력을 높이고 과적합을 줄이기 위해 다양한 데이터 증강 기법을 사용합니다. 이러한 기법은 다음과 같습니다:
-
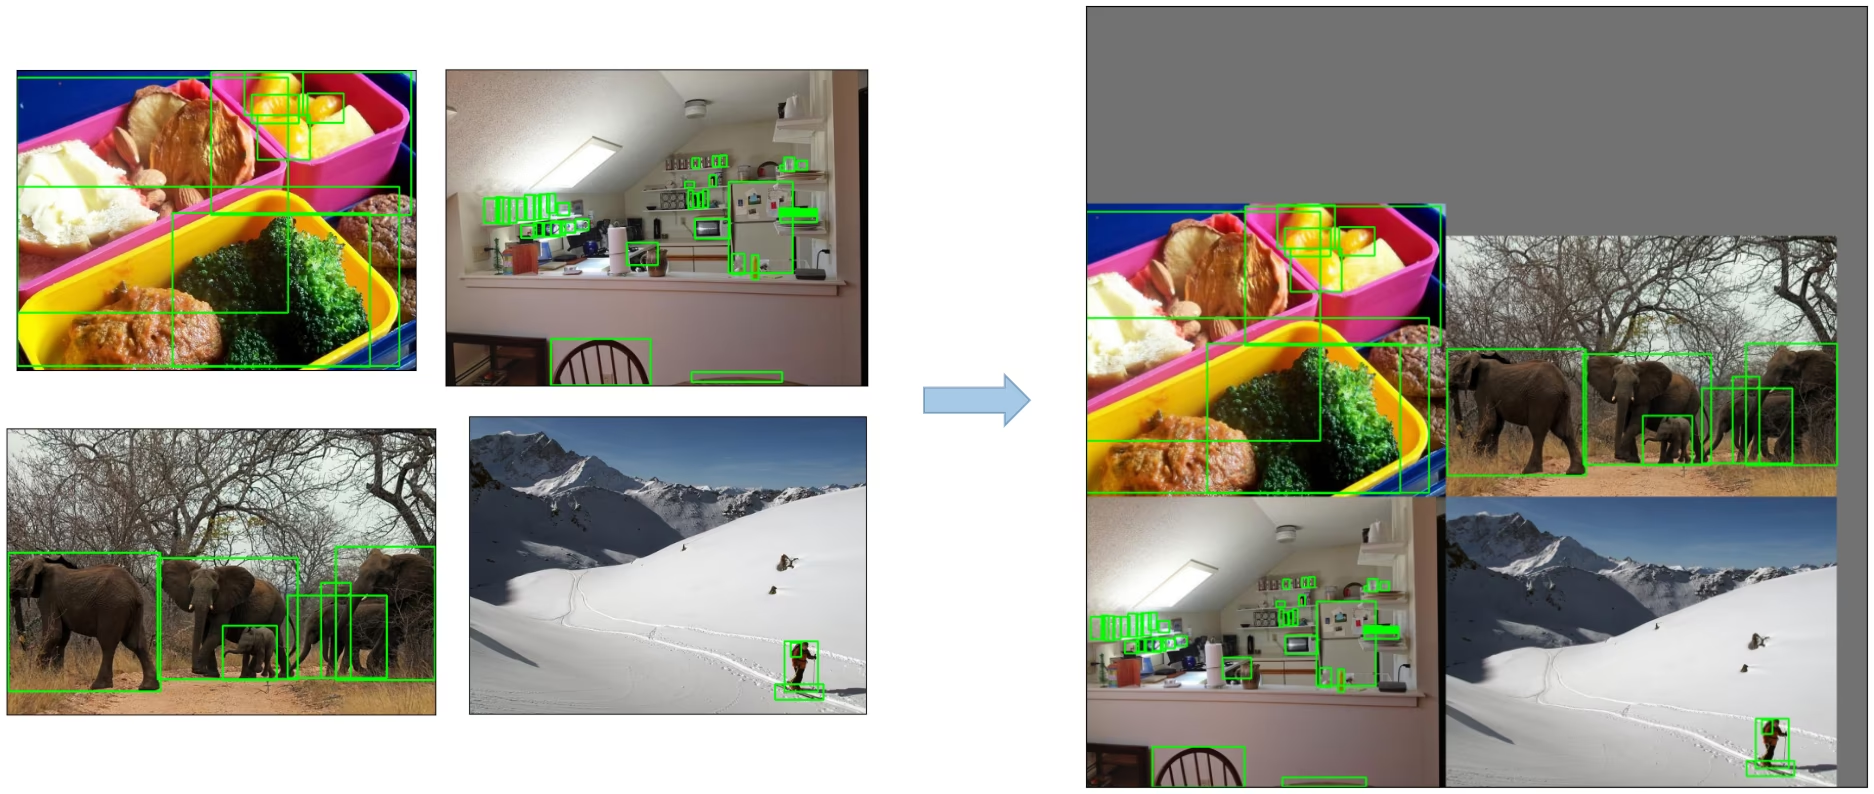
모자이크 증강: 네 개의 학습 이미지를 하나로 결합하는 이미지 처리 기법으로, 객체 탐지 모델이 다양한 객체 크기와 이동을 더 잘 처리하도록 합니다.
-
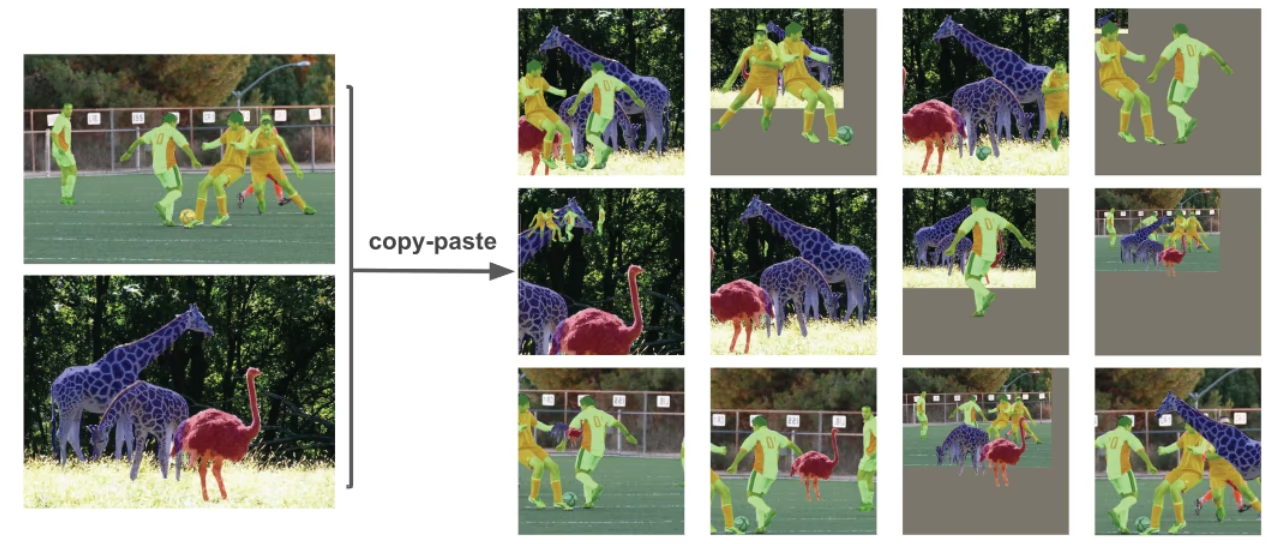
복사-붙여넣기 증강: 이미지에서 무작위 패치를 복사해 무작위로 선택한 다른 이미지에 붙여넣어 새로운 학습 샘플을 생성하는 혁신적인 데이터 증강 방법입니다.
-
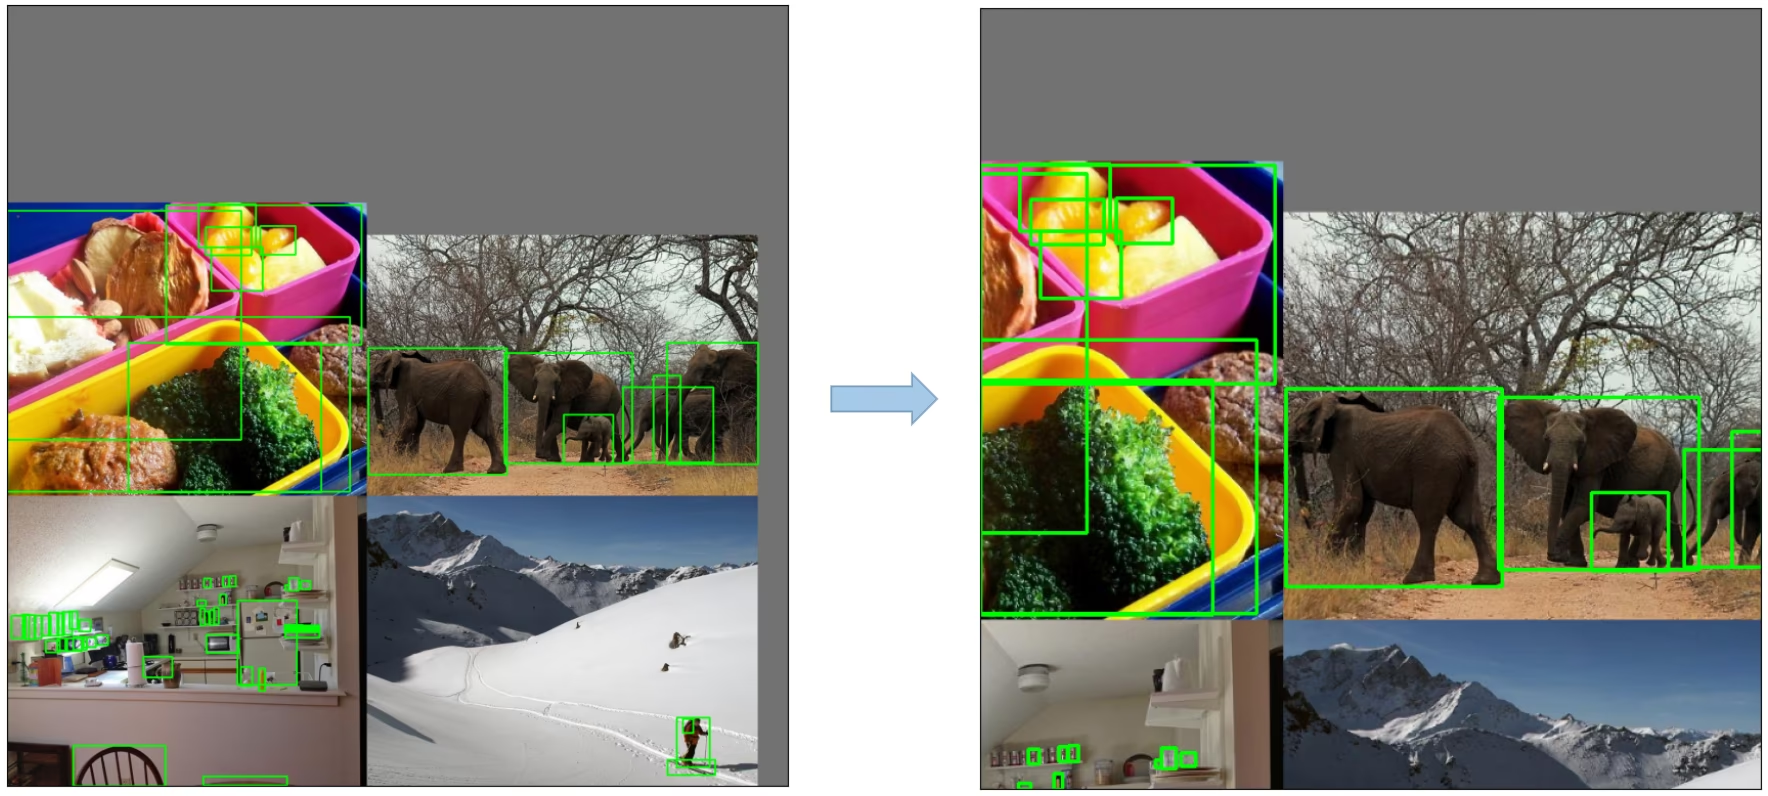
무작위 아핀 변환: 이미지를 무작위로 회전, 크기 조정, 이동, 전단하는 작업이 포함됩니다.
-
MixUp 증강: 두 이미지와 각 이미지에 대응하는 레이블을 선형 결합해 합성 이미지를 만드는 방법입니다.
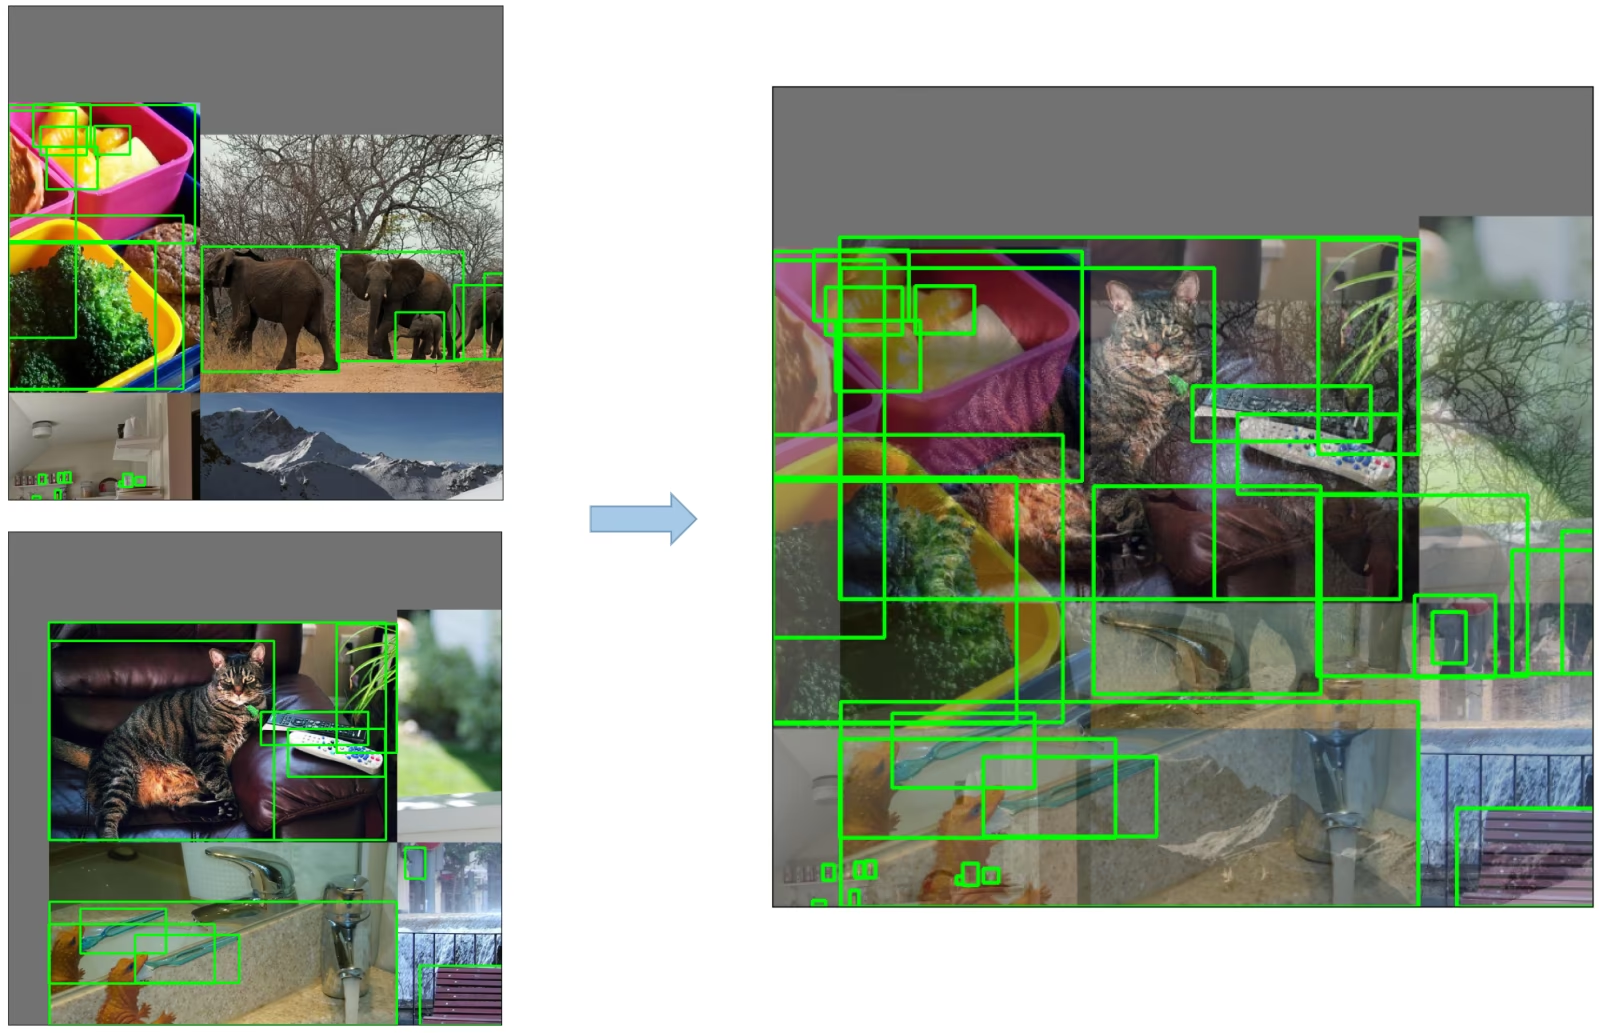
-
Albumentations: 다양한 증강 기법을 지원하는 강력한 이미지 증강 라이브러리입니다. Albumentations 증강 사용 방법을 자세히 알아보세요.
-
HSV 증강: 이미지의 색조, 채도, 명도를 무작위로 변경합니다.
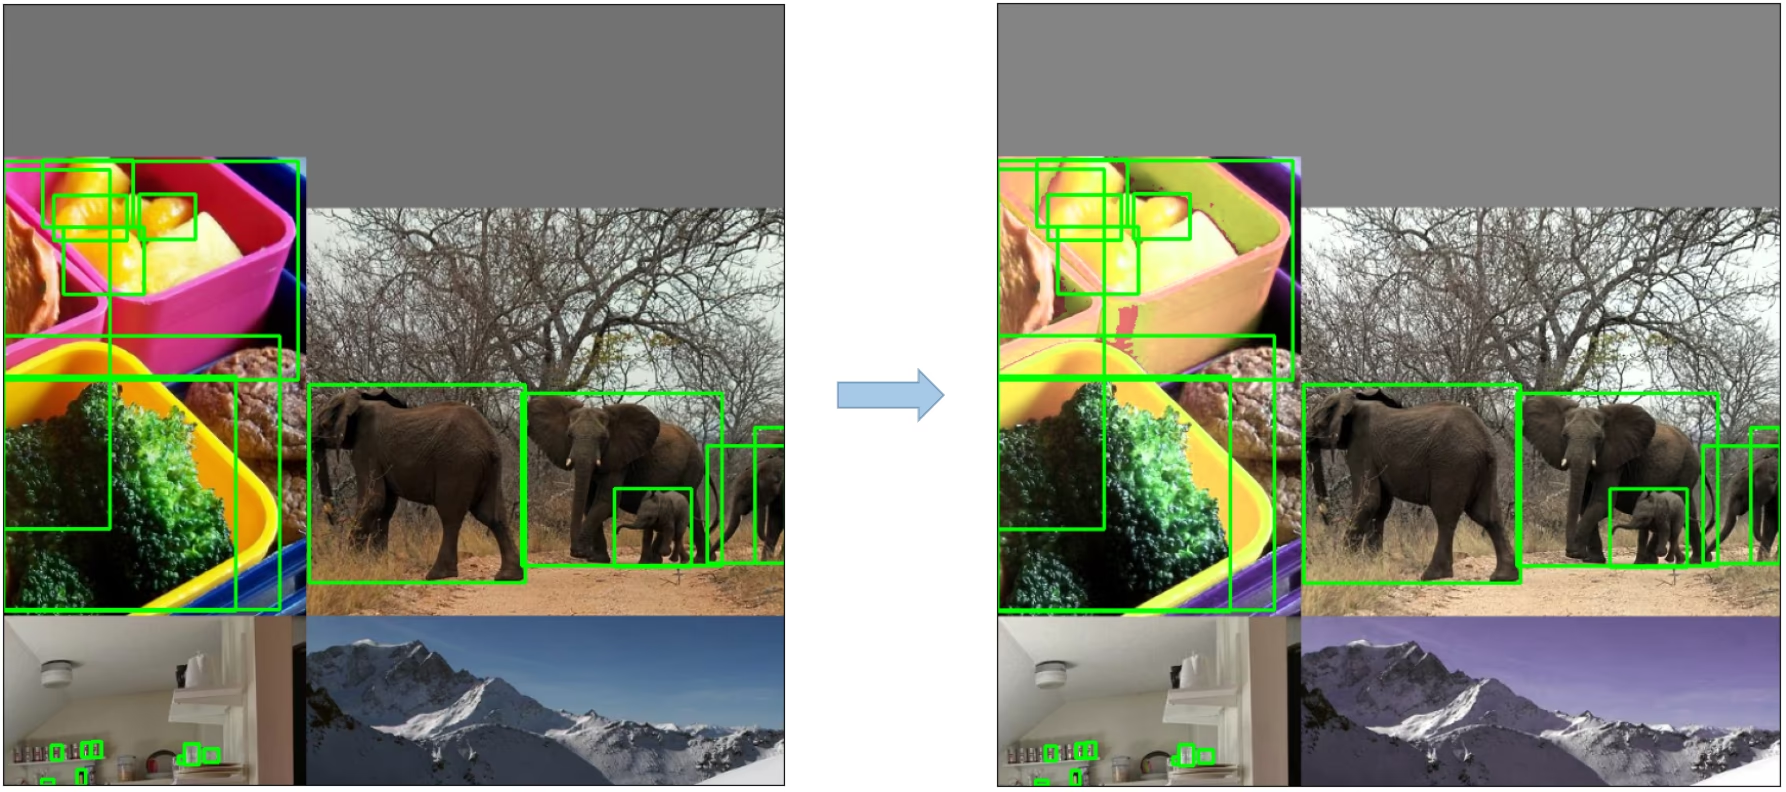
-
무작위 수평 뒤집기: 이미지를 무작위로 수평 방향으로 뒤집는 증강 방법입니다.
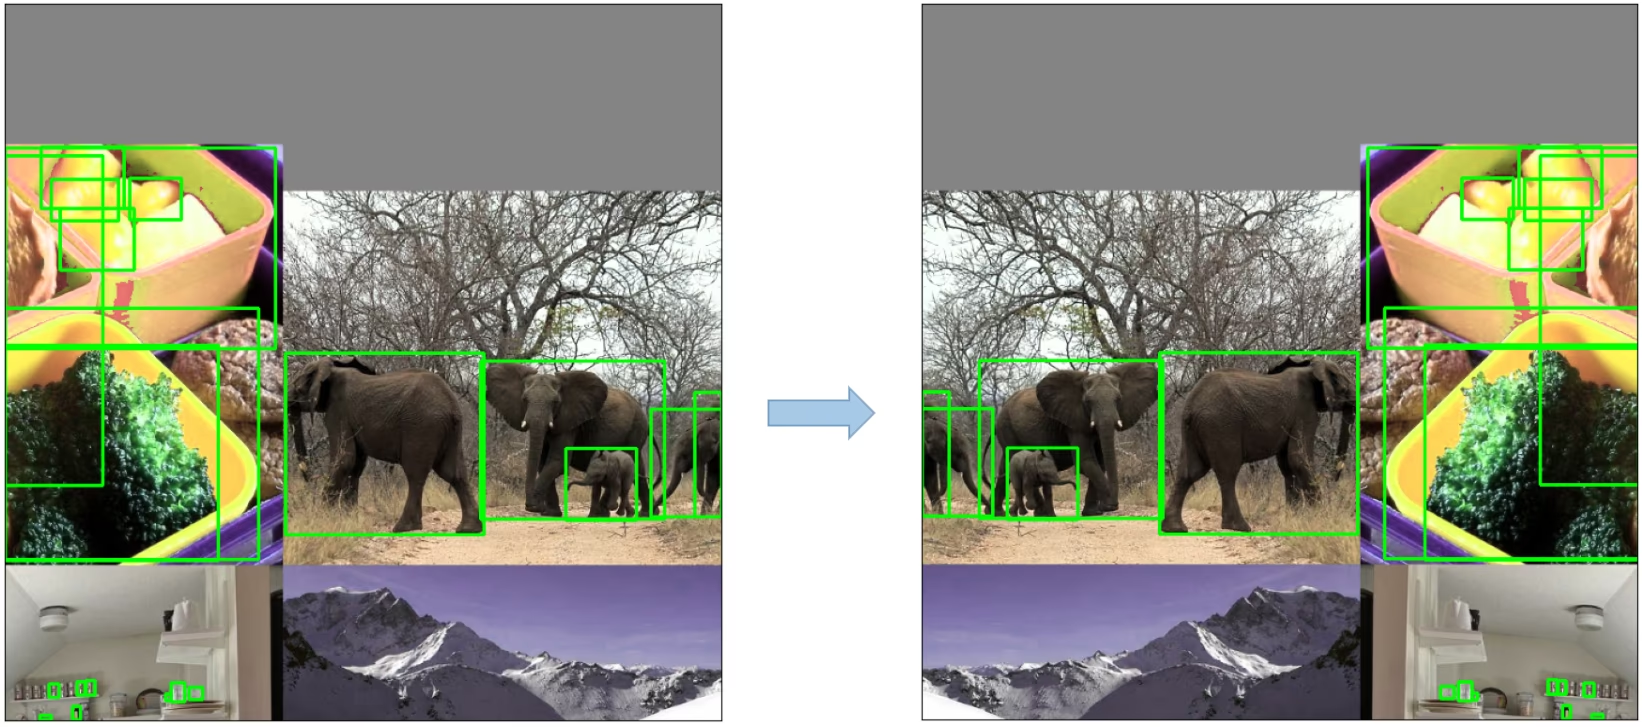
3. 학습 전략#
YOLOv5는 모델 성능을 높이기 위해 몇 가지 정교한 학습 전략을 적용합니다. 전략은 다음과 같습니다:
- 다중 스케일 학습: 학습 중 입력 이미지의 크기를 원래 크기의 0.5~1.5배 범위에서 무작위로 조정합니다.
- AutoAnchor: 이 전략은 사용자 지정 데이터의 ground truth 박스 통계 특성에 맞도록 사전 앵커 박스를 최적화합니다.
- Warmup and Cosine LR Scheduler: 모델 성능을 향상하기 위해 학습률을 조정하는 방법입니다.
- 지수 이동 평균(EMA): 이전 단계들의 파라미터 평균을 사용해 학습 과정을 안정화하고 일반화 오류를 줄이는 전략입니다.
- 혼합 정밀도 학습: 절반-정밀도 형식으로 연산을 수행해 메모리 사용량을 줄이고 계산 속도를 높이는 방법입니다.
- 하이퍼파라미터 탐색: 최적의 성능을 달성하도록 하이퍼파라미터를 자동으로 조정하는 전략입니다. 하이퍼파라미터 탐색 튜토리얼을 참조하세요.
4. 추가 기능#
4.1 손실 계산#
YOLOv5의 손실은 다음 세 가지 개별 손실 구성 요소를 조합해 계산합니다.
- 클래스 손실(BCE Loss): 이진 교차 엔트로피 손실로, 분류 작업의 오류를 측정합니다.
- 객체성 손실(BCE Loss): 또 다른 이진 교차 엔트로피 손실로, 특정 그리드 셀에 객체가 있는지를 감지할 때 발생하는 오류를 계산합니다.
- 위치 손실(CIoU Loss): 완전 IoU 손실로, 그리드 셀 내 객체 위치를 추정할 때 발생하는 오류를 측정합니다.
전체 손실 함수는 다음과 같이 표현됩니다.
4.2 손실 균형 조정#
세 예측 레이어(P3, P4, P5)의 객체성 손실에는 서로 다른 가중치를 적용합니다. 균형 가중치는 각각 [4.0, 1.0, 0.4]입니다. 이 방법을 통해 서로 다른 스케일의 예측이 전체 손실에 적절히 기여하도록 합니다.
4.3 그리드 민감도 제거#
YOLOv5 아키텍처는 이전 YOLO 버전과 비교해 박스 예측 전략에 몇 가지 중요한 변경 사항을 적용했습니다. YOLOv2와 YOLOv3에서는 마지막 레이어의 활성화 값을 사용해 박스 좌표를 직접 예측했습니다.

하지만 YOLOv5에서는 그리드 민감도를 줄이고 모델이 제한 없는 박스 크기를 예측하지 않도록 박스 좌표 예측 공식을 수정했습니다.
수정된 경계 상자 예측 공식은 다음과 같습니다.
스케일링 전후의 중심점 오프셋을 비교해 보세요. 중심점 오프셋 범위가 (0, 1)에서 (-0.5, 1.5)로 조정됩니다. 따라서 오프셋은 0 또는 1에 쉽게 도달할 수 있습니다.

조정 전후의 높이 및 너비 스케일 비율(앵커 기준)을 비교해 보세요. 기존 yolo/darknet 박스 방정식에는 심각한 결함이 있습니다. 너비와 높이는 단순히 out=exp(in)으로 계산되므로 완전히 제한되지 않습니다. 이는 그래디언트 폭주, 불안정성, NaN 손실, 궁극적으로 학습의 완전한 실패를 초래할 수 있어 위험합니다. 자세한 내용은 이슈를 참조하세요.

4.4 타깃 생성#
YOLOv5의 타깃 생성 과정은 학습 효율과 모델 정확도에 매우 중요합니다. 출력 맵의 적절한 그리드 셀에 ground truth 박스를 할당하고 해당 박스를 적절한 앵커 박스와 매칭하는 과정입니다.
이 과정은 다음 단계를 따릅니다.
- ground truth 박스의 크기와 각 앵커 템플릿 크기의 비율을 계산합니다.

- 계산된 비율이 임계값 이내이면 ground truth 박스를 해당 앵커와 매칭합니다.

- 매칭된 앵커를 적절한 셀에 할당합니다. 수정된 중심점 오프셋으로 인해 ground truth 박스가 둘 이상의 앵커에 할당될 수 있다는 점에 유의해야 합니다. 중심점 오프셋 범위가 (0, 1)에서 (-0.5, 1.5)로 조정되어 추가 매칭이 가능해지기 때문입니다.

이와 같은 타깃 생성 과정을 통해 학습 중 각 ground truth 객체를 적절히 할당하고 매칭할 수 있으며, YOLOv5는 객체 감지 작업을 더 효과적으로 학습할 수 있습니다.
결론#
YOLOv5는 실시간 객체 감지의 발전 과정에서 의미 있는 진전을 보여 줍니다. 아키텍처 설계, 학습 전략, 엔지니어링 개선을 통해 이전 YOLO 버전에 비해 우수한 성능과 효율성을 제공합니다.
YOLOv5의 주요 개선 사항에는 동적 아키텍처, 다양한 데이터 증강 기법, 혁신적인 학습 전략, 손실 계산 및 타깃 생성 과정의 중요한 조정이 포함됩니다. 이러한 혁신은 YOLO 모델의 특징인 높은 속도를 유지하면서 객체 감지의 정확도와 효율성을 크게 높입니다.
자주 묻는 질문#
CSPDarknet53 백본이 특징을 추출하고, SPPF와 PANet 넥이 여러 스케일의 특징을 융합하며, YOLOv3 스타일 헤드가 스트라이드 8, 16, 32에서 박스, 객체성, 클래스를 예측합니다. 전체 레이어 목록은
models/yolov5l.yaml에 있습니다.SPPF는 5x5, 9x9, 13x13 풀링을 병렬로 실행하는 대신 5x5 최대 풀링 연산 세 개를 연이어 수행합니다. 출력은 수학적으로 동일하지만, 위의 프로파일링 코드 조각에서 볼 수 있듯이 두 배 이상 빠르게 실행됩니다.
기존 YOLO 오프셋은 정확히 0이나 1이 될 수 없어 그리드 경계에 중심이 놓인 객체를 예측하기 어려웠습니다. 시그모이드의 범위를 (-0.5, 1.5)로 스케일링하면 그리드 민감도가 제거됩니다. 또한 너비와 높이에
2σ을 제곱해 적용하면 예측값이 앵커 크기의 4배로 제한되어, 제한이 없는 지수 함수로 인해 발생하는 그래디언트 폭주를 방지합니다.박스 대비 너비와 높이 비율이
anchor_t(기본값 4.0) 이내인 앵커는 모두 매칭됩니다. 확장된 오프셋 범위 덕분에 해당 박스는 인접한 두 그리드 셀에도 할당될 수 있습니다. 따라서 하나의 객체가 여러 개의 양성 타깃을 생성할 수 있으며, 이는 수렴 속도를 높입니다.