YOLOv5에서 레이어를 고정한 전이 학습#
📚 이 가이드에서는 전이 학습을 구현할 때 YOLOv5 🚀 레이어를 고정하는 방법을 설명합니다. 전이 학습은 전체 네트워크를 처음부터 다시 학습하지 않고도 새 데이터로 모델을 빠르게 재학습할 수 있는 강력한 머신러닝(ML) 기법입니다. 초기 레이어의 가중치를 고정하고 후반 레이어의 매개변수만 업데이트하면 컴퓨팅 리소스 요구량과 학습 시간을 크게 줄일 수 있습니다. 하지만 이 방식은 최종 모델의 정확도에 약간 영향을 줄 수 있습니다.
시작하기 전에#
먼저 YOLOv5 리포지토리를 복제하고 requirements.txt에 나열된 필수 종속 항목을 설치합니다. Python>=3.8.0 환경에 PyTorch>=1.8이 설치되어 있는지 확인하세요. 사전 학습된 모델과 필요한 데이터셋은 최신 YOLOv5 릴리스에서 자동으로 다운로드됩니다.
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
레이어 고정의 작동 방식#
신경망의 레이어를 고정하면 학습 중 해당 매개변수(가중치와 편향)가 업데이트되지 않습니다. PyTorch에서는 레이어 텐서의 requires_grad 속성을 False로 설정하여 이를 구현합니다. 따라서 역전파 중에는 해당 레이어의 그래디언트가 계산되지 않아 연산과 메모리를 절약할 수 있습니다.
YOLOv5의 학습 스크립트에서 레이어 고정을 구현하는 방식은 다음과 같습니다:
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
        v.requires_grad = False  # Disable gradient calculation for frozen layers
모델 아키텍처 살펴보기#
YOLOv5 모델의 구조를 이해하는 것은 고정할 레이어를 결정하는 데 중요합니다. 다음 Python 코드로 모든 모듈의 이름과 매개변수를 확인할 수 있습니다:
# 'model'이 로드된 YOLOv5 모델 인스턴스라고 가정합니다
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""
YOLOv5 아키텍처는 일반적으로 백본(YOLOv5s/m/l/x와 같은 표준 구성에서 0~9번 레이어)과 특징 추출을 담당하는 부분, 그리고 객체 탐지를 수행하는 헤드(나머지 레이어)로 구성됩니다.
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
    # ... subsequent head layers for feature fusion and detection
고정 옵션#
학습 명령에서 --freeze 인수를 사용해 고정할 레이어를 제어할 수 있습니다. 이 인수는 첫 번째 고정 해제된 모듈의 인덱스를 지정하며, 이 인덱스보다 앞선 모든 모듈의 가중치가 고정됩니다. 대신 여러 인덱스(예: --freeze 0 1 2)를 전달하면 해당 모듈만 고정됩니다. 특정 블록에 해당하는 인덱스를 확인하려면 model.model(a nn.Sequential)를 사용해 모듈 순서를 확인하세요.
백본만 고정#
대규모 데이터셋인 COCO에서 학습한 일반적인 특징 추출 능력을 유지하면서 모델을 새로운 객체 클래스에 적용할 때 흔히 사용하는 방법으로, 백본 전체(0~9번 레이어)를 고정하려면 다음과 같이 합니다:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10대상 데이터셋의 저수준 시각적 특징(에지, 텍스처)이 원본 학습 데이터(예: COCO)와 비슷하지만 객체 범주는 다른 경우 이 전략이 효과적입니다.
최종 탐지 레이어를 제외한 모든 레이어 고정#
최종 출력 합성곱 레이어만 학습 가능하도록 네트워크의 거의 전체를 고정하려면 다음과 같이 합니다. 최종 출력 합성곱 레이어는 Detect 모듈(일반적으로 마지막 모듈이며, 예를 들어 YOLOv5s에서는 모듈 24)에 포함됩니다:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24이 방법은 학습된 특징 대부분을 유지하면서 출력 클래스 수가 다른 모델에 맞게 조정해야 하는 경우 유용합니다. 파인튜닝에 필요한 컴퓨팅 리소스가 가장 적습니다.
성능 비교#
레이어 고정의 효과를 보여주기 위해 공식 COCO 사전 학습 가중치(yolov5m.pt)에서 시작해 Pascal VOC 데이터셋으로 YOLOv5m을 50개 에포크 동안 학습했습니다. 세 가지 시나리오를 비교했습니다. 모든 레이어 학습(--freeze 0), 백본 고정(--freeze 10), 최종 탐지 레이어를 제외한 모든 레이어 고정(--freeze 24)입니다.
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10
정확도 결과#
결과에 따르면 레이어를 고정하면 학습 속도가 크게 빨라질 수 있지만 최종 mAP(평균 정밀도)가 약간 낮아질 수 있습니다. 일반적으로 모든 레이어를 학습할 때 정확도가 가장 높으며, 더 많은 레이어를 고정하면 학습 속도는 빨라지는 대신 성능이 낮아질 수 있습니다.
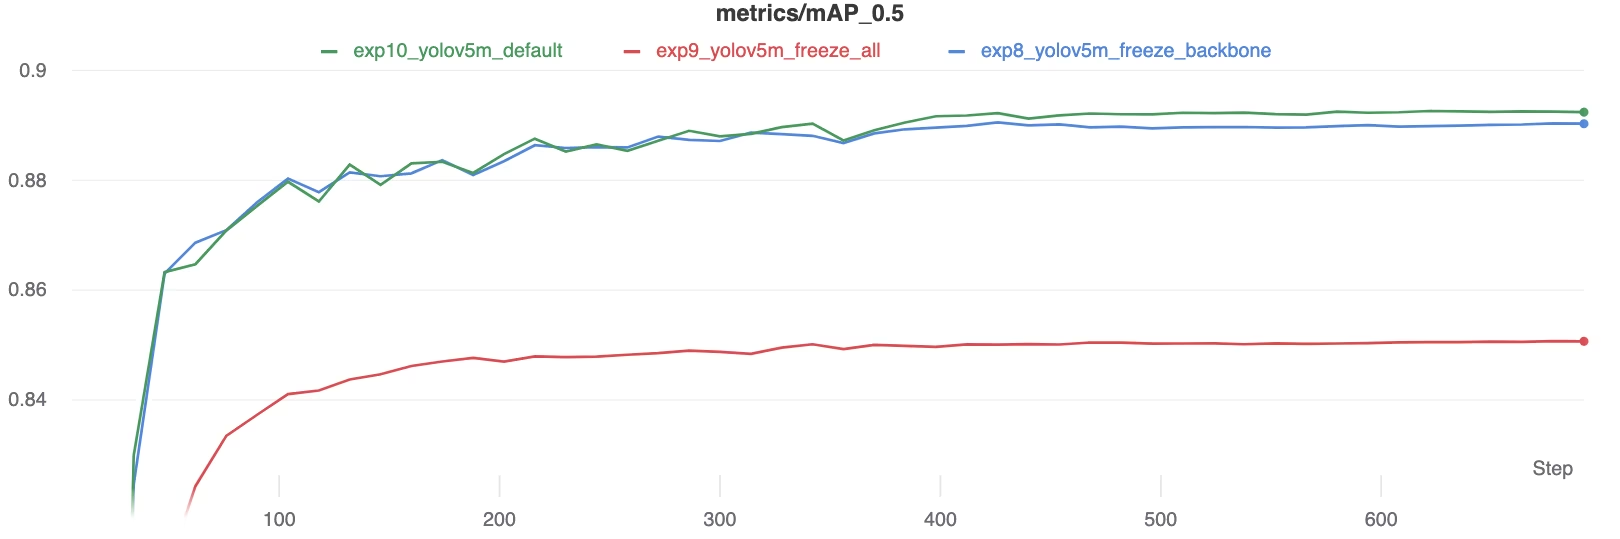 mAP50 학습 중 비교
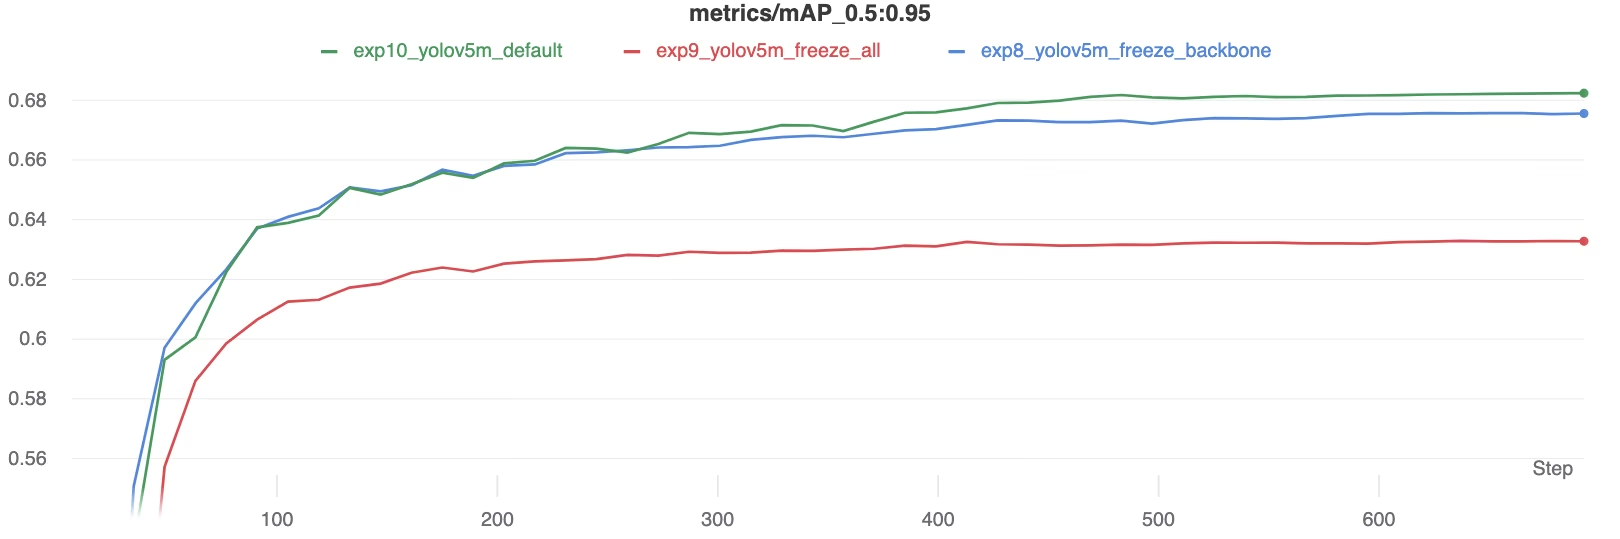 mAP50-95 학습 중 비교
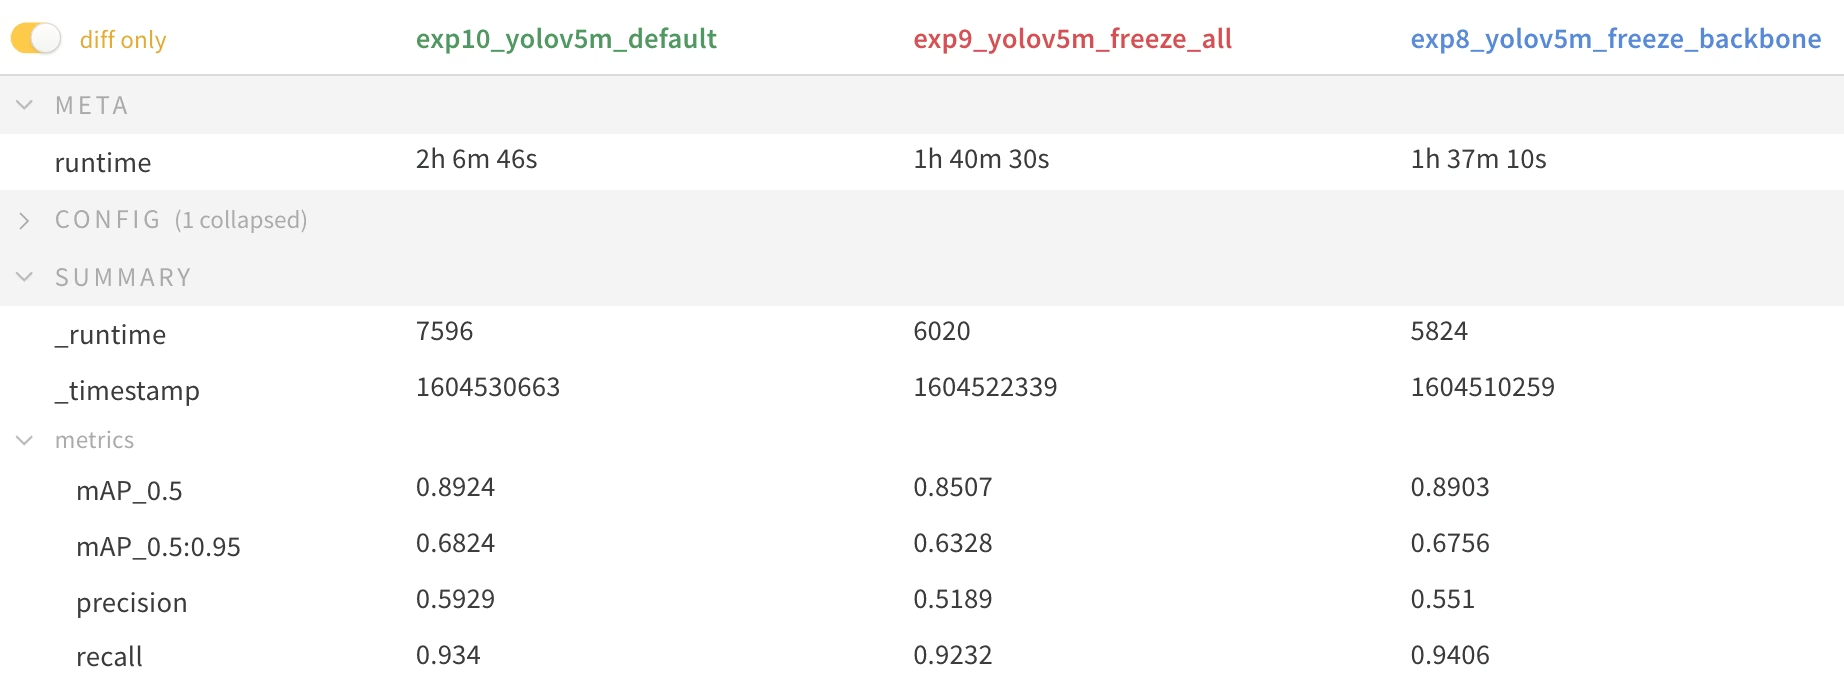 *성능 지표 요약 표*
리소스 사용량#
더 많은 레이어를 고정하면 GPU 메모리 요구량과 전체 사용량이 크게 줄어듭니다. 따라서 하드웨어 리소스가 제한적인 경우 레이어를 고정한 전이 학습이 유용하며, 이를 통해 더 큰 모델이나 더 큰 이미지 크기로 학습할 수 있습니다.
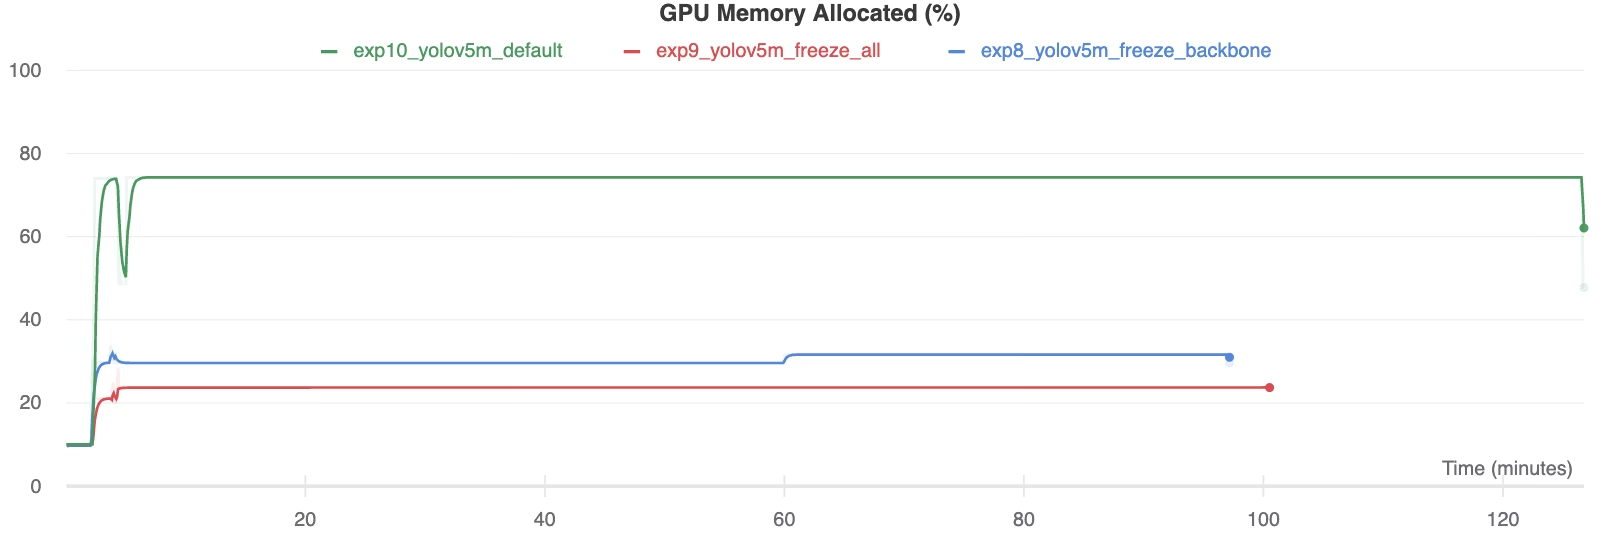 GPU 메모리 할당량(%)
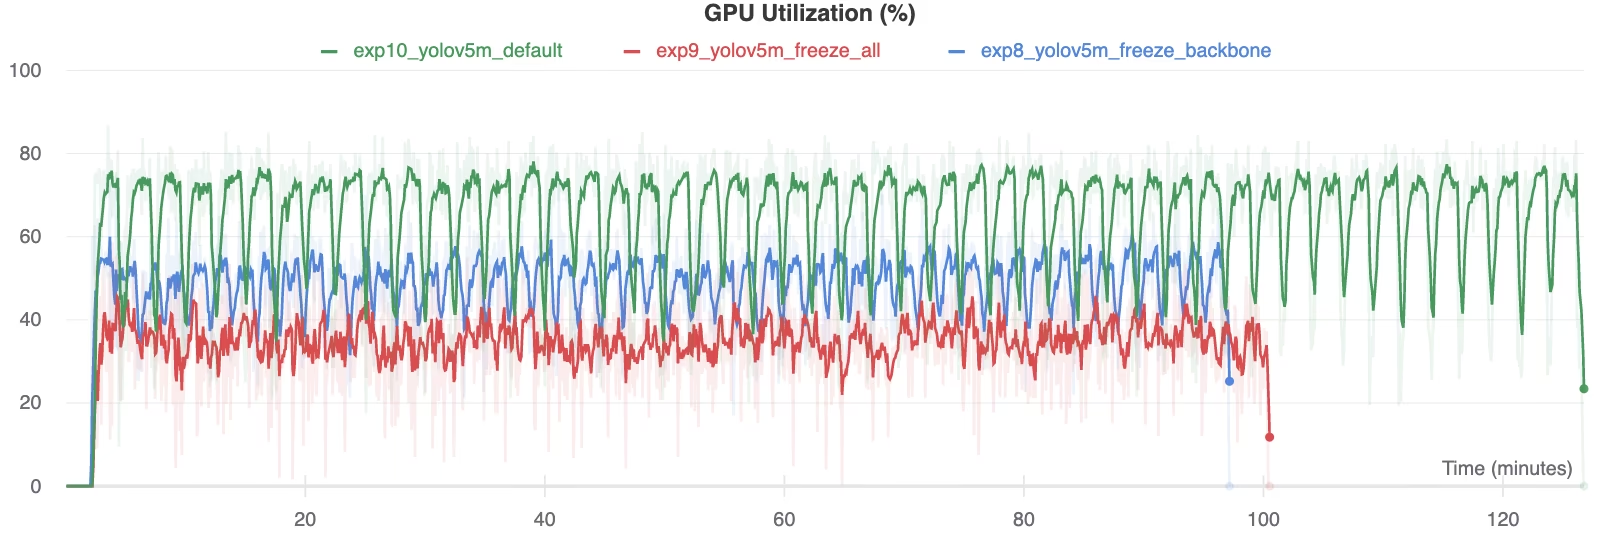 GPU 사용률(%)
레이어 고정을 사용하는 경우#
전이 학습 중 레이어 고정은 다음과 같은 여러 상황에서 특히 유용합니다:
- 제한된 컴퓨팅 리소스: GPU 메모리나 처리 성능에 제약이 있는 경우입니다.
- 소규모 데이터셋: 대상 데이터셋이 사전 학습에 사용한 원본 데이터셋보다 훨씬 작을 때 레이어 고정은 과적합을 방지하는 데 도움이 됩니다.
- 신속한 프로토타이핑: 초기 평가를 위해 기존 모델을 새 작업이나 도메인에 빠르게 적용해야 하는 경우입니다.
- 유사한 특징 도메인: 새 데이터셋의 저수준 특징이 모델의 사전 학습 데이터셋에 포함된 특징과 매우 유사한 경우입니다.
전이 학습의 세부 사항은 용어집 항목에서 자세히 알아보고, 성능 최적화를 위해 하이퍼파라미터 진화도 고려해 보세요.
지원 환경#
Ultralytics는 CUDA, CuDNN, Python, PyTorch와 같은 필수 종속 항목이 사전 설치된 다양한 즉시 사용 가능한 환경을 제공합니다.
- 무료 GPU 노트북:


- Google Cloud: GCP 빠른 시작 가이드
- Amazon: AWS 빠른 시작 가이드
- Azure: AzureML 빠른 시작 가이드
- Docker: Docker 빠른 시작 가이드

프로젝트 상태#

이 배지는 모든 YOLOv5 GitHub Actions 지속적 통합(CI) 테스트가 성공적으로 통과했음을 확인합니다. 이러한 CI 테스트는 학습, 검증, 추론, 내보내기, 벤치마크 등 주요 작업에서 YOLOv5의 기능과 성능을 엄격하게 평가합니다. 테스트는 macOS, Windows, Ubuntu에서 일관되고 안정적으로 작동하는지 확인하며, 24시간마다 그리고 새 코드 커밋이 있을 때마다 자동으로 실행됩니다.
자주 묻는 질문#
model.model의 첫N개 모듈을 고정하므로 가중치가 고정된 상태로 유지되고 그래디언트를 받지 않습니다.--freeze 10는 백본을 고정하며,--freeze 24은 최종Detect모듈을 제외한 모든 모듈을 고정합니다.위 VOC 실험에서는 모든 레이어를 학습했을 때 mAP가 가장 높았고, 백본을 고정하면 정확도가 조금 낮아졌으며, 탐지 헤드만 남기고 모두 고정했을 때 정확도가 가장 크게 낮아졌습니다. 대신 레이어를 고정한 실행은 더 빠르게 학습되고 GPU 메모리를 훨씬 적게 사용합니다.
이미지가 사전 학습 데이터와 저수준 특징을 공유하거나, 데이터셋이 작거나, 제한된 하드웨어에서 빠르게 기준 성능을 확인해야 하는 경우입니다. 데이터셋이 커지거나 mAP를 조금이라도 더 높여야 한다면 모든 레이어를 학습하세요.
예. 고정된 모델의
best.pt에서--freeze없이 새 실행을 시작하면 일반적으로 더 낮은 학습률로 네트워크 전체를 파인튜닝할 수 있습니다.