TFLite, ONNX, CoreML, TensorRT 내보내기#
📚 이 가이드에서는 학습된 YOLOv5 🚀 모델을 PyTorch에서 ONNX, TensorRT, CoreML 등을 포함한 다양한 배포 형식으로 내보내는 방법을 설명합니다.
시작하기 전에#
Python>=3.8.0 환경에서 requirements.txt를 사용하여 리포지토리를 클론하고 설치합니다. 여기에는 PyTorch>=1.8도 포함됩니다. 모델과 데이터셋은 최신 YOLOv5 릴리스에서 자동으로 다운로드됩니다.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
TensorRT 내보내기 예제(GPU 필요)는 Colab 노트북의 부록 섹션을 참조하십시오. 
지원되는 Export Format#
YOLOv5 추론은 공식적으로 12개 형식을 지원합니다:
| 형식 | export.py --include | 모델 |
|---|---|---|
| PyTorch | - | yolov5s.pt |
| TorchScript | torchscript | yolov5s.torchscript |
| ONNX | onnx | yolov5s.onnx |
| OpenVINO | openvino | yolov5s_openvino_model/ |
| TensorRT | engine | yolov5s.engine |
| CoreML | coreml | yolov5s.mlpackage |
| TensorFlow SavedModel | saved_model | yolov5s_saved_model/ |
| TensorFlow GraphDef | pb | yolov5s.pb |
| TensorFlow Lite | tflite | yolov5s.tflite |
| TensorFlow Edge TPU | edgetpu | yolov5s_edgetpu.tflite |
| TensorFlow.js | tfjs | yolov5s_web_model/ |
| PaddlePaddle | paddle | yolov5s_paddle_model/ |
벤치마크#
아래 벤치마크는 YOLOv5 튜토리얼 노트북이 포함된 Colab Pro에서 실행되었습니다. . 재현하려면 다음을 수행하십시오:
python benchmarks.py --weights yolov5s.pt --imgsz 640 --device 0Colab Pro V100 GPU#
benchmarks: weights=/content/yolov5/yolov5s.pt, imgsz=640, batch_size=1, data=/content/yolov5/data/coco128.yaml, device=0, half=False, test=False
Checking setup...
YOLOv5 🚀 v6.1-135-g7926afc torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)
Setup complete ✅ (8 CPUs, 51.0 GB RAM, 46.7/166.8 GB disk)

Benchmarks complete (458.07s)
                   Format  mAP@0.5:0.95  Inference time (ms)
0                 PyTorch        0.4623                10.19
1             TorchScript        0.4623                 6.85
2                    ONNX        0.4623                14.63
3                OpenVINO           NaN                  NaN
4                TensorRT        0.4617                 1.89
5                  CoreML           NaN                  NaN
6   TensorFlow SavedModel        0.4623                21.28
7     TensorFlow GraphDef        0.4623                21.22
8         TensorFlow Lite           NaN                  NaN
9     TensorFlow Edge TPU           NaN                  NaN
10          TensorFlow.js           NaN                  NaN
Colab Pro CPU#
benchmarks: weights=/content/yolov5/yolov5s.pt, imgsz=640, batch_size=1, data=/content/yolov5/data/coco128.yaml, device=cpu, half=False, test=False
Checking setup...
YOLOv5 🚀 v6.1-135-g7926afc torch 1.10.0+cu111 CPU
Setup complete ✅ (8 CPUs, 51.0 GB RAM, 41.5/166.8 GB disk)

Benchmarks complete (241.20s)
                   Format  mAP@0.5:0.95  Inference time (ms)
0                 PyTorch        0.4623               127.61
1             TorchScript        0.4623               131.23
2                    ONNX        0.4623                69.34
3                OpenVINO        0.4623                66.52
4                TensorRT           NaN                  NaN
5                  CoreML           NaN                  NaN
6   TensorFlow SavedModel        0.4623               123.79
7     TensorFlow GraphDef        0.4623               121.57
8         TensorFlow Lite        0.4623               316.61
9     TensorFlow Edge TPU           NaN                  NaN
10          TensorFlow.js           NaN                  NaN
학습된 YOLOv5 모델 내보내기#
이 명령은 사전 학습된 YOLOv5s 모델을 TorchScript 및 ONNX 형식으로 내보냅니다. yolov5s.pt은 사용 가능한 모델 중 두 번째로 작은 'small' 모델입니다. 그 밖의 옵션으로는 yolov5n.pt, yolov5m.pt, yolov5l.pt, yolov5x.pt와 해당 P6 버전인 yolov5s6.pt 또는 사용자가 직접 학습한 체크포인트인 runs/exp/weights/best.pt이 있습니다. 사용 가능한 모든 모델에 대한 자세한 내용은 README 표를 참조하십시오.
python export.py --weights yolov5s.pt --include torchscript onnx더 작은 파일 크기로 모델을 내보내려면 --half을 추가하여 FP16 반 정밀도로 내보냅니다.
출력:
export: data=data/coco128.yaml, weights=['yolov5s.pt'], imgsz=[640, 640], batch_size=1, device=cpu, half=False, inplace=False, train=False, keras=False, optimize=False, int8=False, dynamic=False, simplify=False, opset=12, verbose=False, workspace=4, nms=False, agnostic_nms=False, topk_per_class=100, topk_all=100, iou_thres=0.45, conf_thres=0.25, include=['torchscript', 'onnx']
YOLOv5 🚀 v6.2-104-ge3e5122 Python-3.8.0 torch-1.12.1+cu113 CPU

Downloading https://github.com/ultralytics/yolov5/releases/download/v6.2/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 274MB/s]

Fusing layers...
YOLOv5s summary: 213 layers, 7225885 parameters, 0 gradients

PyTorch: starting from yolov5s.pt with output shape (1, 25200, 85) (14.1 MB)

TorchScript: starting export with torch 1.12.1+cu113...
TorchScript: export success ✅ 1.7s, saved as yolov5s.torchscript (28.1 MB)

ONNX: starting export with onnx 1.12.0...
ONNX: export success ✅ 2.3s, saved as yolov5s.onnx (28.0 MB)

Export complete (5.5s)
Results saved to /content/yolov5
Detect:          python detect.py --weights yolov5s.onnx
Validate:        python val.py --weights yolov5s.onnx
PyTorch Hub:     model = torch.hub.load('ultralytics/yolov5', 'custom', 'yolov5s.onnx')
Visualize:       https://netron.app/
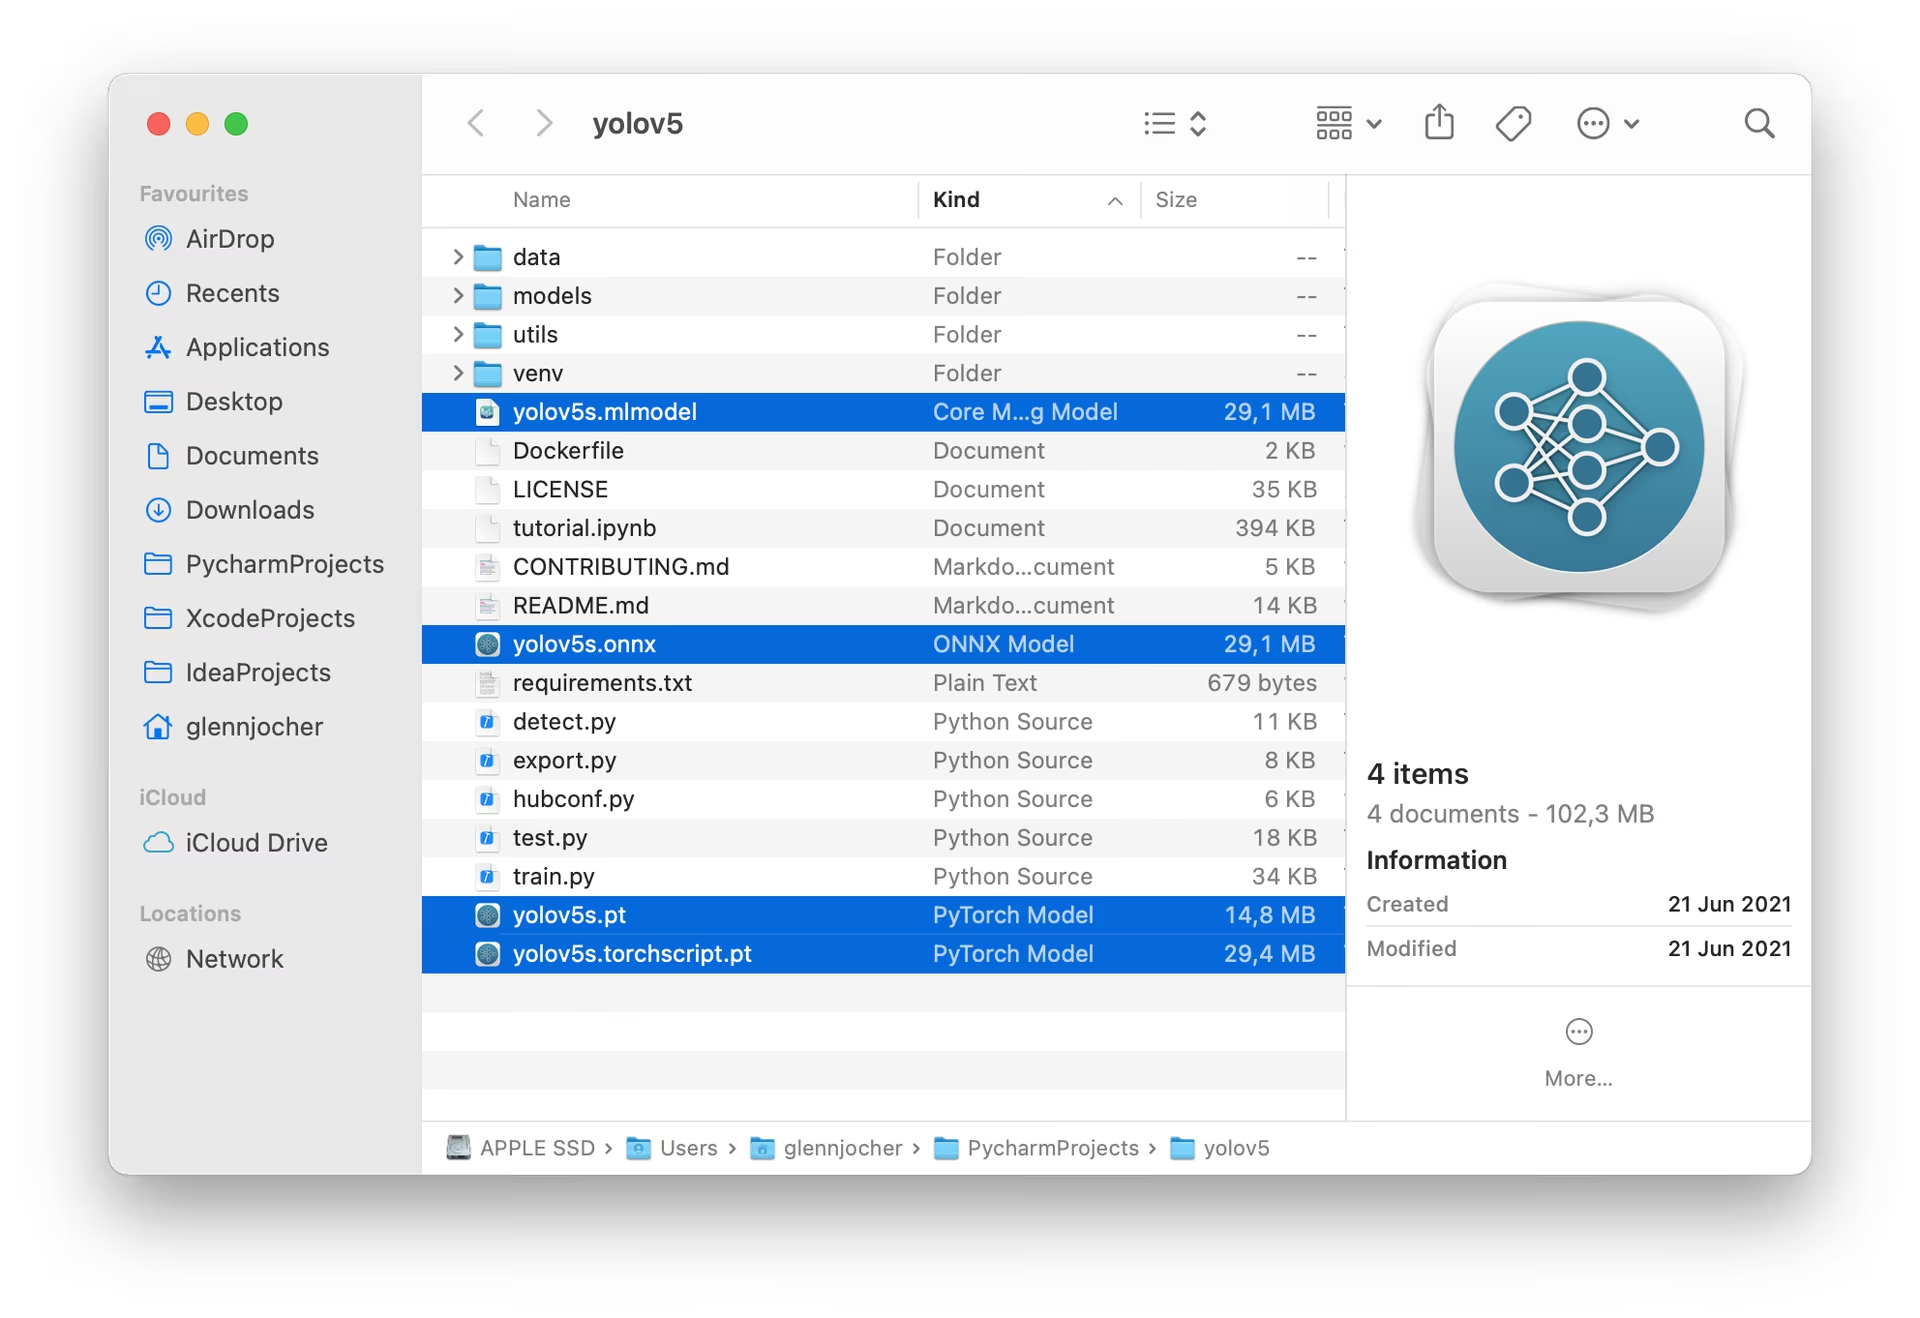
내보낸 3개의 모델은 원본 PyTorch 모델과 같은 위치에 저장됩니다:
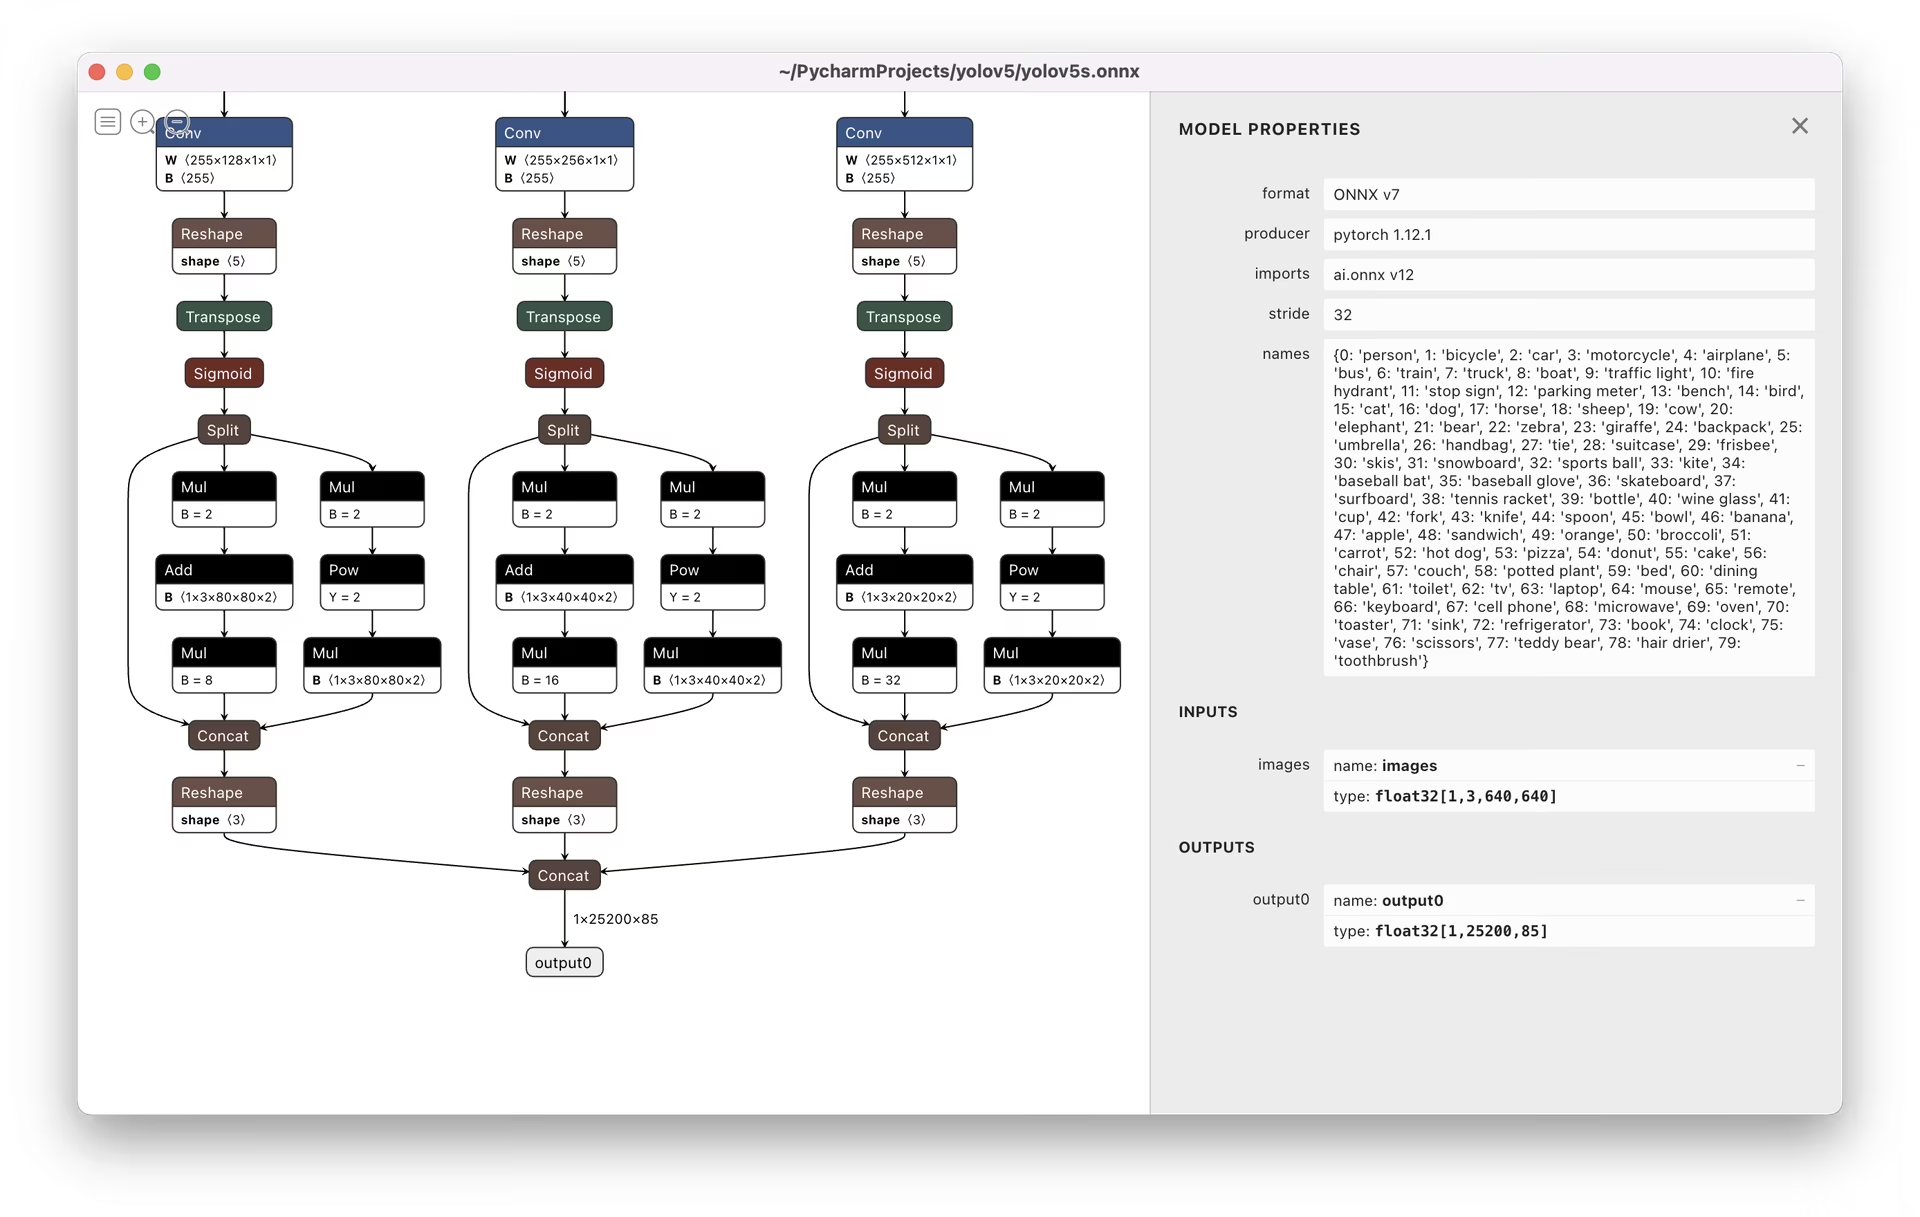
내보낸 모델을 시각화하려면 Netron Viewer를 사용하는 것이 좋습니다:
내보낸 모델 사용 예제#
detect.py은 내보낸 모델에서 추론을 실행합니다:
python detect.py --weights yolov5s.pt             # PyTorch
python detect.py --weights yolov5s.torchscript    # TorchScript
python detect.py --weights yolov5s.onnx           # ONNX Runtime or OpenCV DNN with dnn=True
python detect.py --weights yolov5s_openvino_model # OpenVINO
python detect.py --weights yolov5s.engine         # TensorRT
python detect.py --weights yolov5s.mlpackage      # CoreML (macOS only)
python detect.py --weights yolov5s_saved_model    # TensorFlow SavedModel
python detect.py --weights yolov5s.pb             # TensorFlow GraphDef
python detect.py --weights yolov5s.tflite         # TensorFlow Lite
python detect.py --weights yolov5s_edgetpu.tflite # TensorFlow Edge TPU
python detect.py --weights yolov5s_paddle_model # PaddlePaddleval.py은 내보낸 모델에서 검증을 실행합니다:
python val.py --weights yolov5s.pt             # PyTorch
python val.py --weights yolov5s.torchscript    # TorchScript
python val.py --weights yolov5s.onnx           # ONNX Runtime or OpenCV DNN with dnn=True
python val.py --weights yolov5s_openvino_model # OpenVINO
python val.py --weights yolov5s.engine         # TensorRT
python val.py --weights yolov5s.mlpackage      # CoreML (macOS only)
python val.py --weights yolov5s_saved_model    # TensorFlow SavedModel
python val.py --weights yolov5s.pb             # TensorFlow GraphDef
python val.py --weights yolov5s.tflite         # TensorFlow Lite
python val.py --weights yolov5s_edgetpu.tflite # TensorFlow Edge TPU
python val.py --weights yolov5s_paddle_model   # PaddlePaddle
내보낸 YOLOv5 모델에서 PyTorch Hub를 사용합니다:
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.pt")
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.torchscript")  # TorchScript
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.onnx")  # ONNX Runtime
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_openvino_model")  # OpenVINO
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.engine")  # TensorRT
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.mlpackage")  # CoreML (macOS only)
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_saved_model")  # TensorFlow SavedModel
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.pb")  # TensorFlow GraphDef
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.tflite")  # TensorFlow Lite
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_edgetpu.tflite")  # TensorFlow Edge TPU
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_paddle_model")  # PaddlePaddle

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # or file, Path, PIL, OpenCV, numpy, list

# Inference
results = model(img)

# Results
results.print()  # or .show(), .save(), .crop(), .pandas(), etc.
OpenCV DNN 추론#
ONNX 모델을 사용한 OpenCV 추론:
python export.py --weights yolov5s.pt --include onnx

python detect.py --weights yolov5s.onnx --dnn # detect
python val.py --weights yolov5s.onnx --dnn    # validate
C++ 추론#
내보낸 ONNX 모델을 사용한 YOLOv5 OpenCV DNN C++ 추론 예제:
- https://github.com/Hexmagic/ONNX-yolov5/blob/master/src/test.cpp
- https://github.com/doleron/yolov5-opencv-cpp-python
YOLOv5 OpenVINO C++ 추론 예제:
- https://github.com/dacquaviva/yolov5-openvino-cpp-python
- https://github.com/UNeedCryDear/yolov5-seg-opencv-onnxruntime-cpp
TensorFlow.js 웹 브라우저 추론#
지원 환경#
Ultralytics는 프로젝트를 바로 시작할 수 있도록 CUDA, CUDNN, Python, PyTorch와 같은 필수 종속성이 사전 설치된 다양한 즉시 사용 가능한 환경을 제공합니다.
- 무료 GPU 노트북:


- Google Cloud: GCP 빠른 시작 가이드
- Amazon: AWS 빠른 시작 가이드
- Azure: AzureML 빠른 시작 가이드
- Docker: Docker 빠른 시작 가이드
프로젝트 상태#

이 배지는 모든 YOLOv5 GitHub Actions 지속적 통합 (CI) 테스트가 성공적으로 통과했음을 나타냅니다. 이러한 CI 테스트는 학습, 검증, 추론, 내보내기, 벤치마크 등 여러 주요 측면에서 YOLOv5의 기능과 성능을 엄격하게 점검합니다. 또한 macOS, Windows, Ubuntu에서 일관되고 안정적으로 작동하는지 확인하며, 24시간마다 그리고 새 커밋이 생성될 때마다 테스트를 수행합니다.
FAQ#
CPU 배포의 경우 PyTorch보다 최대 3배 빠르게 실행되는 ONNX 또는 OpenVINO를 사용하고, NVIDIA GPU의 경우 최대 5배 빠르게 실행되는 TensorRT를 사용하십시오. CoreML은 Apple 기기를 타겟팅하며, TensorFlow Lite 또는 Edge TPU는 Android 및 Coral 하드웨어를 타겟팅합니다.
--half을(를) 추가하십시오. 대부분의 형식에서는 절반 정밀도(half precision)에 GPU가 필요하므로--device 0도 함께 전달하십시오. CoreML은 예외이며 CPU에서 FP16 내보내기를 수행할 수 있습니다.예.
--dynamic을(를) 추가하십시오. ONNX 내보내기는 동적 배치, 높이, 너비 축을 얻고 CPU에서 트레이스되므로--device 0을 생략하십시오. TensorRT 내보내기는 이미지 크기를 고정하고 배치 차원만 변경하므로 여전히--device 0가 필요하며,--batch-size은 엔진이 허용하는 가장 큰 배치를 설정합니다.내보낸 파일을
detect.py --weights,val.py --weights또는torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.onnx")(으)로 전달하십시오. YOLOv5는 파일 확장자에서 올바른 백엔드를 선택합니다.