YOLOv5 하이퍼파라미터 진화#
📚 이 가이드에서는 YOLOv5의 하이퍼파라미터 진화를 설명합니다 🚀. 하이퍼파라미터 진화는 최적화를 위해 유전 알고리즘(GA)을 사용하는 하이퍼파라미터 최적화 방법입니다.
머신러닝의 하이퍼파라미터는 학습의 여러 측면을 제어하며, 최적의 값을 찾기는 쉽지 않습니다. 그리드 탐색과 같은 기존 방법은 다음과 같은 이유로 빠르게 실행 불가능한 수준이 될 수 있습니다:
- 탐색 공간의 차원이 높음
- 차원 간 상관관계를 알 수 없음
- 각 지점의 적합도를 평가하는 데 드는 비용이 큼
따라서 유전 알고리즘은 하이퍼파라미터 탐색에 적합한 방법입니다.
시작하기 전에#
리포지토리를 복제하고 Python>=3.8.0 환경에서 requirements.txt를 설치합니다. 여기에는 PyTorch>=1.8이 포함됩니다. 모델과 데이터셋은 최신 YOLOv5 릴리스에서 자동으로 다운로드됩니다.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. 하이퍼파라미터 초기화#
YOLOv5에는 다양한 학습 설정에 사용되는 하이퍼파라미터가 약 30개 있습니다. 이 값은 /data/hyps 디렉터리의 *.yaml 파일에 정의되어 있습니다. 초기 추정값이 좋을수록 최종 결과도 좋아지므로 진화를 시작하기 전에 값을 적절하게 초기화하는 것이 중요합니다. 확신이 없다면 기본값을 사용하세요. 기본값은 YOLOv5의 COCO 처음부터 학습에 최적화되어 있습니다.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. 적합도 정의#
적합도는 최대화하려는 값입니다. YOLOv5에서는 기본 적합도 함수를 여러 지표의 가중 합으로 정의합니다. mAP@0.5의 가중치는 10%, mAP@0.5:0.95의 가중치는 나머지 90%이며, 정밀도(P)와 재현율(R)은 포함되지 않습니다. 필요에 따라 값을 조정하거나 utils/metrics.py의 기본 적합도 정의를 사용할 수 있습니다(권장). 이 적합도는 hyp_evolve.yaml에 저장할 결과를 결정합니다. 유전 알고리즘 자체는 mAP@0.5만으로 부모와 엘리트를 순위화하므로 이 가중치를 변경해도 부모 선택은 달라지지 않습니다.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # [P, R, mAP@0.5, mAP@0.5:0.95]의 가중치
    return (x[:, :4] * w).sum(1)
3. 진화#
진화는 개선하고자 하는 기준 시나리오를 바탕으로 수행됩니다. 이 예시의 기준 시나리오는 사전 학습된 YOLOv5s를 사용해 COCO128을 10개 에포크 동안 파인튜닝하는 것입니다. 기준 시나리오의 학습 명령은 다음과 같습니다:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache초기값은 섹션 1.에 정의된 값에서 시작하고, 섹션 2.에 정의된 적합도를 최대화하여 이 시나리오에 특화된 하이퍼파라미터를 진화시키려면 다음을 추가합니다: --evolve
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
기본 진화 설정은 300세대 동안 실행되며, 각 세대에서는 모집단의 개체 50개 각각에 대해 기준 시나리오를 한 번씩 학습합니다. --evolve 인수(예: python train.py --evolve 1000)를 사용해 세대 수를 수정할 수 있습니다.
주요 유전 연산자는 교차와 돌연변이입니다. 각 세대에서는 모든 개체를 학습하고 mAP@0.5으로 점수를 매긴 뒤, 토너먼트 선택으로 부모를 선택하고 적합도가 가장 높은 엘리트를 부모 풀에 추가합니다. 이후 진화가 진행됨에 따라 비율이 조정되는 교차와 돌연변이를 통해 다음 모집단을 구성합니다. 결과는 runs/evolve/exp/evolve.csv에 기록되며, 적합도가 가장 높은 자손은 매 세대 runs/evolve/exp/hyp_evolve.yaml로 저장됩니다:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
최상의 결과를 얻으려면 최소 300세대의 진화를 권장합니다. 기준 시나리오를 수천 번 학습하므로 진화는 일반적으로 비용과 시간이 많이 소요되며, 수백 또는 수천 GPU 시간이 필요할 수 있습니다.
진화가 완료되면 저장된 파일을 학습에 지정하여 발견한 설정을 재사용할 수 있습니다. 예: python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. 시각화#
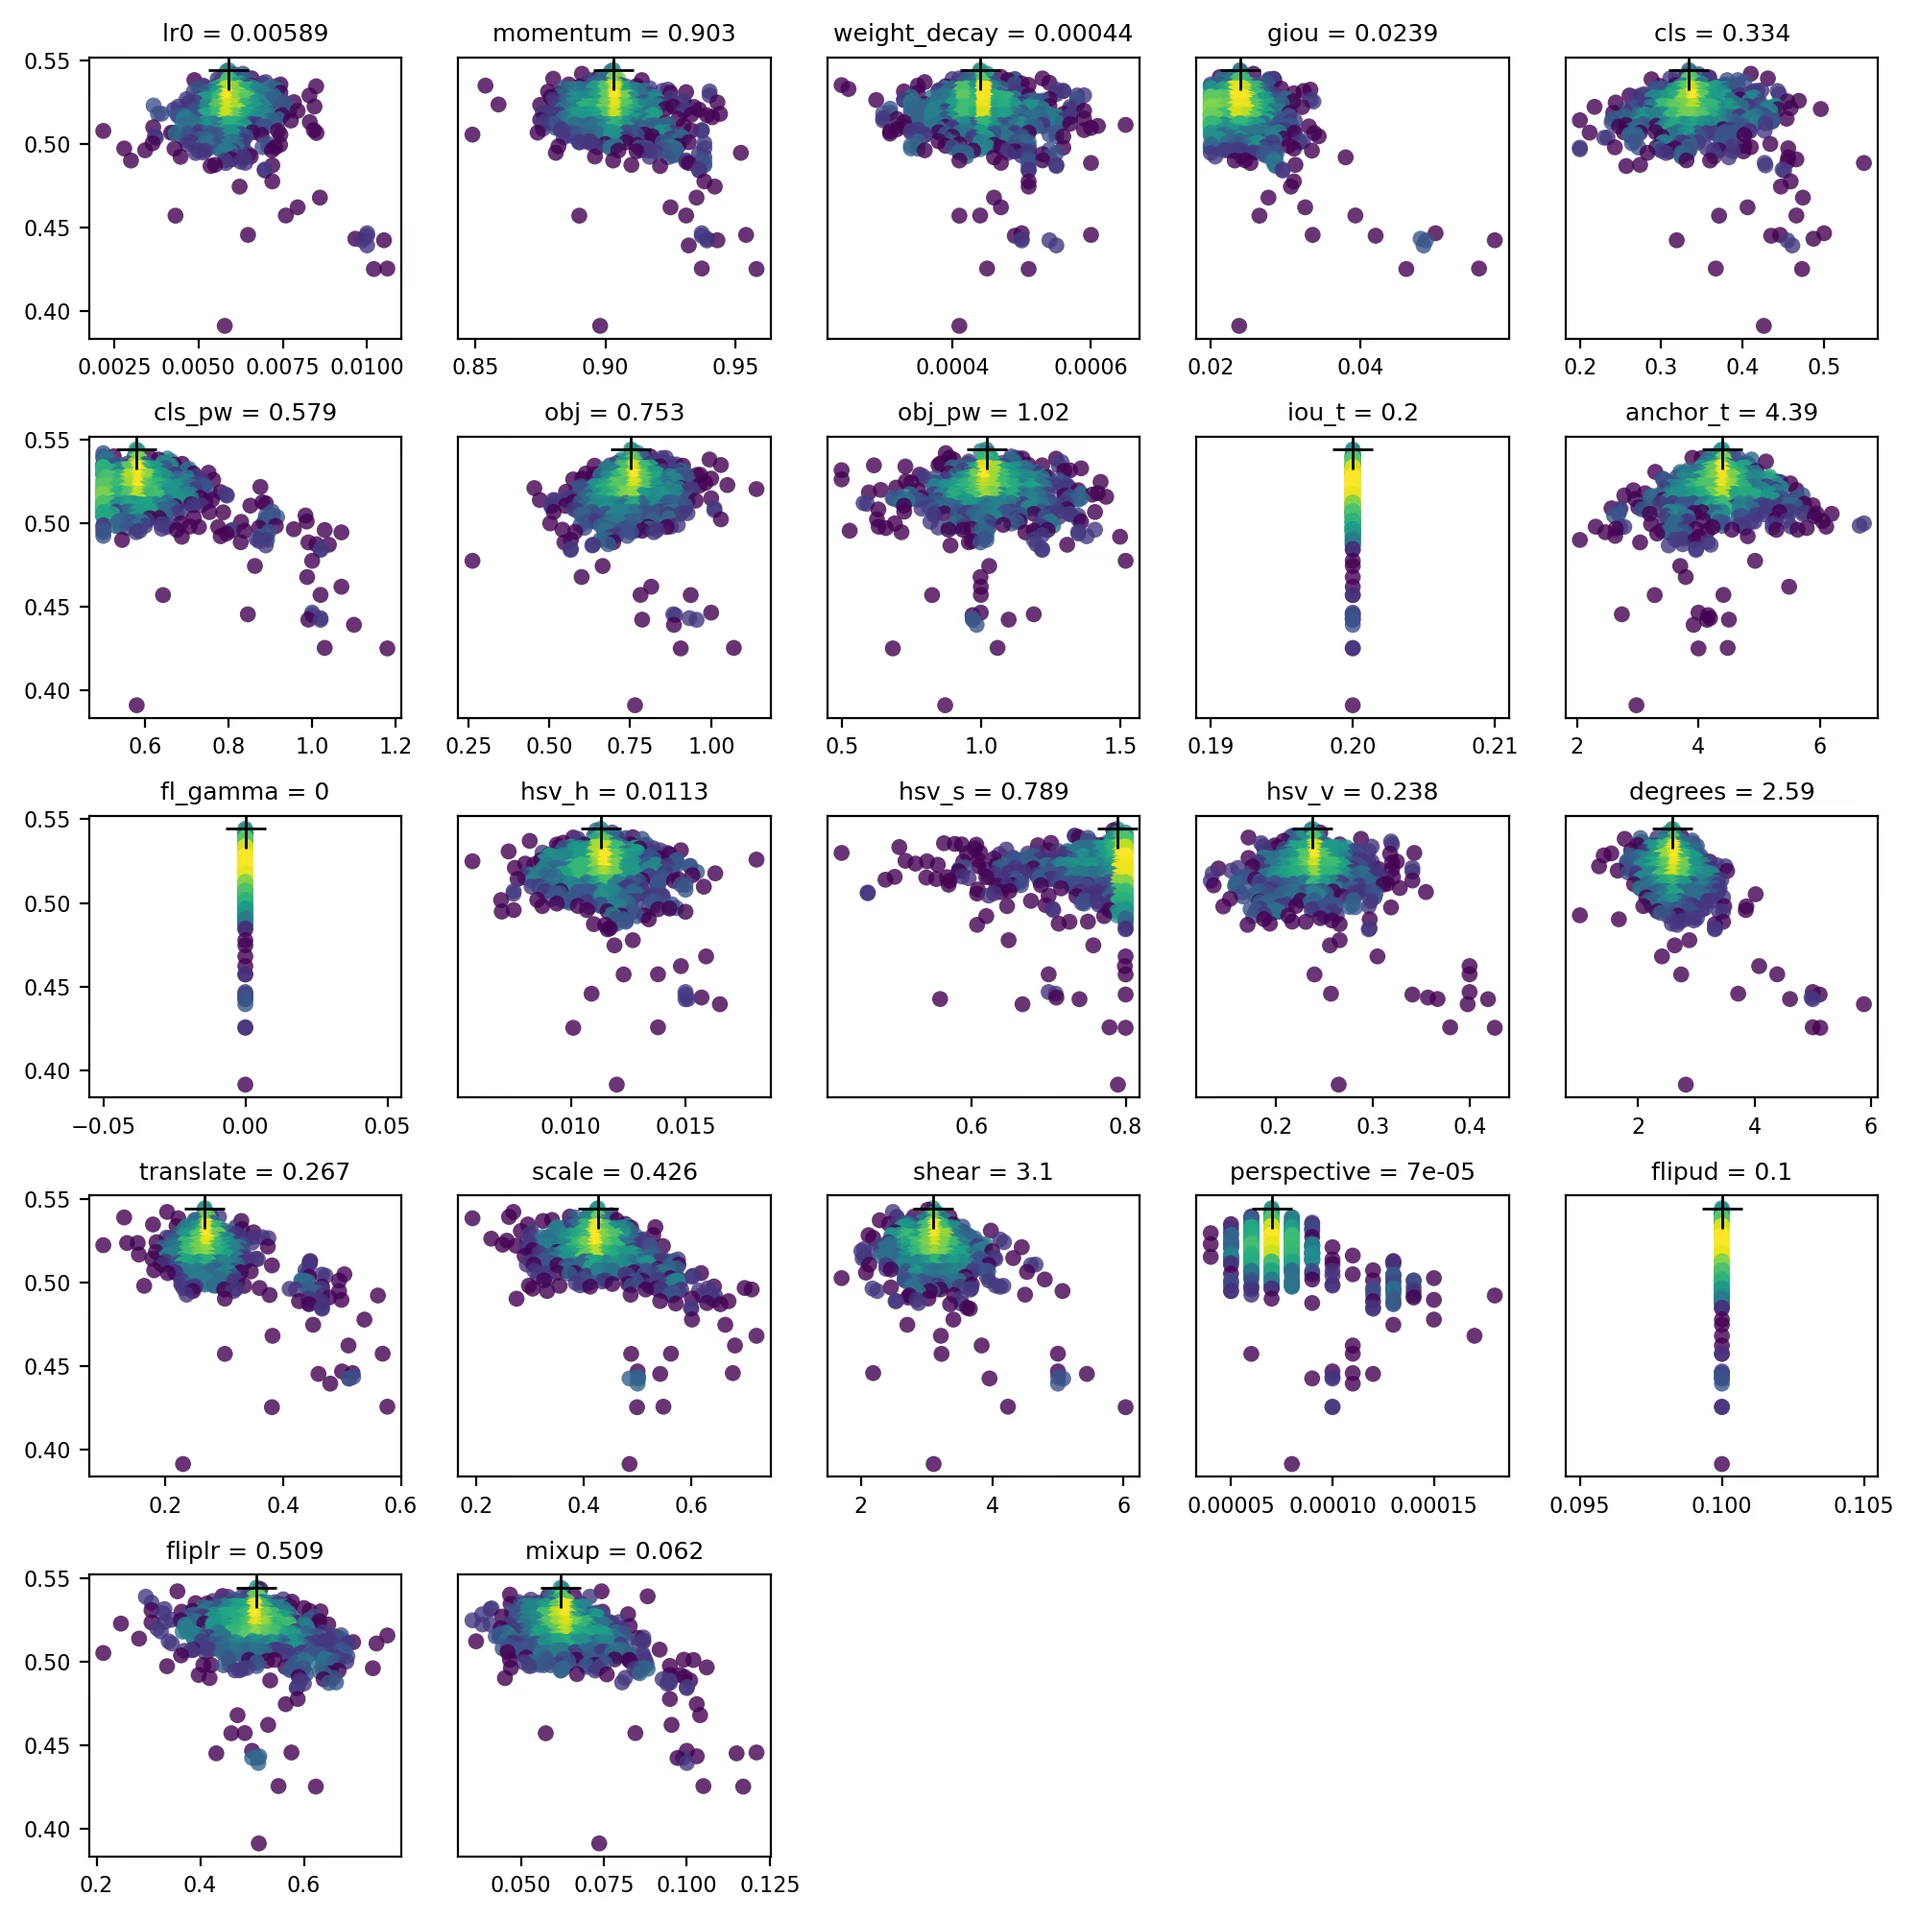
진화가 완료되면 evolve.csv은 utils.plots.plot_evolve()에 의해 evolve.png로 시각화됩니다. 각 하이퍼파라미터별 서브플롯에는 적합도(y축)와 하이퍼파라미터 값(x축)이 표시됩니다. 노란색은 농도가 더 높음을 나타냅니다. 세로 방향 분포는 매개변수가 비활성화되어 돌연변이가 일어나지 않음을 의미합니다. train.py의 meta 딕셔너리에서 사용자가 이 설정을 선택할 수 있으며, 매개변수를 고정해 진화하지 않도록 하는 데 유용합니다.
지원 환경#
Ultralytics는 프로젝트를 빠르게 시작할 수 있도록 CUDA, CUDNN, Python, PyTorch 등 필수 종속성이 사전 설치된 다양한 즉시 사용 가능한 환경을 제공합니다.
- 무료 GPU 노트북:


- Google Cloud: GCP 빠른 시작 가이드
- Amazon: AWS 빠른 시작 가이드
- Azure: AzureML 빠른 시작 가이드
- Docker: Docker 빠른 시작 가이드

프로젝트 상태#

이 배지는 모든 YOLOv5 GitHub Actions 지속적 통합(CI) 테스트가 성공적으로 통과했음을 나타냅니다. 이 CI 테스트는 학습, 검증, 추론, 내보내기, 벤치마크 등 여러 주요 측면에서 YOLOv5의 기능과 성능을 철저히 확인합니다. 테스트는 24시간마다 그리고 새 커밋이 있을 때마다 실행되어 macOS, Windows, Ubuntu에서 일관되고 안정적으로 작동하는지 확인합니다.
자주 묻는 질문#
각 세대에서는 모집단의 개체 50개 각각에 대해 기준 시나리오를 한 번씩 학습하므로, COCO128을 10 에포크 동안 실행하는 경우 300세대의 비용은 해당 실행을 한 번 수행하는 비용의 약 15,000배입니다. 기준 시나리오는 짧고 대표성 있게 구성하세요. 위의 멀티 GPU 루프는 검색 하나를 공유하는 대신 각 GPU에서 독립적인 검색을 시작하므로, 고정된 예산으로 작업하는 경우 프로세스별
--evolve값을 낮추세요.예.
--evolve의 기본값은 300세대입니다. 더 많이 실행하려면--evolve 1000과 같은 숫자를 전달하세요.train.py의meta딕셔너리에서 해당 항목의 첫 번째 값을False로 설정합니다. 제외된 매개변수는 초기값을 유지하며evolve.png에서 세로선으로 표시됩니다.저장된 파일을 일반 학습 실행에 전달하세요:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.