YOLOv5의 모델 가지치기와 희소성
이 가이드에서는 성능을 유지하면서 더 효율적인 네트워크를 만들기 위해 YOLOv5 모델에 프루닝을 적용하는 방법을 설명합니다.
모델 가지치기란 무엇입니까?#
모델 프루닝은 덜 중요한 파라미터(가중치 및 연결)를 제거해 신경망의 크기와 복잡도를 줄이는 기법입니다. 이 과정을 통해 효율성이 더 높은 모델을 만들 수 있으며, 여러 이점이 있습니다:
- 리소스가 제한된 디바이스에 더 쉽게 배포할 수 있도록 모델 크기를 줄입니다.
- 정확도에 미치는 영향을 최소화하면서 추론 속도를 높입니다.
- 메모리 사용량과 에너지 소비를 줄입니다.
- 실시간 애플리케이션의 전반적인 효율성을 높입니다.
프루닝은 모델 성능에 미치는 영향이 미미한 파라미터를 식별하고 제거하여 비슷한 정확도를 유지하면서 더 경량화된 모델을 만드는 방식으로 작동합니다.
시작하기 전에#
저장소를 클론하고 PyTorch>=1.8을 포함한 Python>=3.8.0 환경에 requirements.txt를 설치하세요. 모델과 데이터셋은 최신 YOLOv5 릴리스에서 자동으로 다운로드됩니다.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
기준 성능 테스트#
프루닝을 적용하기 전에 비교 기준이 될 성능 기준선을 설정하세요. 이 명령은 이미지 크기 640픽셀로 COCO val2017에서 YOLOv5x를 테스트합니다. yolov5x.pt은 가장 크고 정확한 P5 모델입니다. 그 밖의 옵션으로는 더 작은 사전 훈련 체크포인트 yolov5n.pt, yolov5s.pt, yolov5m.pt, yolov5l.pt 또는 사용자 지정 데이터셋 훈련에 사용한 자체 체크포인트(예: runs/train/exp/weights/best.pt)가 있습니다.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --half출력:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
YOLOv5x에 가지치기 적용(희소성 30%)#
utils/torch_utils.py에 정의된 prune() 함수를 사용하여 모델에 가지치기를 적용할 수 있습니다. 가지치기된 모델을 테스트하려면 val.py를 업데이트하여 YOLOv5x의 희소성을 0.3(가중치의 30%를 0으로 설정)으로 가지치기합니다:
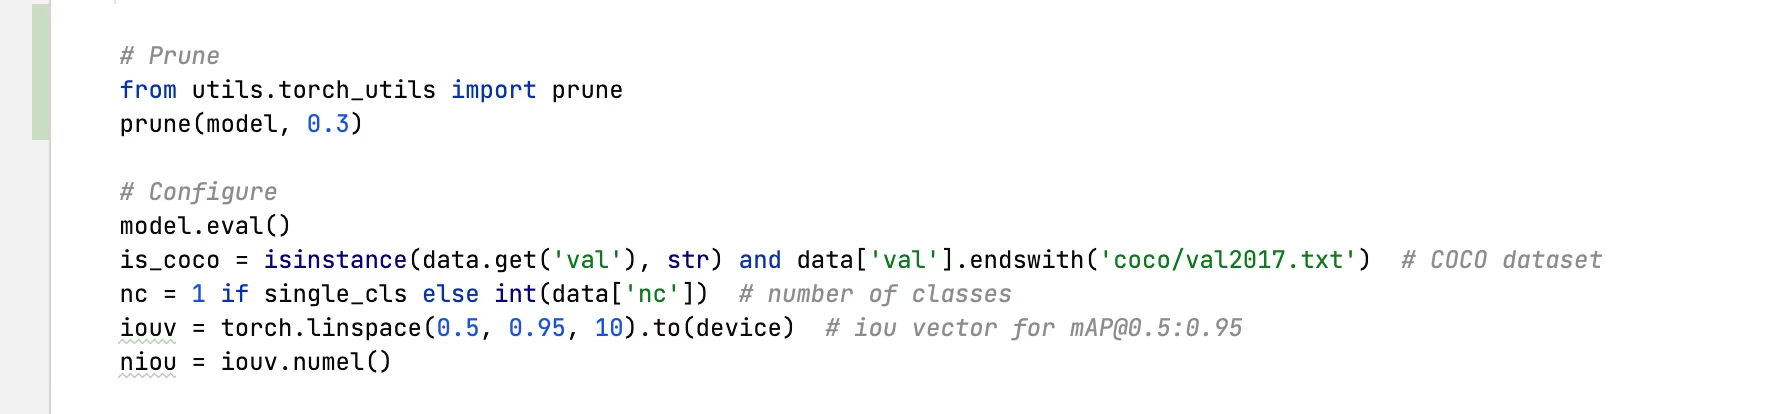
가지치기 30% 적용 결과:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
결과 분석#
결과에서 다음 사항을 확인할 수 있습니다:
- 희소성 30% 달성:
nn.Conv2d레이어에 있는 모델 가중치 매개변수의 30%가 0이 되었습니다. - 추론 시간 유지: 가지치기에도 불구하고 처리 속도는 사실상 동일합니다.
- 성능 영향 최소화: mAP가 0.507에서 0.489로 소폭 하락했습니다(감소 폭 3.6%).
- 모델 크기 유지: 0으로 설정된 가중치도 밀집 형태로 저장되므로 희소성을 고려하는 형식이나 압축을 사용해야 파일 크기가 줄어듭니다.
이는 정확도에 미치는 영향이 미미한 상태에서 합성곱 가중치의 30%를 제거할 수 있음을 보여줍니다. 이러한 희소성을 추론 속도 향상이나 파일 크기 축소로 이어지게 하려면 희소성 인식 런타임, 구조적 프루닝 또는 압축이 필요합니다.
가지치기된 모델 미세 조정#
최상의 결과를 얻으려면 정확도를 회복하도록 가지치기 후 모델을 미세 조정해야 합니다. 방법은 다음과 같습니다:
- 원하는 희소성 수준으로 가지치기를 적용합니다.
- 프루닝된 모델을 더 낮은 학습률로 몇 에포크 동안 훈련합니다.
- 미세 조정한 가지치기 모델을 기준 모델과 비교 평가합니다.
이 과정을 통해 남은 매개변수가 제거된 연결을 보완하도록 조정되므로, 원래 정확도의 대부분 또는 전부를 회복할 수 있습니다.
지원 환경#
Ultralytics는 프로젝트를 시작할 수 있도록 CUDA, cuDNN, Python, PyTorch와 같은 필수 종속성이 사전 설치된 다양한 즉시 사용 가능한 환경을 제공합니다.
- 무료 GPU 노트북:


- Google Cloud: GCP 빠른 시작 가이드
- Amazon: AWS 빠른 시작 가이드
- Azure: AzureML 빠른 시작 가이드
- Docker: Docker 빠른 시작 가이드

프로젝트 상태#

이 배지는 모든 YOLOv5 GitHub Actions 지속적 통합(CI) 테스트가 성공적으로 통과했음을 나타냅니다. 이 CI 테스트는 학습, 검증, 추론, 내보내기, 벤치마크 등 여러 주요 측면에서 YOLOv5의 기능과 성능을 철저히 확인합니다. 테스트는 24시간마다 그리고 새 커밋이 있을 때마다 실행되어 macOS, Windows, Ubuntu에서 일관되고 안정적으로 작동하는지 확인합니다.
자주 묻는 질문#
비구조적 가지치기는 가중치를 0으로 설정하지만 텐서 형상은 변경하지 않으므로 밀집 PyTorch 커널은 동일한 양의 연산을 수행합니다. 속도를 높이려면 DeepSparse와 같이 희소성을 고려하는 런타임을 사용하거나 채널 전체를 제거하는 구조적 가지치기를 적용해야 합니다.
검증 또는 내보내기 전에
utils/torch_utils.py의 헬퍼를 호출하세요:from utils.torch_utils import prune prune(model, amount=0.3) # nn.Conv2d 가중치에 전역 희소성 30% 적용0.3에서 시작해 mAP를 측정하세요. YOLOv5x는 미세 조정 없이 희소성 30%를 적용했을 때 mAP가 약 3.6% 하락했습니다. 희소성 수준을 더 높이면 정확도를 회복하기 위해 낮은 학습률로 몇 에폭 동안 재학습해야 하는 경우가 많습니다.
예. 0으로 설정된 가중치도 다른 가중치와 동일하게 저장되므로
export.py은 변경 없이 작동합니다. 대상 형식이나 런타임이 희소 텐서를 압축하는 경우에만 파일 크기가 줄어듭니다.


댓글
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.