ClearML 통합#

ClearML 소개#
ClearML은 머신러닝 워크플로를 간소화하고 엔지니어링 시간을 절약하도록 설계된 오픈 소스 MLOps 플랫폼입니다.
- 🔨 실험 관리자에서 모든 YOLOv5 학습 실행을 추적합니다.
- 🔧 통합된 ClearML 데이터 버전 관리 도구를 사용하여 사용자 지정 학습 데이터의 버전을 관리하고 액세스합니다.
- 🔦 ClearML Agent를 사용하여 YOLOv5 실행을 원격으로 학습하고 모니터링합니다.
- 🔬 ClearML 하이퍼파라미터 최적화로 최적의 mAP를 찾습니다.
- 🔭 ClearML Serving을 사용하면 몇 가지 명령만으로 학습된 YOLOv5 모델을 API로 전환할 수 있습니다.
필요한 만큼 도구를 사용하세요. 실험 관리자만 사용하는 것으로 시작하거나 모든 도구를 연결하여 전체 파이프라인을 구축할 수 있습니다.
🦾 설정하기#
ClearML은 실험과 데이터를 추적하기 위해 서버와 통신해야 합니다. 다음 두 가지 옵션이 있습니다:
- 무료 ClearML 호스팅 서비스에 가입하거나,
- 직접 ClearML 서버를 배포하세요. 오픈 소스이므로 민감한 데이터를 다루는 경우에도 사용할 수 있습니다.
그런 다음 clearml Python 패키지를 설치하고 SDK를 서버에 연결하세요:
pip install clearml설정 → 워크스페이스 → 새 자격 증명 만들기(ClearML UI 오른쪽 상단)에서 자격 증명을 생성한 다음 다음 명령을 실행하세요:
clearml-init안내에 따라 진행하면 설정이 완료됩니다.
🚀 ClearML로 YOLOv5 학습하기#
실험 추적을 활성화하려면 아직 설치하지 않은 경우 ClearML pip 패키지를 설치하세요:
pip install clearml이렇게 하면 YOLOv5 학습 스크립트와 통합됩니다. 이제부터 모든 학습 실행이 ClearML 실험 관리자에 캡처되어 저장됩니다.
프로젝트 및 작업 이름을 사용자 지정하려면 --project과 --name을 train.py에 전달하세요. 기본값은 YOLOv5과 Training입니다. ClearML은 /를 하위 프로젝트 구분자로 사용하므로 사용자 지정 프로젝트 이름에 /을 사용하지 마세요.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cache또는 사용자 지정 이름을 사용합니다:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cache각 실행에서 다음 항목을 캡처합니다:
- 소스 코드 및 커밋되지 않은 변경 사항
- 설치된 패키지
- 하이퍼파라미터
- 모델 체크포인트(매
n에포크마다 저장하려면--save-period n을 사용하세요) - 콘솔 출력
- 스칼라 값(mAP_0.5, mAP_0.5:0.95, 정밀도, 재현율, 손실, 학습률)
- 머신 세부 정보, 실행 시간 및 생성 날짜
- 레이블 상관도와 혼동 행렬 등의 생성된 플롯
- 에포크별 바운딩 박스가 포함된 이미지
- 에포크별 모자이크 시각화
- 에포크별 검증 이미지
모든 항목이 ClearML UI에 표시되므로 한곳에서 학습을 모니터링할 수 있습니다. 사용자 지정 열(예: mAP_0.5)을 추가하여 성능이 가장 좋은 모델을 기준으로 정렬하거나 여러 실험을 선택해 나란히 비교할 수 있습니다.
하이퍼파라미터 최적화와 원격 실행에 대해 계속 알아보세요.
🔗 데이터셋 버전 관리#
데이터를 코드와 별도로 버전 관리하면 최신 버전을 쉽게 가져올 수 있고 완전한 재현성을 보장할 수 있습니다. 이 저장소는 데이터셋 버전 ID를 받아 데이터가 없는 경우 자동으로 가져오며, 사용한 데이터와 실험을 항상 확인할 수 있도록 해당 ID를 작업 매개변수로 기록합니다.
데이터셋 준비하기#
YOLOv5 저장소는 YAML 구성 파일을 통해 다양한 데이터셋을 지원합니다. 기본적으로 데이터셋은 저장소 루트를 기준으로 ../datasets 폴더에 다운로드됩니다. coco128을 다운로드한 후 폴더 구조는 다음과 같습니다:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
이 구조를 유지한다면 어떤 데이터셋이든 사용할 수 있습니다.
그다음 데이터셋의 YAML 파일을 데이터셋 루트 폴더에 복사하세요. ClearML은 이 파일을 읽어 데이터셋을 올바르게 사용합니다. 예시 레이아웃을 따라 직접 YAML 파일을 작성할 수도 있으며, 이때 path, train, test, val, nc, names를 정의해야 합니다.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
데이터셋 업로드하기#
데이터셋을 버전 관리되는 ClearML 데이터셋으로 등록하려면 데이터셋의 루트 폴더로 이동하여 다음 명령을 실행하세요:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync은 다음 명령 시퀀스를 간략히 나타낸 것입니다. 아래 명령을 직접 실행할 수도 있습니다:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
ClearML 데이터셋으로 학습하기#
데이터셋을 등록한 후 ID를 지정하여 학습을 실행하세요:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 하이퍼파라미터 최적화#
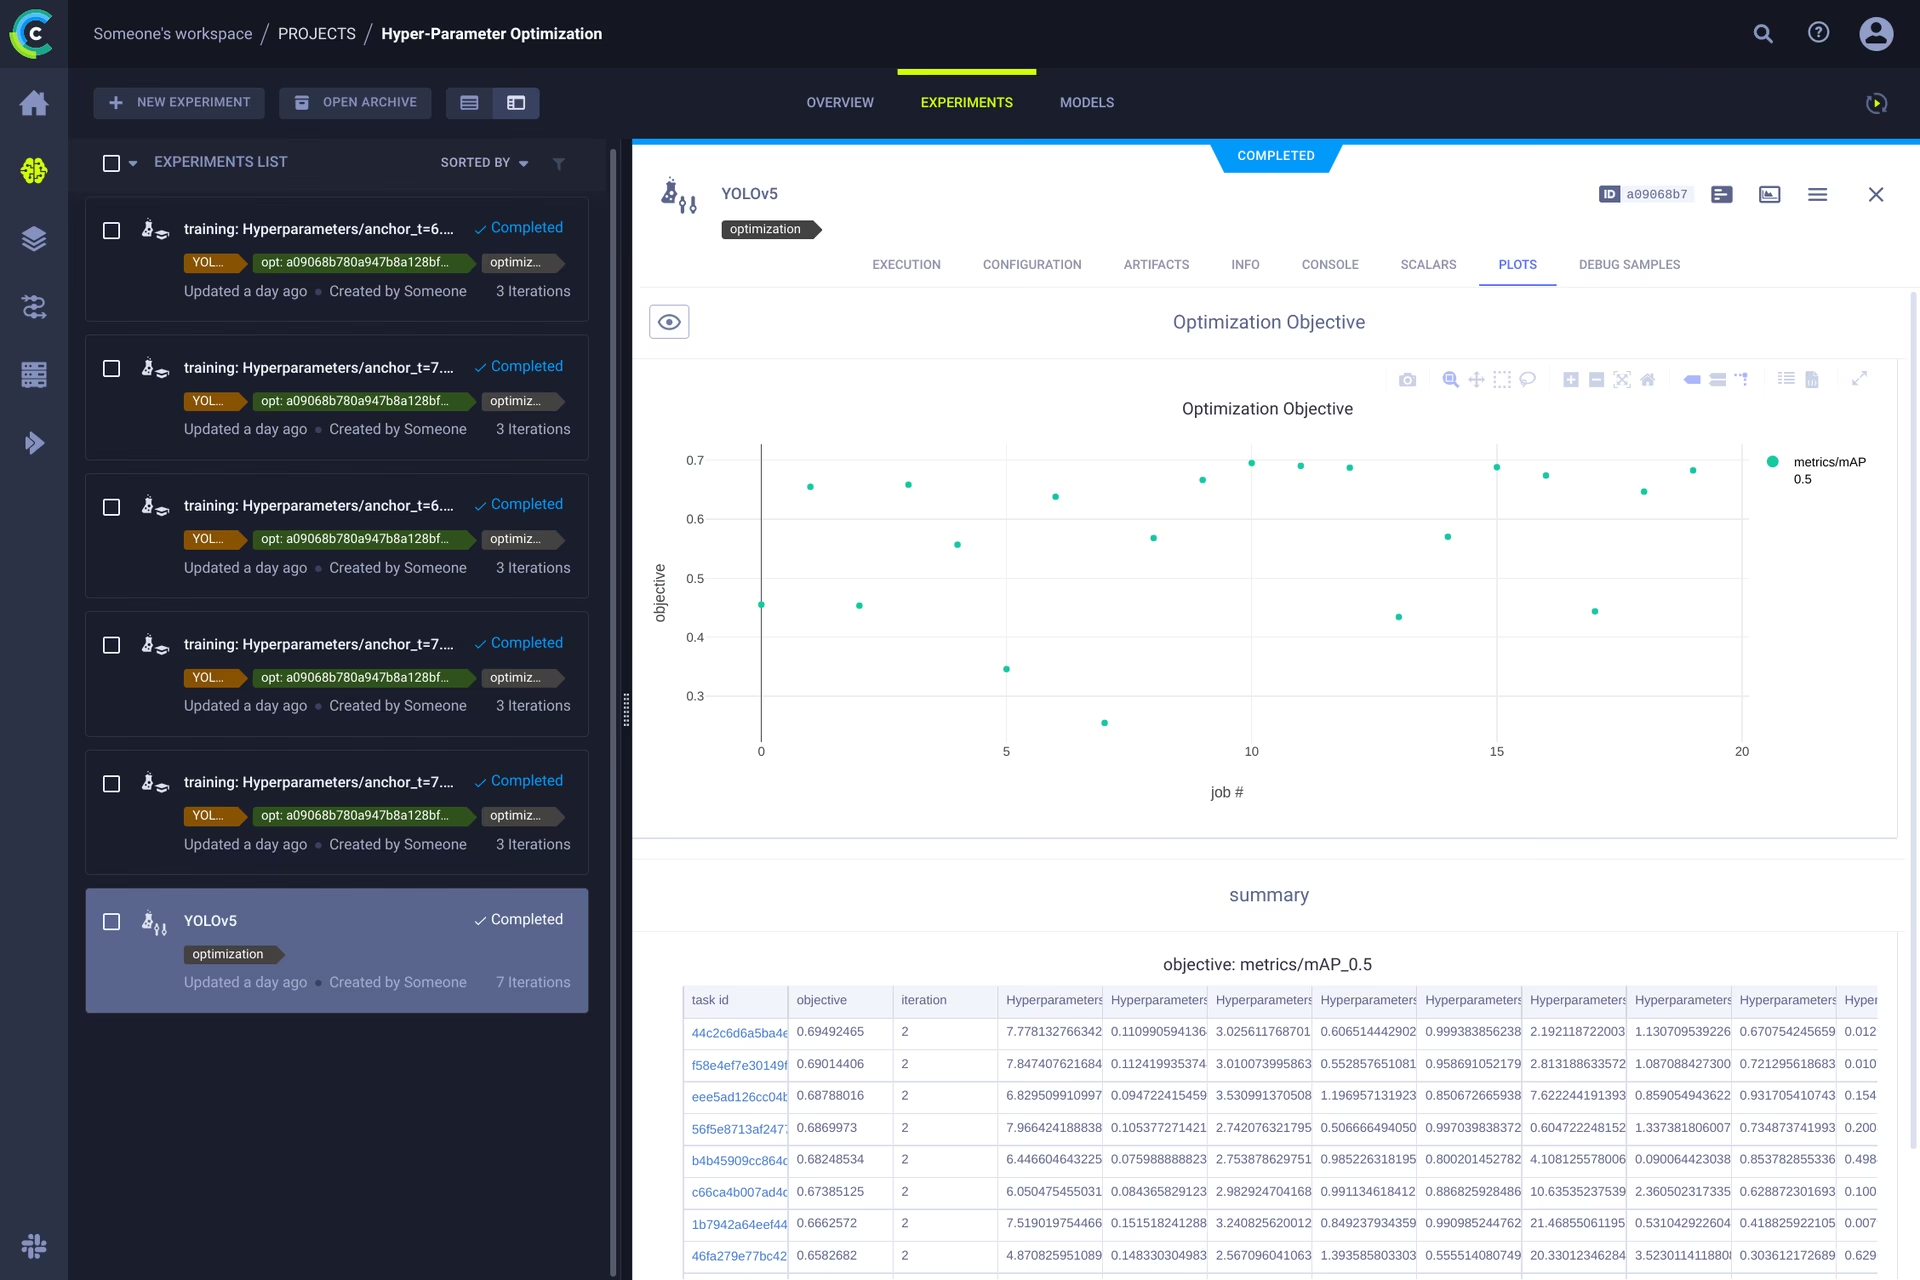
실험과 데이터의 버전 관리를 마쳤다면 이를 기반으로 작업할 수 있습니다. 추적된 각 실험에는 코드, 설치된 패키지, 구성 등 전체 환경이 포함되므로 실행을 완전히 재현할 수 있습니다. ClearML을 사용하면 실험을 복제하고 매개변수를 변경한 다음 자동으로 다시 실행할 수 있습니다. 이것이 하이퍼파라미터 최적화(HPO)의 기반입니다.
HPO를 로컬에서 실행하려면 포함된 스크립트를 사용하세요. 먼저 실험 관리자에 학습 작업이 있는지 확인합니다. 스크립트는 해당 작업을 복제하고 하이퍼파라미터를 변경합니다.
utils/loggers/clearml/hpo.py에 템플릿 작업 ID를 입력한 다음 다음 명령을 실행하세요:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
대신 원격 에이전트에서 실험을 실행하려면 optimizer.start_locally()을 optimizer.start()로 바꾸고, HyperParameterOptimizer 호출에서 execution_queue를 에이전트가 대기 중인 큐로 설정하세요.
🤯 원격 실행(고급)#
HPO를 로컬에서 실행하는 것도 편리하지만, 온프레미스 GPU 머신이나 클라우드 인스턴스처럼 더 강력한 하드웨어에서 실험을 실행해야 할 때가 많습니다. 이때 사용하는 것이 ClearML Agent입니다:
추적된 각 실험에는 다른 머신에서 재현하는 데 필요한 모든 항목(설치된 패키지, 커밋되지 않은 변경 사항 및 구성)이 포함됩니다. ClearML 에이전트는 큐를 모니터링하고 들어오는 작업을 가져와 환경을 재구성한 다음 작업을 실행하고 스칼라 값과 플롯을 실험 관리자에 다시 전송합니다.
다음 명령을 사용하면 클라우드 VM, 로컬 GPU 머신, 노트북 등 모든 머신을 ClearML 에이전트로 만들 수 있습니다:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]복제, 편집 및 큐에 등록하기#
에이전트가 실행 중이면 UI에서 직접 작업을 할당할 수 있습니다:
- 🪄 실험을 마우스 오른쪽 버튼으로 클릭한 다음 복제합니다.
- 🎯 하이퍼파라미터를 편집합니다.
- ⏳ 복제된 작업을 마우스 오른쪽 버튼으로 클릭한 다음 대상 큐에 등록합니다.
원격으로 작업 실행하기#
ClearML 로거를 인스턴스화한 후 task.execute_remotely()을 추가하면 실행 중인 스크립트에 원격 실행 플래그를 프로그래밍 방식으로 설정할 수도 있습니다. train.py에 강조 표시된 줄을 추가하세요:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ 이 줄을 추가하세요
    # ...
    # 사용자 지정 데이터셋 아티팩트 링크 처리
    data_dict = loggers.remote_dataset
# ...
이 변경 후 학습 스크립트를 실행하면 해당 줄까지 실행된 다음 코드를 패키징하여 큐로 전송합니다.
작업자 자동 확장#
ClearML에는 큐에 대기 중인 실험이 있으면 AWS, GCP 또는 Azure에서 원격 머신을 시작하고 ClearML 에이전트로 전환하며 작업이 완료되면 종료하는 오토스케일러가 포함되어 있습니다. 따라서 실제로 실행 중인 컴퓨팅 리소스에 대해서만 비용을 지불하면 됩니다.
아래의 시작 안내 동영상을 확인하세요:
자세히 알아보기#
Ultralytics 모델과 ClearML을 통합하는 방법을 자세히 알아보려면 ClearML 통합 가이드를 확인하고, 다른 실험 추적 도구를 사용하여 MLOps 워크플로를 개선하는 방법을 살펴보세요.
자주 묻는 질문#
아니요. app.clear.ml에서 제공하는 무료 호스팅 서비스는
clearml-init후 바로 사용할 수 있습니다. 데이터가 네트워크 외부로 나갈 수 없는 경우에는 자체 호스팅을 선택하는 것이 일반적이며, 이는 선택 사항입니다.YOLOv5는
clearml패키지를 가져올 수 있는 경우 통합 기능을 활성화하므로, 실행 중 추적을 비활성화하려면pip uninstall clearml로 패키지를 제거하세요.clearml-data sync으로 데이터셋을 등록한 다음, 해당 ID를 data 인수로 전달하세요:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. ID가 작업에 기록되므로 모든 실험에서 사용된 데이터를 정확히 확인할 수 있습니다.예. 각 머신에서
clearml-agent daemon을 시작한 다음, UI에서 복제된 실험을 대기열에 추가하거나utils/loggers/clearml/hpo.py을 수정해execution_queue을 설정한 상태로optimizer.start()를 호출하면 옵티마이저가 시험 실행을 대기열에 추가합니다.