사용자 지정 데이터로 YOLOv5 학습하기
이 가이드에서는 YOLOv5 모델을 사용해 사용자 지정 데이터셋을 학습하는 방법을 설명합니다. 사용자 지정 모델 학습은 일반적인 객체 탐지를 넘어 실제 특정 응용 분야에 맞는 컴퓨터 비전 솔루션을 구현하는 기본 단계입니다.
시작하기 전에#
먼저 필요한 환경이 설정되어 있는지 확인하세요. YOLOv5 저장소를 클론하고 requirements.txt에서 필수 종속 항목을 설치합니다. Python>=3.8.0 환경과 PyTorch>=1.8이 필수입니다. 모델과 데이터셋을 로컬에서 찾을 수 없으면 최신 YOLOv5 릴리스에서 자동으로 다운로드됩니다.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
사용자 지정 데이터로 학습하기#
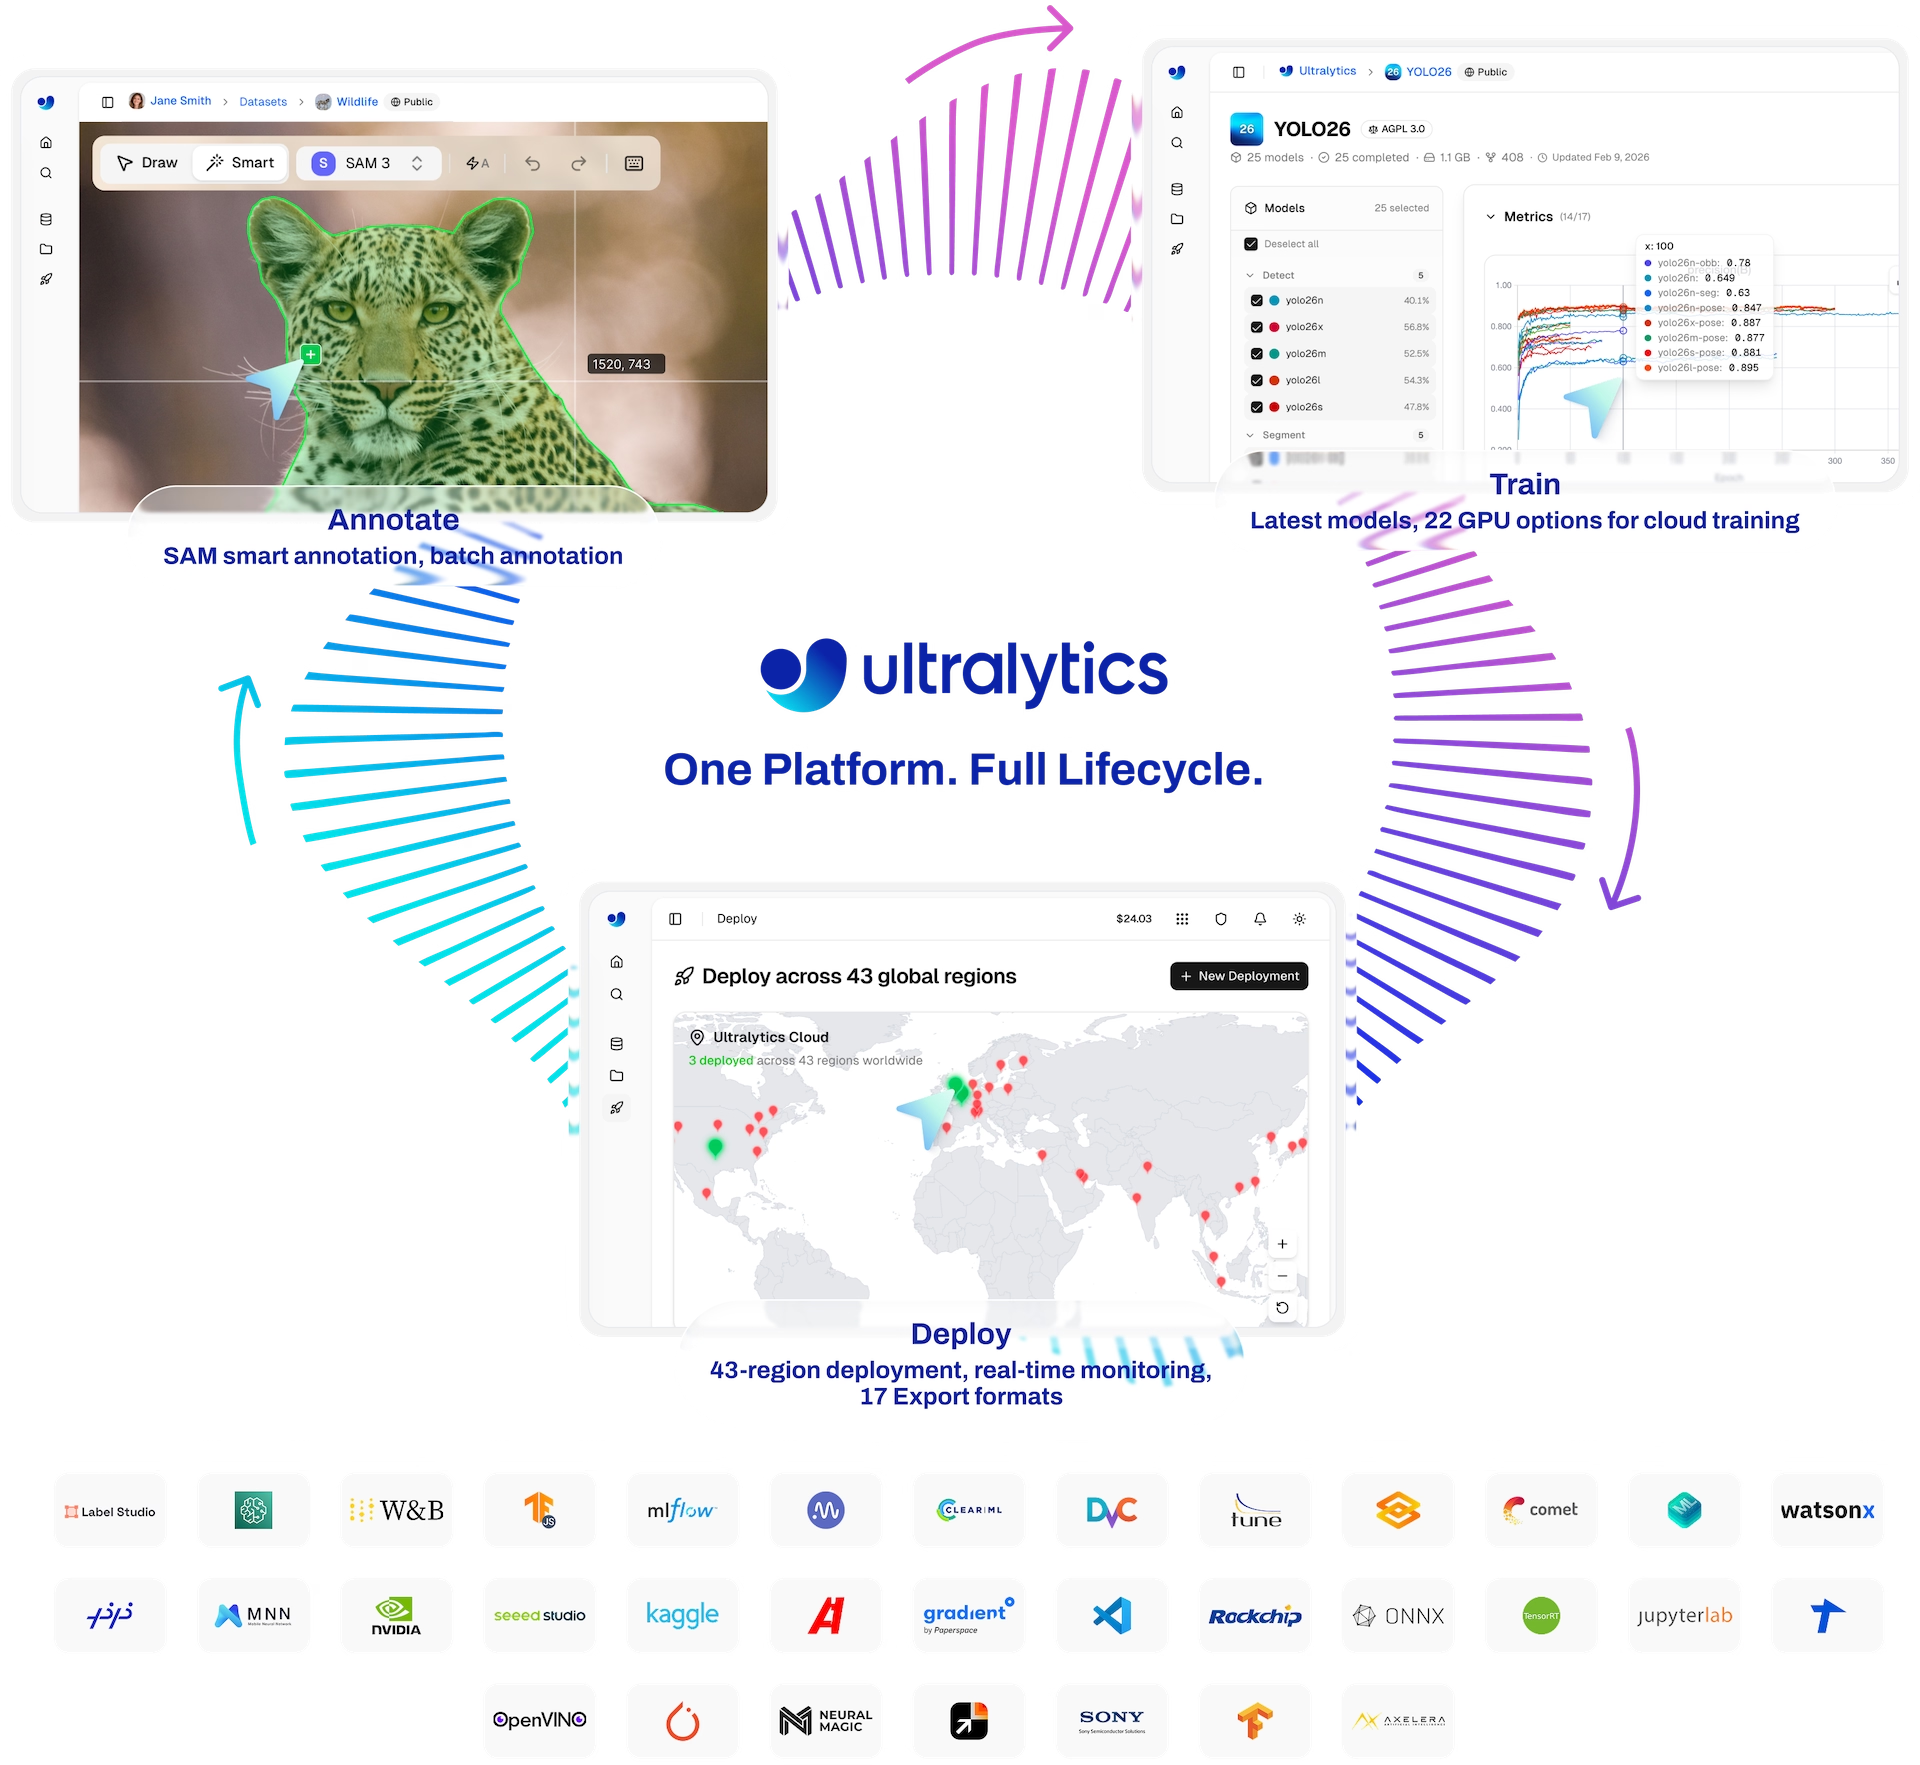
사용자 지정 객체 감지 모델 개발은 반복적인 과정입니다:
- 이미지 수집 및 정리: 특정 작업과 관련된 이미지를 수집합니다. 고품질의 다양한 데이터가 중요합니다. 데이터 수집 및 어노테이션 가이드를 참조하세요.
- 객체 레이블 지정: 이미지 내 관심 객체에 정확하게 어노테이션을 추가합니다.
- 모델 학습: 레이블이 지정된 데이터를 사용해 YOLOv5 모델을 학습합니다. 사전 학습된 가중치로 시작해 전이 학습을 활용하세요.
- 배포 및 예측: 학습된 모델로 새 데이터에 대한 추론을 수행합니다.
- 엣지 케이스 수집: 모델의 성능이 낮은 시나리오(엣지 케이스)를 파악하고, 강건성을 높이기 위해 유사한 데이터를 데이터셋에 추가합니다. 이 과정을 반복합니다.
Ultralytics Platform은 데이터셋 관리, 모델 학습, 배포를 포함한 전체 머신러닝 운영 (MLOps) 주기를 코드 없이 진행할 수 있는 솔루션을 제공합니다.
Ultralytics는 다양한 사용 시나리오에 맞춰 두 가지 라이선스 옵션을 제공합니다:
- AGPL-3.0 라이선스: OSI 승인을 받은 이 오픈 소스 라이선스는 개방형 협업과 지식 공유에 관심이 있는 학생, 연구자, 애호가에게 적합합니다. 파생 저작물도 동일한 라이선스로 공유해야 합니다. 자세한 내용은 LICENSE 파일을 참조하세요.
- 엔터프라이즈 라이선스: 개발 및 프로덕션 용도로 제공되는 이 라이선스를 사용하면 AGPL-3.0의 오픈소스 요구 사항을 적용받지 않고 Ultralytics 소프트웨어와 AI 모델을 내부 도구, 자동화된 워크플로, 프로덕션 배포 등 비즈니스 제품 및 서비스에 통합할 수 있습니다. 시작하려면 Ultralytics 라이선스를 통해 문의해 주세요.
Ultralytics 라이선스 페이지에서 라이선스 옵션을 자세히 살펴보세요.
학습을 시작하기 전에 데이터셋을 준비해야 합니다.
1. 데이터셋 생성#
YOLOv5 모델은 객체 클래스의 시각적 특징을 학습하기 위해 레이블이 지정된 데이터가 필요합니다. 데이터셋을 올바르게 정리하는 것이 중요합니다.
1.1 dataset.yaml 생성#
데이터셋 구성 파일(예: coco128.yaml)은 데이터셋 구조, 클래스 이름, 이미지 디렉터리 경로를 정의합니다. COCO128은 대규모 COCO 데이터셋에서 처음 128개 이미지를 추출한 소규모 예제 데이터셋입니다. 학습 파이프라인을 빠르게 테스트하고 과적합과 같은 잠재적 문제를 진단하는 데 유용합니다.
dataset.yaml 파일 구조에는 다음 항목이 포함됩니다:
path: 데이터셋이 포함된 루트 디렉터리입니다.train,val,test: 학습, 검증, 테스트 세트의 이미지가 포함된 디렉터리 또는 이미지 경로가 나열된 텍스트 파일을 가리키는 상대 경로입니다. 기준 경로는path입니다.names: 클래스 인덱스(0부터 시작)를 해당 클래스 이름에 매핑하는 딕셔너리입니다.
학습을 YOLOv5 저장소 루트에서 시작할 때 path에는 절대 디렉터리(예: /home/user/datasets/coco128) 또는 ../datasets/coco128와 같은 상대 경로를 지정할 수 있습니다.
다음은 coco128.yaml의 구조입니다(GitHub에서 보기):
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 자동 레이블 지정에 모델 활용하기#
수동 레이블 지정이 일반적인 방법이지만 시간이 많이 걸립니다. 파운데이션 모델을 사용하면 어노테이션을 자동화하거나 반자동화하여 데이터셋 생성 속도를 높일 수 있습니다. 레이블 생성에 도움이 되는 모델의 예:
- Google Gemini: Gemini와 같은 대규모 멀티모달 모델은 이미지 이해 능력이 뛰어납니다. 이미지 내 객체의 식별 및 위치 파악을 요청하면 바운딩 박스나 설명을 생성할 수 있으며, 연결된 튜토리얼 노트북에 나온 것처럼 이를 YOLO 형식 라벨로 변환할 수 있습니다. Ultralytics VLM 리더보드에서는 Gemini와 다른 비전 언어 모델이 실제 탐지 데이터셋에 자동 주석을 얼마나 정확하게 추가하는지 비교합니다.
- SAM2 (Segment Anything Model 2): SAM2와 같이 세그멘테이션에 중점을 둔 파운데이션 모델은 높은 정밀도로 객체를 식별하고 윤곽을 구분할 수 있습니다. 주로 세그멘테이션에 사용되지만, 결과 마스크를 객체 감지 작업에 적합한 바운딩 박스 어노테이션으로 변환할 수 있는 경우가 많습니다.
- YOLO-World: 이 모델은 개방 어휘 탐지 기능을 제공합니다. 관심 있는 객체를 텍스트로 설명하면, YOLO-World는 해당 클래스를 사전에 학습하지 않아도 이미지에서 객체를 찾을 수 있습니다. 이 기능을 초기 라벨 생성의 출발점으로 사용할 수 있으며, 생성된 라벨은 이후 수정할 수 있습니다.
이러한 모델을 사용하면 "사전 라벨링" 단계로 수작업을 줄일 수 있습니다. Ultralytics Platform Smart Annotation은 코드 없이 브라우저에서 SAM, YOLO, 비전 언어 모델을 사용한 사전 라벨링을 제공합니다. 하지만 자동 생성된 라벨의 품질은 학습된 YOLOv5 모델의 성능에 직접 영향을 미치므로, 정확성과 일관성을 보장하기 위해 라벨을 검토하고 수정하는 것이 중요합니다. 라벨을 생성하고 필요에 따라 수정한 후에는 YOLO 형식을 준수하는지 확인합니다. 이미지마다 *.txt 파일 하나를 사용하고, 각 줄에는 객체를 class_index x_center y_center width height(정규화 좌표, 0부터 시작하는 클래스 인덱스)로 표현합니다. 이미지에 관심 대상 객체가 없으면 해당하는 *.txt 파일은 필요하지 않습니다.
YOLO 형식 *.txt 파일의 사양은 다음과 같이 명확합니다:
- 객체마다 한 행을 사용합니다(바운딩 박스).
- 각 행에는 다음이 포함되어야 합니다:
class_index x_center y_center width height. - 좌표는 0과 1 사이의 범위로 정규화해야 합니다. 이를 위해
x_center및width의 픽셀 값을 이미지 전체 너비로 나누고,y_center및height의 픽셀 값은 이미지 전체 높이로 나눕니다. - 클래스 인덱스는 0부터 시작합니다(즉, 첫 번째 클래스는
0, 두 번째 클래스는1로 표시하는 식입니다).
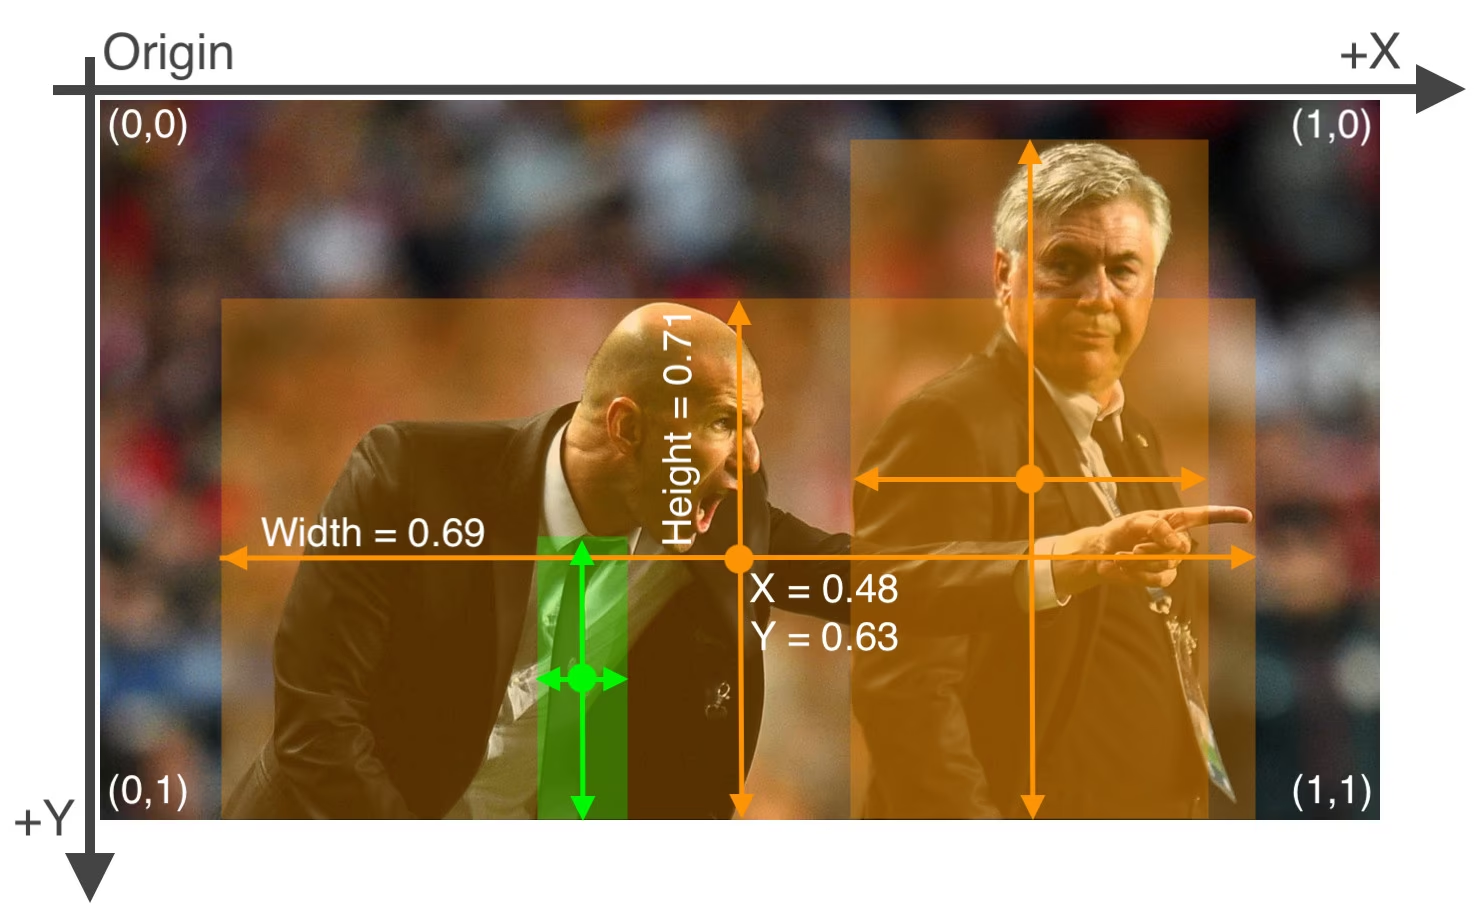
위 이미지에 해당하는 레이블 파일은 'person' 객체 두 개(클래스 인덱스 0)와 'tie' 객체 하나(클래스 인덱스 27)를 포함하며, 다음과 같은 형식입니다:
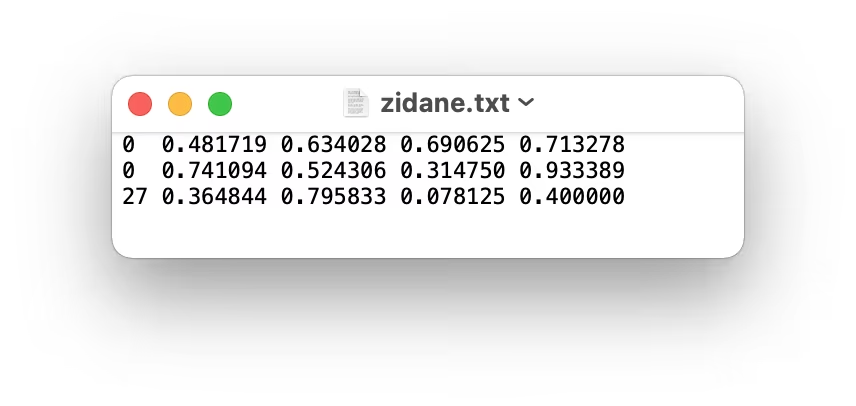
1.3 디렉터리 정리#
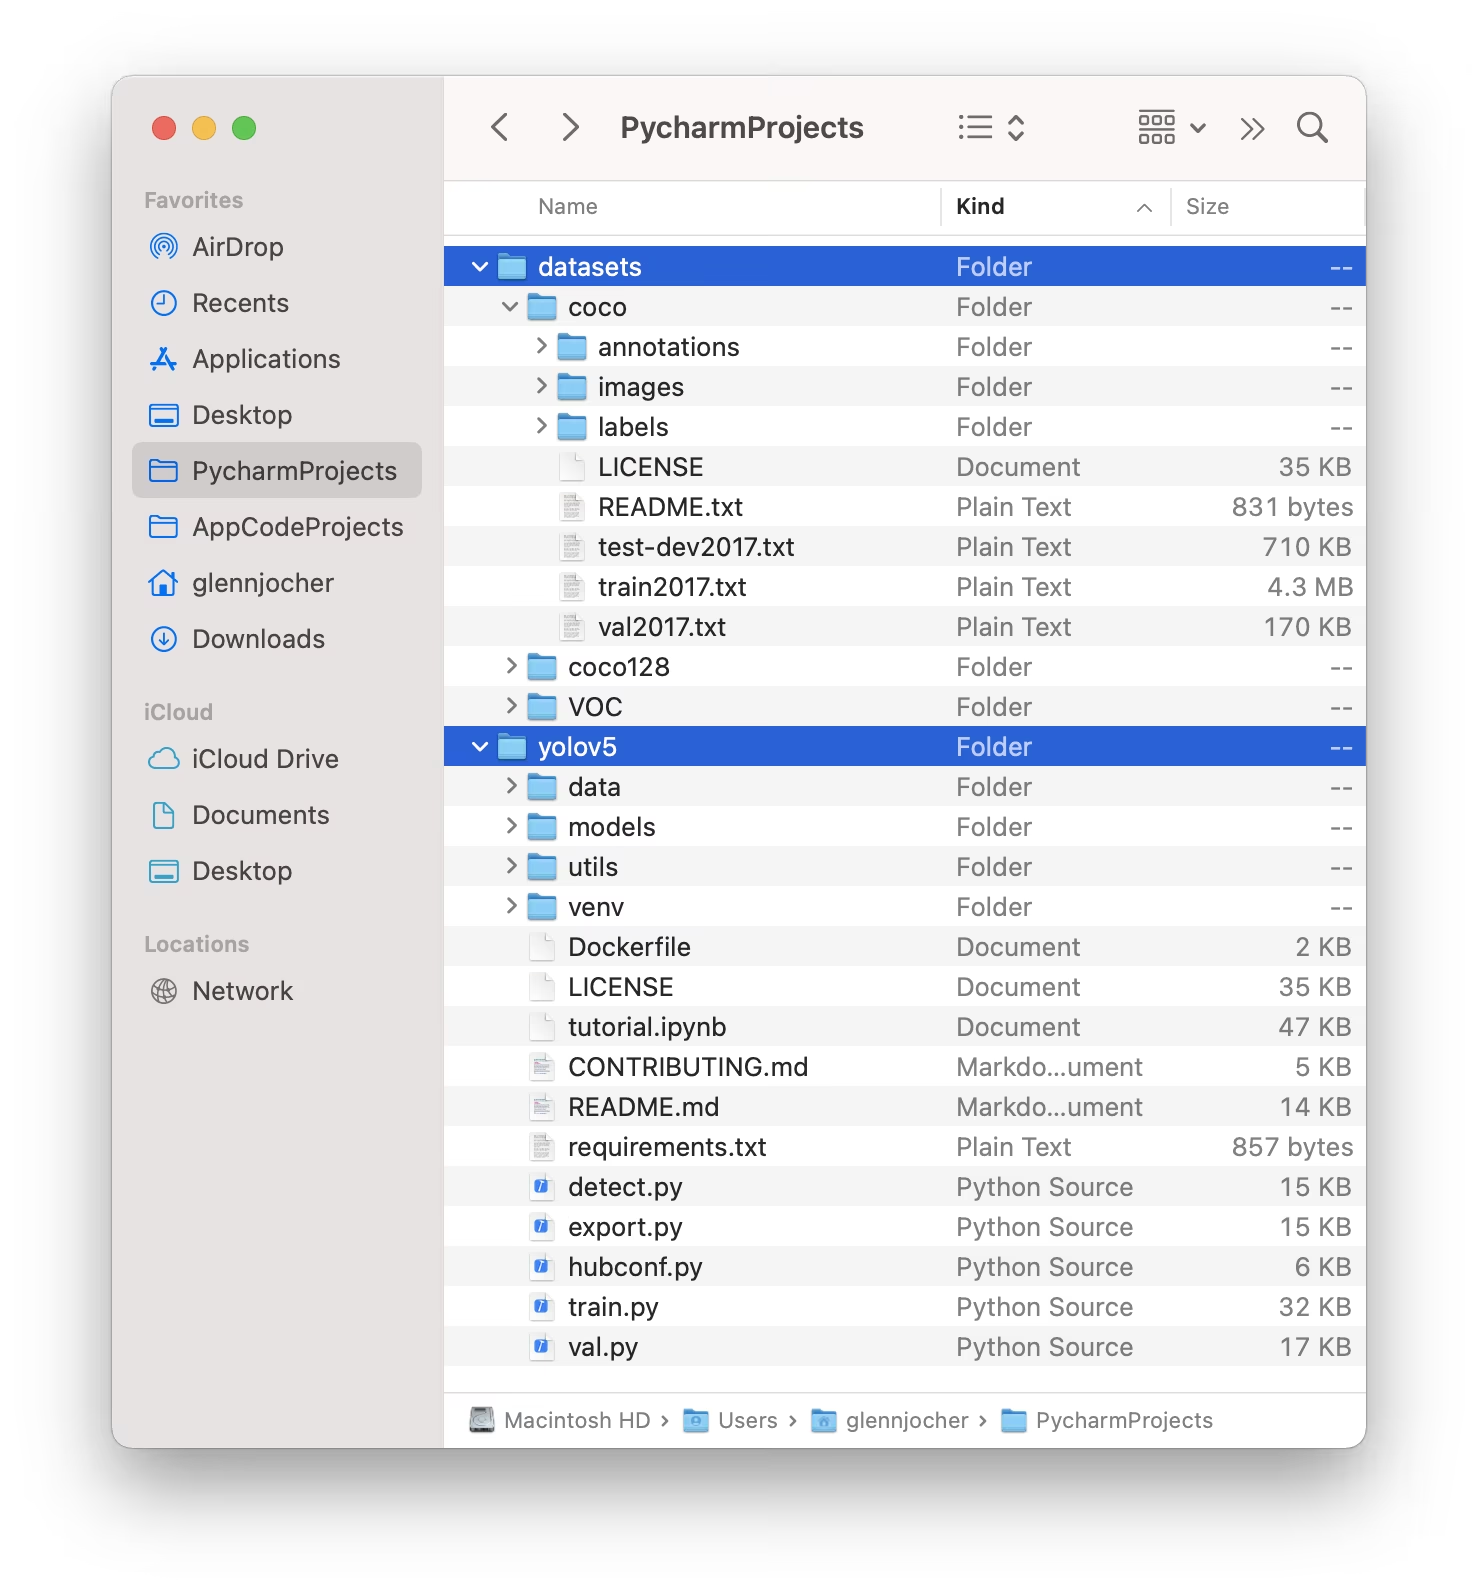
아래에 나온 예시대로 데이터셋 디렉터리를 구성합니다. 기본적으로 YOLOv5는 데이터셋 디렉터리(예: /coco128)가 /yolov5 저장소 디렉터리와 같은 위치에 있는 /datasets 폴더 안에 있다고 가정합니다.
YOLOv5는 이미지 경로에서 마지막 /images/을 /labels/로 바꾸어 각 이미지의 레이블을 자동으로 찾습니다. 예:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
권장 디렉터리 구조는 다음과 같습니다:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. 모델 선택#
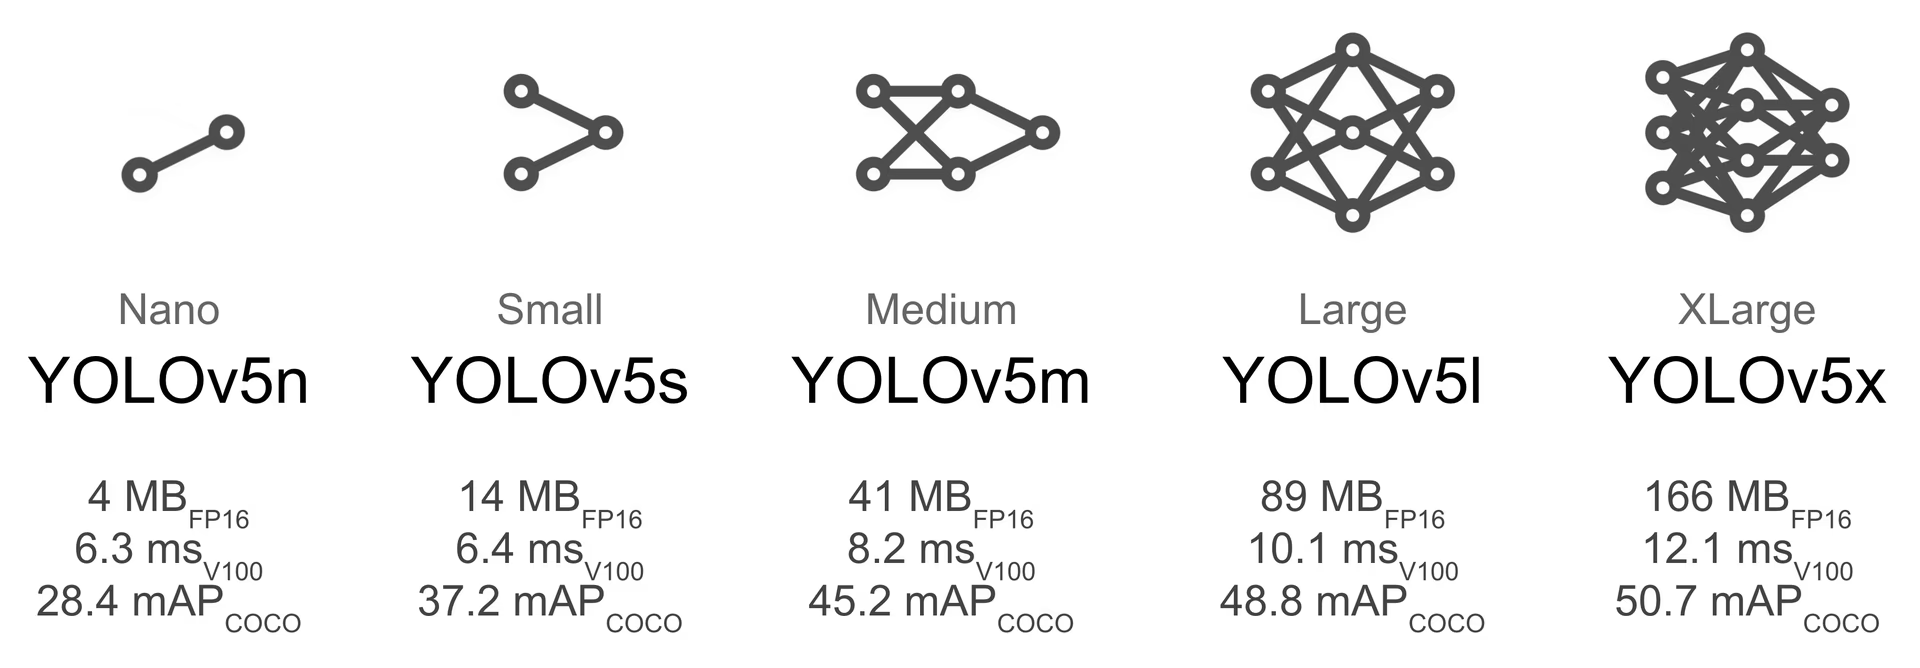
학습을 시작할 사전 학습 모델을 선택합니다. 사전 학습 가중치로 시작하면 처음부터 학습하는 것보다 학습 속도가 크게 빨라지고 성능도 향상됩니다. YOLOv5는 속도와 정확도의 균형이 서로 다른 다양한 모델 크기를 제공합니다. 예를 들어 YOLOv5s는 두 번째로 작고 두 번째로 빠른 모델로, 리소스가 제한된 환경에 적합합니다.
3. 학습#
train.py 스크립트를 사용해 모델 학습을 시작합니다. 주요 인수는 다음과 같습니다:
--img: 입력 이미지 크기를 정의합니다(예:--img 640). 일반적으로 크기가 클수록 정확도가 높지만 더 많은 GPU 메모리가 필요합니다.--batch: 배치 크기를 지정합니다(예:--batch 16). GPU가 처리할 수 있는 최대 크기를 선택하세요.--epochs: 총 학습 에포크 수를 지정합니다(예:--epochs 100). 에포크 하나는 전체 학습 데이터셋을 한 번 모두 처리하는 것을 의미합니다.--data:dataset.yaml파일의 경로입니다(예:--data coco128.yaml).--weights: 초기 가중치 파일의 경로입니다. 더 빠른 수렴과 나은 결과를 위해 사전 학습 가중치(예:--weights yolov5s.pt)를 사용하는 것이 좋습니다. 처음부터 학습하려면(매우 큰 데이터셋과 특정 요구 사항이 있는 경우가 아니라면 권장하지 않음)--weights '' --cfg yolov5s.yaml를 사용합니다.
사전 학습 가중치를 로컬에서 찾을 수 없으면 최신 YOLOv5 릴리스에서 자동으로 다운로드됩니다.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt--cache ram 또는 --cache disk을 사용하면 데이터셋 이미지를 RAM 또는 로컬 디스크에 각각 캐싱할 수 있습니다. 데이터셋 I/O(입출력) 작업이 병목일 때 특히 학습 속도를 크게 높일 수 있습니다. 상당한 RAM 또는 디스크 공간이 필요합니다.
데이터셋은 항상 로컬에 저장된 것을 사용해 학습하세요. 네트워크 드라이브(예: Google Drive)나 원격 스토리지에서 데이터에 접근하면 속도가 크게 느려져 학습 성능이 저하될 수 있습니다. 데이터셋을 로컬 SSD에 복사하는 것이 일반적으로 가장 좋습니다.
가중치와 로그를 포함한 모든 학습 출력은 runs/train/ 디렉터리에 저장됩니다. 각 학습 세션은 새 하위 디렉터리(예: runs/train/exp, runs/train/exp2 등)를 생성합니다. 직접 실습하며 학습하려면 공식 튜토리얼 노트북의 학습 섹션을 살펴보세요: 

4. 시각화#
YOLOv5는 학습 진행 상황 시각화, 결과 평가, 실시간 성능 모니터링을 위한 다양한 도구와 통합됩니다.
Comet 로깅 및 시각화#
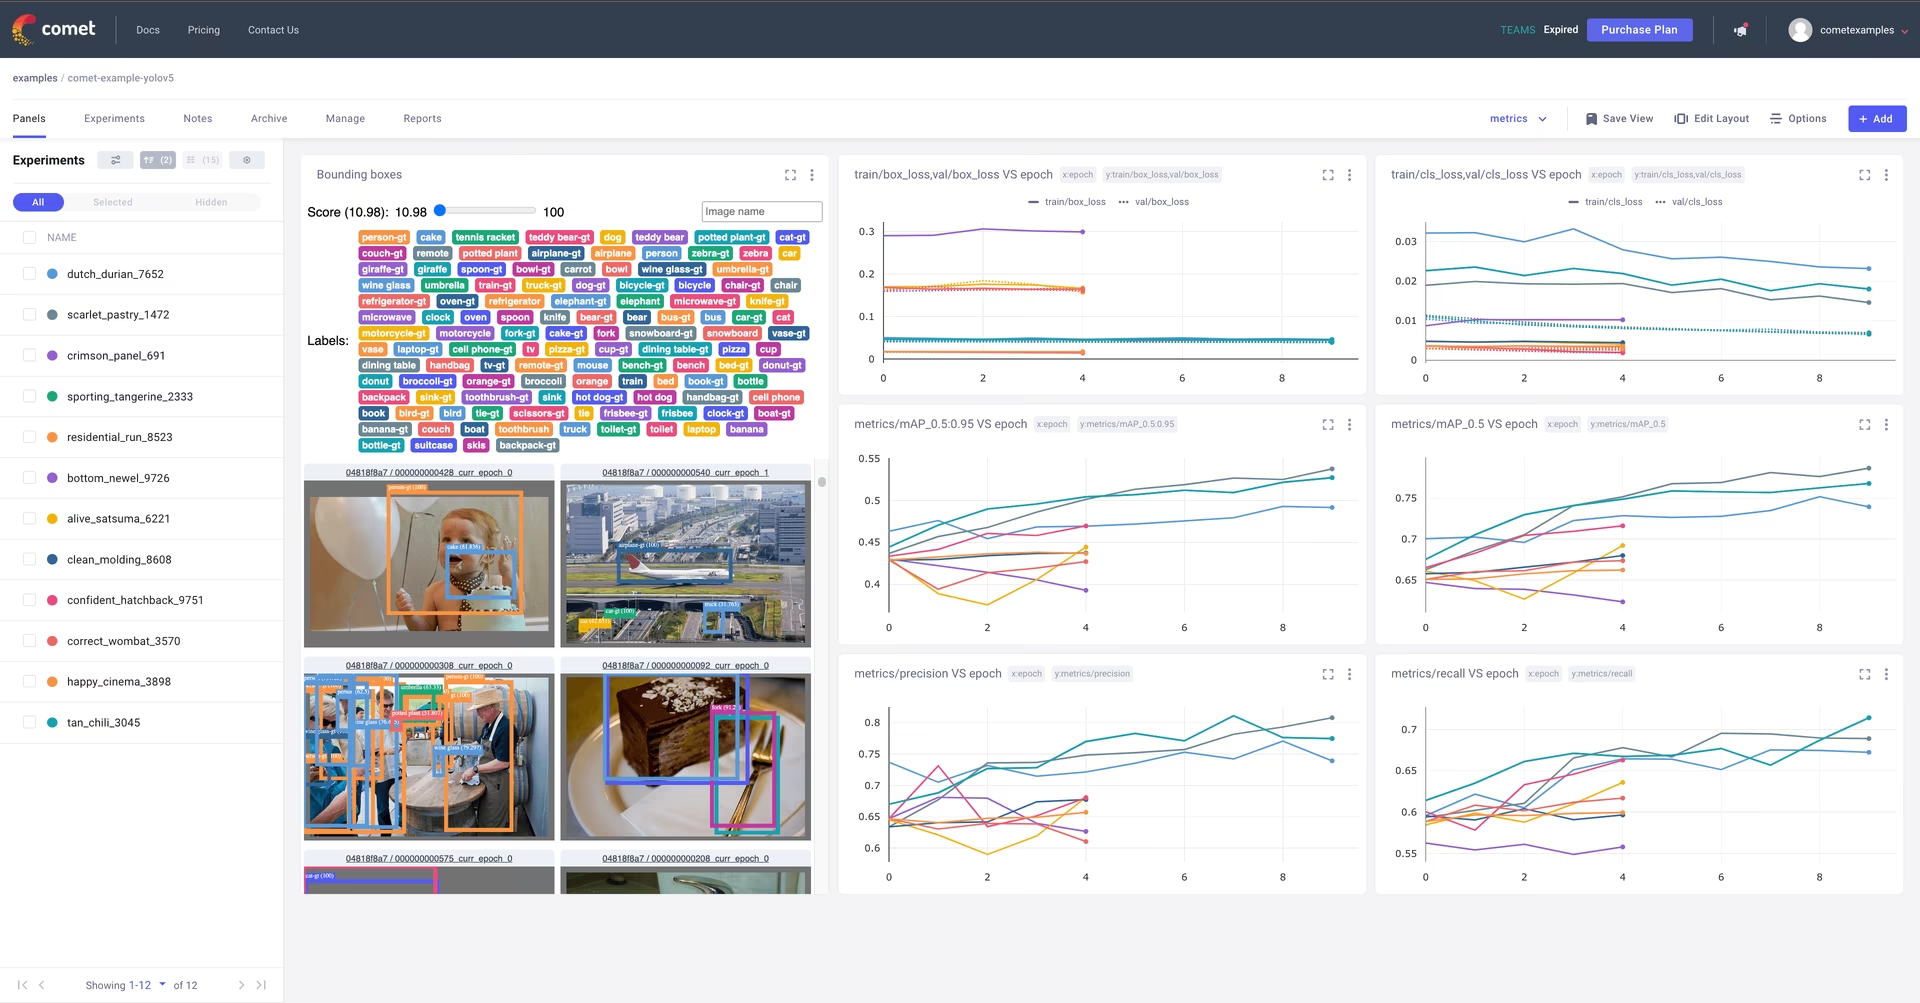
Comet은 전체 실험 추적을 위해 통합되어 있습니다. 지표를 실시간으로 시각화하고, 하이퍼파라미터를 저장하고, 데이터셋과 모델 체크포인트를 관리하고, 대화형 Comet Custom Panels을 사용해 모델 예측을 분석할 수 있습니다.
간단한 단계로 시작할 수 있습니다:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
실시간 데모는 Comet Colab Notebook에서 확인하세요:
ClearML 로깅 및 자동화#
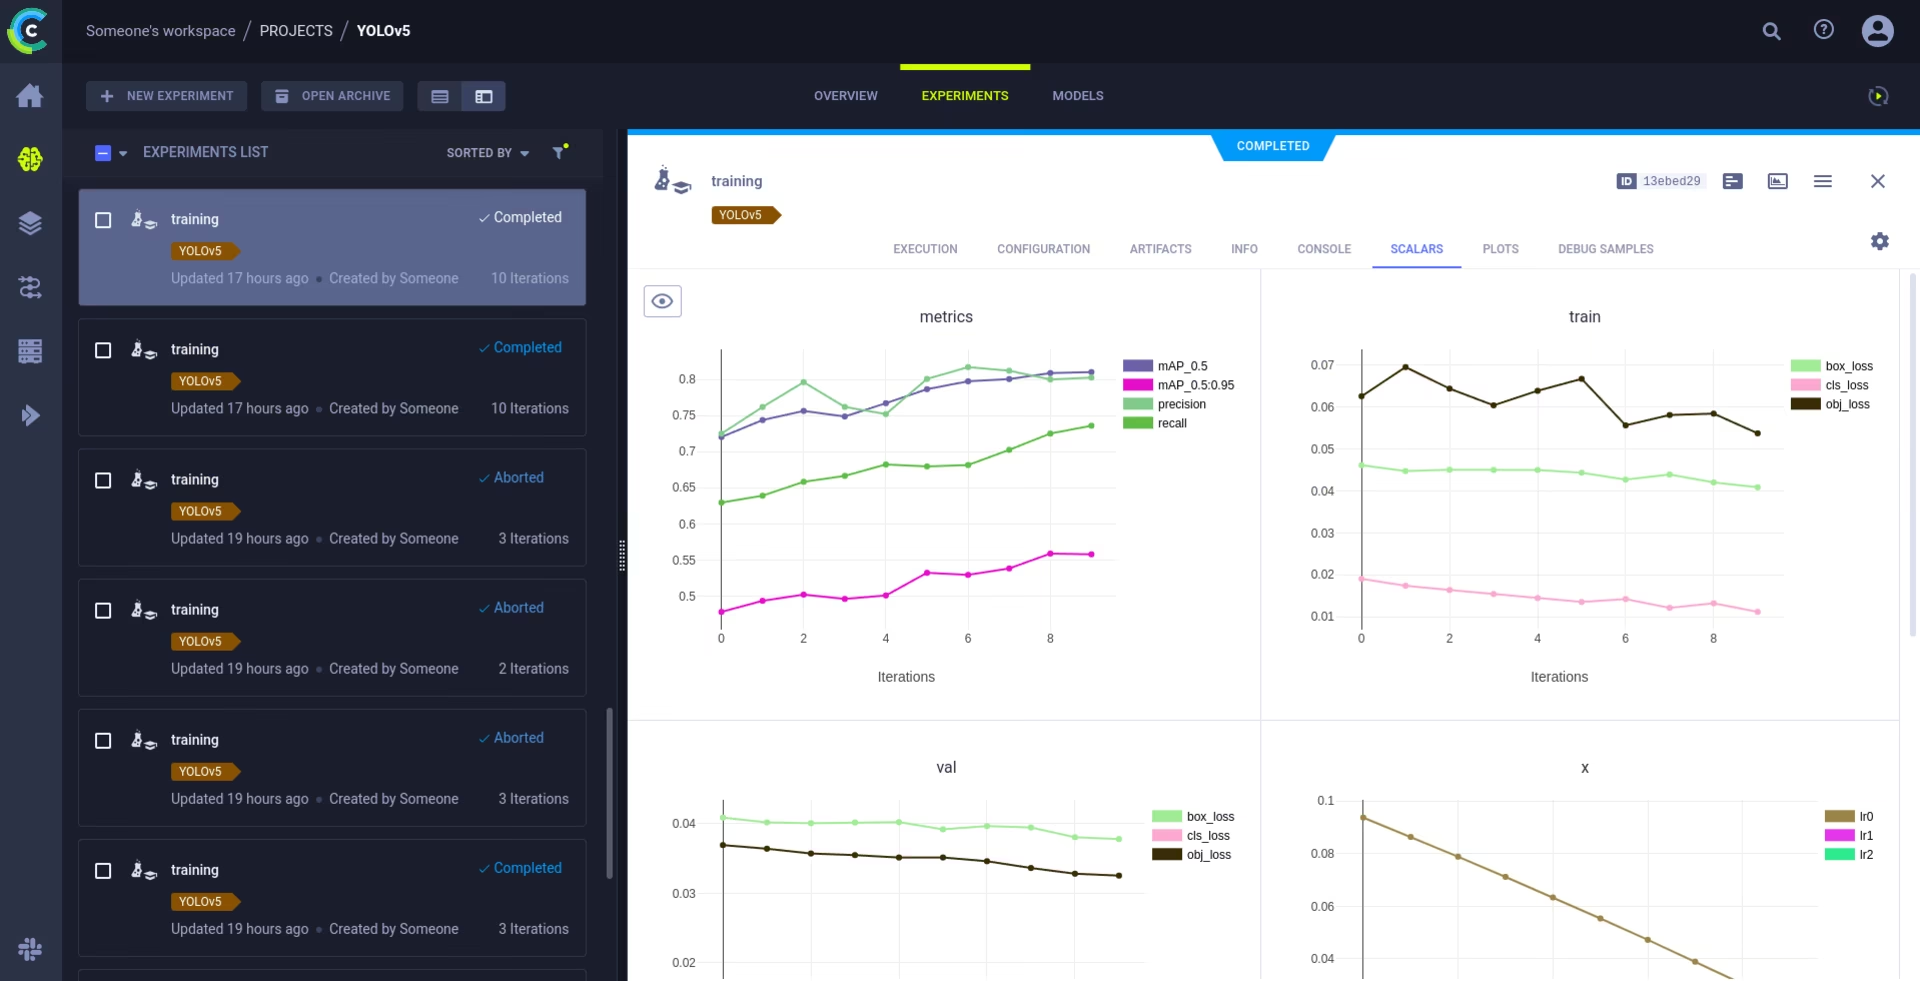
ClearML 통합을 사용하면 상세한 실험 추적, 데이터셋 버전 관리, 학습 실행의 원격 수행까지 가능합니다. 다음 단계에 따라 ClearML을 활성화하세요.
- 패키지 설치:
pip install clearml - ClearML 초기화:
clearml-init을 한 번 실행해 ClearML 서버(자체 호스팅 서버 또는 무료 티어)에 연결합니다.
ClearML은 실험 세부 정보, 모델 업로드, 비교, 커밋되지 않은 코드 변경 사항, 설치된 패키지를 자동으로 기록하여 완전한 재현성을 보장합니다. 원격 에이전트에서 학습 작업을 예약하고 ClearML Data로 데이터셋 버전을 관리할 수 있습니다.
로컬 로깅#
학습 결과는 TensorBoard를 사용해 자동으로 기록되며, 해당 실험 디렉터리(예: runs/train/exp)에 CSV 파일로 저장됩니다. 기록되는 데이터는 다음과 같습니다:
- 학습 및 검증 손실과 성능 지표입니다.
- 적용된 증강(모자이크 등)을 보여주는 샘플 이미지입니다.
- 시각적 검토를 위한 정답 레이블과 모델 예측입니다.
- 정밀도-재현율(PR) 곡선과 같은 주요 평가 지표입니다.
- 클래스별 성능을 자세히 분석하기 위한 혼동 행렬입니다.
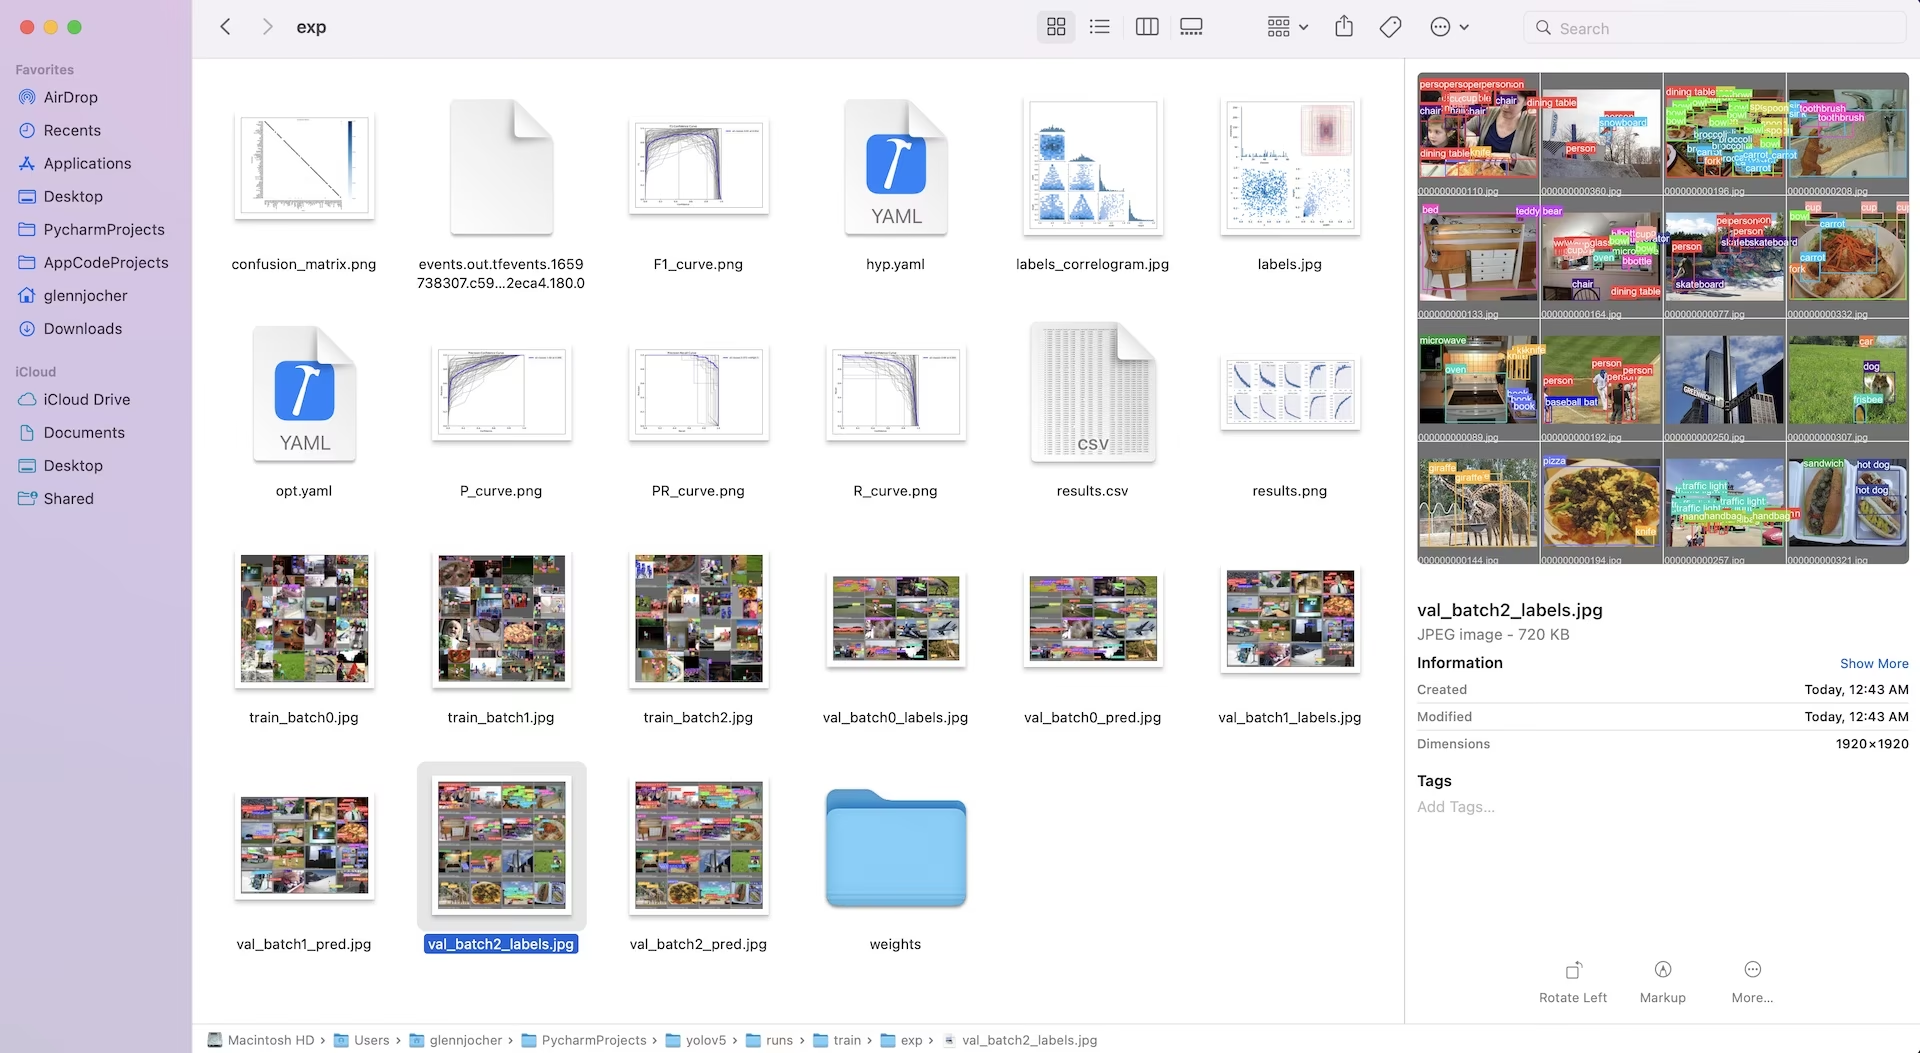
results.csv 파일은 에포크가 끝날 때마다 업데이트되고, 학습이 종료되면 results.png로 그려집니다. 제공된 유틸리티 함수를 사용해 results.csv 파일을 직접 플로팅할 수도 있습니다:
from utils.plots import plot_results

# 특정 학습 실행 디렉터리의 결과를 플로팅합니다
plot_results("runs/train/exp/results.csv")  # 같은 디렉터리에 'results.png'가 생성됩니다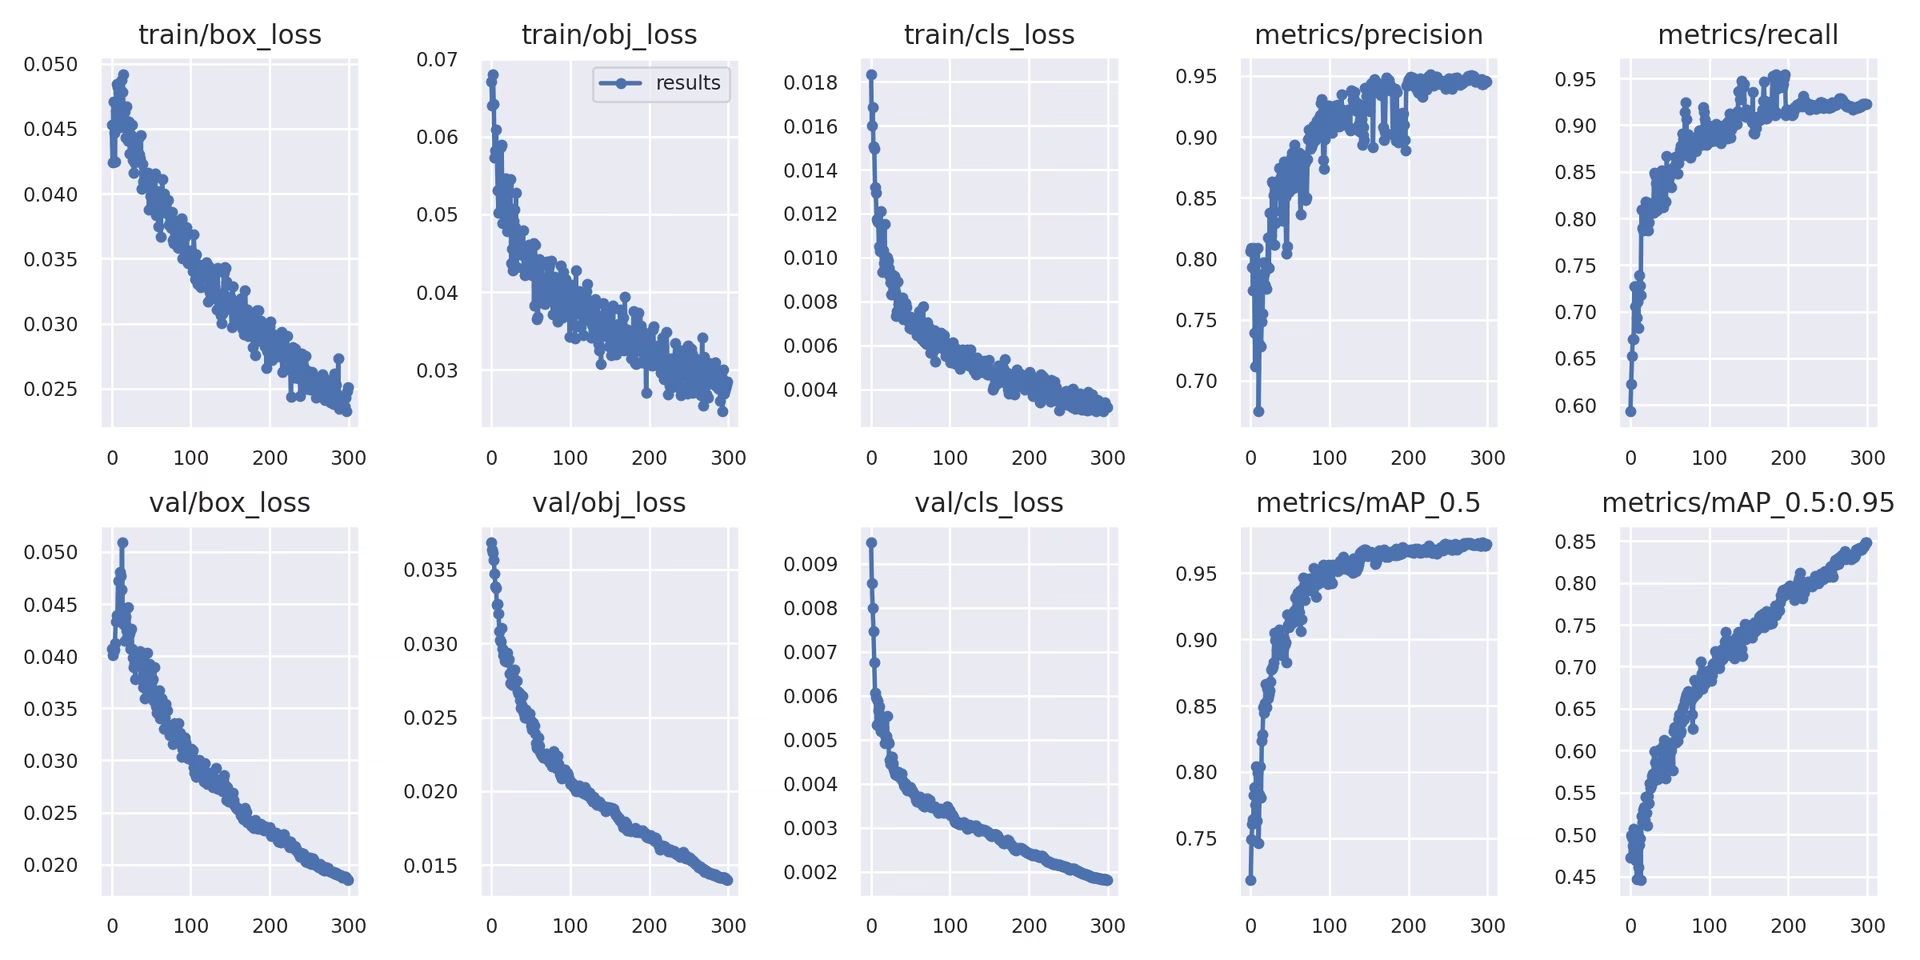
5. 다음 단계#
학습이 성공적으로 완료되면 성능이 가장 좋은 모델 체크포인트(best.pt)가 저장되어 배포하거나 추가로 개선할 수 있습니다. 다음 단계의 예:
- 학습된 모델을 사용해 CLI 또는 Python으로 새로운 이미지나 동영상에 대한 추론을 실행합니다.
val.py을 실행하여 서로 다른 데이터 분할(예: 학습에 사용하지 않은 테스트 세트)에서 모델의 정확도와 일반화 성능을 평가합니다.- 다양한 플랫폼에서 추론을 최적화할 수 있도록 모델을 ONNX, TensorFlow SavedModel, TensorRT와 같은 다양한 배포 형식으로 내보냅니다.
- 추가 성능 향상을 위해 하이퍼파라미터 진화를 활용해 보세요.
- 최상의 학습 결과를 위한 팁을 따르고 성능 분석을 바탕으로 더욱 다양하고 어려운 데이터를 반복적으로 추가해 모델을 계속 개선하세요.
지원 환경#
Ultralytics는 CUDA, cuDNN, Python, PyTorch와 같은 필수 종속 항목이 사전 설치된 환경을 제공하여 원활하게 시작할 수 있도록 지원합니다.
- 무료 GPU 노트북:
- 클라우드 플랫폼:
- Google Cloud: GCP 빠른 시작 가이드
- Amazon AWS: AWS 빠른 시작 가이드
- Microsoft Azure: AzureML 빠른 시작 가이드
- 로컬 설정:
- Docker: Docker 빠른 시작 가이드
- Docker: Docker 빠른 시작 가이드


프로젝트 상태#

이 배지는 모든 YOLOv5 GitHub Actions 지속적 통합 (CI) 테스트가 성공적으로 통과했음을 나타냅니다. 이 CI 테스트는 macOS, Windows, Ubuntu 운영 체제에서 학습, 검증, 추론, 내보내기, 벤치마크를 포함한 핵심 기능을 확인합니다. 테스트는 24시간마다, 그리고 코드가 커밋될 때마다 자동으로 실행됩니다.
자주 묻는 질문#
사용자 지정 데이터셋으로 YOLOv5를 학습하려면 다음과 같은 주요 단계를 거칩니다:
- 데이터셋 준비: 이미지를 수집하고 주석을 추가합니다. 주석은 필수 YOLO 형식을 따라야 합니다. 이미지를
train/에, 라벨을val/(선택적으로test/) 디렉터리에 정리합니다. Google Gemini, SAM2, YOLO-World와 같은 모델을 사용해 라벨링을 지원하거나 자동화할 수 있습니다(섹션 1.2 참조). - 환경 설정: YOLOv5 리포지토리를 복제하고
pip install -r requirements.txt을 사용해 종속 항목을 설치합니다.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - 데이터셋 구성 파일 생성:
dataset.yaml파일에서 데이터셋 경로, 클래스 수 및 클래스 이름을 정의합니다. - 학습 시작:
train.py스크립트를 실행하고dataset.yaml경로, 원하는 사전 학습 가중치(예:yolov5s.pt), 이미지 크기, 배치 크기 및 에포크 수를 지정합니다.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- 데이터셋 준비: 이미지를 수집하고 주석을 추가합니다. 주석은 필수 YOLO 형식을 따라야 합니다. 이미지를
Ultralytics Platform은 코드를 작성하지 않아도 YOLO 모델 개발 수명 주기 전체를 지원합니다. 주요 이점은 다음과 같습니다.
- 간편한 학습: 웹 인터페이스를 통해 사전 구성된 클라우드 환경에서 모델을 학습합니다.
- 통합 데이터 관리: 플랫폼에서 데이터셋을 업로드하고 버전을 관리하며 정리할 수 있습니다.
- 실시간 모니터링: 학습 진행 상황을 추적하고 스트리밍되는 성능 지표를 시각화할 수 있습니다.
- 협업 기능: 공유 리소스, 프로젝트 관리 도구 및 간편한 모델 공유를 통해 팀워크를 지원합니다.
- 노코드 배포: 학습된 모델을 다양한 대상에 직접 배포할 수 있습니다.
실습 안내는 블로그 게시물 Ultralytics Platform으로 사용자 지정 모델을 학습하는 방법을 참조하세요.
수동으로 어노테이션하든 자동화 도구(섹션 1.2에서 언급한 도구 등)를 사용하든, 최종 레이블은 YOLOv5에 필요한 특정 YOLO 형식이어야 합니다:
- 이미지마다
.txt파일을 하나씩 만듭니다. 파일 이름은 이미지 파일 이름과 일치해야 합니다(예:image1.jpg은image1.txt에 해당합니다). 이 파일을images/디렉터리와 나란히 있는labels/디렉터리에 저장합니다(예:../datasets/mydataset/labels/train/). .txt파일의 각 줄은 하나의 객체 어노테이션을 나타내며, 다음 형식을 따릅니다:class_index center_x center_y width height.- 좌표(
center_x,center_y,width,height)는 이미지 크기를 기준으로 정규화해야 합니다(값의 범위는 0.0~1.0입니다). - 클래스 인덱스는 0부터 시작합니다(첫 번째 클래스는
0, 두 번째 클래스는1등입니다).
많은 수동 어노테이션 도구는 YOLO 형식으로 직접 내보내는 기능을 제공합니다. 자동화 모델을 사용하는 경우, 출력(예: 경계 상자 좌표, 세그멘테이션 마스크)을 이 정규화된 특정 텍스트 형식으로 변환하는 스크립트나 프로세스가 필요합니다. 최종 데이터셋 구조가 가이드의 예시를 따르는지 확인하세요. 자세한 내용은 데이터 수집 및 어노테이션 가이드를 참조하세요.
- 이미지마다
Ultralytics는 다양한 요구 사항에 맞춘 유연한 라이선스를 제공합니다:
- AGPL-3.0 라이선스: 이 오픈 소스 라이선스는 학술 연구, 개인 프로젝트 및 오픈 소스 규정을 준수할 수 있는 상황에 적합합니다. 수정 사항과 파생 저작물도 AGPL-3.0에 따라 오픈 소스로 공개해야 합니다. AGPL-3.0 라이선스 세부 정보를 확인하세요.
- 엔터프라이즈 라이선스: YOLOv5를 독점 제품이나 서비스에 통합하는 기업을 위한 상용 라이선스입니다. 이 라이선스를 사용하면 AGPL-3.0의 오픈 소스 의무가 면제되어 비공개 소스 배포가 가능합니다. 자세한 내용이나 엔터프라이즈 라이선스 요청은 라이선스 페이지를 방문하세요.
프로젝트 요구 사항 및 배포 모델에 가장 적합한 라이선스를 선택하세요.


댓글
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.