컴퓨터 비전 데이터 수집 및 어노테이션 전략#
데이터 수집과 어노테이션은 모든 컴퓨터 비전 프로젝트의 두 가지 기본 단계입니다. 대표성 있는 이미지나 동영상을 수집한 다음, 모델이 학습할 수 있도록 레이블을 지정합니다. 데이터 품질이 모델 성능을 직접적으로 좌우하므로, 학습을 시작하기 전에 클래스 정의, 편향 없는 데이터 수집, 일관된 어노테이션이 중요합니다.
시청: 컴퓨터 비전을 위한 효과적인 데이터 수집 및 주석 전략을 구축하는 방법 🚀
이 가이드에서는 클래스 설정 및 데이터 수집, 데이터 어노테이션의 개념과 선택 가능한 어노테이션 유형 및 형식, 그리고 효율적인 레이블링 전략을 다룹니다. 모든 결정은 프로젝트 목표에 맞춰야 합니다.
클래스 설정 및 데이터 수집#
컴퓨터 비전 프로젝트를 위한 이미지와 동영상 수집은 정의할 클래스의 수, 데이터 출처, 데이터셋의 편향 방지라는 세 가지 결정으로 요약됩니다.
프로젝트에 적합한 클래스 선택#
컴퓨터 비전 프로젝트를 시작할 때 가장 먼저 고려할 질문 중 하나는 포함할 클래스의 수입니다. 모델이 인식하고 구분할 범주 또는 레이블인 클래스 구성원을 결정해야 합니다. 클래스 수는 프로젝트의 구체적인 목표에 따라 정해야 합니다.
예를 들어 교통 상황을 모니터링하려면 클래스에 "자동차", "트럭", "버스", "오토바이", "자전거"를 포함할 수 있습니다. 반면 매장의 상품을 추적하려면 "과일", "채소", "음료", "간식"을 클래스로 사용할 수 있습니다. 프로젝트 목표에 따라 클래스를 정의하면 데이터셋의 관련성과 집중도를 유지하는 데 도움이 됩니다.
클래스를 정의할 때 고려해야 할 또 다른 중요한 점은 클래스 수를 포괄적으로 설정할지 세분화할지 결정하는 것입니다. 여기서 '수'는 관심 있는 개별 클래스의 개수를 의미합니다. 이 결정은 데이터의 세분성과 모델의 복잡도에 영향을 줍니다. 각 접근 방식에서 고려할 사항은 다음과 같습니다.
- 포괄적인 클래스 구성: "차량" 및 "비차량"과 같이 더 넓고 포괄적인 범주를 사용합니다. 어노테이션을 단순화하고 컴퓨팅 리소스를 덜 사용하지만, 정보의 세부 수준이 낮아 복잡한 상황에서 모델의 효과가 제한될 수 있습니다.
- 세분화된 클래스 구성: "세단", "SUV", "픽업트럭", "오토바이"와 같이 더 많은 범주를 사용하고 구분을 세밀하게 합니다. 더 자세한 정보를 포착해 모델의 정확도와 성능을 높일 수 있습니다. 그러나 어노테이션에 시간과 노동력이 더 많이 들고 컴퓨팅 리소스도 더 많이 필요합니다.
더 구체적인 클래스로 시작하면 세부 정보가 중요한 복잡한 프로젝트에서 특히 유용할 수 있습니다. 구체적인 클래스를 사용하면 더 상세한 데이터를 수집하고, 더 깊이 있는 인사이트를 얻으며, 범주 간 차이를 명확히 설정할 수 있습니다. 모델의 정확도를 높일 뿐 아니라 필요할 때 나중에 모델을 더 쉽게 조정할 수 있어 시간과 리소스를 모두 절약할 수 있습니다.
데이터 출처#
공개 데이터셋을 사용하거나 직접 사용자 지정 데이터를 수집할 수 있습니다. Kaggle 및 Google Dataset Search Engine과 같은 공개 데이터셋은 어노테이션이 잘 되어 있고 표준화된 데이터를 제공하므로 모델 학습과 검증을 시작하기에 좋습니다.
반면 사용자 지정 데이터를 수집하면 특정 요구 사항에 맞게 데이터셋을 구성할 수 있습니다. 카메라나 드론으로 이미지와 동영상을 촬영하거나, 웹에서 이미지를 수집하거나, 조직의 기존 내부 데이터를 사용할 수 있습니다. 사용자 지정 데이터를 사용하면 품질과 관련성을 더 잘 관리할 수 있습니다. 공개 데이터와 사용자 지정 데이터를 결합하면 다양하고 포괄적인 데이터셋을 만들 수 있습니다.
데이터 수집 시 편향 방지#
데이터셋에서 특정 그룹이나 상황이 과소 또는 과대 대표될 때 편향이 발생합니다. 이로 인해 일부 데이터에서는 성능이 좋지만 다른 데이터에서는 성능이 떨어지는 모델이 만들어집니다. 컴퓨터 비전 모델이 다양한 상황에서 잘 작동하도록 AI 편향을 방지하는 것이 중요합니다.
데이터 수집 중 편향을 방지하는 방법은 다음과 같습니다.
- 다양한 출처: 여러 출처에서 데이터를 수집해 다양한 관점과 상황을 포착합니다.
- 균형 잡힌 대표성: 관련된 모든 그룹이 균형 있게 대표되도록 합니다. 예를 들어 다양한 연령, 성별, 인종을 고려합니다.
- 지속적인 모니터링: 새로운 편향이 발생하는지 정기적으로 데이터셋을 검토하고 업데이트합니다.
- 편향 완화 기법: 과소 대표된 클래스의 오버샘플링, 데이터 증강, 공정성을 고려한 알고리즘 등의 방법을 사용합니다.
이러한 방식을 따르면 실제 애플리케이션에서 잘 일반화할 수 있는 더 견고하고 공정한 모델을 만드는 데 도움이 됩니다.
데이터 어노테이션이란 무엇인가요?#
데이터 어노테이션은 머신러닝 모델 학습에 데이터를 사용할 수 있도록 레이블을 지정하는 과정입니다. 컴퓨터 비전에서는 모델이 학습하는 데 필요한 정보를 이미지나 동영상에 표시하는 것을 의미합니다. 데이터에 적절한 어노테이션이 없으면 모델은 입력과 출력 사이의 관계를 정확하게 학습할 수 없습니다.
데이터 어노테이션 유형#
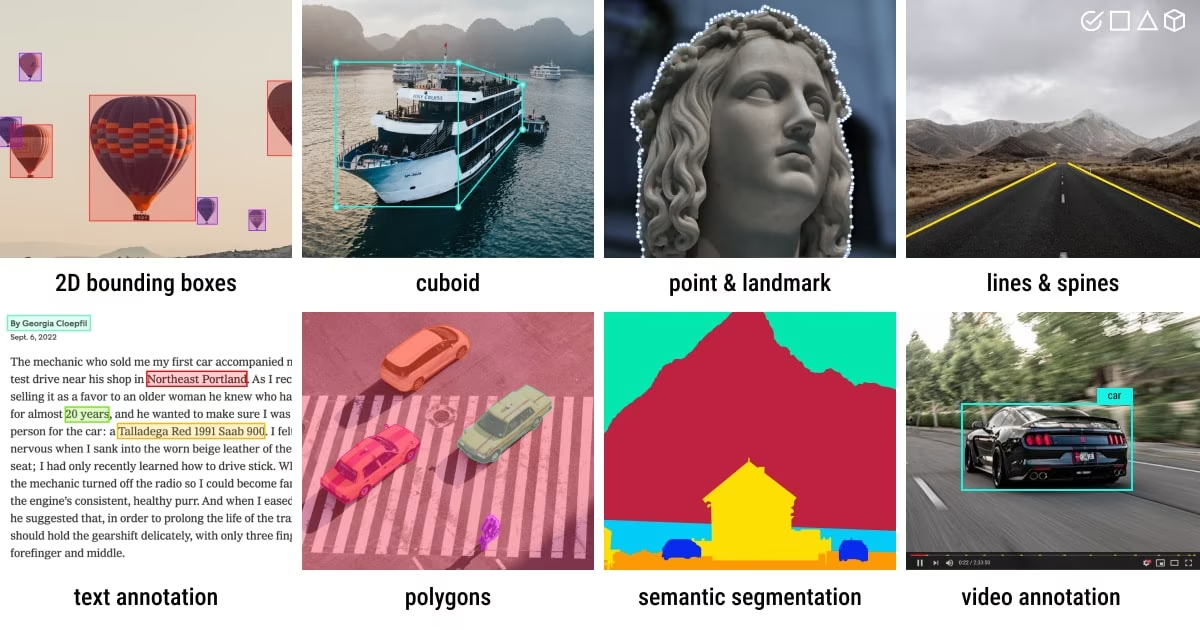
컴퓨터 비전 작업의 구체적인 요구 사항에 따라 다양한 유형의 데이터 어노테이션을 사용할 수 있습니다. 몇 가지 예는 다음과 같습니다.
- 바운딩 박스: 이미지 속 객체 주위에 그리는 직사각형 박스로, 주로 객체 탐지 작업에 사용됩니다. 박스는 좌측 상단과 우측 하단 좌표로 정의됩니다.
- 폴리곤: 객체의 윤곽을 세밀하게 표시하며, 바운딩 박스보다 더 정밀한 어노테이션을 제공합니다. 폴리곤은 객체의 모양이 중요한 인스턴스 세그멘테이션과 같은 작업에 사용됩니다.
- 마스크: 각 픽셀이 객체 또는 배경에 속하는지 나타내는 이진 마스크입니다. 마스크는 픽셀 단위의 세부 정보를 제공하기 위해 시맨틱 세그멘테이션 작업에서 사용됩니다.
- 키포인트: 관심 위치를 식별하기 위해 이미지에 표시하는 특정 지점입니다. 키포인트는 포즈 추정 및 얼굴 랜드마크 탐지와 같은 작업에 사용됩니다.
- 방향성 바운딩 박스: 회전 각도가 포함된 직사각형으로, 항공 이미지처럼 객체가 임의의 방향으로 나타나는 OBB 작업에 사용됩니다.
일반적인 어노테이션 형식#
어노테이션 유형을 선택한 후에는 어노테이션을 저장하고 공유할 적절한 형식을 선택해야 합니다. 가장 일반적인 형식은 다음과 같습니다.
| 형식 | 파일 구조 | 주요 사용 사례 |
|---|---|---|
| COCO | 단일 JSON 파일 | 객체 탐지, 인스턴스 세그멘테이션, 키포인트 탐지, 스터프 및 파노픽 세그멘테이션, 이미지 캡셔닝 |
| Pascal VOC | 이미지당 XML 파일 하나 | 객체 탐지 |
| YOLO | 이미지당 .txt 파일 하나 | 객체 탐지, 세그멘테이션, 포즈 및 방향성 박스 |
YOLO 형식은 객체당 한 행을 저장하며, 클래스 인덱스는 0부터 시작합니다. 객체 탐지 행은 정규화된 0–1 좌표를 사용하는 class x_center y_center width height입니다. 세그멘테이션 행에서는 박스 대신 객체의 정규화된 폴리곤 점을 사용합니다. 포즈 행은 박스를 유지하고 그 뒤에 키포인트 좌표를 추가하며, 데이터셋에서 kpt_shape: [n, 3]를 선언한 경우 각 키포인트에 가시성 플래그를 포함합니다. OBB 행은 정규화된 모서리 좌표를 사용해 class x1 y1 x2 y2 x3 y3 x4 y4을 저장합니다.
어노테이션 도구에서 COCO JSON을 내보내는 경우 YOLO .txt 레이블로 변환하거나 사용자 지정 데이터셋 클래스를 사용해 JSON으로 직접 학습할 수 있습니다.
어노테이션 가이드라인 설정#
어노테이션 유형과 형식을 선택한 다음에는 명확하고 객관적인 레이블링 규칙을 세워야 합니다. 이러한 규칙은 어노테이션 과정 전반에서 일관성과 정확도를 유지하기 위한 지침이 됩니다. 주요 규칙은 다음과 같습니다.
- 명확성과 세부 정보: 지침이 명확한지 확인합니다. 기대하는 결과를 보여 주는 예시와 그림을 사용합니다.
- 일관성: 어노테이션을 균일하게 유지합니다. 여러 유형의 데이터에 어노테이션을 적용하기 위한 표준 기준을 설정해 모든 어노테이션이 동일한 규칙을 따르도록 합니다.
- 편향 줄이기: 중립적인 태도를 유지합니다. 공정한 어노테이션을 위해 객관성을 갖추고 개인적인 편향을 최소화하도록 스스로 훈련합니다.
- 효율성: 더 열심히 하기보다 더 효율적으로 작업합니다. 반복 작업을 자동화하는 도구와 워크플로를 사용해 어노테이션을 더 빠르고 효율적으로 진행합니다.
레이블링 규칙을 정기적으로 검토하고 업데이트하면 어노테이션의 정확성과 일관성을 유지하고 프로젝트 목표에 부합하도록 관리할 수 있습니다.
어노테이션 도구#
좋은 어노테이션 도구는 작업에 필요한 모든 유형의 레이블링을 지원하고, 일관된 가이드라인을 적용하며, 학습에 바로 사용할 수 있는 형식으로 레이블을 내보냅니다. Ultralytics Platform은 탐지, 인스턴스 세그멘테이션, 시맨틱 세그멘테이션, 분류, 포즈, OBB를 지원하는 기본 제공 어노테이션 편집기를 제공하며, 클릭 한 번으로 탐지, 인스턴스 세그멘테이션, 시맨틱 세그멘테이션, OBB 작업에 사용할 마스크를 생성하는 SAM 기반 스마트 어노테이션도 지원합니다. 어노테이션은 각 작업에 필요한 레이아웃, 즉 공간 작업에는 YOLO .txt 행, 분류에는 클래스 폴더로 저장되므로 변환 과정 없이 레이블이 지정된 데이터셋을 바로 학습에 사용할 수 있습니다.
어노테이션 품질: 정확도, 정밀도 및 이상치#
대규모로 어노테이션을 시작하기 전에 정확도, 정밀도, 이상치, 품질 관리를 이해하면 데이터에 역효과를 낳는 방식으로 레이블을 지정하는 일을 방지할 수 있습니다.
정확도와 정밀도 이해하기#
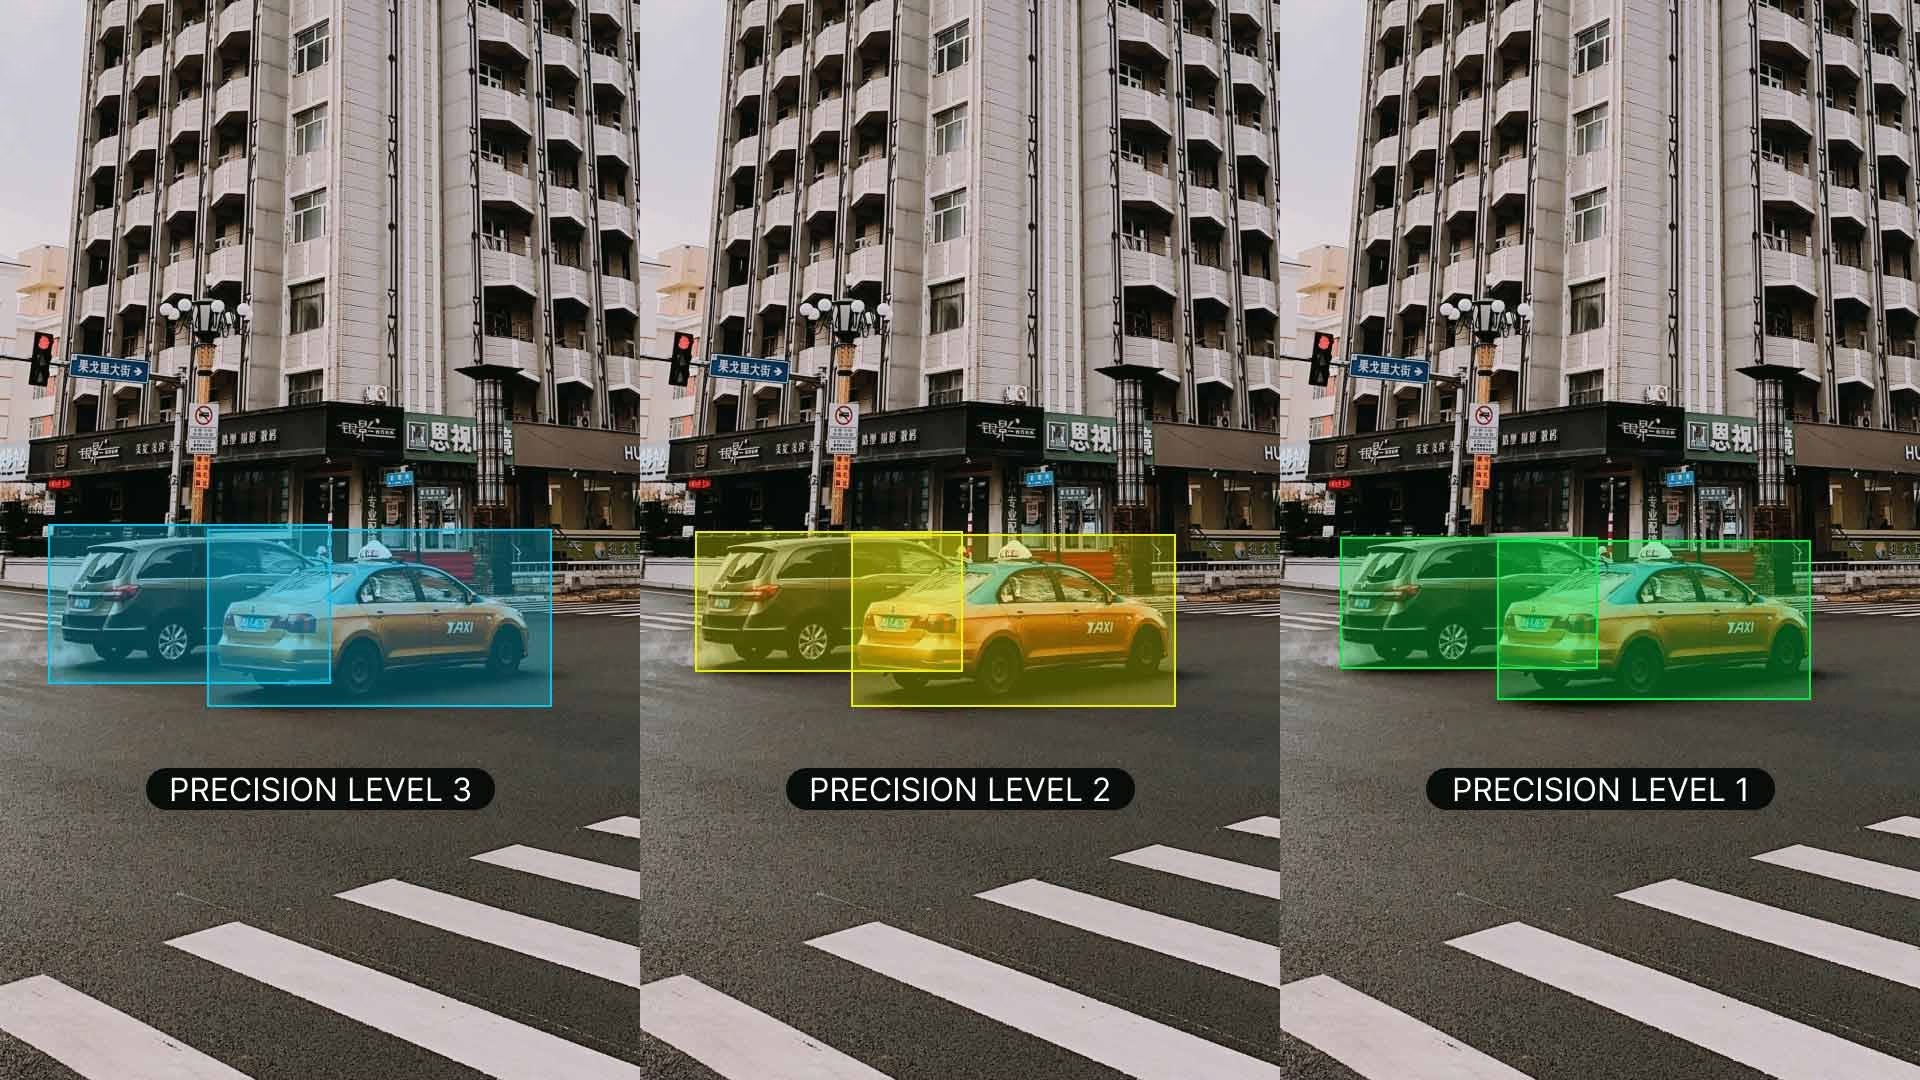
정확도와 정밀도의 차이, 그리고 이 차이가 어노테이션과 어떤 관련이 있는지 이해하는 것이 중요합니다. 정확도는 어노테이션된 데이터가 실제 값에 얼마나 가까운지를 나타내며, 레이블이 실제 상황을 얼마나 잘 반영하는지 측정하는 데 도움이 됩니다. 정밀도는 어노테이션의 일관성을 나타냅니다. 데이터셋 전반에서 동일한 객체나 특징에 같은 레이블을 지정하는지 확인합니다. 정확도와 정밀도가 높으면 노이즈가 줄고 모델의 학습 데이터 일반화 능력이 향상되어 모델 학습 성능이 좋아집니다.
이상치 식별하기#
이상치는 데이터셋의 다른 관측값과 크게 차이가 나는 데이터 포인트입니다. 어노테이션에서 이상치는 레이블이 잘못 지정된 이미지나 데이터셋의 다른 항목과 맞지 않는 어노테이션일 수 있습니다. 이상치는 모델의 학습 과정을 왜곡하여 부정확한 예측과 낮은 일반화 성능을 초래할 수 있으므로 주의해야 합니다.
다양한 방법으로 이상치를 감지하고 수정할 수 있습니다.
- 통계적 기법: 픽셀 값, 바운딩 박스 좌표, 객체 크기와 같은 수치형 특징의 이상치를 감지하려면 상자 그림, 히스토그램, z 점수 등의 방법을 사용할 수 있습니다.
- 시각적 기법: 객체 클래스, 색상, 모양과 같은 범주형 특징의 이상을 찾으려면 이미지, 레이블, 히트맵을 그려 보는 등의 시각적 방법을 사용합니다.
- 알고리즘 기법: 클러스터링(K-means 클러스터링, DBSCAN 등)과 이상 탐지 알고리즘 같은 도구를 사용해 데이터 분포 패턴을 기반으로 이상치를 식별합니다.
어노테이션된 데이터의 품질 관리#
다른 기술 프로젝트와 마찬가지로 어노테이션된 데이터에도 품질 관리가 필수입니다. 어노테이션의 정확성과 일관성을 확인하기 위해 정기적으로 검토하는 것이 좋습니다. 다음과 같은 방법으로 검토할 수 있습니다.
- 어노테이션된 데이터 샘플 검토
- 자동화 도구를 사용해 일반적인 오류 감지
- 다른 사람에게 어노테이션 재확인 요청
여러 명이 함께 작업하는 경우 어노테이터 간의 일관성이 중요합니다. 어노테이터 간 일치도가 높으면 가이드라인이 명확하고 모두가 같은 방식으로 따르고 있다는 뜻입니다. 이는 모두가 같은 기준을 공유하고 어노테이션의 일관성을 유지하는 데 도움이 됩니다.
검토 중 오류를 발견하면 수정하고 가이드라인을 업데이트해 같은 문제가 반복되지 않도록 합니다. 오류를 줄일 수 있도록 어노테이터에게 피드백을 제공하고 정기적인 교육을 실시합니다. 오류를 처리하는 절차를 확립하면 데이터셋의 정확성과 신뢰성을 유지할 수 있습니다.
효율적인 데이터 라벨링 전략#
데이터 라벨링 프로세스를 원활하고 효과적으로 진행하려면 다음 전략을 도입해 보세요.
- 명확한 어노테이션 가이드라인: 모든 어노테이터가 작업을 일관되게 해석할 수 있도록 예시를 포함한 자세한 지침을 제공하세요. 예를 들어 새를 라벨링할 때 새 전체를 포함할지 특정 부위만 포함할지 명시하세요.
- 정기적인 품질 검사: 기준을 설정하고 특정 지표를 사용해 작업을 검토하며, 지속적인 피드백을 통해 높은 품질 기준을 유지하세요.
- 사전 어노테이션 도구 사용: 최신 어노테이션 플랫폼 중 상당수는 AI 지원 사전 어노테이션 기능을 제공합니다. 이 기능은 초기 어노테이션을 자동으로 생성하고 사람이 다듬을 수 있게 해 프로세스 속도를 크게 높여 줍니다.
- 액티브 러닝 도입: 이 접근 방식은 정보량이 가장 많은 샘플부터 라벨링하도록 우선순위를 지정하므로, 모델 성능을 유지하면서 필요한 전체 어노테이션 수를 줄일 수 있습니다.
- 배치 처리: 유사한 이미지를 그룹으로 묶어 어노테이션하면 일관성을 유지하고 효율성을 높일 수 있습니다.
이러한 전략은 라벨링 프로세스에 필요한 시간과 리소스를 줄이면서도 어노테이션의 높은 품질을 유지하는 데 도움이 됩니다.
결론#
다양하고 편향되지 않은 데이터를 수집하고 적절한 도구를 사용해 일관되게 어노테이션하는 것은 신뢰할 수 있는 컴퓨터 비전 모델의 기반입니다. 데이터셋을 수집하고 라벨링한 후에는 컴퓨터 비전 프로젝트 단계 가이드에 따라 학습과 평가를 진행하세요. 진행 중 궁금한 점이 있으면 Ultralytics GitHub 리포지토리 또는 Ultralytics Discord 서버에서 커뮤니티에 문의하세요.
자주 묻는 질문#
편향을 최소화하려면 다양한 출처에서 데이터를 수집하고, 관련된 모든 그룹(예: 연령, 성별, 인종이 다른 사람들)이 균형 있게 포함되도록 하며, 새롭게 나타나는 편향을 파악하기 위해 데이터셋을 정기적으로 검토하고 업데이트하세요. 또한 과소 대표된 클래스의 오버샘플링, 데이터 증강, 공정성을 고려한 알고리즘 등의 완화 기법을 적용하세요. 이러한 방식으로 편향을 방지하면 다양한 실제 시나리오에서 컴퓨터 비전 모델이 우수한 성능을 발휘하고 일반화 성능을 높일 수 있습니다.
자세한 지침과 예시, 그림을 포함한 명확하고 객관적인 라벨링 가이드라인을 수립한 다음 모든 데이터 유형에 동일하게 적용하여 모든 어노테이션이 같은 규칙을 따르도록 하세요. 어노테이터가 개인적 편향을 줄이고 중립적인 태도를 유지하도록 교육하고, 가이드라인을 정기적으로 검토하고 업데이트하세요. 또한 자동 일관성 검사와 어노테이터 간 피드백을 활용해 정확도를 높이고 프로젝트 목표에 부합하도록 유지하세요.
클래스당 어노테이션된 객체 수백 개면 전이 학습을 실험하기에 충분하지만, 신뢰할 수 있는 실제 환경 성능을 위해 Ultralytics는 클래스당 최소 이미지 1,500장과 라벨링된 인스턴스 10,000개를 권장합니다. 충분히 큰 데이터셋에 적절한 학습 일정을 적용하세요. 일반적인 시작점은 약 300 에포크이며, 모델이 조기에 과적합되면 에포크 수를 줄이면 됩니다. 어노테이션은 엄격하게 수행하고 프로젝트의 구체적인 목표에 맞추세요. 자세한 학습 전략은 YOLO26 학습 가이드를 참조하세요.
예. Ultralytics Platform에는 바운딩 박스, 폴리곤, 키포인트, 방향성 박스, 분류 라벨을 하나의 작업 공간에서 지원하는 내장 어노테이션 편집기가 포함되어 있습니다. SAM 기반 스마트 어노테이션은 클릭 한 번으로 마스크를 생성하여 객체 탐지, 인스턴스 분할, 시맨틱 분할, OBB 작업의 라벨링 속도를 높입니다. 포즈 데이터셋은 YOLO 포즈 모델을 스마트 어노테이션에 사용할 수 있으며, 분류는 수동으로 어노테이션합니다. 어노테이션은 각 작업에 필요한 형식으로 저장되므로 공간 작업은 YOLO
.txt행에, 분류는 클래스 폴더에 저장되어 바로 학습에 사용할 수 있습니다.