COCO128 데이터셋#
소개#
Ultralytics COCO128은 COCO train 2017 세트의 처음 128개 이미지로 구성된 작지만 다용도로 활용할 수 있는 객체 감지 데이터셋입니다. 이 데이터셋은 객체 감지 모델을 테스트하고 디버깅하거나 새로운 감지 접근 방식을 실험하는 데 적합합니다. 이미지가 128개뿐이라 관리하기 쉽고, 다양한 이미지가 포함되어 있어 학습 파이프라인의 오류를 확인하고 대규모 데이터셋으로 학습하기 전에 정상 동작 여부를 검증할 수 있습니다.
시청: Ultralytics COCO 데이터셋 개요
이 데이터셋은 Ultralytics Platform 및 YOLO26과 함께 사용하도록 설계되었습니다.
데이터셋 구조#
COCO128에는 COCO train 2017 세트의 처음 128개 이미지가 포함되어 있으며, 80개의 COCO 클래스 이름(이 중 71개가 이미지에 나타남)으로 라벨링되어 있습니다(YOLO 라벨 형식). 동일한 128개 이미지가 학습 및 검증 분할에 모두 사용되어 빠른 정상 동작 확인에 적합하도록 데이터셋을 가볍게 유지합니다:
coco128/
├── images/
│   └── train2017/   # 128 images (used for both train and val)
└── labels/
    └── train2017/
데이터셋 YAML#
YAML 파일을 사용해 데이터셋 구성을 정의합니다. 이 파일에는 데이터셋 경로, 클래스 및 기타 관련 정보가 포함됩니다. COCO128 데이터셋의 경우, coco128.yaml 파일은 https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128.yaml에 유지 관리됩니다.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128 dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco128
# Example usage: yolo train data=coco128.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128 ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128 # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128.zip사용법#
COCO128 데이터셋(7 MB)은 학습을 처음 시작할 때 자동으로 다운로드됩니다. 이미지 크기 640으로 COCO128에서 YOLO26n 모델을 100 에포크 동안 학습하려면 다음 코드 예제를 사용할 수 있습니다. 사용 가능한 인수 전체 목록은 모델 학습 페이지를 참조하세요.
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).

# 모델 학습
results = model.train(data="coco128.yaml", epochs=100, imgsz=640)
샘플 이미지 및 어노테이션#
다음은 COCO128 데이터셋의 이미지와 해당 어노테이션 예시입니다:
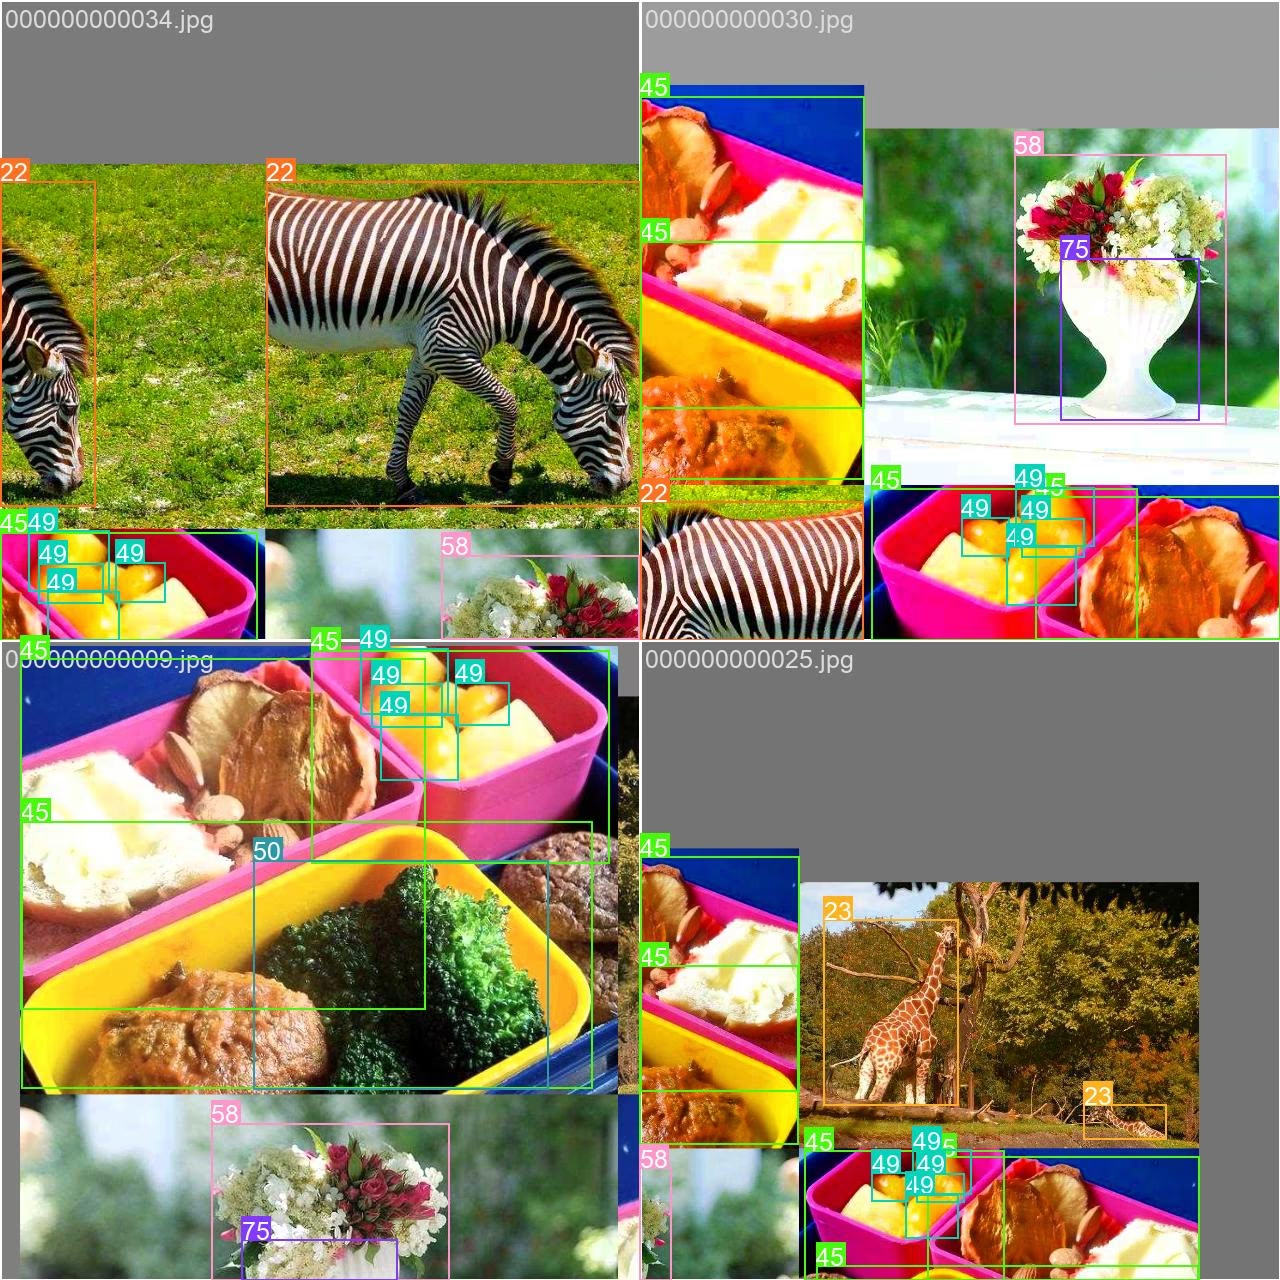
- 모자이크 이미지: 이 이미지는 모자이크 처리된 데이터셋 이미지로 구성된 학습 배치를 보여줍니다. 모자이크 처리는 학습 중 여러 이미지를 하나의 이미지로 결합해 각 학습 배치에 포함되는 객체와 장면의 다양성을 높이는 기법입니다. 이 기법은 모델이 다양한 객체 크기, 종횡비 및 맥락에 일반화하는 능력을 향상하는 데 도움이 됩니다.
이 예시에서는 COCO128 데이터셋 이미지의 다양성과 복잡성, 그리고 학습 과정에서 모자이크를 사용하는 이점을 확인할 수 있습니다.
인용 및 감사의 글#
연구 또는 개발 작업에서 COCO 데이터셋을 사용하는 경우 다음 논문을 인용해 주세요:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
컴퓨터 비전 커뮤니티를 위한 이 귀중한 리소스를 만들고 유지 관리해 주신 COCO Consortium에 감사드립니다. COCO 데이터셋과 제작자에 대한 자세한 내용은 COCO 데이터셋 웹사이트를 방문하세요.
자주 묻는 질문#
Ultralytics COCO128 데이터셋은 COCO train 2017 데이터셋의 처음 128개 이미지로 구성된 소규모 하위 집합입니다. 주로 객체 감지 모델을 테스트하고 디버깅하거나, 새로운 감지 접근 방식을 실험하고, 더 큰 데이터셋으로 확장하기 전에 학습 파이프라인을 검증하는 데 사용됩니다. 관리하기 쉬운 크기 덕분에 빠르게 반복 작업을 수행할 수 있으며, 의미 있는 테스트 사례가 될 만큼 충분한 다양성도 제공합니다.
COCO128 데이터셋에서 YOLO26 모델을 학습하려면 Python 또는 CLI 명령을 사용할 수 있습니다. 방법은 다음과 같습니다:
학습 예제from ultralytics import YOLO # 사전 학습된 모델 불러오기 model = YOLO("yolo26n.pt") # 모델 학습 results = model.train(data="coco128.yaml", epochs=100, imgsz=640)더 많은 학습 옵션과 매개변수는 학습 문서를 참조하세요.
샘플 이미지에 표시된 것처럼 모자이크 증강은 여러 학습 이미지를 하나의 합성 이미지로 결합합니다. COCO128로 학습할 때 이 기법을 사용하면 다음과 같은 이점이 있습니다:
- 각 학습 배치에 포함되는 객체와 배경의 다양성을 높입니다.
- 다양한 객체 크기와 종횡비에 대한 모델의 일반화 성능을 향상합니다.
- 다양한 크기의 객체에 대한 감지 성능을 높입니다.
- 더 다양한 학습 샘플을 생성해 소규모 데이터셋의 활용도를 극대화합니다.
이 기법은 COCO128과 같은 소규모 데이터셋에서 특히 유용하며, 제한된 데이터로 모델이 더 견고한 특징을 학습하도록 돕습니다.
크기 면에서 COCO128(이미지 128개)은 COCO8(이미지 8개)과 전체 COCO 데이터셋(이미지 118K 이상)의 중간에 해당합니다:
- COCO8: 이미지 8개(학습 4개, 검증 4개)만 포함하며, 빠른 테스트와 디버깅에 적합합니다.
- COCO128: 이미지 128개를 포함하며, 크기와 다양성이 균형을 이룹니다.
- 전체 COCO: 학습 이미지 118K개 이상을 포함하며, 포괄적이지만 많은 리소스가 필요합니다.
COCO128은 실험 및 초기 모델 개발에 활용하기 좋습니다. COCO8보다 다양성이 높으면서 전체 COCO 데이터셋보다 훨씬 관리하기 쉽습니다.