최상의 YOLOv5 학습 결과를 위한 팁
이 가이드에서는 YOLOv5로 최상의 mAP와 학습 결과를 얻는 방법을 설명합니다.
대부분의 경우 데이터셋의 규모가 충분하고 라벨이 잘 지정되어 있다면 모델이나 학습 설정을 변경하지 않아도 좋은 결과를 얻을 수 있습니다. 처음에 결과가 좋지 않다면 개선을 위한 여러 방법을 시도할 수 있지만, 변경을 고려하기 전에 먼저 모든 기본 설정으로 학습할 것을 항상 권장합니다. 이렇게 하면 성능 기준선을 마련하고 개선이 필요한 부분을 파악할 수 있습니다.
학습 결과에 관해 질문할 때 유용한 답변을 받으려면 가능한 한 많은 정보를 제공하세요. 학습 손실, 검증 손실, P, R, mAP 결과 그래프, PR 곡선, 혼동 행렬, 학습 모자이크, 테스트 결과, labels.png와 같은 데이터셋 통계 이미지가 포함됩니다. 이 파일은 모두 project/name 디렉터리(일반적으로 yolov5/runs/train/exp)에 있습니다.
다음 섹션에서는 YOLOv5 학습 결과에 영향을 미치는 주요 요인을 다룹니다.
데이터셋#
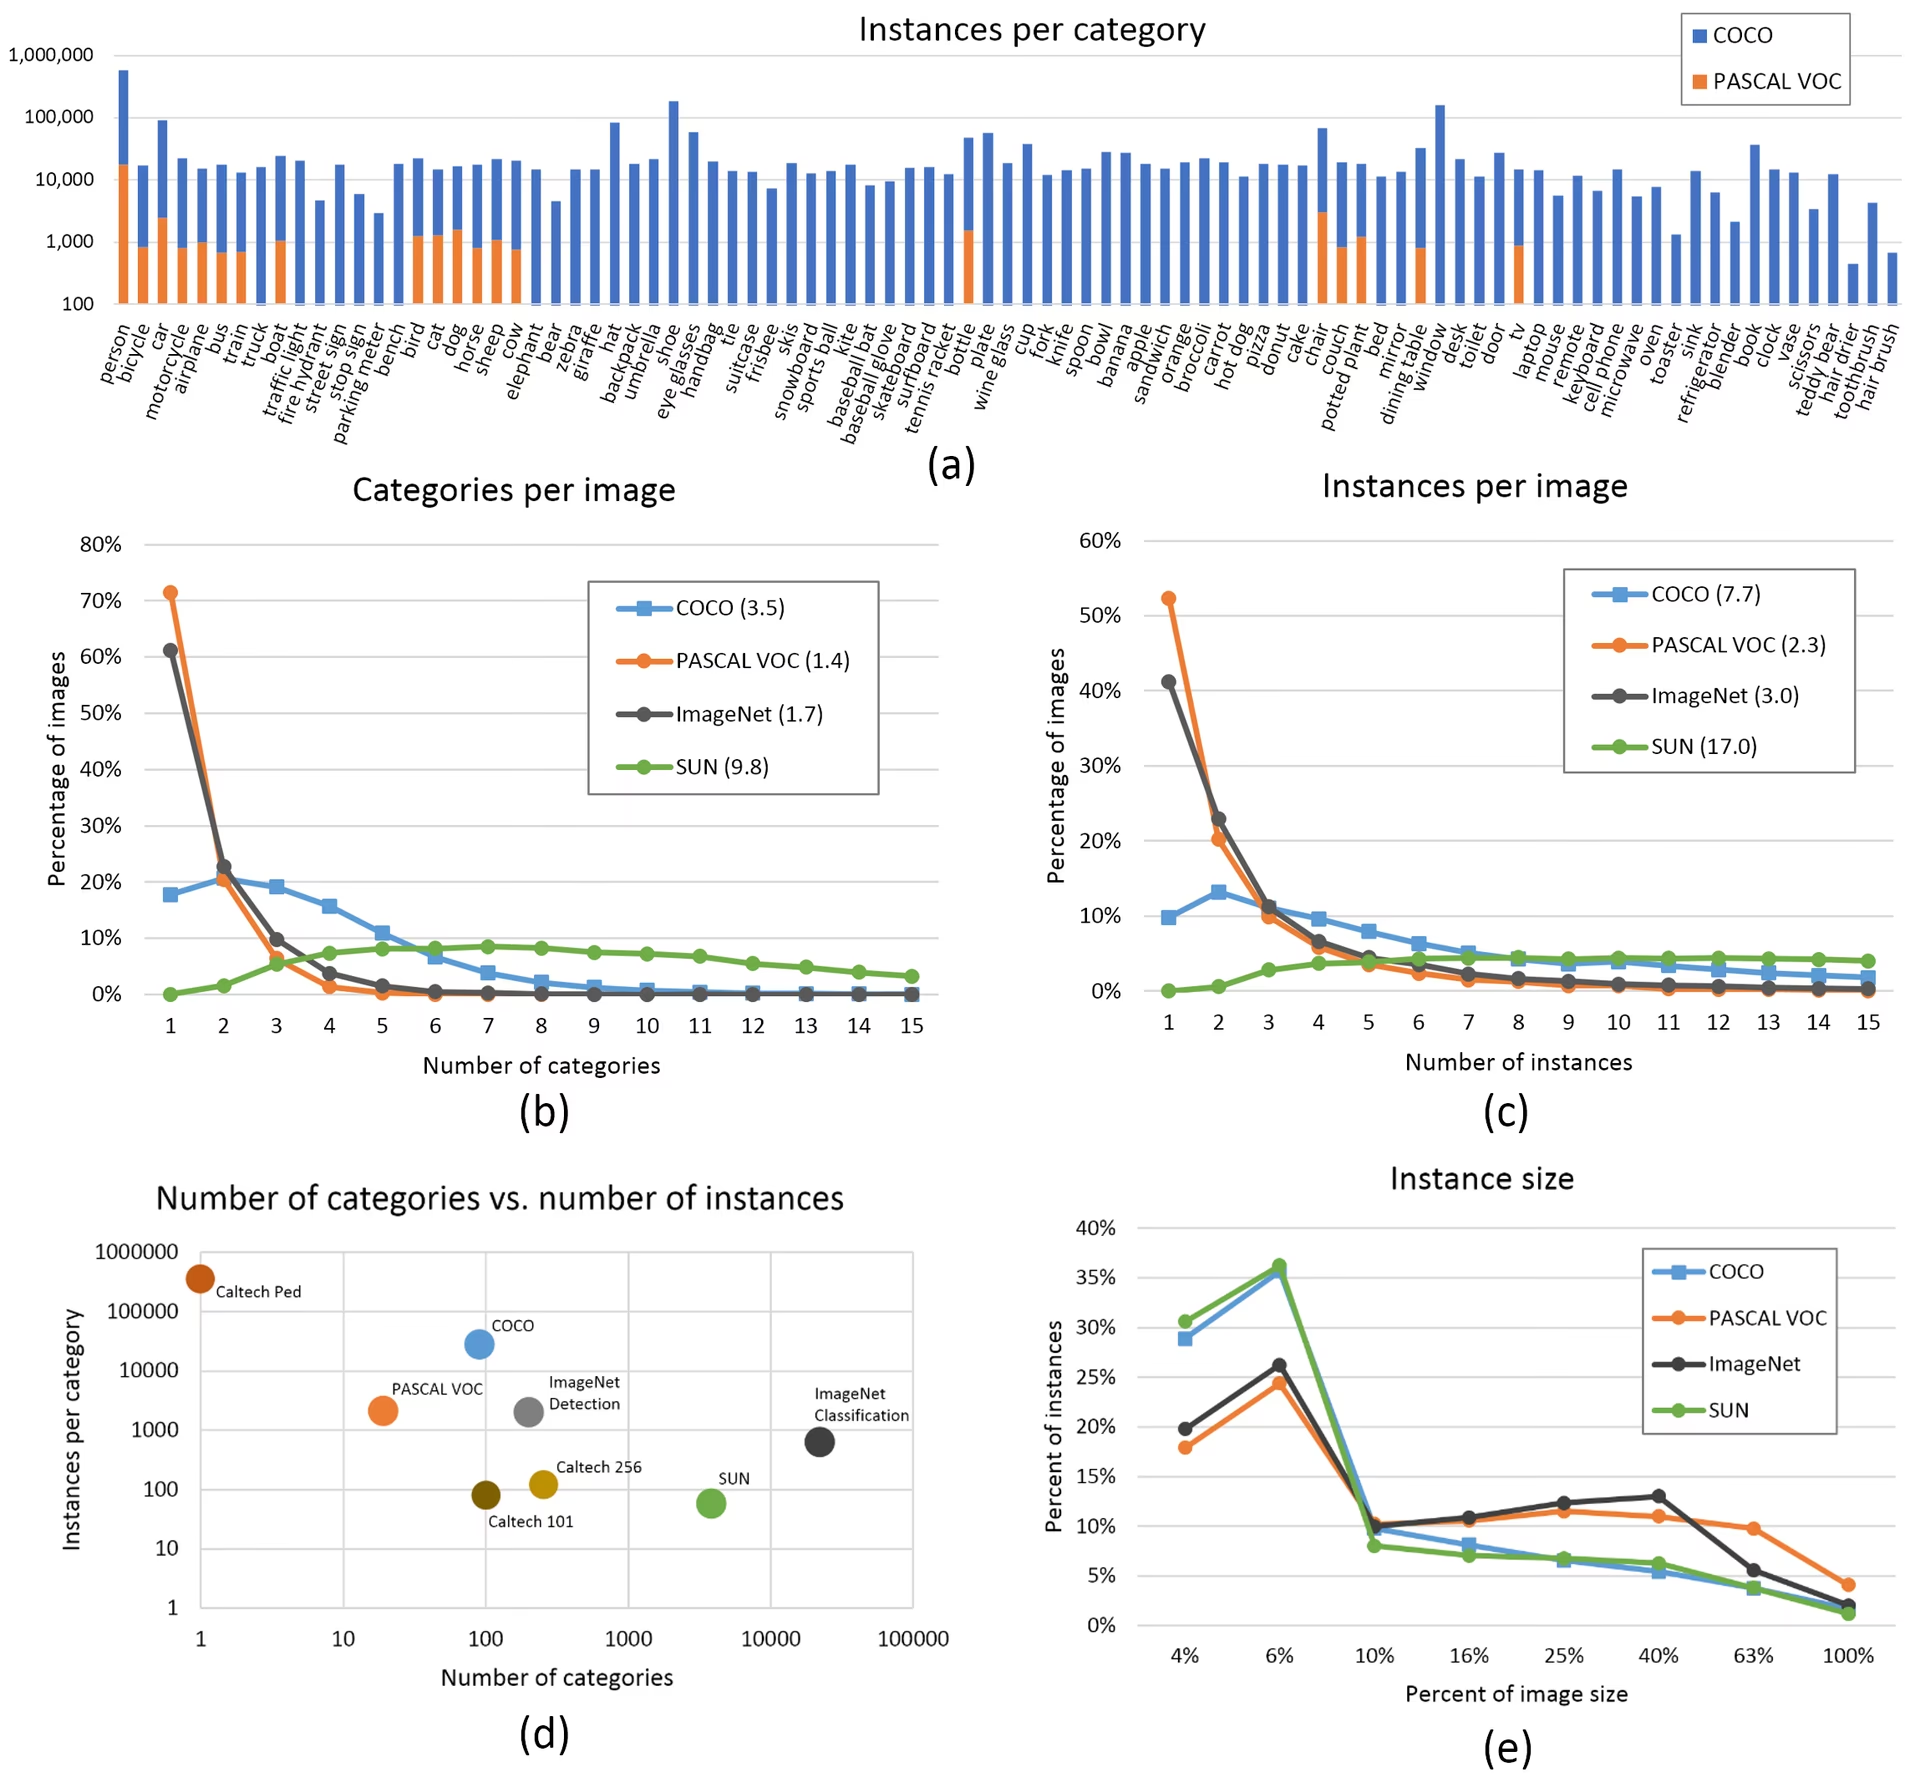
- 클래스당 이미지 수. 클래스당 이미지 1500개 이상을 권장합니다.
- 클래스당 인스턴스 수. 클래스당 인스턴스(레이블이 지정된 객체) 10000개 이상을 권장합니다.
- 이미지 다양성. 실제 배포 환경을 대표해야 합니다. 실제 사용 사례에서는 시간대, 계절, 날씨, 조명, 촬영 각도 및 출처(온라인 스크래핑, 로컬 수집, 서로 다른 카메라 등)가 다양한 이미지를 권장합니다.
- 레이블 일관성. 모든 이미지에서 모든 클래스의 모든 인스턴스에 레이블을 지정해야 합니다. 일부 인스턴스에만 레이블을 지정하면 제대로 작동하지 않습니다.
- 레이블 정확도. 레이블은 각 객체를 정확하게 둘러싸야 합니다. 객체와 해당 경계 상자 사이에 간격이 없어야 합니다. 레이블이 누락된 객체가 있어서는 안 됩니다.
- 학습/검증 분할 원칙. 지나치게 낙관적인 지표가 산출되지 않도록 검증 및 테스트 이미지는 학습 세트에 포함하지 마세요. 각 분할에서 클래스 분포를 비슷하게 유지하세요.
- 라벨 검증. 학습을 시작할 때
train_batch*.jpg모자이크를 확인해 라벨이 올바른지 검증합니다. - 배경 이미지. 배경 이미지는 False Positive(FP)를 줄이기 위해 객체가 없는 상태로 데이터셋에 추가하는 이미지입니다. FP를 줄이려면 배경 이미지를 약 0~10% 포함하는 것이 좋습니다(COCO에는 참고용으로 전체의 1%인 배경 이미지 1000개가 포함되어 있습니다). 배경 이미지에는 레이블이 필요하지 않습니다.
모델 선택#
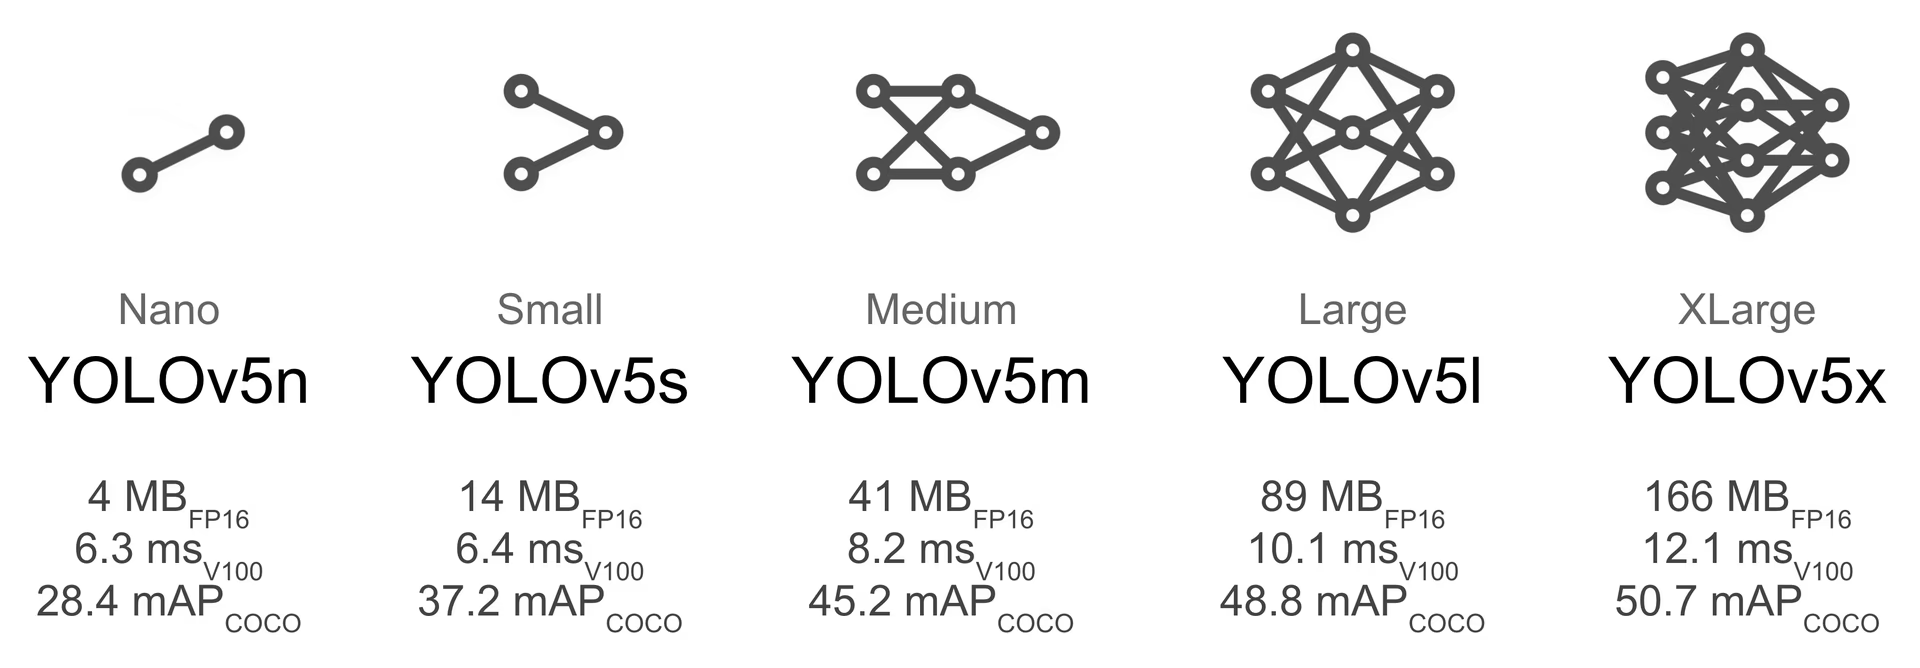
YOLOv5x와 YOLOv5x6 같은 대형 모델은 거의 모든 경우에 더 나은 결과를 내지만, 매개변수가 더 많고 학습에 더 많은 CUDA 메모리가 필요하며 실행 속도가 더 느립니다. 모바일 배포에는 YOLOv5s/m을, 클라우드 배포에는 YOLOv5l/x를 권장합니다.
-
사전 학습 가중치로 시작합니다. VOC, VisDrone, GlobalWheat와 같이 규모가 작거나 중간 정도인 데이터셋에 권장합니다. 모델 이름을
--weights인수에 전달합니다. 모델은 최신 YOLOv5 릴리스에서 자동으로 다운로드됩니다.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
처음부터 시작합니다. COCO, Objects365, OIv6와 같이 대규모 데이터셋에 권장합니다. 원하는 모델 아키텍처 YAML과 빈
--weights ''인수를 전달합니다.python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
학습 설정#
설정을 변경하기 전에 먼저 기본 설정으로 학습하여 성능 기준선을 설정하세요. train.py 설정 전체 목록은 train.py 인수 파서에서 확인할 수 있습니다.
- 에포크. 300 에포크부터 시작합니다. 조기에 과적합이 발생하면 에포크 수를 줄일 수 있습니다. 300 에포크 후에도 과적합이 발생하지 않으면 600 또는 1200 에포크 등으로 더 오래 학습합니다.
- 이미지 크기. COCO는 기본 해상도인
--img 640으로 학습하지만, 데이터셋에 작은 객체가 많으므로--img 1280과 같은 더 높은 해상도로 학습하면 효과를 볼 수 있습니다. 작은 객체가 많다면 사용자 지정 데이터셋도 기본 해상도 또는 그보다 높은 해상도로 학습하는 것이 좋습니다. 학습에 사용한 것과 동일한--img에서 추론할 때 최상의 결과를 얻습니다. 예를 들어--img 1280에서 학습했다면 테스트와 탐지도--img 1280에서 수행해야 합니다. - 배치 크기. 하드웨어가 지원하는 가장 큰
--batch-size을 사용하세요. 작은 배치 크기는 배치 정규화 통계를 저하시키므로 피해야 합니다.--batch-size -1을 사용하면 GPU에 적합한 최적 배치 크기를 자동으로 선택할 수 있습니다. - 학습률. 대부분의 경우 기본 학습률 스케줄이 잘 작동합니다. 더 빠른 수렴을 위해
--cos-lr플래그를 사용해 코사인 학습률 스케줄링을 활성화할 수 있습니다. 이 스케줄링은 에포크가 진행됨에 따라 코사인 곡선을 따라 학습률을 점진적으로 낮춥니다. - 데이터 증강. YOLOv5에는 여러 학습 이미지를 결합하는 모자이크와 같은 다양한 증강 기법이 포함되어 있습니다.
--hyp파일의mosaic하이퍼파라미터를 통해 증강 강도를 조정하여 학습을 안정화할 수 있습니다. - 하이퍼파라미터. 기본 하이퍼파라미터는 hyp.scratch-low.yaml에 있습니다. 하이퍼파라미터를 수정하기 전에 먼저 기본값으로 학습하는 것을 권장합니다. 일반적으로 증강 하이퍼파라미터를 높이면 과적합을 줄이고 늦출 수 있어 더 오래 학습하고 최종 mAP를 높일 수 있습니다.
hyp['obj']과 같은 손실 항목 이득 하이퍼파라미터를 낮추면 해당 손실 항목에서 과적합을 줄이는 데 도움이 됩니다. 이러한 하이퍼파라미터를 자동으로 최적화하는 방법은 하이퍼파라미터 진화 튜토리얼을 참조하세요. - 혼합 정밀도 학습. YOLOv5는 지원되는 GPU를 감지하면 Automatic Mixed Precision(AMP)을 자동으로 활성화하여 모델 정확도를 저하시키지 않으면서 학습 속도를 높이고 메모리 사용량을 줄입니다.
- 다중 GPU 학습. GPU가 여러 개라면
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3로 분산 데이터 병렬 학습을 시작하여 학습 시간을 크게 줄일 수 있습니다. - 조기 종료.
--patience 50을 사용하면 검증 지표가 50 에포크 동안 개선되지 않을 때 학습을 중단하여 시간을 절약하고 과적합을 방지할 수 있습니다.
고급 최적화 기법#
- 전이 학습. 특수한 데이터셋에는 사전 학습 가중치로 시작하고, 필요에 따라
--freeze를 사용해 레이어를 고정하여 특정 작업에 맞게 모델을 조정합니다. - 모델 가지치기. 학습 후 정확도 손실은 거의 없이 중복 가중치를 0으로 만드는 모델 가지치기를 고려하세요. 그런 다음 희소성을 인식하는 런타임에 배포하면 속도를 높일 수 있습니다.
- 모델 앙상블. 중요한 애플리케이션에는 구성이 서로 다른 여러 모델을 학습하고 예측을 앙상블하여 정확도를 높입니다.
- 테스트 시점 증강. 추론 시
--augment로 TTA를 활성화하면 입력 이미지의 반전 및 크기 조정 버전에서 생성한 예측을 결합하여 예측 정확도를 높일 수 있습니다.
추가 자료#
더 자세히 알고 싶다면 Karpathy의 신경망 학습을 위한 레시피를 시작점으로 삼아 보세요. 이 자료의 학습 아이디어는 다양한 ML 분야에 폭넓게 적용할 수 있습니다.
행운을 빕니다. 다른 질문이 있으시면 알려주세요.
자주 묻는 질문#
최적 배치 크기는 GPU 메모리에 따라 달라집니다. 일반적으로 배치 크기가 클수록 배치 정규화 통계가 개선되고 학습이 안정적입니다. 메모리가 부족해지지 않는 범위에서 하드웨어가 처리할 수 있는 가장 큰 배치 크기를 사용하세요.
--batch-size -1을 사용하면 설정에 적합한 최적 배치 크기를 자동으로 결정할 수 있습니다.훈련 속도를 높이려면 다음을 시도해 보세요. DDP를 사용해 여러 GPU를 활용하고,
--cache로 데이터셋을 캐시하며, 배치 크기를 최적화하세요(지원되는 GPU에서는 혼합 정밀도가 자동으로 활성화됩니다). 절대적인 정확도가 중요하지 않다면 YOLOv5s와 같은 더 작은 모델 변형을 사용하는 것도 고려해 보세요.


댓글
질문을 하거나 결과를 공유하거나 다른 사람을 도와주세요.