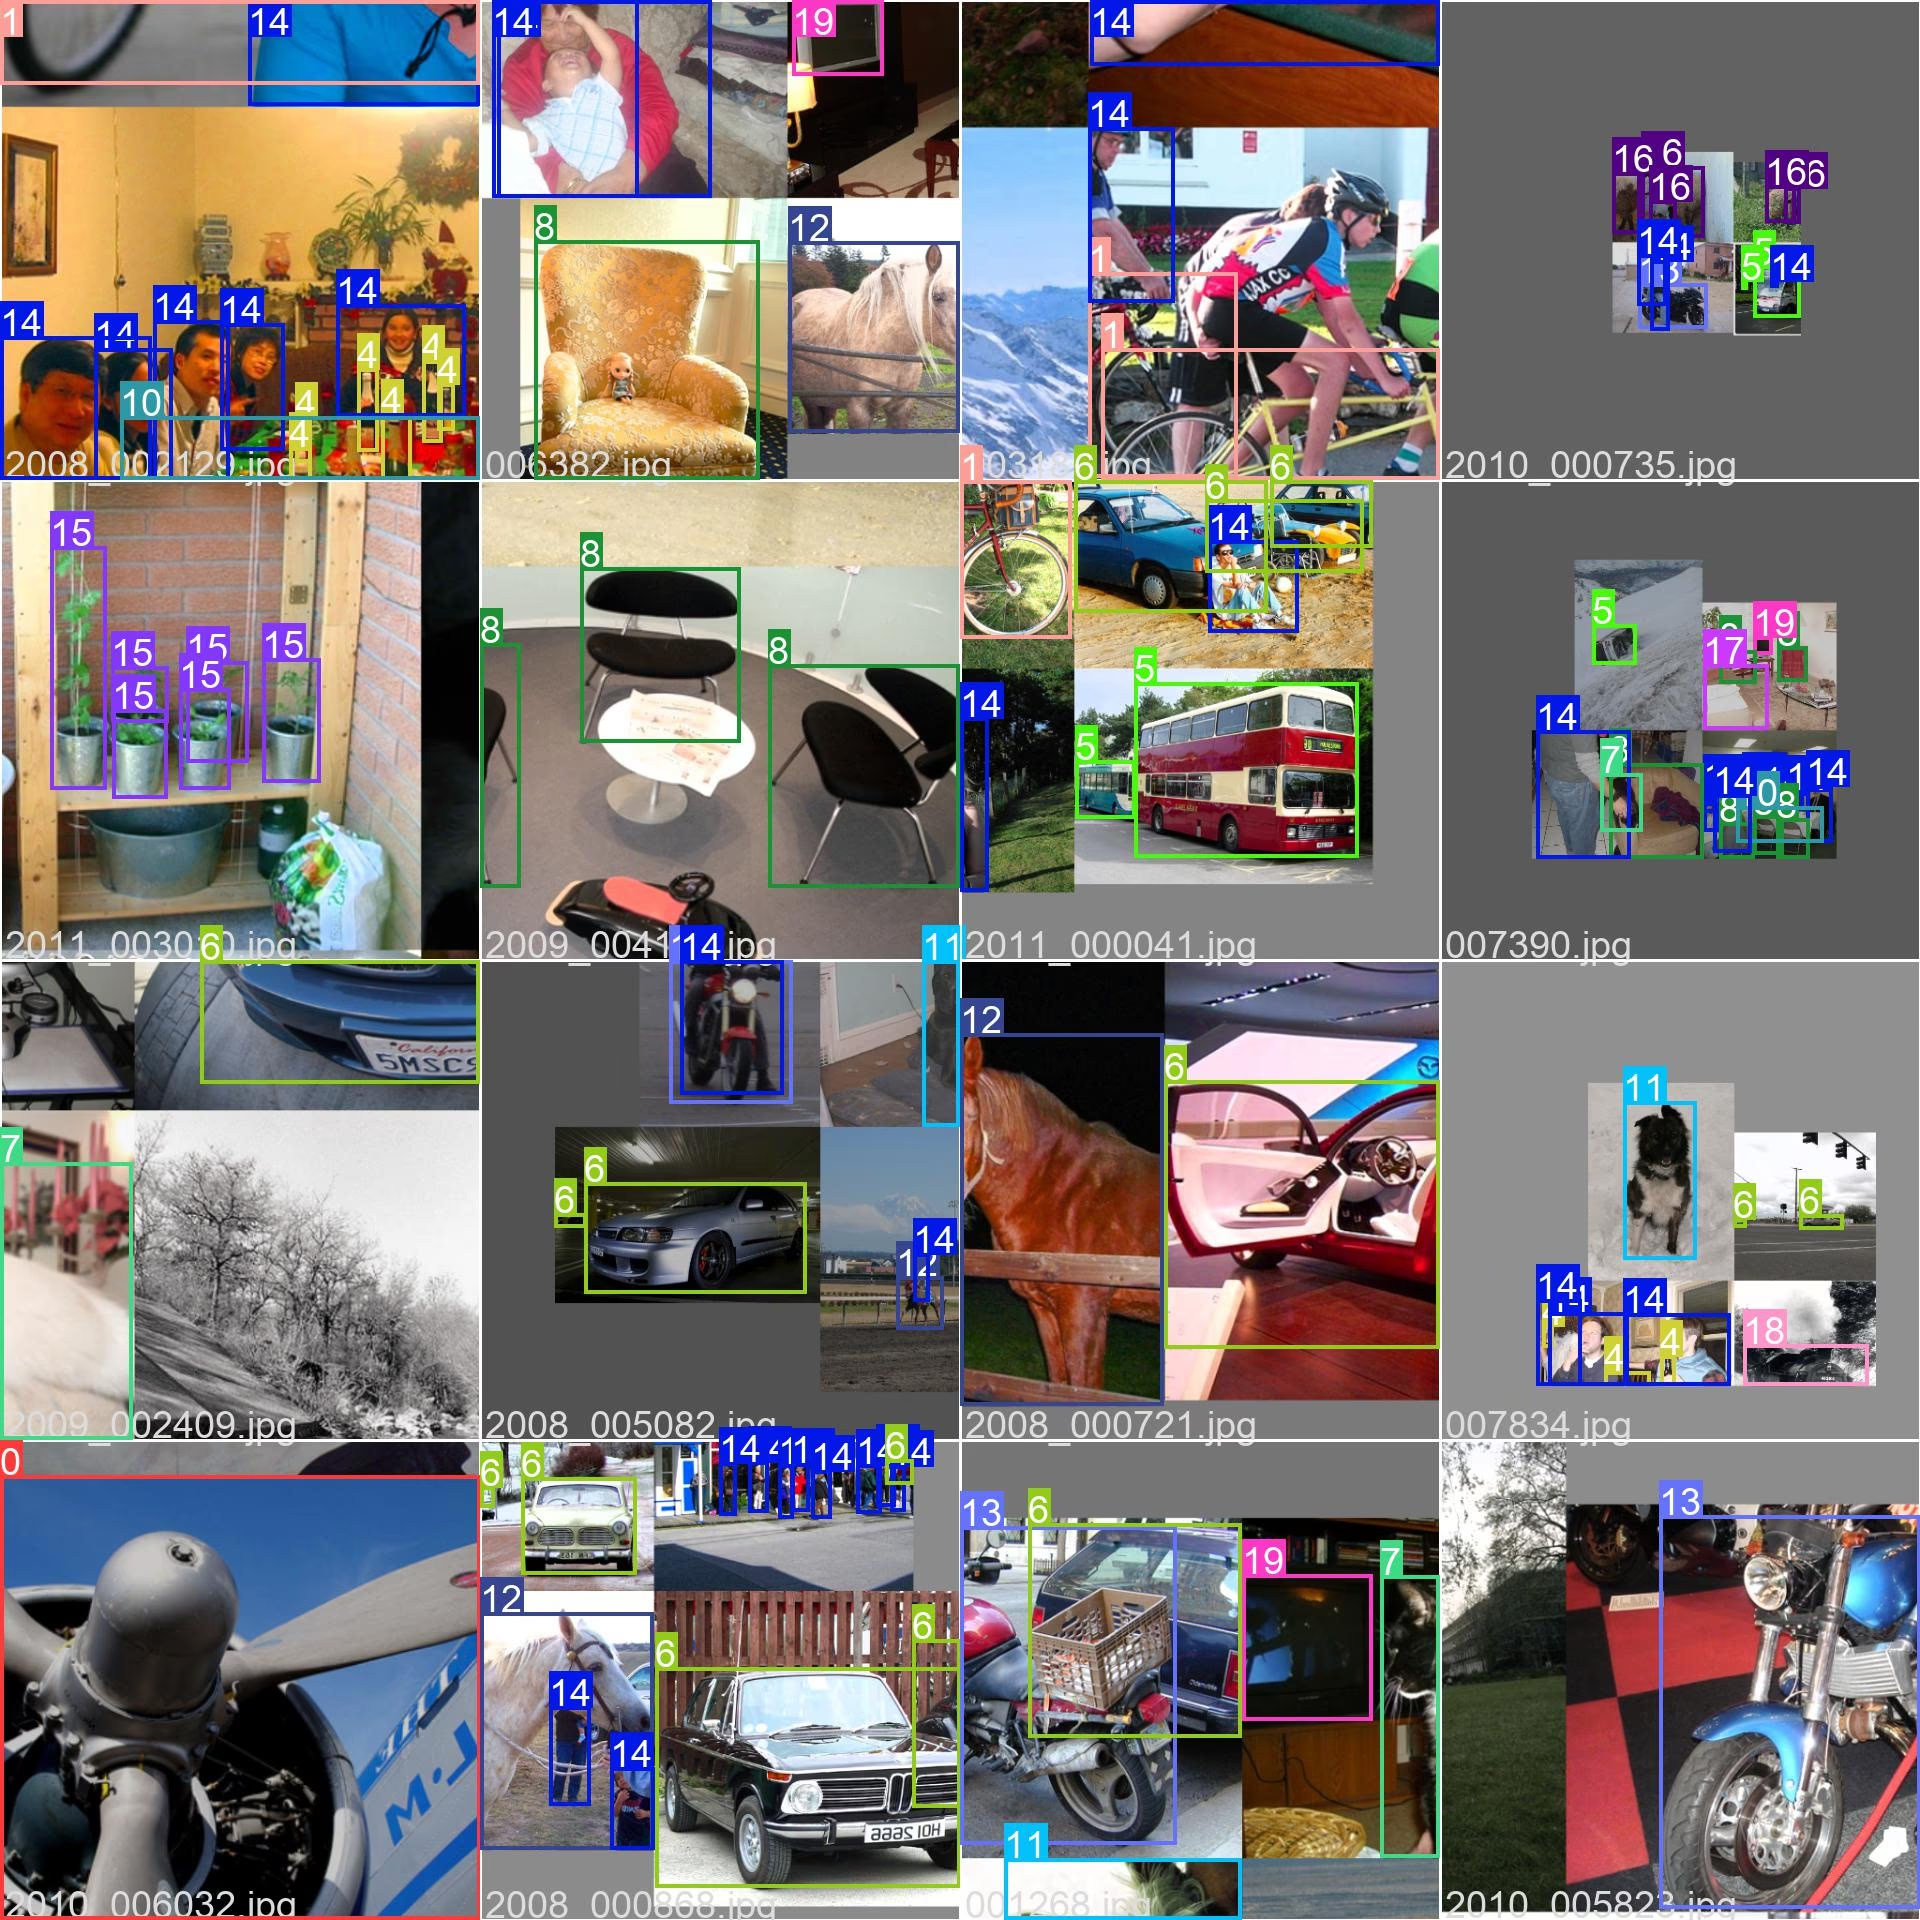
PASCAL VOC(시각 객체 클래스) 데이터셋은 20개 일상 객체 클래스를 포함하는 고전적인 객체 탐지 벤치마크입니다. Ultralytics VOC.yaml 구성은 VOC2007 및 VOC2012의 trainval 분할을 결합해 학습 이미지 16,551장으로 구성하고, 공개 어노테이션이 있는 VOC2007 테스트 이미지 4,952장으로 검증하며, 처음 사용할 때 전체 데이터(2.8GB)를 자동으로 다운로드합니다.
시청: Pascal VOC 데이터셋으로 Ultralytics YOLO를 학습하는 방법 | 객체 감지 | 컴퓨터 비전 🚀
PASCAL VOC 챌린지는 2005년부터 2012년까지 진행되었으며 객체 탐지 모델의 평가 방식을 형성했습니다. 벤치마크는 이미지 분류, 탐지, 분할 작업을 아우르며 표준 탐지 지표로 평균 정밀도(mAP)를 널리 사용하게 했습니다. Ultralytics VOC.yaml 구성은 탐지 어노테이션을 사용하며, 다운로드 과정에서 원본 XML 바운딩 박스를 YOLO 형식으로 변환합니다.
일상 객체 클래스 20개: 사람, 동물 6종(bird, cat, cow, dog, horse, sheep), 차량 7종(aeroplane, bicycle, boat, bus, car, motorbike, train), 실내 객체 6종(bottle, chair, diningtable, pottedplant, sofa, tvmonitor)입니다.
두 세대의 챌린지 결합: 학습 세트는 VOC2007 trainval(이미지 5,011장)과 VOC2012 trainval(이미지 11,540장)을 병합합니다.
표준화된 평가: 수십 년간 발표된 VOC 기준 성능 덕분에 탐지 모델을 비교할 때 편리한 기준점으로 활용할 수 있습니다.
YOLO 학습 준비 완료: 다운로드 스크립트가 아카이브를 가져오고 어노테이션을 자동으로 변환하므로 수동 준비가 필요하지 않습니다.
동일한 VOC2007 테스트 이미지입니다. 구성에 별도의 홀드아웃 분할은 정의되어 있지 않습니다.
VOC2007 테스트 어노테이션은 해당 연도 챌린지가 끝난 뒤 공개되었기 때문에 이 분할을 레이블이 있는 검증 세트로 사용할 수 있습니다. VOC2012 테스트 어노테이션은 계속 비공개로 유지되며, 공식 PASCAL 평가 서버를 통해서만 결과를 채점할 수 있으므로 이 구성에는 포함되지 않습니다.
제외된 난이도 높은 객체
자동 변환기는 원본 VOC XML 어노테이션에서 difficult으로 표시된 객체를 건너뛰므로 클래스별 인스턴스 수가 공식 VOC 통계와 약간 다릅니다.
Ultralytics Platform의 VOC를 살펴보면서 어노테이션 오버레이와 함께 이미지를 둘러보고, Charts 탭에서 클래스 분포 및 바운딩 박스 히트맵을 확인하고, 데이터셋을 복제해 클라우드에서 직접 모델을 학습할 수 있습니다.
PASCAL VOC는 더 큰 COCO 데이터셋이 등장하기 전까지 객체 탐지 연구의 주요 벤치마크였습니다. Faster R-CNN, SSD 등의 검출기가 처음 결과를 발표할 때 이 데이터셋을 사용했으며, Ultralytics YOLO 모델도 별도 설정 없이 학습할 수 있습니다. 현재도 다음 용도로 널리 사용됩니다:
오랜 기간 발표된 기준 성능과 비교해 새로운 탐지 아키텍처를 벤치마킹합니다.
빠른 실험 및 수업 과제에 활용합니다. 학습 이미지가 16,551장으로 COCO보다 훨씬 빠르게 학습됩니다.
VOC는 처음 학습할 때 자동으로 다운로드됩니다. 총 2.8GB 용량의 아카이브 3개가 다운로드되며, 압축 해제 및 변환 중에는 약 6GB의 여유 디스크 공간이 필요합니다.
다음 코드 조각을 사용하면 이미지 크기 640으로 VOC 데이터셋에서 100 에포크 동안 YOLO26n 모델을 학습할 수 있습니다.
학습 예제
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).

# 모델을 학습합니다 - 데이터셋은 첫 실행 시 자동으로 다운로드됩니다
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
컴퓨터 비전 커뮤니티를 위해 이 귀중한 리소스를 만들고 유지 관리한 PASCAL VOC Consortium에 감사드립니다. VOC 데이터셋과 제작자에 관한 자세한 내용은 PASCAL VOC 데이터셋 웹사이트를 방문하세요.
PASCAL VOC는 사람, 자동차, 개, 의자와 같은 일상 객체 20개 클래스의 객체 감지 모델을 학습하고 벤치마킹하는 데 사용됩니다. 데이터셋이 작고 레이블이 완비되어 있으며 수년간 발표된 기준 성능이 축적되어 있어 새로운 아키텍처 검증, 수업 실험, 빠른 전이 학습 연구에 흔히 사용됩니다.
Ultralytics VOC 구성에는 이미지 21,503장이 포함되어 있습니다. 학습용은 16,551장(VOC2007 trainval + VOC2012 trainval)이고, 검증용은 4,952장(VOC2007 test 세트)입니다. 모든 분할에서 동일한 20개 클래스를 사용합니다. 전체 구성은 데이터셋 구조를 참조하세요.
data="VOC.yaml"으로 처음 학습할 때 VOC가 자동으로 다운로드되므로 수동으로 진행할 단계가 없습니다. 스크립트는 Ultralytics GitHub 릴리스 에셋에서 아카이브 3개(2.8GB)를 가져와 XML 주석을 YOLO 형식으로 변환합니다.
이미지 크기 640으로 100 epochs 동안 VOC에서 YOLO26n 모델을 학습합니다:
학습 예제
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n.pt")  # 사전 학습된 모델을 불러옵니다(학습에 권장).

# 모델 학습
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
두 챌린지는 동일한 20개 클래스를 사용하지만 서로 다른 이미지를 제공합니다. VOC2007은 trainval 이미지 5,011장과 주석이 공개된 테스트 이미지 4,952장을 제공하고, VOC2012는 trainval 이미지 11,540장을 제공하며 테스트 주석은 비공개로 유지되어 공식 평가 서버에서만 점수를 산출합니다. Ultralytics VOC.yaml은 두 trainval 세트를 병합해 학습에 사용하고 VOC2007 test로 검증합니다.
VOC는 COCO보다 작고 단순합니다. VOC는 20개 클래스와 이미지 21,503개를 포함하며, COCO는 80개 클래스와 이미지 330K개를 포함합니다. VOC 결과는 전통적으로 0.5 IoU에서의 mAP로 보고되는 반면, COCO는 IoU 임계값 0.5~0.95의 mAP를 평균합니다. VOC는 학습 속도가 훨씬 빠르고 빠른 실험에 적합하며, COCO 데이터셋은 프로덕션 규모 벤치마킹의 표준입니다.
아니요. VOC.yaml은 감지 전용 구성입니다. 변환기는 VOC XML 어노테이션에서 바운딩 박스를 추출하며 원본 벤치마크에 포함된 세그멘테이션 마스크는 변환하지 않습니다. 인스턴스 세그멘테이션 모델을 학습하려면 YOLO26n-seg 모델과 함께 COCO-Seg와 같이 폴리곤 레이블이 있는 데이터셋을 사용하세요.
raise RuntimeError(emojis(f"Dataset '{clean_url(self.args.data)}' error ❌ {e}")) from e
RuntimeError: Dataset 'VOC.yaml' error ❌ [Errno 2] No such file or directory: '/home/diana/Code/test/datasets/VOC/images/VOCdevkit/VOC2007/ImageSets/Main/train.txt'
Nice find on the root cause. To clean things up, delete the incomplete datasets/VOC folder and run your yolo ... data=VOC.yaml command again so the download/conversion script can fully re-download and unpack everything; if you still hit a path error after that, please share the full command and complete traceback so we can take a closer look.
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to train YOLO26 on your Pascal VOC dataset, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height in normalized coordinates). Use the conversion script provided in the VOC.yaml file under the "Download script/URL" section. Once converted, define a custom YAML file for your dataset paths and run the training using:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="your_dataset.yaml", epochs=100, imgsz=640)
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to use your Pascal VOC dataset for YOLO26 training, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height with normalized coordinates). You can adapt the XML-to-YOLO conversion script from the VOC dataset documentation here: https://docs.ultralytics.com/datasets/detect/voc/. Once converted, create a dataset YAML file similar to VOC.yaml, specifying your paths and classes, and then start training using yolo detect train data=your_dataset.yaml model=yolo26n.pt. Let me know if you encounter any issues!
쿠키를 통해 유용하다고 생각하시는 문서, 모델, 기능을 파악하여 계속 개선할 수 있습니다. 에서 공유할 정보를 선택하거나 개인정보 처리방침을(를) 읽어 보세요.


mengdxiran
 Glenn JocherUltralytics
YustasDev