RT-DETR da Baidu: um detetor de objetos em tempo real baseado em Vision Transformer
Visão geral#
Real-Time Detection Transformer (RT-DETR), desenvolvido pela Baidu, é um detetor de objetos de ponta a ponta que oferece desempenho em tempo real e mantém uma elevada precisão. Baseia-se no DETR, um framework de deteção transformer sem NMS, e acrescenta uma rede principal convolucional e um codificador híbrido eficiente para atingir velocidades em tempo real. RT-DETR processa eficientemente funcionalidades multiescala ao separar a interação intranível da fusão entre níveis. O modelo é altamente adaptável e permite ajustar de forma flexível a velocidade de inferência através de diferentes camadas do descodificador, sem novo treino. RT-DETR tem o melhor desempenho em backends acelerados, como CUDA com TensorRT.
Vê: Como utilizar RT-DETR da Baidu para deteção de objetos | Inferência e benchmarking com Ultralytics
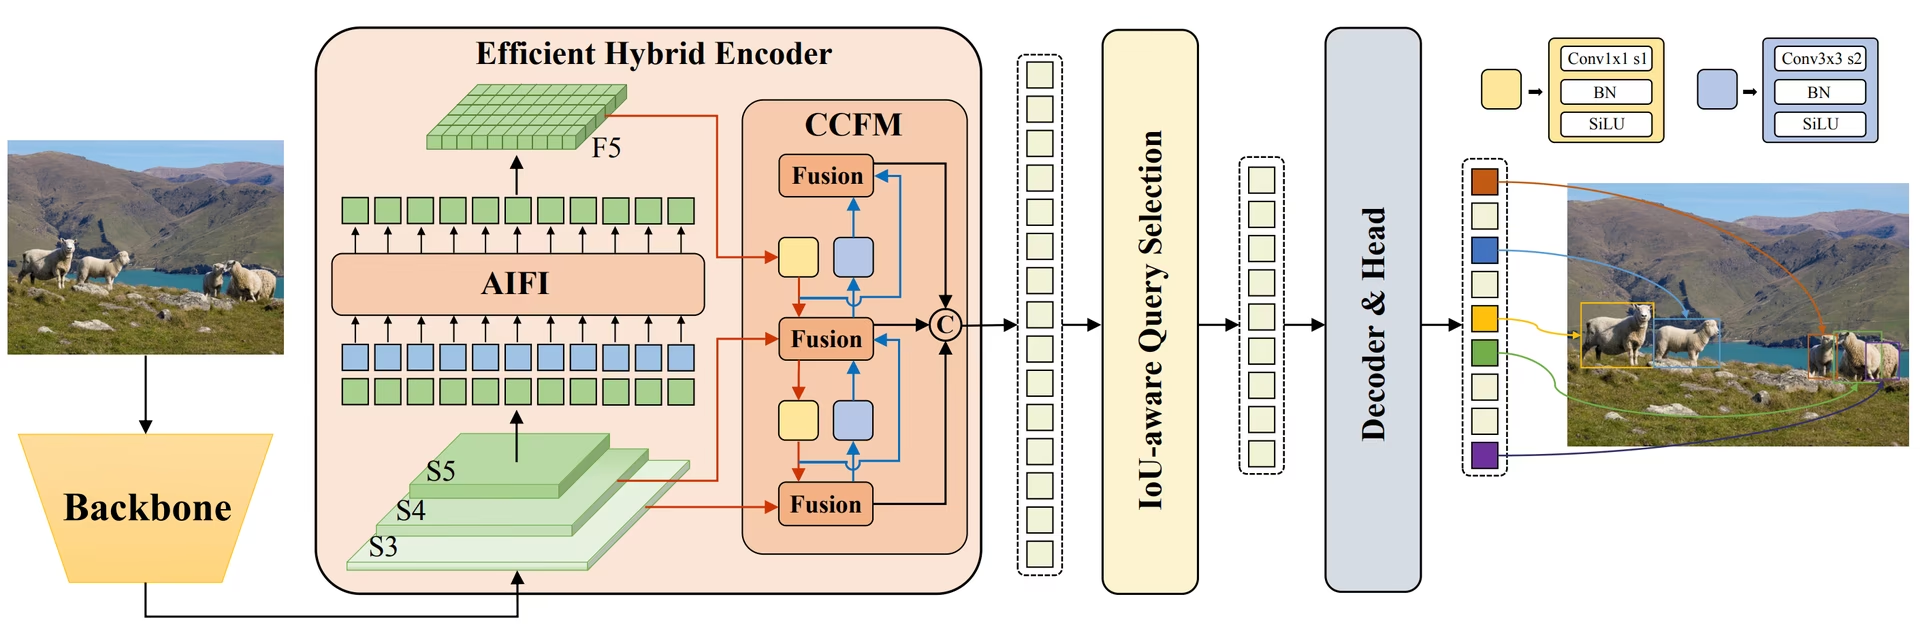 Visão geral do RT-DETR da Baidu. O diagrama da arquitetura do modelo RT-DETR mostra as três últimas etapas da rede base {S3, S4, S5} como entrada do codificador. O codificador híbrido eficiente transforma características multiescala numa sequência de características de imagem através da interação de características intrasescala (AIFI) e do módulo de fusão de características entre escalas (CCFM). A seleção de consultas ciente de IoU é usada para selecionar um número fixo de características de imagem que servirão como consultas de objetos iniciais para o descodificador. Por fim, o descodificador, com cabeças de predição auxiliares, otimiza iterativamente as consultas de objetos para gerar caixas e pontuações de confiança (fonte).
Principais funcionalidades#
- Codificador híbrido eficiente: RT-DETR da Baidu utiliza um codificador híbrido eficiente que processa funcionalidades multiescala ao separar a interação intranível da fusão entre níveis. Esta conceção baseada em transformer reduz os custos computacionais e permite a deteção de objetos em tempo real.
- Seleção de consultas com consciência de IoU: RT-DETR da Baidu melhora a inicialização das consultas de objetos com seleção de consultas com consciência de IoU. Isto permite que o modelo se concentre nos objetos mais relevantes da cena e aumenta a precisão da deteção.
- Velocidade de inferência adaptável: o RT-DETR da Baidu permite ajustar flexivelmente a velocidade de inferência usando diferentes camadas do descodificador, sem necessidade de novo treino. Esta adaptabilidade facilita a aplicação prática em vários cenários de deteção de objetos em tempo real.
- Estrutura sem NMS: baseado em DETR, o RT-DETR elimina a necessidade de pós-processamento de supressão não máxima, simplificando o pipeline de deteção e podendo melhorar a eficiência.
- Deteção sem âncoras: como detetor sem âncoras, o RT-DETR simplifica o processo de deteção e pode melhorar a generalização entre diferentes conjuntos de dados.
Modelos pré-treinados#
A API Python da Ultralytics disponibiliza modelos RT-DETR pré-treinados com PaddlePaddle em diferentes escalas:
- RT-DETR-L: 53,0% AP no conjunto de validação de 2017 do COCO, 114 FPS numa GPU T4
- RT-DETR-X: 54,8% AP em COCO val2017, 74 FPS numa GPU T4
A Baidu lançou RTDETRv2 em julho de 2024, melhorando ainda mais a arquitetura original.
Exemplos de uso#
Os exemplos abaixo mostram código simples de treino e inferência de RT-DETR. Também é possível treinar os modelos em GPUs na nuvem através da Ultralytics Platform.
from ultralytics import RTDETR

# Carrega um modelo RT-DETR-l pré-treinado em COCO
model = RTDETR("rtdetr-l.pt")

# Exibir informações do modelo (opcional)
model.info()

# Treina o modelo no conjunto de dados de exemplo COCO8 durante 100 épocas
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Executa a inferência com o modelo RT-DETR-l na imagem 'bus.jpg'
results = model("path/to/bus.jpg")Define deterministic=False ao treinar RT-DETR em CUDA com PyTorch 2.0 ou posterior. A atenção deformável usa F.grid_sample, que não tem retropropagação determinística em CUDA; por isso, deterministic=True não consegue tornar a execução reprodutível e pode reduzir o débito de treino. seed continua a controlar a inicialização dos pesos, a ordem dos dados e a amostragem das aumentações.
Os pesos pré-treinados do RT-DETR permitem usar duas definições durante a inferência para reduzir a latência sem novo treino:
eval_idx: interrompe a descodificação mais cedo. No descodificador predefinido de 6 camadas, usa um índice baseado em zero (0–5).eval_idx=5usa todas as camadas;eval_idx=3usa 4 camadas. Numa GPU T4 com TensorRT v10.11, o RT-DETR-L melhora de 8,0 ms / 52,7 mAP para 7,4 ms / 52,5 mAP com 4 camadas.num_queries: reduz o número de consultas de objetos (predefinição: 300). Reduzir o valor para 100 pode permitir atingir 7,4 ms / 51,7 mAP em COCO na mesma configuração. Em conjuntos de dados com menos objetos por imagem, a queda de mAP é normalmente menor, mas mantém o valor acima do número máximo esperado de objetos por imagem.
Ambas as definições podem reduzir o mAP — valida o compromisso no teu conjunto de dados antes da implementação.
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# Escolhe uma ou ambas as definições depois de validares o compromisso entre velocidade e precisão.
head.decoder.eval_idx = 3  # Usa 4 das 6 camadas do descodificador.
head.num_queries = 100  # Usa menos consultas de objetos.

results = rtdetr("path/to/image.jpg")

# A exportação usa as mesmas definições do descodificador e das consultas, incluindo nas exportações TensorRT.
rtdetr.export(format="engine", device=0, quantize=16)
Tarefas e modos compatíveis#
Esta tabela apresenta os tipos de modelos, os respetivos pesos pré-treinados, as tarefas suportadas por cada modelo e os modos suportados (Train, Val, Predict, Export), indicados por emojis ✅.
| Tipo de modelo | Pesos pré-treinados | Tarefas suportadas | Treinamento | Validação | Inferência | Exportar |
|---|---|---|---|---|---|---|
| RT-DETR grande | rtdetr-l.pt | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
| RT-DETR extra grande | rtdetr-x.pt | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yaml e rtdetr-resnet101.yaml são fornecidos apenas como arquiteturas YAML. A Ultralytics disponibiliza pesos pré-treinados apenas para rtdetr-l e rtdetr-x. Instancia as variantes ResNet a partir de YAML (por exemplo, RTDETR("rtdetr-resnet50.yaml")) e treina-as ou ajusta-as conforme necessário.
Casos de utilização ideais#
O RT-DETR é especialmente adequado para aplicações que exigem elevada precisão e desempenho em tempo real:
- Condução autónoma: Para uma perceção fiável do ambiente em sistemas de condução autónoma, onde a velocidade e a precisão são fundamentais.
- Robótica avançada: Permite que os robôs executem tarefas complexas que exigem reconhecimento preciso de objetos e interação em ambientes dinâmicos.
- Imagiologia médica: Para aplicações de cuidados de saúde em que a precisão na deteção de objetos pode ser fundamental para o diagnóstico.
- Sistemas de vigilância: para aplicações de segurança que exigem monitorização em tempo real com elevada precisão de deteção. Sabe mais sobre sistemas de alarme de segurança.
- Análise de imagens de satélite: para a análise detalhada de imagens de alta resolução, em que é importante compreender o contexto global. Lê sobre visão computacional em imagens de satélite.
Citações e agradecimentos#
Se usares o RT-DETR da Baidu no teu trabalho de investigação ou desenvolvimento, cita o artigo original:
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Para RTDETRv2, podes citar o artigo de 2024:
@misc{lv2024rtdetrv2,
      title={RT-DETRv2: Improved Baseline with Bag-of-Freebies for Real-Time Detection Transformer},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Agradecemos à Baidu e à equipa PaddlePaddle por criarem e manterem este recurso valioso para a comunidade de visão computacional. Agradecemos muito o desenvolvimento do detetor de objetos em tempo real baseado em transformer, RT-DETR.
Perguntas frequentes#
O RT-DETR (Transformer de Deteção em Tempo Real) da Baidu é um detetor de objetos em tempo real baseado em Transformer. Processa eficientemente características multiescala ao separar a interação intranível da fusão entre níveis através do seu codificador híbrido eficiente. Ao utilizar a seleção de consultas consciente do IoU, o modelo concentra-se nos objetos mais relevantes, melhorando a precisão da deteção. A velocidade de inferência adaptável, obtida ajustando as camadas do descodificador sem voltar a treinar, torna o RT-DETR adequado para vários cenários de deteção de objetos em tempo real.
Utiliza a API Python da Ultralytics para carregar os modelos RT-DETR pré-treinados em PaddlePaddle. Por exemplo, para carregar o modelo RT-DETR-l pré-treinado em COCO, ajustá-lo e executar inferência:
Exemplofrom ultralytics import RTDETR # Carrega um modelo RT-DETR-l pré-treinado em COCO model = RTDETR("rtdetr-l.pt") # Exibir informações do modelo (opcional) model.info() # Treina o modelo no conjunto de dados de exemplo COCO8 durante 100 épocas results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # Executa a inferência com o modelo RT-DETR-l na imagem 'bus.jpg' results = model("path/to/bus.jpg")RT-DETR da Baidu combina um codificador híbrido eficiente com a seleção de consultas com consciência de IoU, reduzindo o custo computacional e mantendo uma elevada precisão. A capacidade de ajustar a velocidade de inferência através de diferentes camadas do descodificador, sem novo treino, acrescenta flexibilidade, útil para aplicações em tempo real em backends acelerados, como CUDA com TensorRT. A arquitetura transformer também capta mais contexto global do que os detetores tradicionais baseados em CNN.
RT-DETR da Baidu permite ajustar de forma flexível a velocidade de inferência através de diferentes camadas do descodificador, sem necessidade de novo treino. Isto permite equilibrar velocidade e precisão em tarefas de deteção de objetos em tempo real: utiliza menos camadas do descodificador para um processamento mais rápido e uma precisão ligeiramente inferior, ou todas as camadas para obter as deteções mais precisas. Esta funcionalidade é especialmente útil ao implementar modelos em dispositivos com diferentes capacidades computacionais.
Não. No RT-DETR,
max_detlimita o número de predições devolvidas após a inferência, mas não aumenta o número de consultas de objetos produzidas pelo descodificador. Os pontos de controlo pré-treinados do RT-DETR da Ultralytics usam 300 consultas de objetos, pelo que não podem devolver mais de 300 deteções por imagem, mesmo que definasmax_detcom um valor superior.Usa
max_detpara reduzir o número de deteções devolvidas, por exemplomax_det=100, quando só precisas de menos predições com elevada confiança. Se o teu conjunto de dados puder conter mais de 300 objetos por imagem, treina um modelo RT-DETR personalizado com um número maior de consultas no descodificador (nq) no YAML do modelo; alterar este valor num ponto de controlo pré-treinado depois do treino não é equivalente e exige novo treino para aprender as consultas adicionais.Sim, os modelos RT-DETR suportam os modos de treino, validação, previsão e exportação da Ultralytics. O framework Ultralytics oferece uma API consistente em diferentes arquiteturas de modelos, pelo que RT-DETR utiliza o mesmo fluxo de trabalho que os modelos YOLO.


Comentários148
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
PhucPhamSy
Hi all, Could you please let me know how to use all parameters in the appendix of the original paper, "https://arxiv.org/pdf/2304.08069"? Thanks!
1 Glenn JocherUltralytics
Hey there! 👋
We're really glad you're interested in diving deep into the parameters detailed in the original paper. Specifically, for utilizing parameters as mentioned in the RT-DETR paper ("DETRs Beat YOLOs on Real-time Object Detection"), I recommend focusing on the key components such as the Efficient Hybrid Encoder, IoU-aware Query Selection, and adaptability in Inference Speed adjustments that make RT-DETR efficient.
Details on these components can be extrapolated to parameter usage within your model through our Python API. For instance, when initializing the RT-DETR model or adjusting inference speed, you would consider the different scales of pre-trained models available:
from ultralytics import RTDETR

# For a larger model with potentially higher accuracy but lower FPS (Frames Per Second)
model = RTDETR('rtdetr-l.pt')

# For an extra-large model prioritizing accuracy over speed
model_x = RTDETR('rtdetr-x.pt')
Adjustments for inference speed and applying IoU-aware query selection can directly correlate with your focus during the
.train()or.predict()processes, especially understanding what goes behind each configuration setting in these functions.Unfortunately, we don't provide a direct mapping for every parameter mentioned in the appendix to code-level argument settings as the implementation abstracts many complexities for user convenience and to maintain the API's simplicity. However, understanding the RT-DETR's key features and translating that understanding into practical API usage is a great way to leverage the power of RT-DETR. 😊
For more tailored guidance, always feel free to ask or refer to our official documentation for specific examples and deeper insights.
Happy coding! 🚀
 Murat Raimbekov
hey @wba-zzu, thanks for raising this.
quick rundown of where things stand:
resnet50 / resnet101 - the architectures are already shipped as yaml configs:
you can build and train them straight from yaml:
from ultralytics import RTDETR

model = RTDETR("rtdetr-resnet50.yaml")
model.train(data="coco.yaml", epochs=100, imgsz=640)
however, ultralytics does not publish pretrained weights for these. the only official rt-detr checkpoints in the ultralytics/assets releases are
rtdetr-l.ptandrtdetr-x.pt, both of which use the hgnetv2 backbone (not resnet). this is also flagged in the model docs under "architecture-only variants".resnet18 - not shipped. there is no
rtdetr-resnet18.yamlin the repo, so a resnet18 variant would need its own yaml and corresponding modules added.loading external pretrained weights: ultralytics builds the model from yaml, so the state_dict keys follow a pattern like
model.<index>.layer.<...>.conv.weight. weights from another implementation will not load directly - they would need a key-mapping / conversion step to match this layout.hope this helps!
 Boao Wang
想要将原版RT-DETR中的ResNet50和ResNet18以及ResNet101完全移植到Ultralytics,并且获得其预训练模型
995742853
您好,我想请问一下,在哪里有基于rtdetr-resnet50的预训练pt权重,我知道看到rtdetr-l以及x的预训练权重
- Glenn JocherUltralytics
目前 RT-DETR 文档 里公开提供的 Ultralytics 预训练权重只有
rtdetr-l.pt和rtdetr-x.pt;如果你找的是 ResNet50 版本,建议查看 Baidu 官方的 RT-DETR PyTorch 权重列表,其中提供的是rtdetr_r50vd_*.pth,不是 Ultralytics 直接发布的rtdetr-resnet50.pt,也欢迎直接在这里继续提问,方便 Ultralytics 团队跟进。 (docs.ultralytics.com) 谢谢您的回复
maitianstudio-arch
How to use RT-DETRv2?
- Glenn JocherUltralytics
Ultralytics currently exposes the original RT-DETR pretrained weights (
rtdetr-l.pt,rtdetr-x.pt) via theRTDETRAPI; RT-DETRv2 pretrained weights/configs aren’t packaged inultralyticsyet, so if you share what RT-DETRv2 checkpoint you have (Paddle vs PyTorch) and how you’re trying to run it, we can point you to the right conversion/workflow—meanwhile you can use RT-DETR as shown in the RT-DETR docs.from ultralytics import RTDETR model = RTDETR("rtdetr-l.pt") results = model("path/to/image.jpg")
fxc0627
你好,请问RE-DETR模型适用于小目标工业缺陷检测吗?对于小目标检测有什么天然的优势?
wang18382140151-hub
你好,最近deim,dfine等对于rtdetr有了很好的改进,尤其是deim能很好的加速训练的速度,能将其整合进rtdetr中吗?
yuwencool
您好RT-DETR模型的推理支持model.track模式吗?
liyansong123456
RT-DETRv3 has been released. Does Ultralytics have plans to integrate it?
AK993
你好,rt-detr支持在转为rknn格式,并在rk3588上部署吗