YOLOv7: conjunto de recursos gratuitos treináveis
Lançado em julho de 2022, o YOLOv7 representou um avanço significativo na deteção de objetos em tempo real na altura do seu lançamento. Alcançou 56,8% de AP, a maior precisão entre os detetores em tempo real que executavam a 30 FPS ou mais numa GPU V100 quando foi apresentado. O YOLOv7 superava detetores de objetos contemporâneos, como YOLOR, YOLOX, Scaled-YOLOv4 e YOLOv5, em velocidade e precisão. O modelo foi treinado de raiz no conjunto de dados MS COCO, sem utilizar outros conjuntos de dados ou pesos pré-treinados. O código-fonte do YOLOv7 está disponível no GitHub. Nota que, desde então, modelos mais recentes, como YOLO26 e YOLO11, alcançaram maior precisão e melhor eficiência.
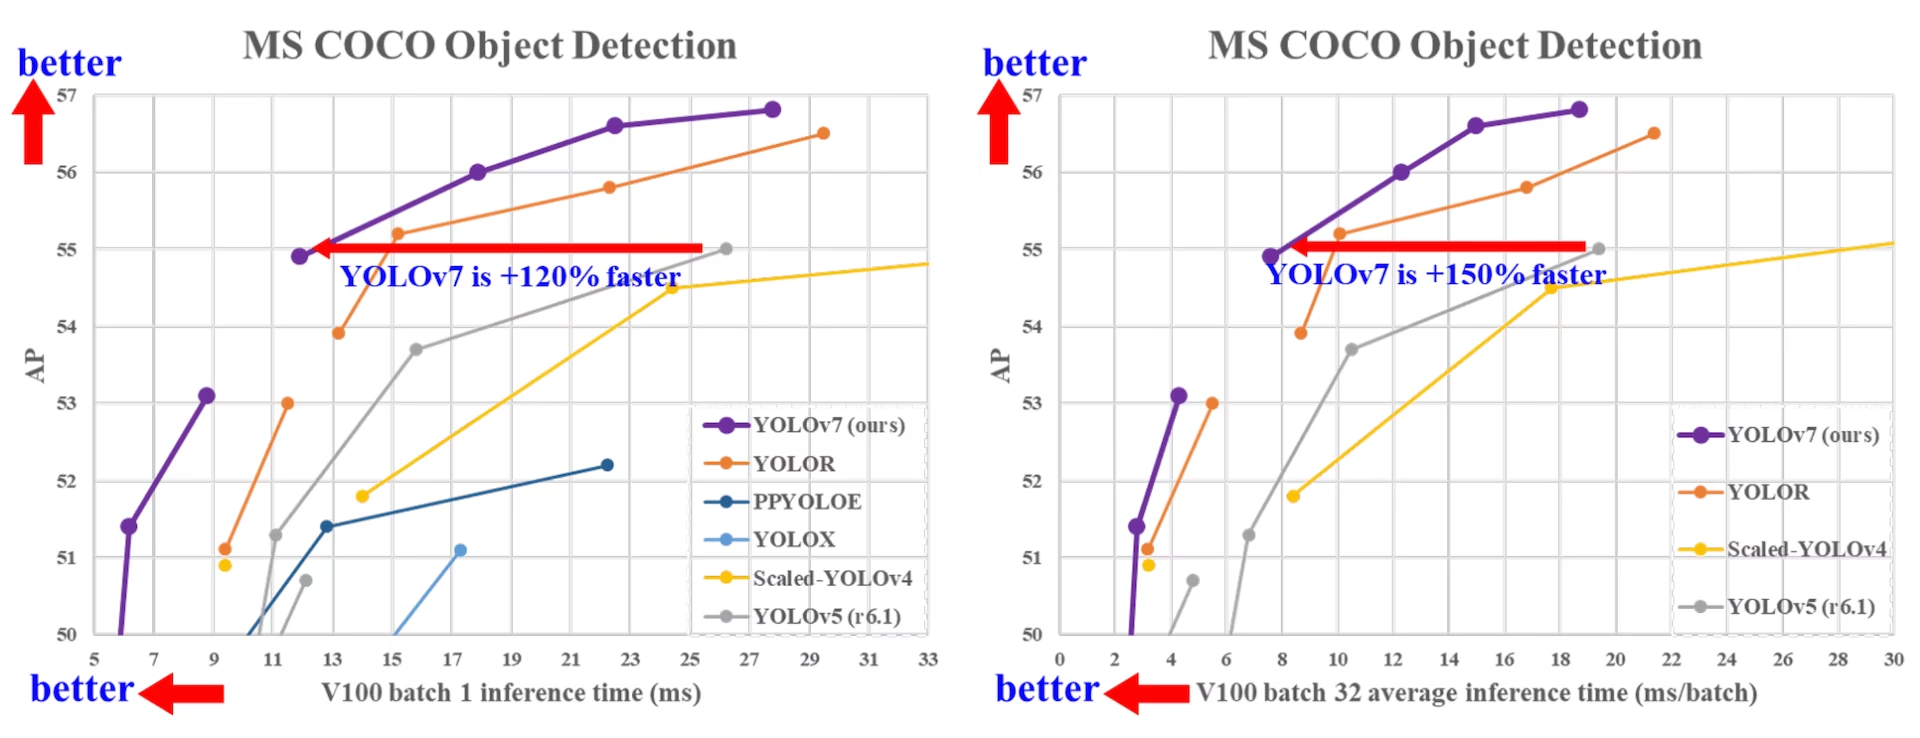
Comparação de detetores de objetos de última geração#
Segundo a tabela comparativa do artigo sobre YOLOv7, o YOLOv7 apresenta o melhor equilíbrio geral entre velocidade e precisão. Em comparação com o YOLOv5-N (r6.1), o YOLOv7-tiny-SiLU é 127 fps mais rápido e 10,7% mais preciso em AP. Além disso, o YOLOv7 alcança 51,4% de AP a 161 fps, enquanto o PPYOLOE-L alcança o mesmo AP a apenas 78 fps, e o YOLOv7 utiliza menos 41% de parâmetros do que o PPYOLOE-L.
Em comparação com o YOLOv5-L (r6.1), que funciona a 99 fps, o YOLOv7-X funciona a 114 fps e melhora o AP em 3,9%. Em comparação com o YOLOv5-X (r6.1), de escala semelhante, o YOLOv7-X é 31 fps mais rápido, utiliza menos 22% de parâmetros e menos 8% de computação, e melhora o AP em 2,2% (Fonte).
| Modelo | Parâmetros (M) | FLOPs (G) | Tamanho (pixels) | FPS | APteste / val50-95 | APteste50 | APteste75 | APtesteS | APtesteM | APtesteL |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOX-S | 9.0 | 26.8 | 640 | 102 | 40.5% / 40.5% | - | - | - | - | - |
| YOLOX-M | 25.3 | 73.8 | 640 | 81 | 47.2% / 46.9% | - | - | - | - | - |
| YOLOX-L | 54.2 | 155.6 | 640 | 69 | 50.1% / 49.7% | - | - | - | - | - |
| YOLOX-X | 99.1 | 281.9 | 640 | 58 | 51.5% / 51.1% | - | - | - | - | - |
| PPYOLOE-S | 7.9 | 17.4 | 640 | 208 | 43.1% / 42.7% | 60.5% | 46.6% | 23.2% | 46.4% | 56.9% |
| PPYOLOE-M | 23.4 | 49.9 | 640 | 123 | 48.9% / 48.6% | 66.5% | 53.0% | 28.6% | 52.9% | 63.8% |
| PPYOLOE-L | 52.2 | 110.1 | 640 | 78 | 51.4% / 50.9% | 68.9% | 55.6% | 31.4% | 55.3% | 66.1% |
| PPYOLOE-X | 98.4 | 206.6 | 640 | 45 | 52.2% / 51.9% | 69.9% | 56.5% | 33.3% | 56.3% | 66.4% |
| YOLOv5-N (r6.1) | 1.9 | 4.5 | 640 | 159 | - / 28.0% | - | - | - | - | - |
| YOLOv5-S (r6.1) | 7.2 | 16.5 | 640 | 156 | - / 37.4% | - | - | - | - | - |
| YOLOv5-M (r6.1) | 21.2 | 49.0 | 640 | 122 | - / 45.4% | - | - | - | - | - |
| YOLOv5-L (r6.1) | 46.5 | 109.1 | 640 | 99 | - / 49.0% | - | - | - | - | - |
| YOLOv5-X (r6.1) | 86.7 | 205.7 | 640 | 83 | - / 50.7% | - | - | - | - | - |
| YOLOR-CSP | 52.9 | 120.4 | 640 | 106 | 51.1% / 50.8% | 69.6% | 55.7% | 31.7% | 55.3% | 64.7% |
| YOLOR-CSP-X | 96.9 | 226.8 | 640 | 87 | 53.0% / 52.7% | 71.4% | 57.9% | 33.7% | 57.1% | 66.8% |
| YOLOv7-tiny-SiLU | 6.2 | 13.8 | 640 | 286 | 38.7% / 38.7% | 56.7% | 41.7% | 18.8% | 42.4% | 51.9% |
| YOLOv7 | 36.9 | 104.7 | 640 | 161 | 51.4% / 51.2% | 69.7% | 55.9% | 31.8% | 55.5% | 65.0% |
| YOLOv7-X | 71.3 | 189.9 | 640 | 114 | 53.1% / 52.9% | 71.2% | 57.8% | 33.8% | 57.1% | 67.4% |
| YOLOv5-N6 (r6.1) | 3.2 | 18.4 | 1280 | 123 | - / 36.0% | - | - | - | - | - |
| YOLOv5-S6 (r6.1) | 12.6 | 67.2 | 1280 | 122 | - / 44.8% | - | - | - | - | - |
| YOLOv5-M6 (r6.1) | 35.7 | 200.0 | 1280 | 90 | - / 51.3% | - | - | - | - | - |
| YOLOv5-L6 (r6.1) | 76.8 | 445.6 | 1280 | 63 | - / 53.7% | - | - | - | - | - |
| YOLOv5-X6 (r6.1) | 140.7 | 839.2 | 1280 | 38 | - / 55.0% | - | - | - | - | - |
| YOLOR-P6 | 37.2 | 325.6 | 1280 | 76 | 53.9% / 53.5% | 71.4% | 58.9% | 36.1% | 57.7% | 65.6% |
| YOLOR-W6 | 79.8 | 453.2 | 1280 | 66 | 55.2% / 54.8% | 72.7% | 60.5% | 37.7% | 59.1% | 67.1% |
| YOLOR-E6 | 115.8 | 683.2 | 1280 | 45 | 55.8% / 55.7% | 73.4% | 61.1% | 38.4% | 59.7% | 67.7% |
| YOLOR-D6 | 151.7 | 935.6 | 1280 | 34 | 56.5% / 56.1% | 74.1% | 61.9% | 38.9% | 60.4% | 68.7% |
| YOLOv7-W6 | 70.4 | 360.0 | 1280 | 84 | 54.9% / 54.6% | 72.6% | 60.1% | 37.3% | 58.7% | 67.1% |
| YOLOv7-E6 | 97.2 | 515.2 | 1280 | 56 | 56.0% / 55.9% | 73.5% | 61.2% | 38.0% | 59.9% | 68.4% |
| YOLOv7-D6 | 154.7 | 806.8 | 1280 | 44 | 56.6% / 56.3% | 74.0% | 61.8% | 38.8% | 60.1% | 69.5% |
| YOLOv7-E6E | 151.7 | 843.2 | 1280 | 36 | 56.8% / 56.8% | 74.4% | 62.1% | 39.3% | 60.5% | 69.0% |
Visão geral#
A deteção de objetos em tempo real é um componente importante em muitos sistemas de visão por computador, incluindo o seguimento de múltiplos objetos, a condução autónoma, a robótica e a análise de imagens médicas. Nos últimos anos, o desenvolvimento da deteção de objetos em tempo real tem-se centrado na conceção de arquiteturas eficientes e na melhoria da velocidade de inferência de várias CPUs, GPUs e unidades de processamento neural (NPUs). O YOLOv7 suporta dispositivos GPU móveis e convencionais, desde a periferia até à nuvem.
Ao contrário dos detetores de objetos tradicionais em tempo real, que se concentram na otimização da arquitetura, o YOLOv7 dá prioridade à otimização do processo de treino. Isso inclui módulos e métodos de otimização concebidos para melhorar a precisão da deteção de objetos sem aumentar o custo de inferência, um conceito conhecido como "trainable bag-of-freebies".
Principais funcionalidades#
O YOLOv7 introduz várias funcionalidades importantes:
-
Reparametrização do modelo: o YOLOv7 propõe um modelo reparametrizado planeado, uma estratégia aplicável a camadas em diferentes redes com o conceito de caminho de propagação do gradiente.
-
Atribuição dinâmica de rótulos: o treino do modelo com várias camadas de saída apresenta um novo problema: "Como atribuir alvos dinâmicos às saídas de diferentes ramificações?" Para resolver este problema, o YOLOv7 introduz um novo método de atribuição de rótulos chamado atribuição de rótulos guiada por pistas, do mais grosseiro ao mais fino.
-
Escalabilidade estendida e composta: o YOLOv7 propõe métodos de "extensão" e "escalabilidade composta" para o detetor de objetos em tempo real, que permitem utilizar eficazmente os parâmetros e a computação.
-
Eficiência: o método proposto pelo YOLOv7 reduz cerca de 40% dos parâmetros e 50% dos cálculos dos detetores de objetos em tempo real de última geração, aumentando a velocidade de inferência e a precisão da deteção.
Exemplos de uso#
A Ultralytics não publica pesos pré-treinados yolov7.pt nem ficheiros YAML ultralytics/cfg/models/v7/, e o treino e a inferência nativos do YOLOv7 com PyTorch não são compatíveis com o pacote Python da Ultralytics. No entanto, podes importar um checkpoint YOLOv7 treinado no repositório upstream do YOLOv7 para a Ultralytics, exportando-o para ONNX ou TensorRT, como mostrado abaixo.
Exportação para ONNX#
Para usar um modelo ONNX YOLOv7 com a Ultralytics:
-
(Opcional) Instala a Ultralytics e exporta um modelo ONNX para instalar automaticamente as dependências necessárias:
pip install ultralytics yolo export model=yolo26n.pt format=onnx -
Exporta o modelo YOLOv7 pretendido usando o exportador no repositório do YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 cd yolov7 python export.py --weights yolov7-tiny.pt --grid --end2end --simplify --topk-all 100 --iou-thres 0.65 --conf-thres 0.35 --img-size 640 640 --max-wh 640 -
Modifica o grafo do modelo ONNX para que seja compatível com a Ultralytics, usando o seguinte script:
import numpy as np import onnx from onnx import helper, numpy_helper # Load the ONNX model model_path = "yolov7/yolov7-tiny.onnx" # Replace with your model path model = onnx.load(model_path) graph = model.graph # Fix input shape to batch size 1 input_shape = graph.input[0].type.tensor_type.shape input_shape.dim[0].dim_value = 1 # Define the output of the original model original_output_name = graph.output[0].name # Create slicing nodes sliced_output_name = f"{original_output_name}_sliced" # Define initializers for slicing (remove the first value) start = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_start") end = numpy_helper.from_array(np.array([7], dtype=np.int64), name="slice_end") axes = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_axes") steps = numpy_helper.from_array(np.array([1], dtype=np.int64), name="slice_steps") graph.initializer.extend([start, end, axes, steps]) slice_node = helper.make_node( "Slice", inputs=[original_output_name, "slice_start", "slice_end", "slice_axes", "slice_steps"], outputs=[sliced_output_name], name="SliceNode", ) graph.node.append(slice_node) # Define segment slicing seg1_start = numpy_helper.from_array(np.array([0], dtype=np.int64), name="seg1_start") seg1_end = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg1_end") seg2_start = numpy_helper.from_array(np.array([4], dtype=np.int64), name="seg2_start") seg2_end = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg2_end") seg3_start = numpy_helper.from_array(np.array([5], dtype=np.int64), name="seg3_start") seg3_end = numpy_helper.from_array(np.array([6], dtype=np.int64), name="seg3_end") graph.initializer.extend([seg1_start, seg1_end, seg2_start, seg2_end, seg3_start, seg3_end]) # Create intermediate tensors for segments segment_1_name = f"{sliced_output_name}_segment1" segment_2_name = f"{sliced_output_name}_segment2" segment_3_name = f"{sliced_output_name}_segment3" # Add segment slicing nodes graph.node.extend( [ helper.make_node( "Slice", inputs=[sliced_output_name, "seg1_start", "seg1_end", "slice_axes", "slice_steps"], outputs=[segment_1_name], name="SliceSegment1", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg2_start", "seg2_end", "slice_axes", "slice_steps"], outputs=[segment_2_name], name="SliceSegment2", ), helper.make_node( "Slice", inputs=[sliced_output_name, "seg3_start", "seg3_end", "slice_axes", "slice_steps"], outputs=[segment_3_name], name="SliceSegment3", ), ] ) # Concatenate the segments concat_output_name = f"{sliced_output_name}_concat" concat_node = helper.make_node( "Concat", inputs=[segment_1_name, segment_3_name, segment_2_name], outputs=[concat_output_name], axis=1, name="ConcatSwapped", ) graph.node.append(concat_node) # Reshape to [1, -1, 6] reshape_shape = numpy_helper.from_array(np.array([1, -1, 6], dtype=np.int64), name="reshape_shape") graph.initializer.append(reshape_shape) final_output_name = f"{concat_output_name}_batched" reshape_node = helper.make_node( "Reshape", inputs=[concat_output_name, "reshape_shape"], outputs=[final_output_name], name="AddBatchDimension", ) graph.node.append(reshape_node) # Get the shape of the reshaped tensor shape_node_name = f"{final_output_name}_shape" shape_node = helper.make_node( "Shape", inputs=[final_output_name], outputs=[shape_node_name], name="GetShapeDim", ) graph.node.append(shape_node) # Extract the second dimension dim_1_index = numpy_helper.from_array(np.array([1], dtype=np.int64), name="dim_1_index") graph.initializer.append(dim_1_index) second_dim_name = f"{final_output_name}_dim1" gather_node = helper.make_node( "Gather", inputs=[shape_node_name, "dim_1_index"], outputs=[second_dim_name], name="GatherSecondDim", ) graph.node.append(gather_node) # Subtract from 100 to determine how many values to pad target_size = numpy_helper.from_array(np.array([100], dtype=np.int64), name="target_size") graph.initializer.append(target_size) pad_size_name = f"{second_dim_name}_padsize" sub_node = helper.make_node( "Sub", inputs=["target_size", second_dim_name], outputs=[pad_size_name], name="CalculatePadSize", ) graph.node.append(sub_node) # Build the [2, 3] pad array: # 1st row -> [0, 0, 0] (no padding at the start of any dim) # 2nd row -> [0, pad_size, 0] (pad only at the end of the second dim) pad_starts = numpy_helper.from_array(np.array([0, 0, 0], dtype=np.int64), name="pad_starts") graph.initializer.append(pad_starts) zero_scalar = numpy_helper.from_array(np.array([0], dtype=np.int64), name="zero_scalar") graph.initializer.append(zero_scalar) pad_ends_name = "pad_ends" concat_pad_ends_node = helper.make_node( "Concat", inputs=["zero_scalar", pad_size_name, "zero_scalar"], outputs=[pad_ends_name], axis=0, name="ConcatPadEnds", ) graph.node.append(concat_pad_ends_node) pad_values_name = "pad_values" concat_pad_node = helper.make_node( "Concat", inputs=["pad_starts", pad_ends_name], outputs=[pad_values_name], axis=0, name="ConcatPadStartsEnds", ) graph.node.append(concat_pad_node) # Create Pad operator to pad with zeros pad_output_name = f"{final_output_name}_padded" pad_constant_value = numpy_helper.from_array( np.array([0.0], dtype=np.float32), name="pad_constant_value", ) graph.initializer.append(pad_constant_value) pad_node = helper.make_node( "Pad", inputs=[final_output_name, pad_values_name, "pad_constant_value"], outputs=[pad_output_name], mode="constant", name="PadToFixedSize", ) graph.node.append(pad_node) # Update the graph's final output to [1, 100, 6] new_output_type = onnx.helper.make_tensor_type_proto( elem_type=graph.output[0].type.tensor_type.elem_type, shape=[1, 100, 6] ) new_output = onnx.helper.make_value_info(name=pad_output_name, type_proto=new_output_type) # Replace the old output with the new one graph.output.pop() graph.output.extend([new_output]) # Save the modified model onnx.save(model, "yolov7-ultralytics.onnx") -
Em seguida, podes carregar o modelo ONNX modificado e executar a inferência normalmente com a Ultralytics:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.onnx", task="detect")

results = model(ASSETS / "bus.jpg")
Exportação para TensorRT#
-
Segue os passos 1-2 da secção Exportação para ONNX.
-
Instala o pacote Python
TensorRT:pip install tensorrt -
Executa o seguinte script para converter o modelo ONNX modificado num motor TensorRT:
from ultralytics.utils.export import onnx2engine onnx2engine("yolov7-ultralytics.onnx", quantize=16) -
Carrega e executa o modelo na Ultralytics:
from ultralytics import ASSETS, YOLO

model = YOLO("yolov7-ultralytics.engine", task="detect")

results = model(ASSETS / "bus.jpg")
Citações e agradecimentos#
Gostaríamos de reconhecer as contribuições significativas dos autores do YOLOv7 para a área da deteção de objetos em tempo real:
@inproceedings{wang2023yolov7,
  title={YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors},
  author={Wang, Chien-Yao and Bochkovskiy, Alexey and Liao, Hong-Yuan Mark},
  booktitle={Proceedings of the IEEE/CVF conference on Computer Vision and Pattern Recognition (CVPR)},
  pages={7464--7475},
  year={2023}
}
O artigo oficial sobre YOLOv7 foi publicado na CVPR 2023 e está disponível através do CVF Open Access, com uma pré-publicação no arXiv. Os autores disponibilizaram publicamente o seu trabalho, e a base de código pode ser consultada no GitHub. Agradecemos os seus esforços para fazer avançar a área e tornar o trabalho acessível à comunidade em geral.
Perguntas frequentes#
Lançado em julho de 2022, o YOLOv7 era um modelo de detecção de objetos em tempo real que alcançou velocidade e precisão de ponta na época do lançamento. Ele superou modelos contemporâneos como YOLOX, YOLOv5 e PPYOLOE tanto no uso de parâmetros quanto na velocidade de inferência. As características distintivas do YOLOv7 incluem a reparametrização do modelo e a atribuição dinâmica de rótulos, que otimizam seu desempenho sem aumentar os custos de inferência.
O YOLOv7 introduz várias inovações, incluindo a reparametrização do modelo e a atribuição dinâmica de rótulos, que melhoram o processo de treino e a precisão da inferência. Em comparação com o YOLOv5, o YOLOv7 aumenta significativamente a velocidade e a precisão. Por exemplo, o YOLOv7-X melhora a precisão em 2,2% e reduz os parâmetros em 22% em comparação com o YOLOv5-X. Podes consultar comparações detalhadas na tabela de desempenho Comparação do YOLOv7 com detetores de objetos de última geração.
Atualmente, a Ultralytics só é compatível com a inferência do YOLOv7 em ONNX e TensorRT. Para executar com a Ultralytics a versão do YOLOv7 exportada para ONNX ou TensorRT, consulta a secção Exemplos de utilização.
Para instalar e treinar um modelo YOLOv7 personalizado, segue estes passos:
-
Clona o repositório do YOLOv7:
git clone https://github.com/WongKinYiu/yolov7 -
Acede ao diretório clonado e instala as dependências:
cd yolov7 pip install -r requirements.txt -
Prepara o teu conjunto de dados e configura os parâmetros do modelo de acordo com as instruções de utilização fornecidas no repositório.
-
Após o treino, podes exportar o modelo para ONNX ou TensorRT para o usar na Ultralytics, como mostrado em Exemplos de utilização.
-
YOLOv7 introduz várias funcionalidades importantes para a deteção de objetos em tempo real:
- Reparametrização do modelo: melhora o desempenho do modelo otimizando os caminhos de propagação do gradiente.
- Atribuição dinâmica de rótulos: usa um método guiado por pistas, do mais grosseiro ao mais fino, para atribuir alvos dinâmicos às saídas de diferentes ramificações, melhorando a precisão.
- Escalabilidade estendida e composta: utiliza parâmetros e computação de forma eficiente para escalar o modelo para várias aplicações em tempo real.
- Eficiência: reduz em 40% o número de parâmetros e em 50% a computação em comparação com outros modelos de última geração, alcançando simultaneamente velocidades de inferência superiores.


Comentários2
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
naps22
YOLOv7's approach as a trainable bag-of-freebies really stands out, especially in how it optimizes performance without additional inference cost. It's impressive how techniques like re-parameterization and dynamic label assignment enhance accuracy. However, after doing a YOLOv8 comparison, it’s clear that while YOLOv8 brings some architectural improvements and streamlined workflows, YOLOv7 still holds strong in many real-time detection scenarios due to its training-time flexibility.
 Glenn JocherUltralytics(editado)
You're absolutely right about YOLOv7's innovative "trainable bag-of-freebies" approach - it was a game-changing concept that improved accuracy purely through training optimizations rather than architectural changes. The re-parameterization and dynamic label assignment techniques were particularly clever solutions that set new standards for efficiency.
While YOLOv7 remains excellent for real-time detection scenarios, you might want to explore YOLO26 as well - it's our latest model that builds upon these innovations with even better performance across detection, segmentation, and other tasks, all within the streamlined Ultralytics framework.