Implantar o YOLOv5 com o DeepSparse da Neural Magic#
A Neural Magic foi adquirida pela Red Hat em janeiro de 2025 e descontinuou as versões comunitárias do DeepSparse, SparseML, SparseZoo e Sparsify em 2 de junho de 2025. As ferramentas ainda funcionam, mas não recebem mais atualizações nem suporte. Para aceleração de CPU com manutenção contínua, consulta as integrações do OpenVINO e do ONNX.
Este guia explica como implantar YOLOv5 com o DeepSparse da Neural Magic. No pacote ultralytics, a integração da Neural Magic faz o mesmo.
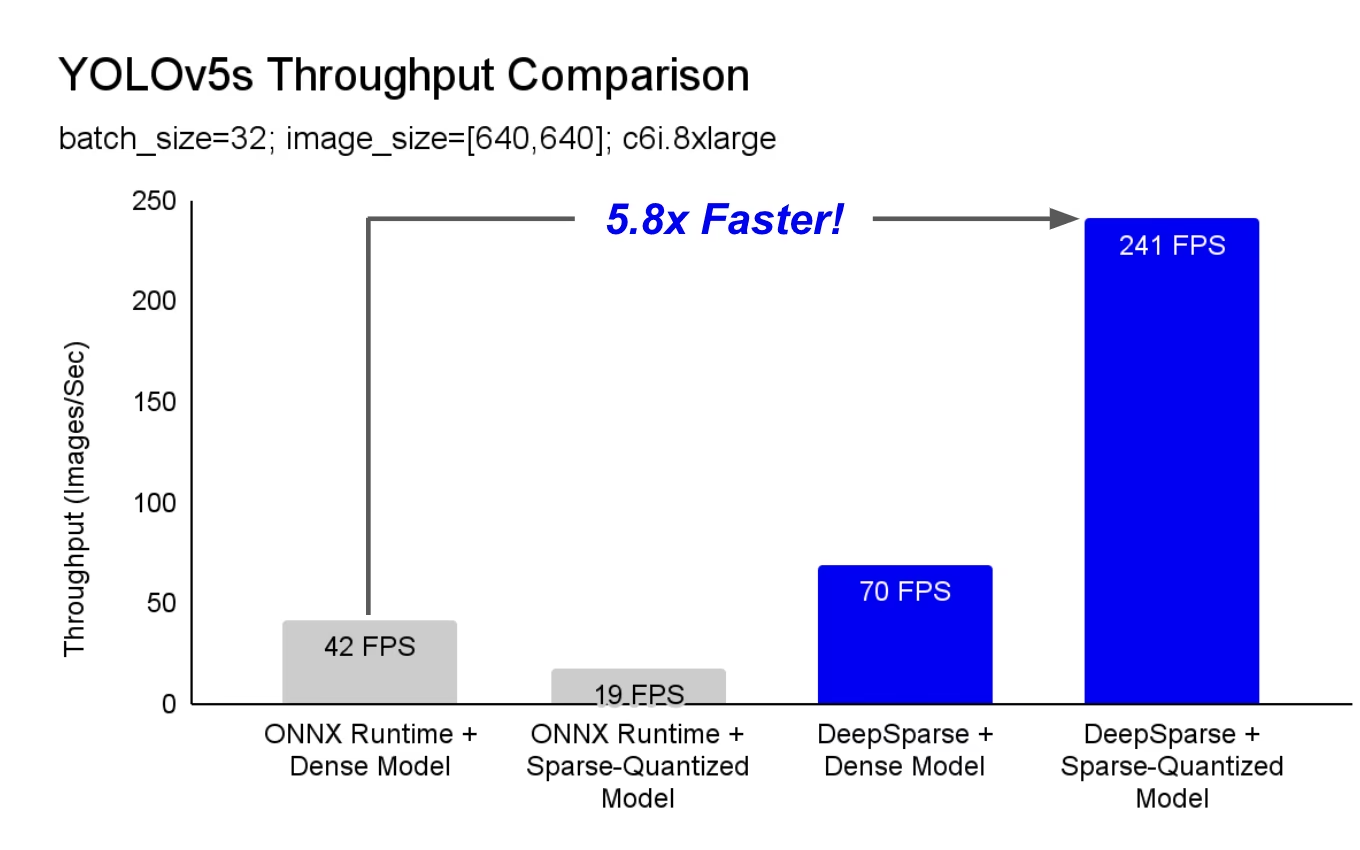
DeepSparse é um ambiente de execução de inferência otimizado para CPUs. Nos benchmarks abaixo, um YOLOv5s podado e quantizado é 5,8 vezes mais rápido no DeepSparse do que o modelo denso no ONNX Runtime, na mesma máquina.
O DeepSparse busca permitir que cargas de trabalho de aprendizado profundo atendam aos requisitos de desempenho de produção em CPUs, sem a complexidade e o custo de aceleradores de hardware dedicados:
- Implantações flexíveis: Executa de maneira consistente na nuvem, no data center e na borda, com qualquer fornecedor de hardware, de Intel a AMD e ARM
- Escalabilidade: escale verticalmente para centenas de núcleos, horizontalmente com Kubernetes padrão ou com abstração completa por meio de Serverless.
- Integração simples: APIs para integrar seu modelo a um aplicativo e monitorá-lo em produção.
Como o DeepSparse alcança desempenho equivalente ao de GPUs?#
O DeepSparse aproveita a esparsidade do modelo para acelerar o desempenho.
A esparsificação por meio da poda e da quantização é uma técnica amplamente estudada que permite reduzir em ordens de grandeza o tamanho e o poder computacional necessários para executar uma rede, mantendo alta precisão. O DeepSparse reconhece a esparsidade, ou seja, ignora os parâmetros zerados e reduz o poder computacional necessário em uma passagem forward. Como a computação esparsa passa a ser limitada pela memória, o DeepSparse executa a rede em profundidade, dividindo o problema em colunas de tensores, faixas verticais de computação que cabem no cache.
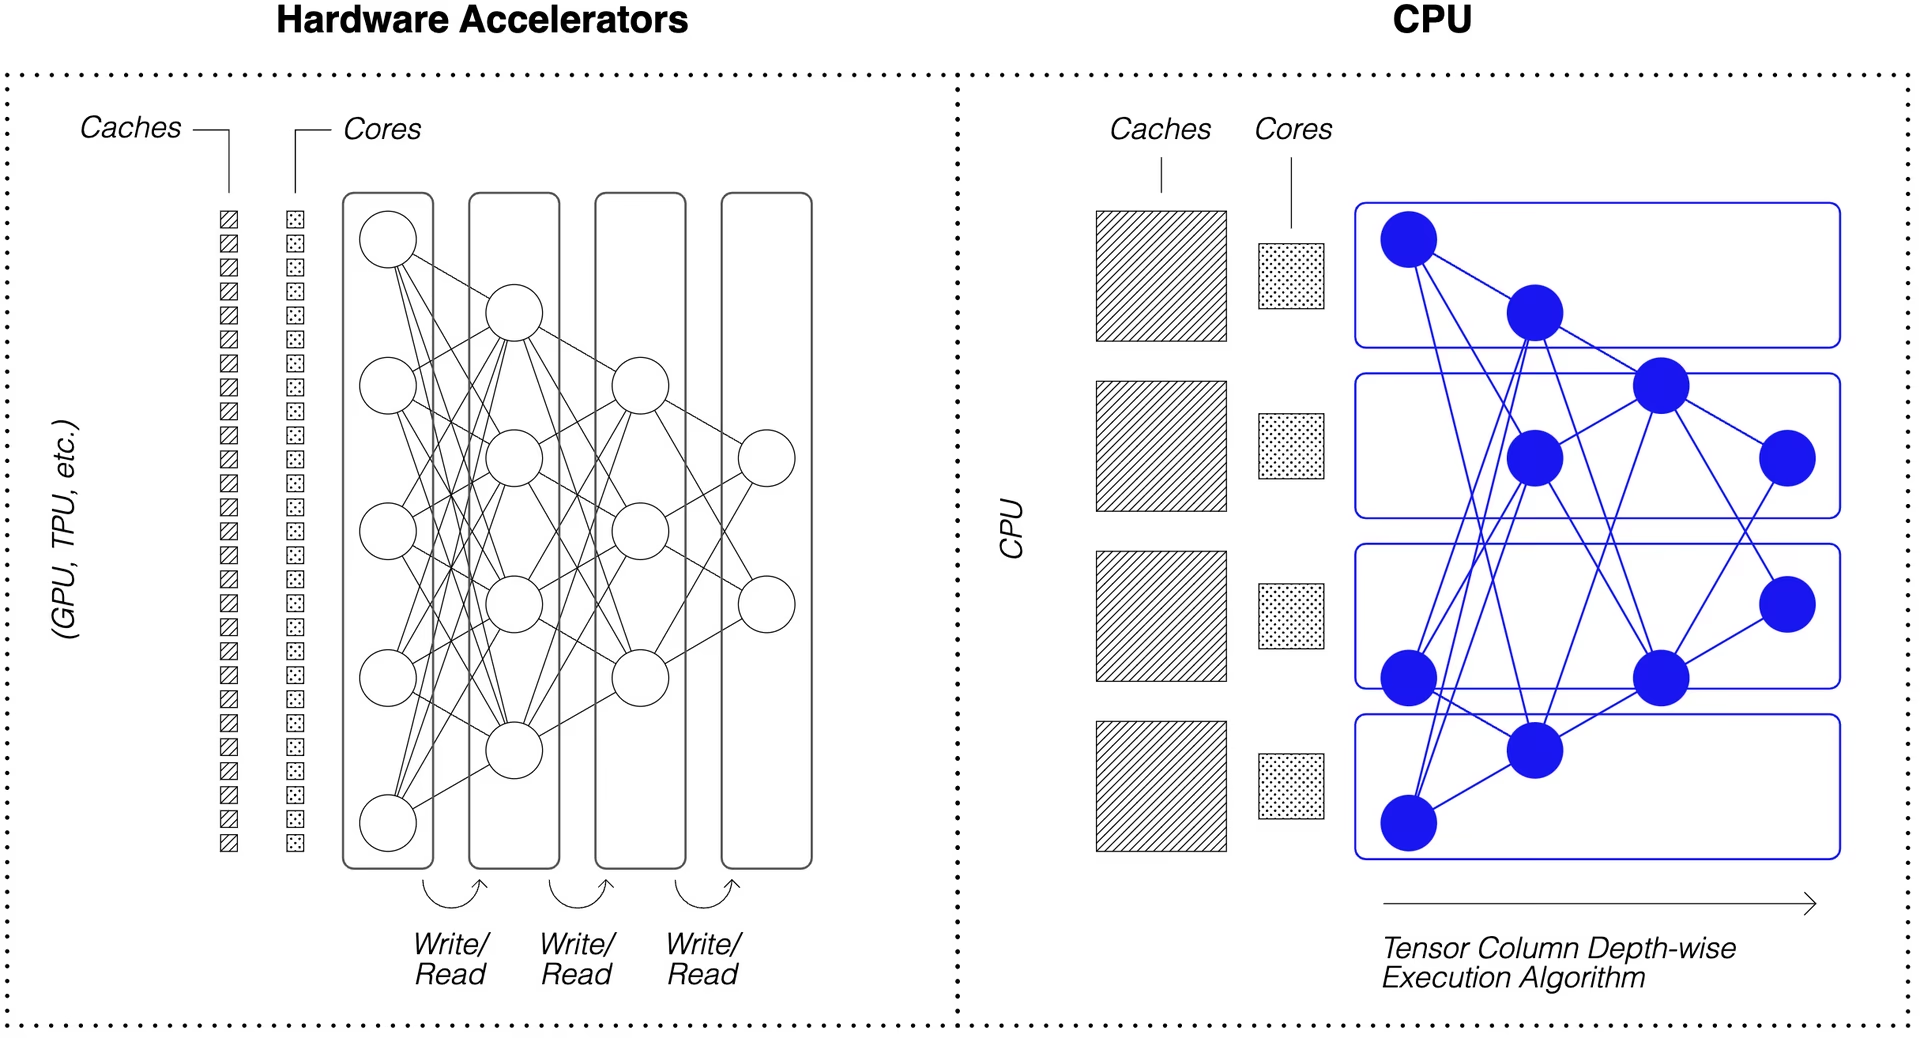
A execução em profundidade de redes esparsas no cache é o que permite ao DeepSparse oferecer inferência rápida em CPUs.
Como criar uma versão esparsa do YOLOv5 treinada com os meus dados?#
O repositório de modelos de código aberto da Neural Magic, SparseZoo, contém checkpoints pré-esparsificados de cada modelo YOLOv5. Com o SparseML, integrado à Ultralytics, podes ajustar um checkpoint esparso aos teus dados com um único comando CLI.
Consulta a integração do SparseML com o YOLOv5 para mais detalhes.
Uso do DeepSparse#
Vamos mostrar um exemplo de benchmark e implantação de uma versão esparsa do YOLOv5s com o DeepSparse.
Instalar o DeepSparse#
Executa o comando a seguir para instalar o DeepSparse. Recomendamos usar um ambiente virtual com Python.
pip install "deepsparse[server,yolo,onnxruntime]"Obter um arquivo ONNX#
O DeepSparse aceita um modelo no formato ONNX, fornecido como:
- Um stub do SparseZoo que identifica um arquivo ONNX no SparseZoo
- Um caminho local para um modelo ONNX no sistema de arquivos
Os exemplos abaixo usam os checkpoints padrão denso e podado-quantizado do YOLOv5s, identificados pelos seguintes stubs do SparseZoo:
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Implantar um modelo#
O DeepSparse oferece APIs práticas para integrar o teu modelo a uma aplicação.
Para testar os exemplos de implantação abaixo, baixa uma imagem de amostra e salva-a como basilica.jpg com o seguinte comando:
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgAPI Python#
Pipelines envolve o pré-processamento e o pós-processamento da saída em torno do ambiente de execução, oferecendo uma interface simples para adicionar o DeepSparse a um aplicativo. A integração DeepSparse-Ultralytics inclui um Pipeline pronto para uso que aceita imagens brutas e gera as caixas delimitadoras.
Cria um Pipeline e executa a inferência:
from deepsparse import Pipeline

# lista de imagens no sistema de arquivos local
images = ["basilica.jpg"]

# cria o Pipeline
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# executa inferência nas imagens e recebe caixas delimitadoras + classes
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
Se estiveres executando na nuvem, podes receber um erro informando que o OpenCV não consegue encontrar libGL.so.1. Podes instalar a biblioteca ausente:
apt-get install libgl1Ou usar a versão headless do OpenCV, que evita completamente as dependências de GUI:
pip install opencv-python-headlessServidor HTTP#
O DeepSparse Server é executado sobre o popular framework web FastAPI e o servidor web Uvicorn. Com um único comando CLI, você pode configurar um endpoint de serviço de modelos com o DeepSparse. O Server oferece suporte a qualquer Pipeline do DeepSparse, incluindo a detecção de objetos com YOLOv5, permitindo enviar imagens brutas ao endpoint e receber as caixas delimitadoras.
Inicia o Server com o YOLOv5s podado-quantizado:
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Um exemplo de solicitação que usa o pacote requests do Python:
import json
from contextlib import ExitStack

import requests

# lista de imagens para inferência (arquivos locais no lado do cliente)
path = ["basilica.jpg"]

# envia a solicitação por HTTP para o endpoint /predict/from_files
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# a resposta é retornada em JSON
annotations = json.loads(resp.text)  # dicionário de resultados da anotação
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]
CLI de anotação#
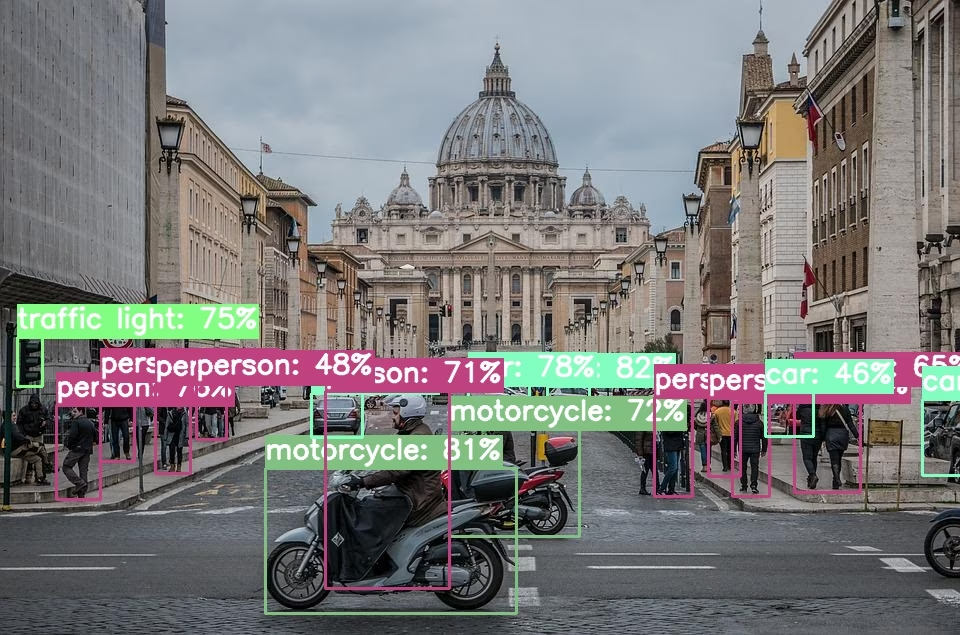
Você também pode usar o comando annotate para fazer com que o mecanismo salve uma foto anotada no disco. Experimente --source 0 para anotar a transmissão da webcam ao vivo.
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpgExecutar o comando acima criará uma pasta annotation-results e salvará a imagem anotada dentro dela.
Desempenho nos benchmarks#
Vamos comparar a taxa de transferência do DeepSparse com a do ONNX Runtime no YOLOv5s, usando o script de benchmark do DeepSparse.
Os benchmarks foram executados em uma instância AWS c6i.8xlarge (16 núcleos).
Comparação de desempenho com lote 32#
Referência do ONNX Runtime#
Com lote 32, o ONNX Runtime alcança 42 imagens/s com o YOLOv5s denso padrão:
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
Desempenho do DeepSparse com modelo denso#
Embora o DeepSparse ofereça o melhor desempenho com modelos esparsos otimizados, ele também tem bom desempenho com o YOLOv5s denso padrão.
Com lote de 32, o DeepSparse processa 70 imagens/s com o YOLOv5s denso padrão, uma melhoria de 1,7x em relação ao ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
Desempenho do DeepSparse com modelo esparso#
Quando a esparsidade é aplicada ao modelo, os ganhos de desempenho do DeepSparse em relação ao ONNX Runtime são ainda maiores.
Com lote de 32, o DeepSparse processa 241 imagens/s com o YOLOv5s podado e quantizado, uma melhoria de 5,8x em relação ao ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
Comparação de desempenho com lote 1#
O DeepSparse também consegue obter um ganho de velocidade em relação ao ONNX Runtime no cenário de lote 1, sensível à latência.
Referência do ONNX Runtime#
Com lote 1, o ONNX Runtime alcança 48 imagens/s com o YOLOv5s denso padrão.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
Desempenho do DeepSparse com modelo esparso#
Com lote de 1, o DeepSparse processa 135 itens/s com um YOLOv5s podado e quantizado, um ganho de 2,8x em relação ao ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
Como as instâncias c6i.8xlarge têm instruções VNNI, é possível aumentar ainda mais a taxa de transferência do DeepSparse podando os pesos em blocos de 4.
Com lote de 1, o DeepSparse processa 180 itens/s com um YOLOv5s podado e quantizado com 4 blocos, um ganho de 3,7x em relação ao ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
Comece a usar o DeepSparse#
Pesquisa ou testes? O DeepSparse Community é gratuito para pesquisa e testes. Comece com o README do DeepSparse.
Para saber mais sobre como implantar o YOLOv5 com o DeepSparse, confira os exemplos de YOLOv5 com DeepSparse e a publicação do blog da Ultralytics sobre a integração com o DeepSparse.
Perguntas frequentes#
Não. O DeepSparse é um runtime de CPU, e os benchmarks acima foram medidos em uma instância AWS
c6i.8xlargecom 16 núcleos, sem nenhum acelerador.Exporte-o para ONNX com
python export.py --weights best.pt --include onnxe passe o caminho do arquivo comomodel_path, em vez de usar um identificador do SparseZoo. Os modelos densos ainda se beneficiam do runtime, e os modelos podados e quantizados obtêm o maior ganho.Faça o ajuste fino de um dos checkpoints SparseZoo pré-esparsificados com seus dados usando o SparseML, que preserva a estrutura de esparsidade durante o treinamento; em seguida, exporte para ONNX.
Não. As versões comunitárias foram descontinuadas em 2 de junho de 2025, e os pacotes no PyPI foram congelados. Os pipelines existentes continuam funcionando, mas novas implantações devem considerar as opções de OpenVINO ou ONNX Runtime, que recebem manutenção ativa.
Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.