Arquitetura Ultralytics YOLOv5#
YOLOv5 (v6.0/6.1) é um algoritmo de detecção de objetos desenvolvido pela Ultralytics. Este artigo explica a arquitetura do YOLOv5, as estratégias de aumento de dados, as metodologias de treinamento e as técnicas de cálculo da perda. Entendê-las ajudará você a aplicar a detecção de objetos em áreas como vigilância, veículos autônomos e reconhecimento de imagens.
1. Estrutura do modelo#
A arquitetura YOLOv5 é composta por três partes principais:
- Base: esta é a parte principal da rede. No YOLOv5, a base é projetada com a estrutura
CSPDarknet53, uma modificação da arquitetura Darknet usada nas versões anteriores. - Neck: esta parte liga o backbone à cabeça. No YOLOv5, são utilizadas as estruturas
SPPF(Spatial Pyramid Pooling - Fast) ePANet(Path Aggregation Network). - Cabeça: esta parte é responsável por gerar a saída final. O YOLOv5 usa
YOLOv3 Headpara essa finalidade.
A estrutura do modelo é apresentada na imagem abaixo. Os detalhes da estrutura do modelo encontram-se em models/yolov5l.yaml.
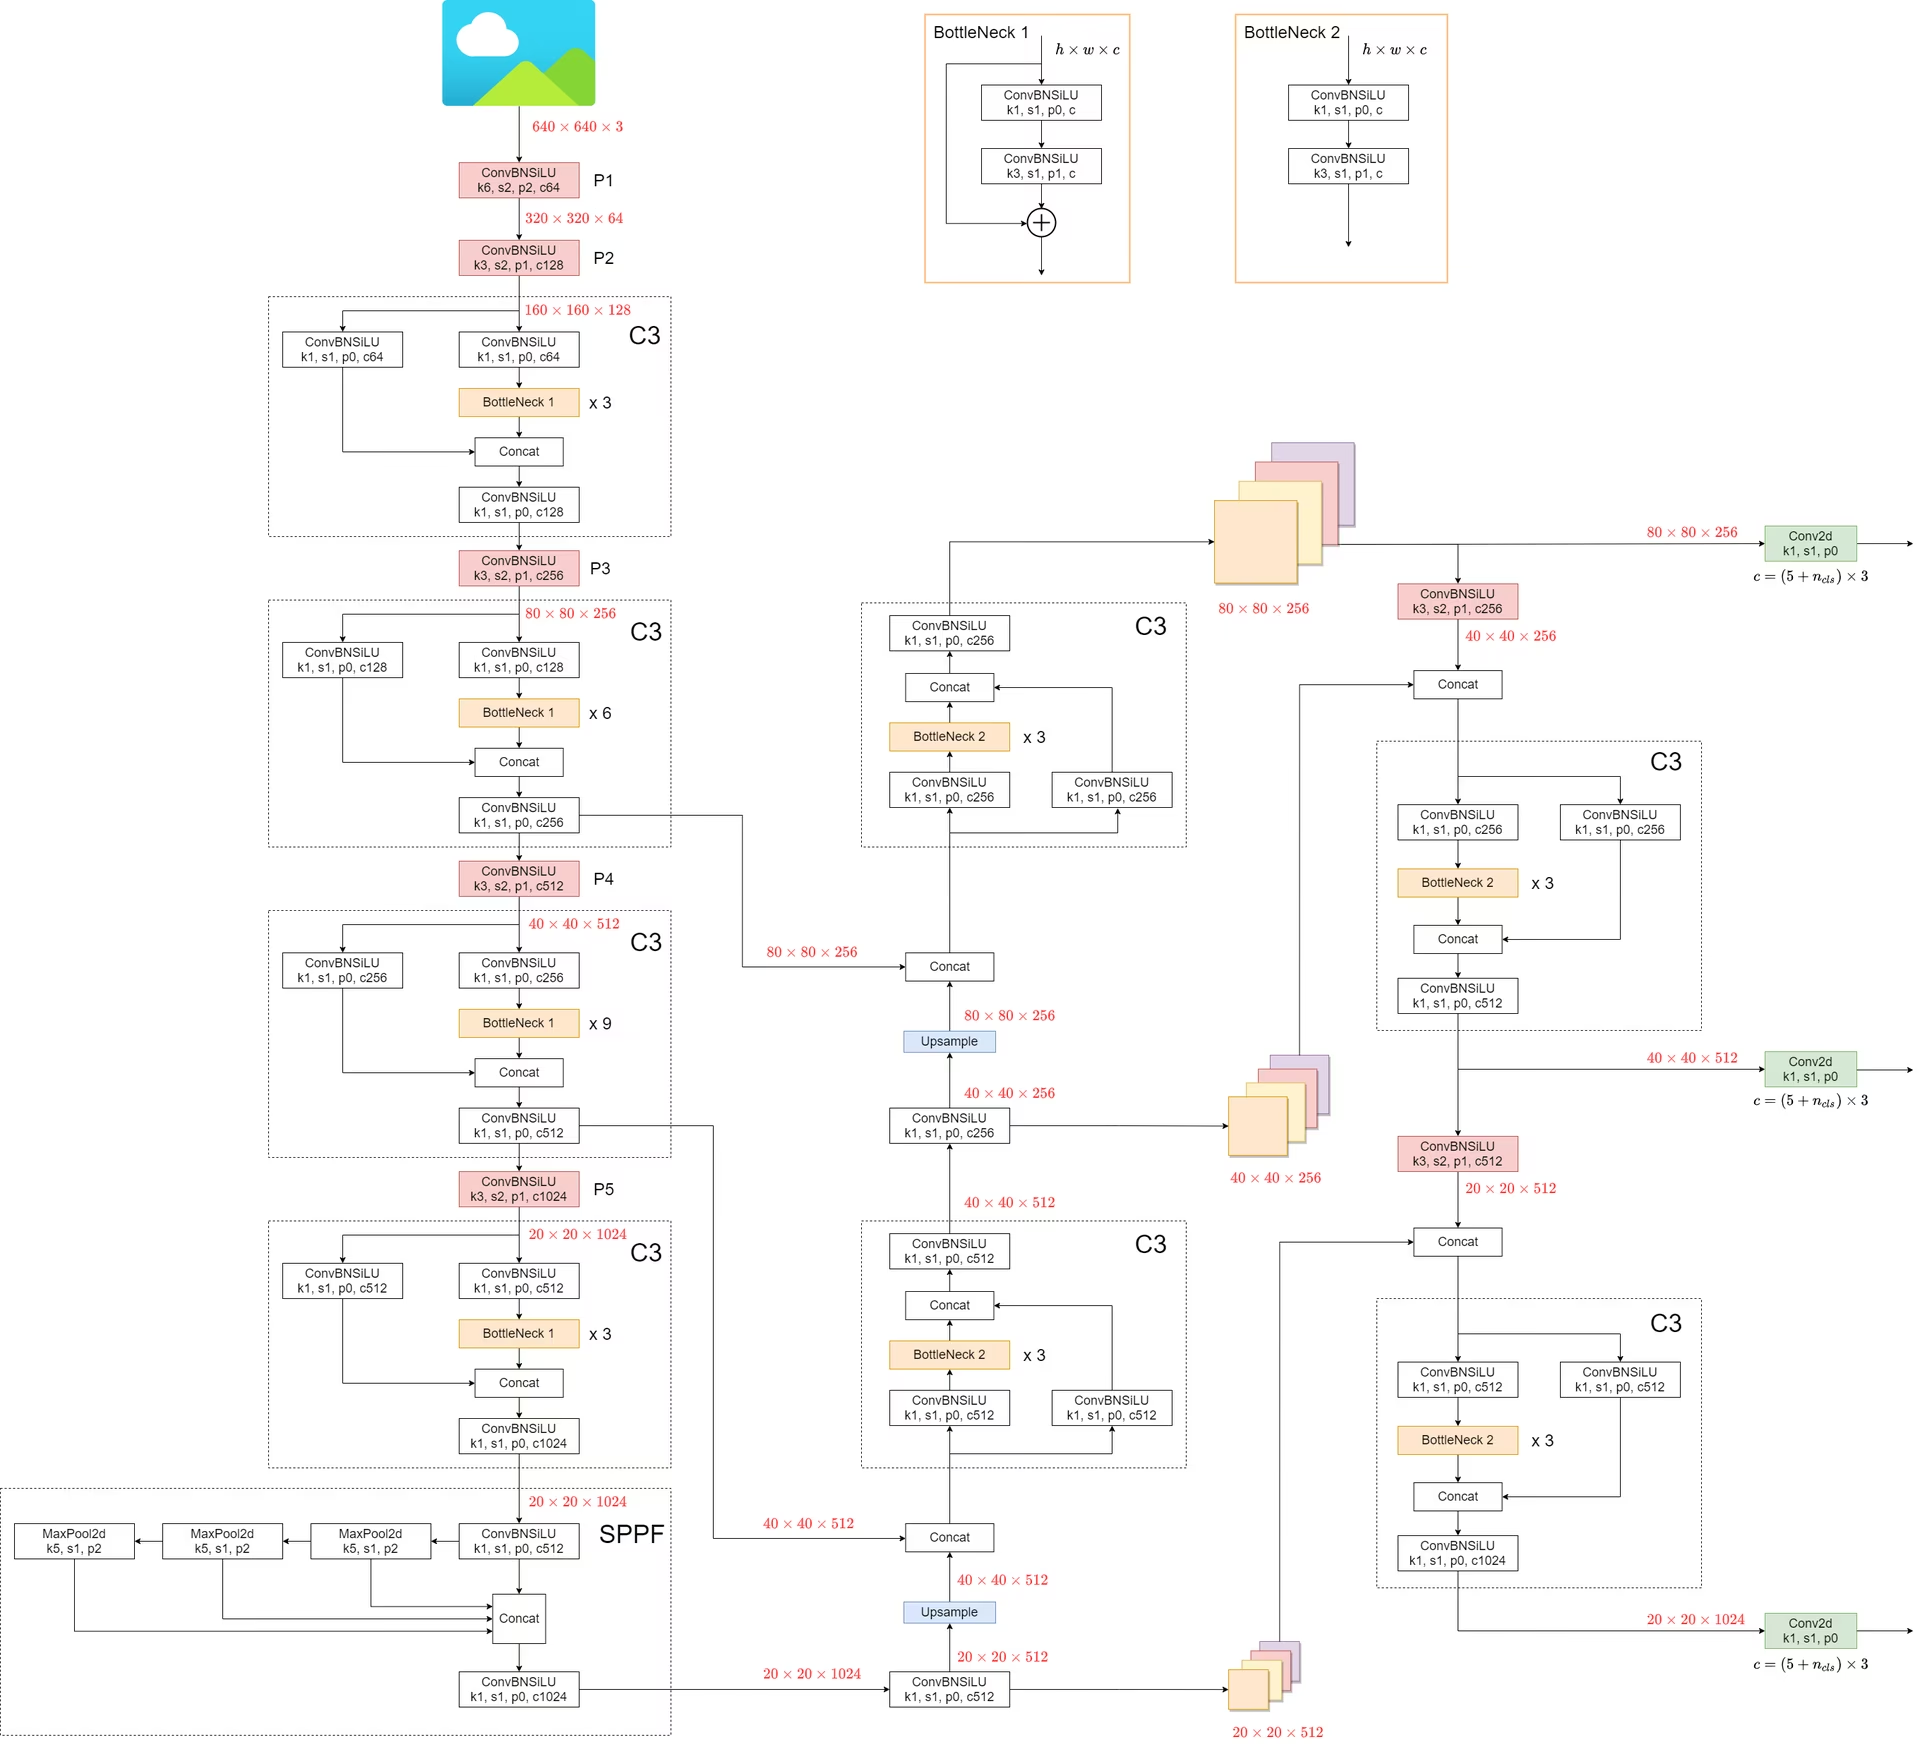
O YOLOv5 introduz algumas melhorias notáveis em relação às versões anteriores:
- A estrutura
Focus, presente em versões anteriores, é substituída por uma estrutura6x6 Conv2d. Esta alteração aumenta a eficiência #4825. - A estrutura
SPPé substituída porSPPF. Esta alteração mais do que duplica a velocidade de processamento, mantendo a mesma saída.
Para testar a velocidade de SPP e SPPF, podes usar o seguinte código:
Exemplo de análise de desempenho da velocidade de SPP vs SPPF (clique para abrir)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
Resultado:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Técnicas de aumento de dados#
O YOLOv5 usa várias técnicas de aumento de dados para melhorar a capacidade de generalização do modelo e reduzir o sobreajuste. Estas técnicas incluem:
-
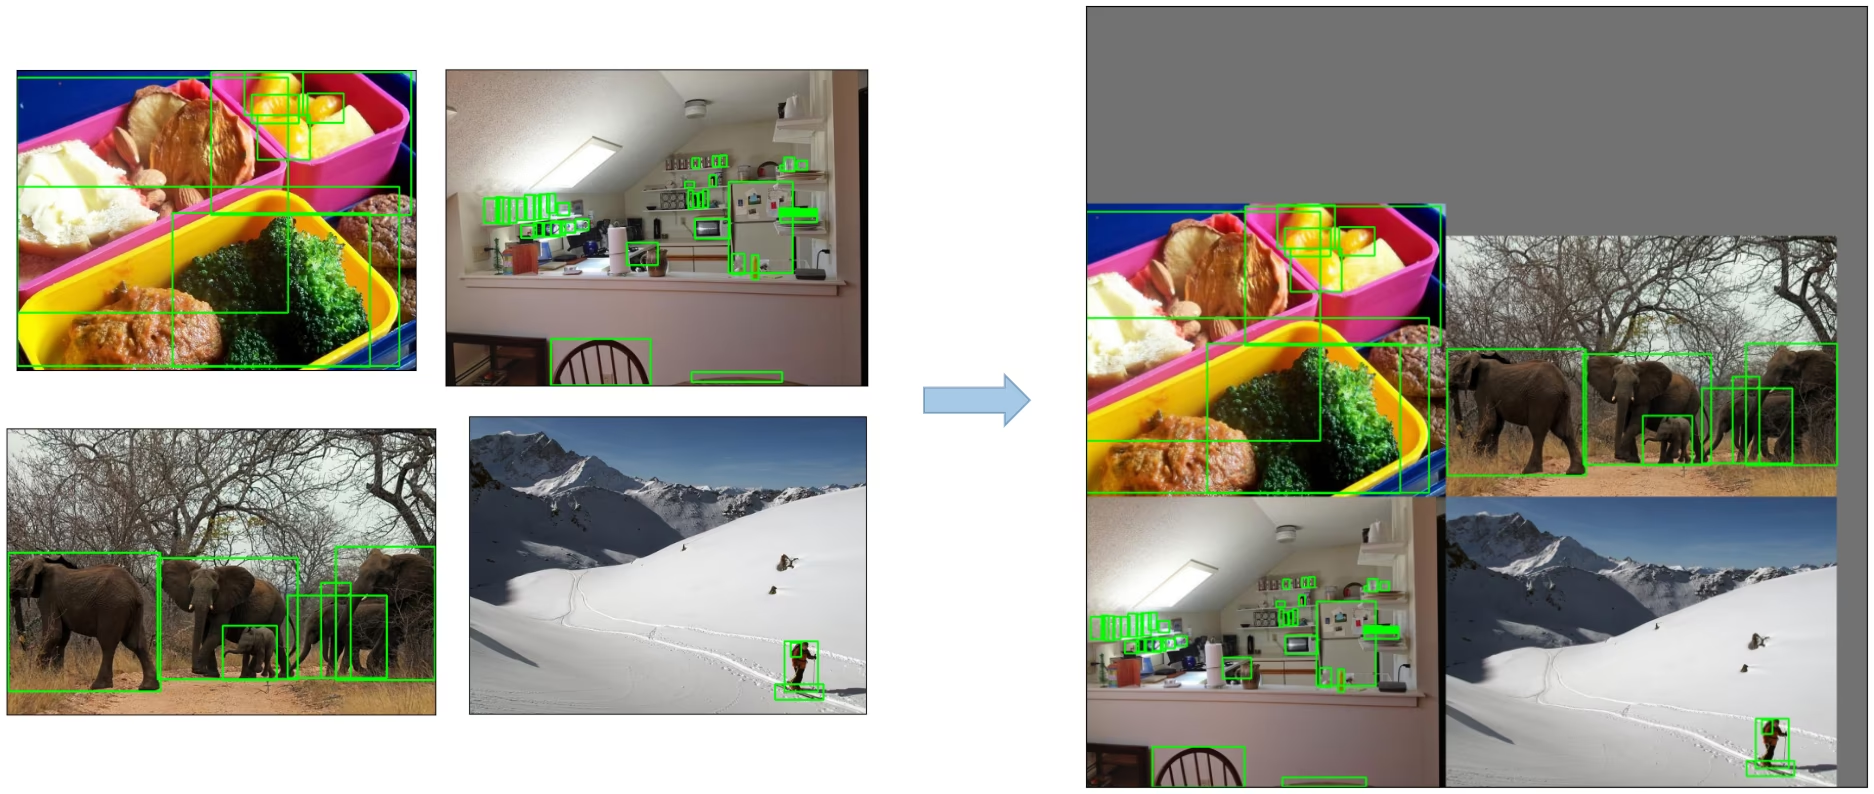
Aumento Mosaic: técnica de processamento de imagens que combina quatro imagens de treinamento em uma, ajudando os modelos de detecção de objetos a lidar melhor com diferentes escalas e translações de objetos.
-
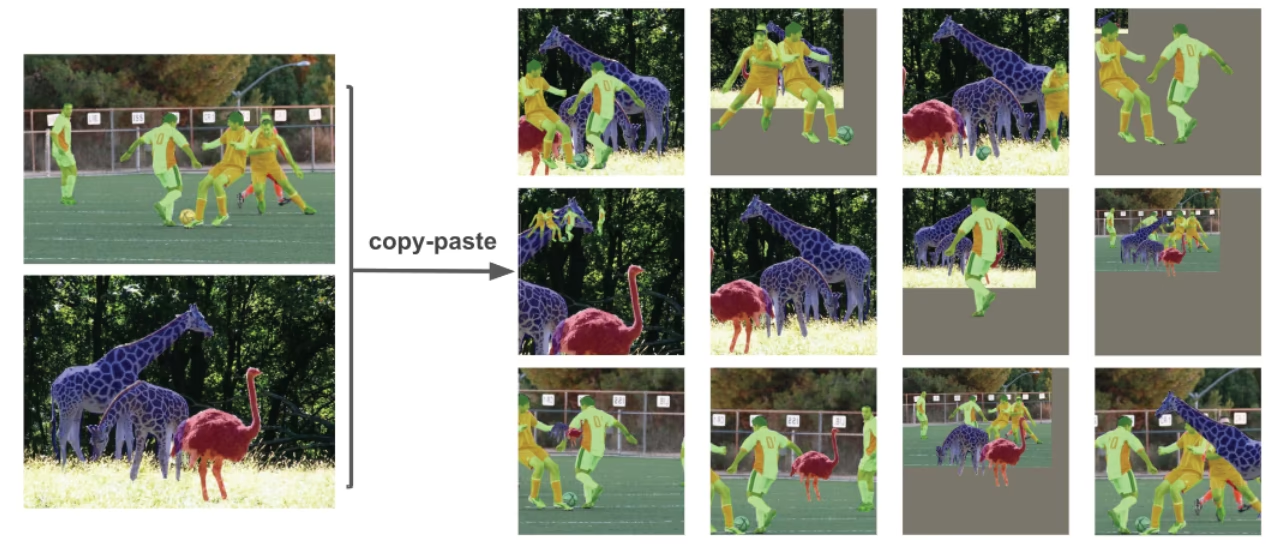
Aumento Copy-Paste: método de aumento de dados que copia instâncias de objetos usando suas máscaras de segmentação e as cola em imagens de treinamento, gerando novas amostras de treinamento.
-
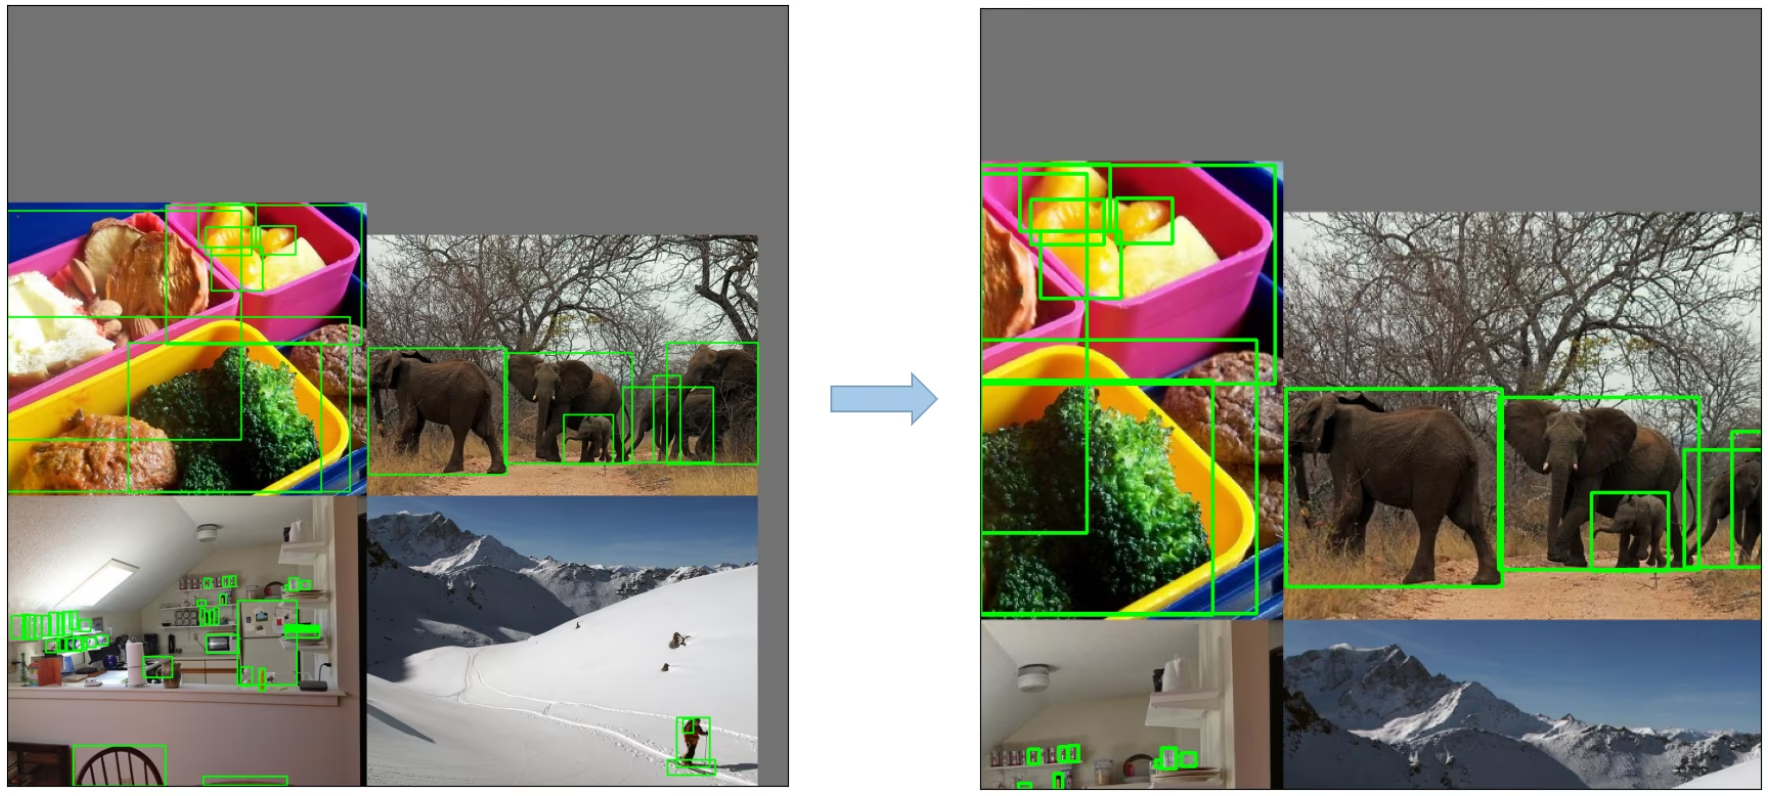
Transformações afins aleatórias: incluem rotação, escala, translação e cisalhamento aleatórios das imagens.
-
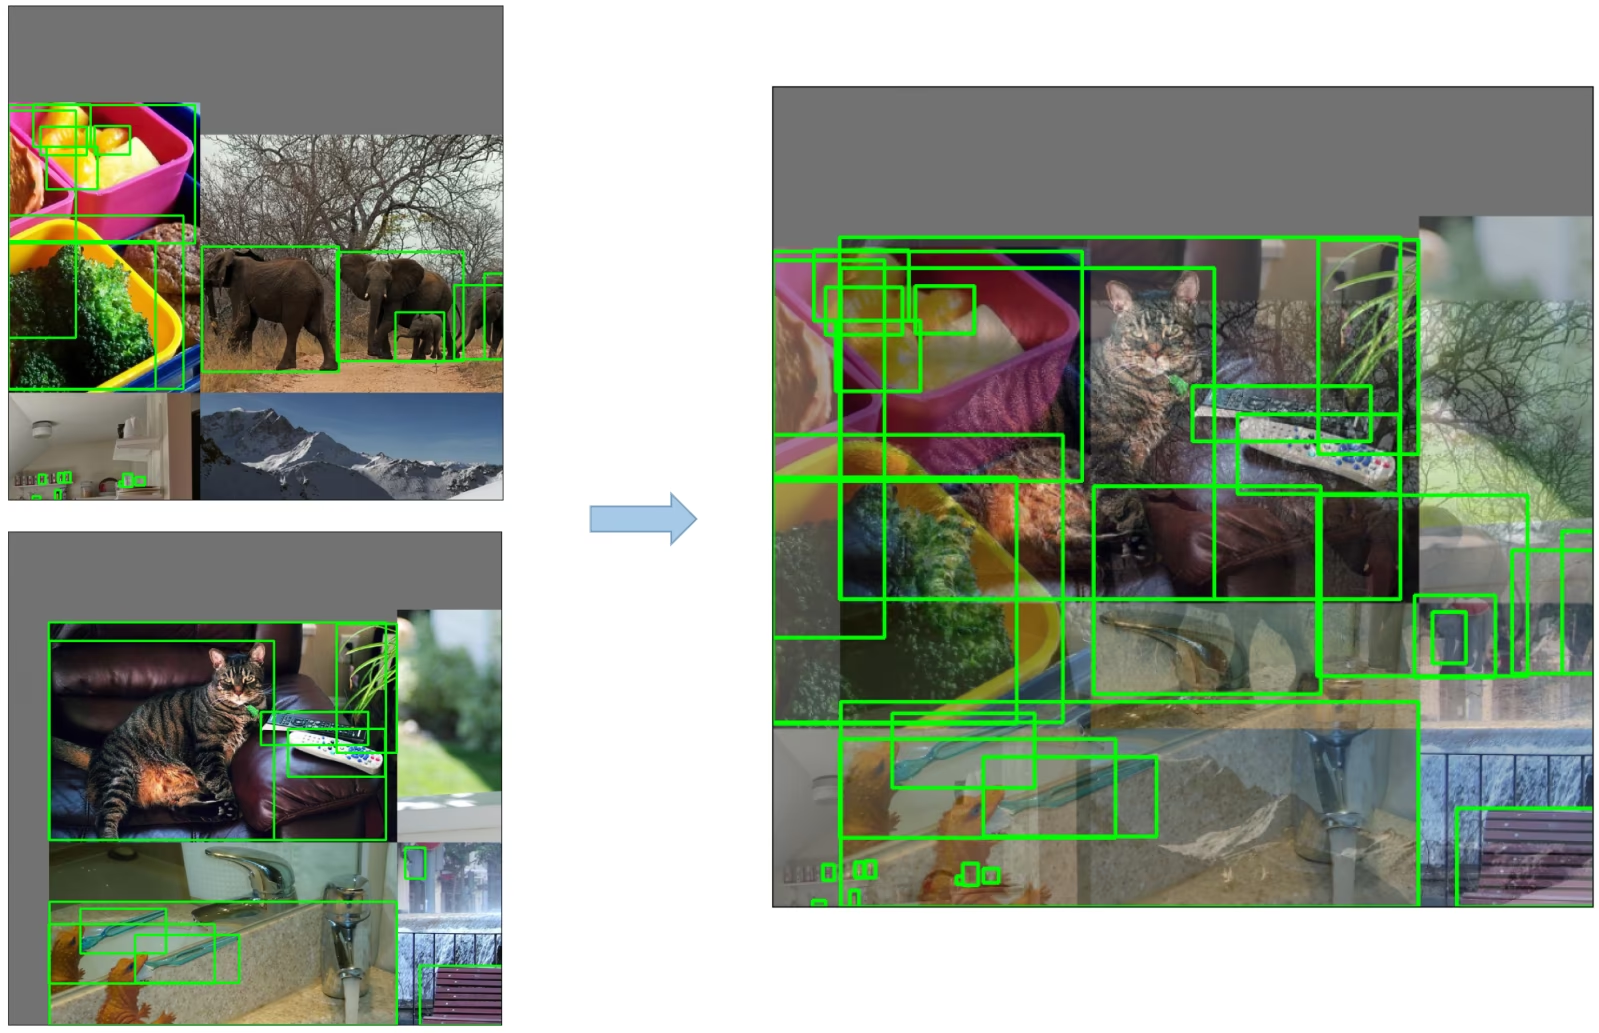
Aumento MixUp: método que cria imagens compostas através de uma combinação linear de duas imagens e das respetivas etiquetas.
-
Albumentations: uma biblioteca de ampliação de imagens que oferece suporte a uma grande variedade de técnicas de ampliação.
-
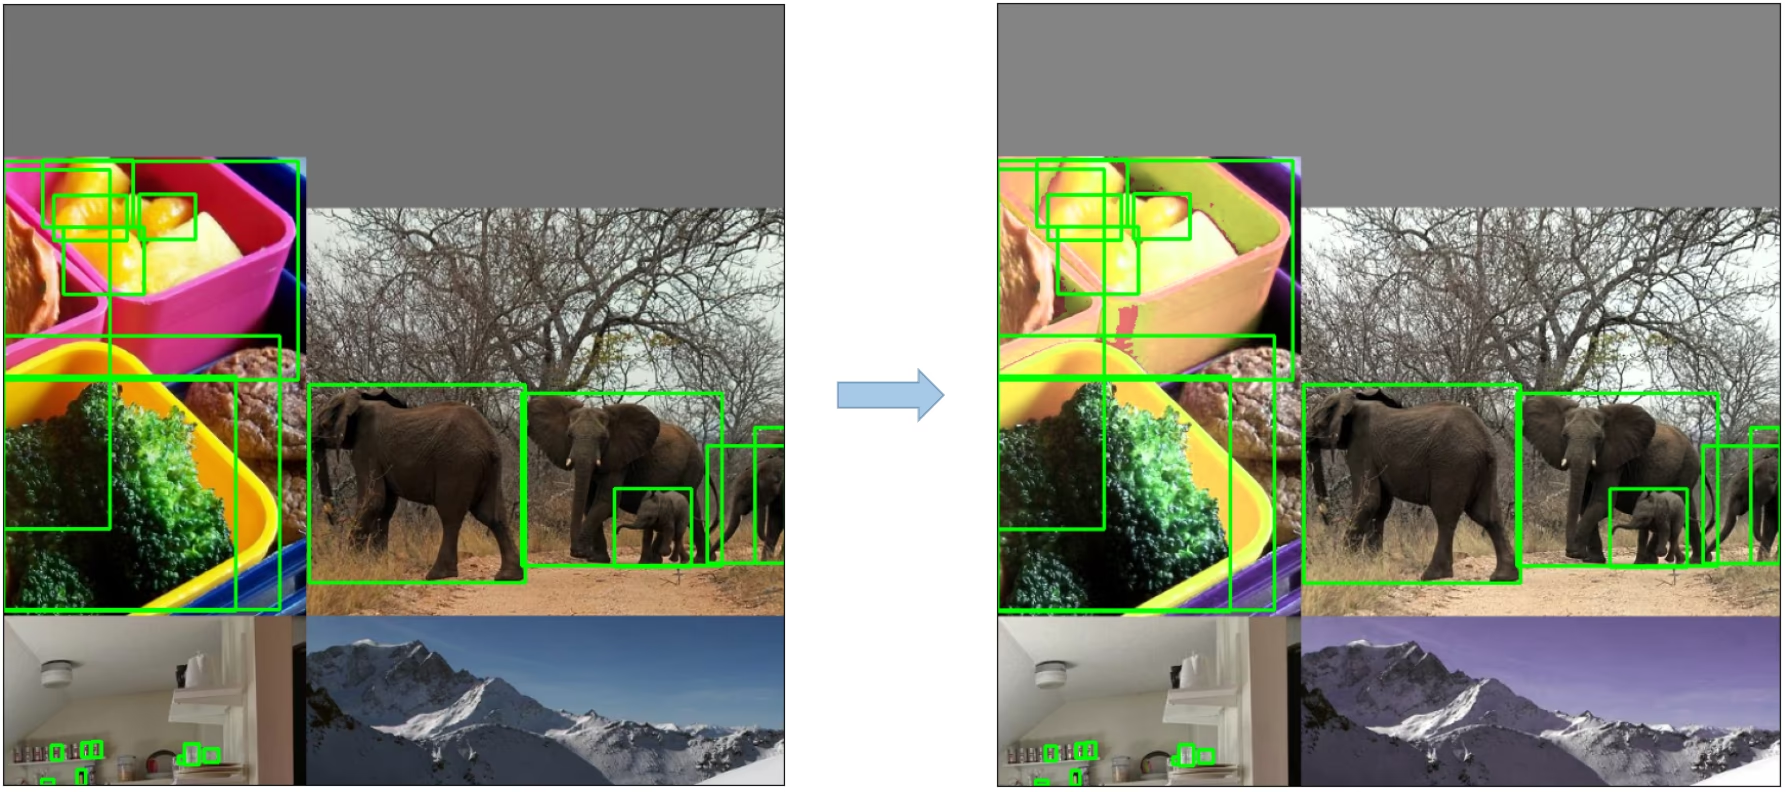
Aumento HSV: alterações aleatórias à tonalidade, à saturação e ao valor das imagens.
-
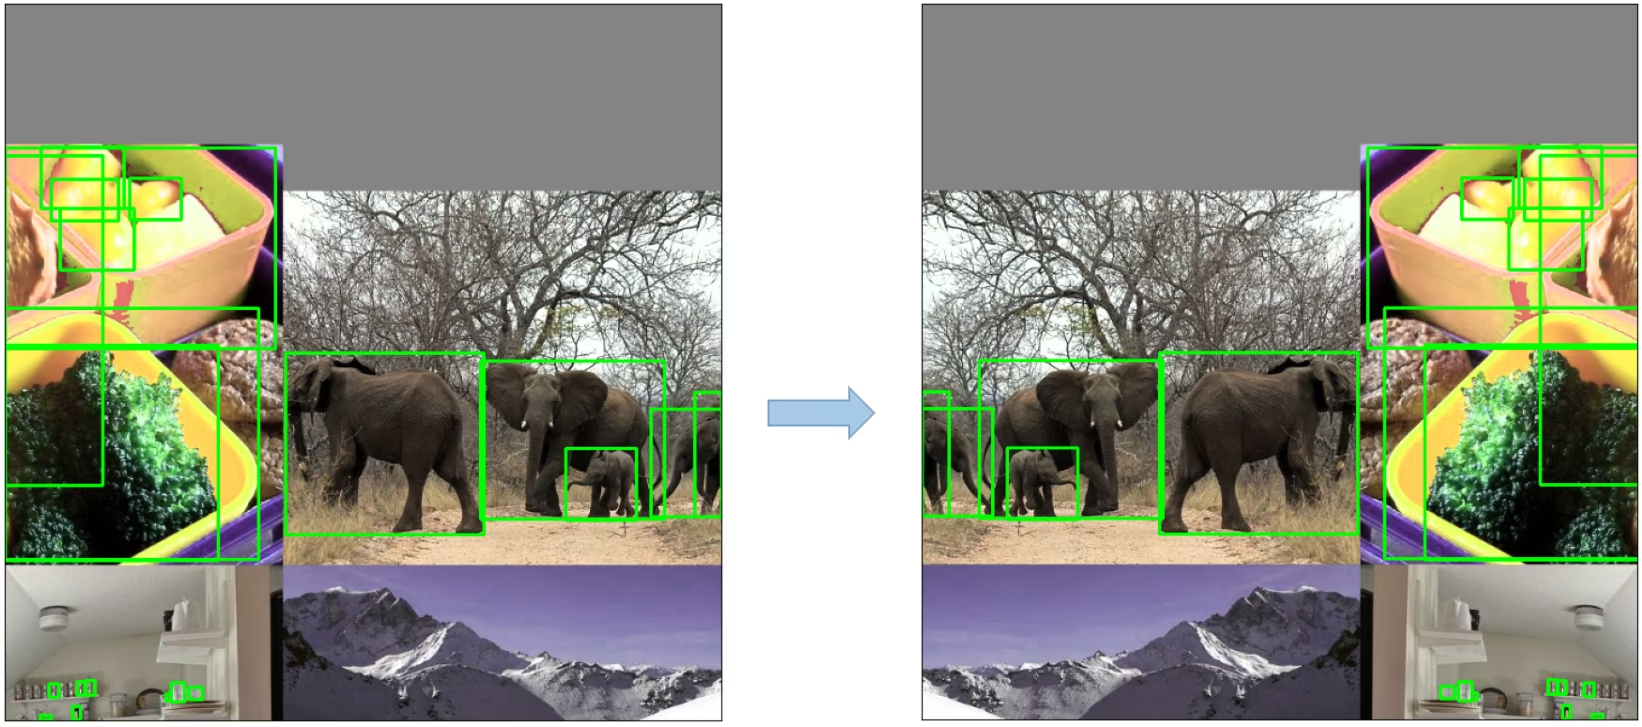
Inversão horizontal aleatória: método de aumento que inverte aleatoriamente as imagens na horizontal.
3. Estratégias de treino#
O YOLOv5 aplica várias estratégias de treinamento para melhorar o desempenho do modelo. Entre elas estão:
- Treino multiescala: durante o processo de treino, as imagens de entrada são redimensionadas aleatoriamente para um tamanho entre 0,5 e 1,5 vezes o tamanho original.
- AutoAnchor: essa estratégia otimiza as caixas-âncora anteriores para corresponder às características estatísticas das caixas de referência nos seus dados personalizados.
- Agendador de aquecimento e taxa de aprendizado cosseno: Um método para ajustar a taxa de aprendizado e melhorar o desempenho do modelo.
- Média móvel exponencial (EMA): Uma estratégia que usa a média dos parâmetros das etapas anteriores para estabilizar o processo de treinamento e reduzir o erro de generalização.
- Treinamento com precisão mista: método que realiza operações no formato de precisão de 16 bits, reduzindo o uso de memória e aumentando a velocidade computacional.
- Evolução de hiperparâmetros: Uma estratégia para ajustar automaticamente os hiperparâmetros e alcançar o desempenho ideal. Consulta o tutorial de Evolução de hiperparâmetros.
4. Recursos adicionais#
4.1 Calcular as perdas#
A perda no YOLOv5 é calculada como a combinação de três componentes individuais:
- Perda de classes (perda BCE): perda de entropia cruzada binária, que mede o erro da tarefa de classificação.
- Perda de objetividade (perda BCE): outra perda de entropia cruzada binária, que calcula o erro ao detectar se há ou não um objeto em determinada célula da grade.
- Perda de localização (perda CIoU): a perda completa de IoU mede o erro ao localizar o objeto dentro da célula da grade.
A função de perda geral é representada por:
4.2 Balancear as perdas#
As perdas de objetividade das três camadas de predição (P3, P4, P5) recebem pesos diferentes. Os pesos de balanceamento são, respectivamente, [4.0, 1.0, 0.4]. Essa abordagem garante que as predições em diferentes escalas contribuam de forma adequada para a perda total.
4.3 Eliminar a sensibilidade à grade#
A arquitetura do YOLOv5 faz mudanças importantes na estratégia de predição de caixas em comparação com versões anteriores do YOLO. No YOLOv2 e no YOLOv3, as coordenadas das caixas eram preditas diretamente usando a ativação da última camada.

No entanto, no YOLOv5, a fórmula para predizer as coordenadas das caixas foi atualizada para reduzir a sensibilidade à grade e impedir que o modelo prediga dimensões de caixa sem limites.
As fórmulas revisadas para calcular a caixa delimitadora predita são as seguintes:
Compare o deslocamento do ponto central antes e depois do escalonamento. O intervalo de deslocamento do ponto central é ajustado de (0, 1) para (-0.5, 1.5). Assim, o deslocamento pode chegar mais facilmente a 0 ou 1.

Compare a proporção de escala da altura e da largura (em relação à âncora) antes e depois do ajuste. As equações originais de caixas do YOLO/Darknet têm uma falha grave. A largura e a altura não têm limites, pois são simplesmente out=exp(in), o que é perigoso, já que pode levar a gradientes descontrolados, instabilidades, perdas NaN e, por fim, à interrupção completa do treinamento.

4.4 Construir os alvos#
O processo de construção dos alvos no YOLOv5 é fundamental para a eficiência do treinamento e a precisão do modelo. Ele envolve atribuir as caixas de referência às células da grade apropriadas no mapa de saída e associá-las às caixas de âncora correspondentes.
Este processo segue estas etapas:
- Calcula a proporção entre as dimensões da caixa de referência e as dimensões de cada modelo de âncora.

- Se a proporção calculada estiver dentro do limite, associa a caixa de referência à âncora correspondente.

- Atribui a âncora correspondente às células apropriadas, lembrando que, devido ao deslocamento revisado do ponto central, uma caixa de referência pode ser atribuída a mais de uma âncora, pois o intervalo de deslocamento do ponto central é ajustado de (0, 1) para (-0.5, 1.5), possibilitando correspondências adicionais.

Dessa forma, o processo de construção dos alvos garante que cada objeto de referência seja atribuído e associado corretamente durante o treinamento, permitindo que o YOLOv5 aprenda a tarefa de detecção de objetos com mais eficiência.
Conclusão#
O YOLOv5 representa um avanço significativo na evolução da detecção de objetos em tempo real. Suas escolhas arquiteturais, estratégias de treinamento e aprimoramentos de engenharia oferecem alto desempenho e eficiência em relação às versões anteriores do YOLO.
As principais melhorias do YOLOv5 incluem refinamentos de arquitetura, como o stem 6x6 Conv2d e SPPF, um amplo conjunto de técnicas de aumento de dados, estratégias de treinamento como AutoAnchor e EMA, além de ajustes no cálculo da perda e na criação de alvos. Em conjunto, essas melhorias aumentam a precisão e a eficiência da detecção de objetos, mantendo a velocidade pela qual os modelos YOLO são conhecidos.
Perguntas frequentes#
Um backbone CSPDarknet53 extrai características, um neck SPPF e PANet as combina entre escalas, e uma head no estilo YOLOv3 prediz caixas, objetividade e classes nos strides 8, 16 e 32. A lista completa de camadas está em
models/yolov5l.yaml.O SPPF encadeia três operações de max pooling 5x5, em vez de executar em paralelo operações de pooling 5x5, 9x9 e 13x13. O resultado é matematicamente idêntico, mas é mais de duas vezes mais rápido, como mostra o trecho de criação de perfil acima.
O deslocamento original do YOLO não podia chegar exatamente a 0 ou 1, então era difícil predizer objetos centralizados nos limites da grade. Escalar a sigmoid para o intervalo (-0.5, 1.5) elimina essa sensibilidade à grade, e elevar
2σao quadrado para limitar a largura e a altura das predições a 4x o tamanho da âncora evita os gradientes descontrolados causados pela exponencial sem limites.Qualquer âncora cujas proporções de largura e altura em relação à caixa estejam dentro de
anchor_t(4.0 por padrão) corresponde; além disso, o intervalo de deslocamento ampliado permite atribuir a caixa também às duas células vizinhas da grade. Portanto, um único objeto pode gerar vários alvos positivos, acelerando a convergência.
Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.