Aprendizagem por transferência com camadas congeladas no YOLOv5#
📚 Este guia explica como congelar camadas do YOLOv5 🚀 ao implementar aprendizagem por transferência. A aprendizagem por transferência é uma técnica poderosa de aprendizagem automática (ML) que te permite voltar a treinar rapidamente um modelo com novos dados, sem treinar toda a rede desde o início. Ao congelar os pesos das camadas iniciais e atualizar apenas os parâmetros das camadas posteriores, podes reduzir significativamente os requisitos de recursos computacionais e o tempo de treino. No entanto, esta abordagem pode afetar ligeiramente a precisão final do modelo.
Antes de começar#
Primeiro, clona o repositório YOLOv5 e instala as dependências necessárias listadas em requirements.txt. Certifica-te de que tens um ambiente Python>=3.8.0 com PyTorch>=1.8 instalado. Os modelos pré-treinados e os conjuntos de dados necessários serão transferidos automaticamente da versão mais recente do YOLOv5 versão.
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
Como funciona o congelamento de camadas#
Quando congelas camadas numa rede neural, impedes que os respetivos parâmetros (pesos e enviesamentos) sejam atualizados durante o processo de treino. No PyTorch, isto consegue-se definindo o atributo requires_grad dos tensores da camada como False. Assim, os gradientes não são calculados para estas camadas durante a retropropagação, poupando computação e memória.
Eis como o YOLOv5 implementa o congelamento de camadas no seu script de treino:
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
        v.requires_grad = False  # Disable gradient calculation for frozen layers
Explorar a arquitetura do modelo#
Compreender a estrutura do modelo YOLOv5 é essencial para decidir que camadas congelar. Podes inspecionar os nomes de todos os módulos e respetivos parâmetros com o seguinte fragmento de código Python:
# Supondo que 'model' é a instância do modelo YOLOv5 que carregaste
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""
A arquitetura YOLOv5 consiste normalmente num backbone (camadas 0-9 nas configurações padrão, como YOLOv5s/m/l/x), responsável pela extração de características, e numa cabeça (as camadas restantes), que executa a deteção de objetos.
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
    # ... subsequent head layers for feature fusion and detection
Opções de congelamento#
Podes controlar que camadas são congeladas usando o argumento --freeze no comando de treino. Este argumento especifica o índice do primeiro módulo descongelado; todos os módulos anteriores a esse índice terão os pesos congelados. Em alternativa, passar vários índices (por exemplo, --freeze 0 1 2) congela exatamente esses módulos. Usa model.model (um nn.Sequential) para inspecionar a ordem dos módulos, caso precises de confirmar que índices correspondem a um bloco específico.
Congelar apenas o backbone#
Para congelar todo o backbone (camadas 0 a 9), uma prática comum ao adaptar o modelo a novas classes de objetos e preservar as capacidades gerais de extração de características aprendidas com um conjunto de dados extenso, como o COCO:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10Esta estratégia é eficaz quando o teu conjunto de dados de destino partilha características visuais de baixo nível (contornos, texturas) com os dados de treino originais (por exemplo, COCO), mas contém categorias de objetos diferentes.
Congelar tudo, exceto as camadas finais de deteção#
Para congelar quase toda a rede, deixando treináveis apenas as camadas de convolução da saída final (parte do módulo Detect, normalmente o último módulo, por exemplo, o módulo 24 no YOLOv5s):
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24Esta abordagem é útil quando precisas sobretudo de ajustar o modelo para um número diferente de classes de saída, mantendo intacta a grande maioria das características aprendidas. Requer o mínimo de recursos computacionais para o ajuste fino.
Comparação de desempenho#
Para ilustrar os efeitos do congelamento de camadas, treinámos o YOLOv5m no conjunto de dados Pascal VOC durante 50 épocas, partindo dos pesos oficiais pré-treinados no COCO (yolov5m.pt). Comparamos três cenários: treinar todas as camadas (--freeze 0), congelar o backbone (--freeze 10) e congelar tudo, exceto as camadas finais de deteção (--freeze 24).
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10
Resultados de precisão#
Os resultados mostram que congelar camadas pode acelerar significativamente o treino, mas pode levar a uma ligeira redução da mAP (precisão média) final. Treinar todas as camadas geralmente proporciona a melhor precisão, enquanto congelar mais camadas permite treinar mais depressa, mas pode reduzir o desempenho.
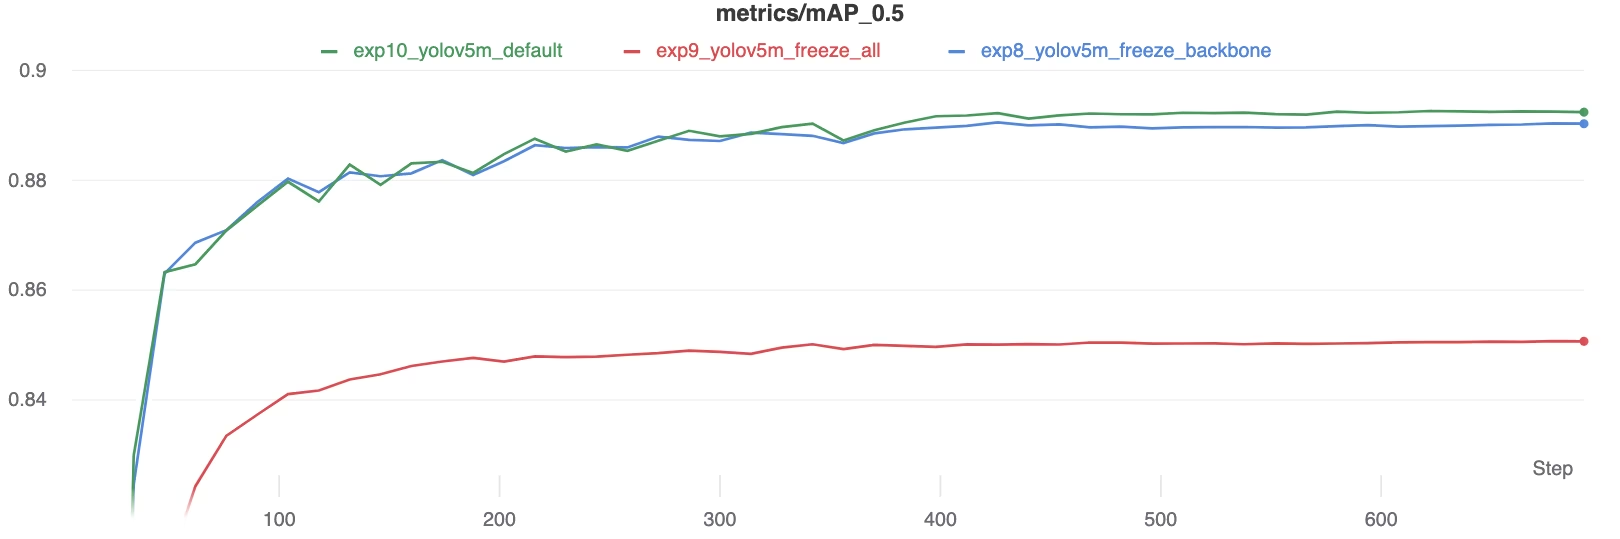 Comparação de mAP50 durante o treino
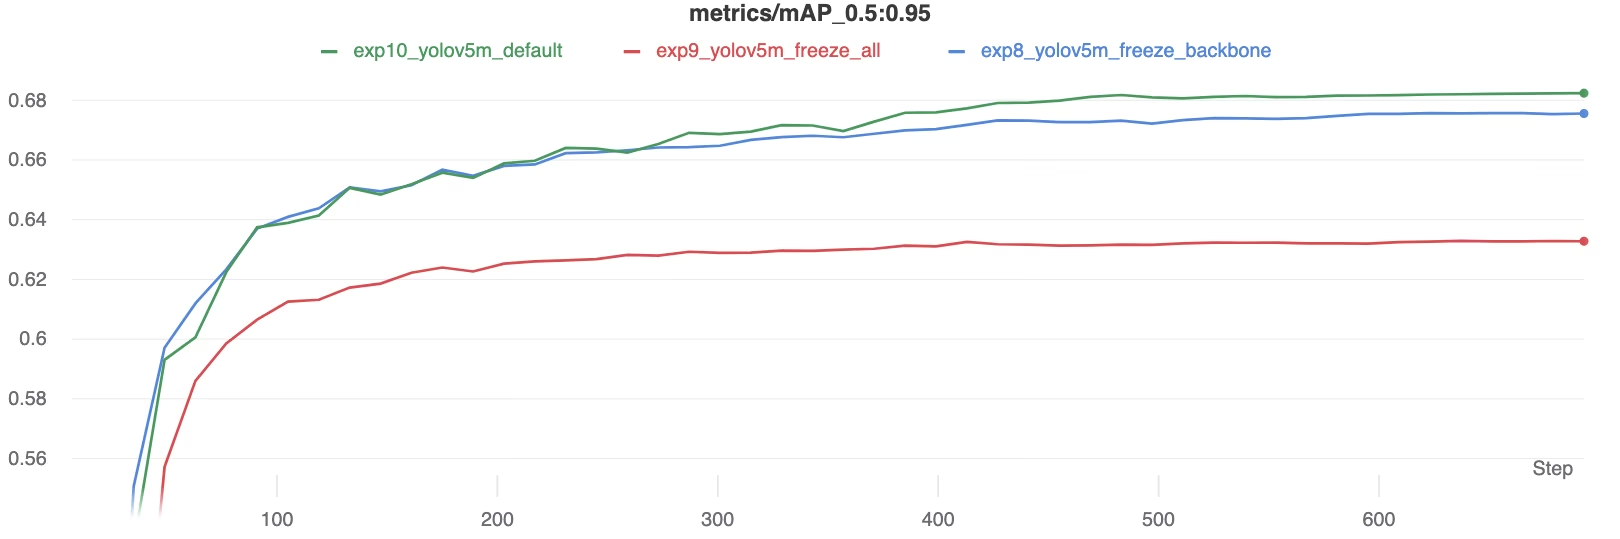 Comparação de mAP50-95 durante o treino
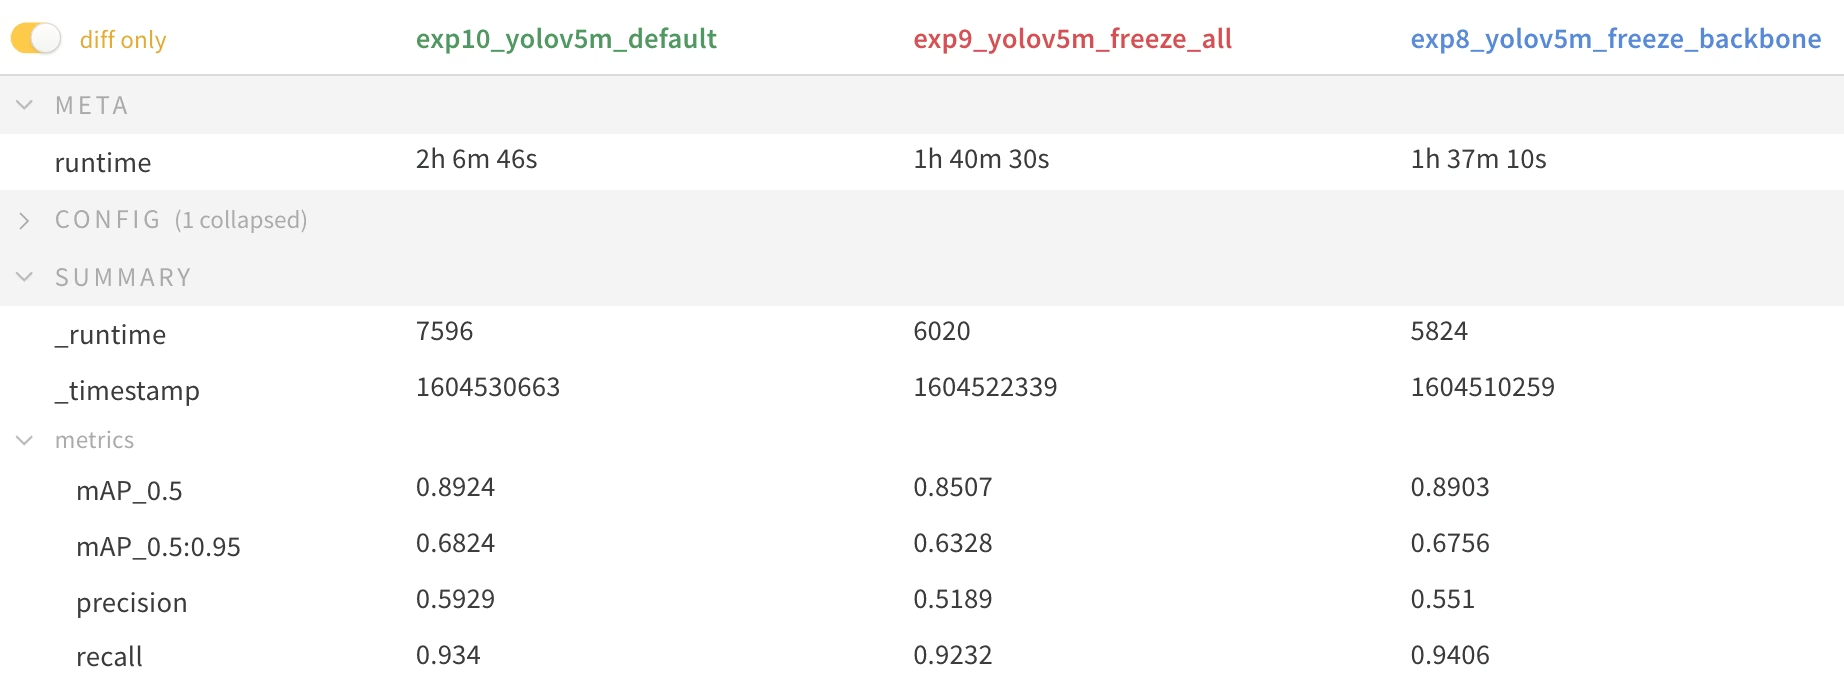 *Tabela resumida das métricas de desempenho*
Utilização de recursos#
Congelar mais camadas reduz substancialmente os requisitos de memória da GPU e a utilização geral. Isto torna a aprendizagem por transferência com camadas congeladas uma opção apelativa quando trabalhas com recursos de hardware limitados, permitindo treinar modelos maiores ou usar imagens de maior dimensão do que seria possível de outra forma.
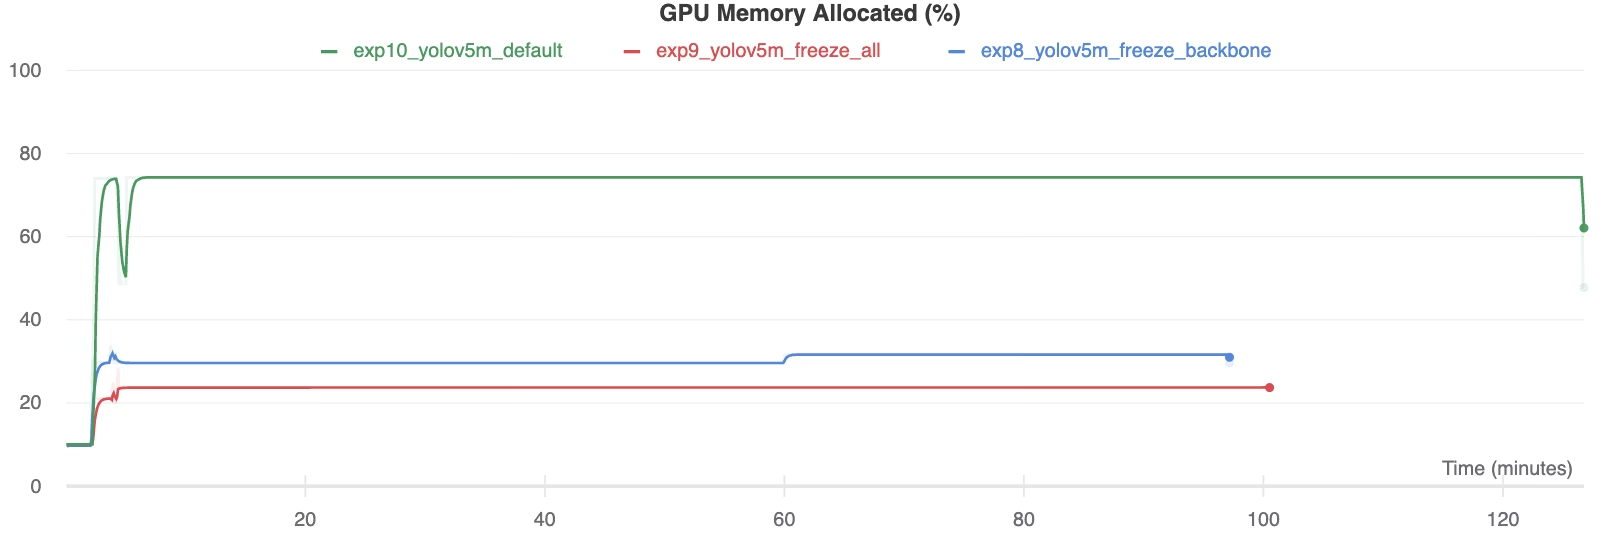 Memória da GPU alocada (%)
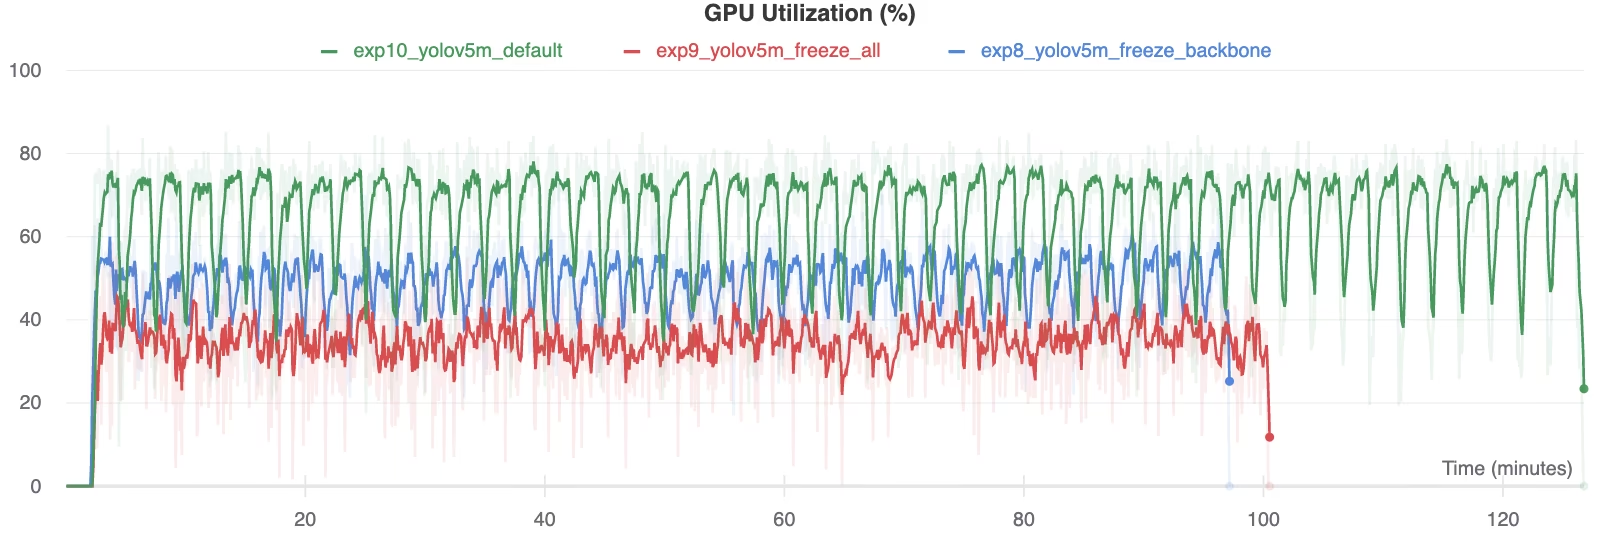 Utilização da GPU (%)
Quando usar o congelamento de camadas#
O congelamento de camadas durante a aprendizagem por transferência é especialmente vantajoso em várias situações:
- Recursos computacionais limitados: se tiveres limitações de memória da GPU ou de capacidade de processamento.
- Conjuntos de dados pequenos: quando o teu conjunto de dados de destino é significativamente menor do que o conjunto de dados original de pré-treino, o congelamento ajuda a evitar o sobreajuste.
- Prototipagem rápida: quando precisas de adaptar rapidamente um modelo existente a uma nova tarefa ou domínio para uma avaliação inicial.
- Domínios de características semelhantes: se as características de baixo nível do teu novo conjunto de dados forem muito semelhantes às do conjunto de dados usado para pré-treinar o modelo.
Explora mais sobre as particularidades da aprendizagem por transferência na nossa entrada do glossário e considera a evolução de hiperparâmetros para otimizar o desempenho.
Ambientes compatíveis#
A Ultralytics disponibiliza vários ambientes prontos a usar, com dependências essenciais como CUDA, CuDNN, Python e PyTorch pré-instaladas.
- Notebooks gratuitos com GPU:


- Google Cloud: Guia de início rápido do GCP
- Amazon: Guia de início rápido da AWS
- Azure: Guia de início rápido do AzureML
- Docker: Guia de início rápido do Docker

Estado do projeto#

Este emblema confirma que todos os testes de integração contínua (CI) das GitHub Actions do YOLOv5 estão a ser aprovados. Estes testes de CI avaliam rigorosamente a funcionalidade e o desempenho do YOLOv5 em operações essenciais: treino, validação, inferência, exportação e benchmarks. Garantem um funcionamento consistente e fiável em macOS, Windows e Ubuntu, sendo executados automaticamente a cada 24 horas e sempre que é feito um novo commit de código.
Perguntas frequentes#
Congela os primeiros
Nmódulos demodel.model, mantendo os respetivos pesos fixos e sem receber gradientes.--freeze 10congela o backbone, e--freeze 24congela tudo, exceto o móduloDetectfinal.Na experiência com VOC acima, treinar todas as camadas proporcionou a melhor mAP, congelar o backbone reduziu ligeiramente a precisão e congelar tudo, exceto a cabeça de deteção, teve o maior custo. Em contrapartida, os treinos com camadas congeladas são mais rápidos e usam muito menos memória da GPU.
Quando as tuas imagens partilham características de baixo nível com os dados de pré-treino, o teu conjunto de dados é pequeno ou precisas de uma referência inicial rápida num hardware limitado. Treina todas as camadas quando o conjunto de dados crescer ou quando precisares dos últimos pontos de mAP.
Sim. Inicia uma nova execução a partir do
best.ptdo modelo congelado, sem--freeze, para ajustar toda a rede, normalmente com uma taxa de aprendizagem mais baixa.