Dicas para obter os melhores resultados no treinamento do YOLOv5#
Este guia explica como obter o melhor mAP e os melhores resultados de treino com YOLOv5.
Na maioria dos casos, é possível obter bons resultados sem alterar os modelos ou as definições de treino, desde que o teu conjunto de dados seja suficientemente grande e esteja bem etiquetado. Se não obtiveres bons resultados à primeira, há medidas que podes tomar para os melhorar, mas recomendamos sempre que os utilizadores comecem por treinar com todas as definições predefinidas antes de ponderarem quaisquer alterações. Isto ajuda a estabelecer uma referência de desempenho e a identificar áreas a melhorar.
Se tiveres dúvidas sobre os resultados do teu treino, fornece o máximo de informação possível para obteres uma resposta útil, incluindo gráficos de resultados (perdas de treino, perdas de validação, P, R, mAP), curva PR, matriz de confusão, mosaicos de treino, resultados de teste e imagens com estatísticas do conjunto de dados, como labels.png. Todos estes ficheiros estão no teu diretório project/name, normalmente yolov5/runs/train/exp.
As secções seguintes abordam os principais fatores que afetam os resultados do treino YOLOv5.
Conjunto de dados#
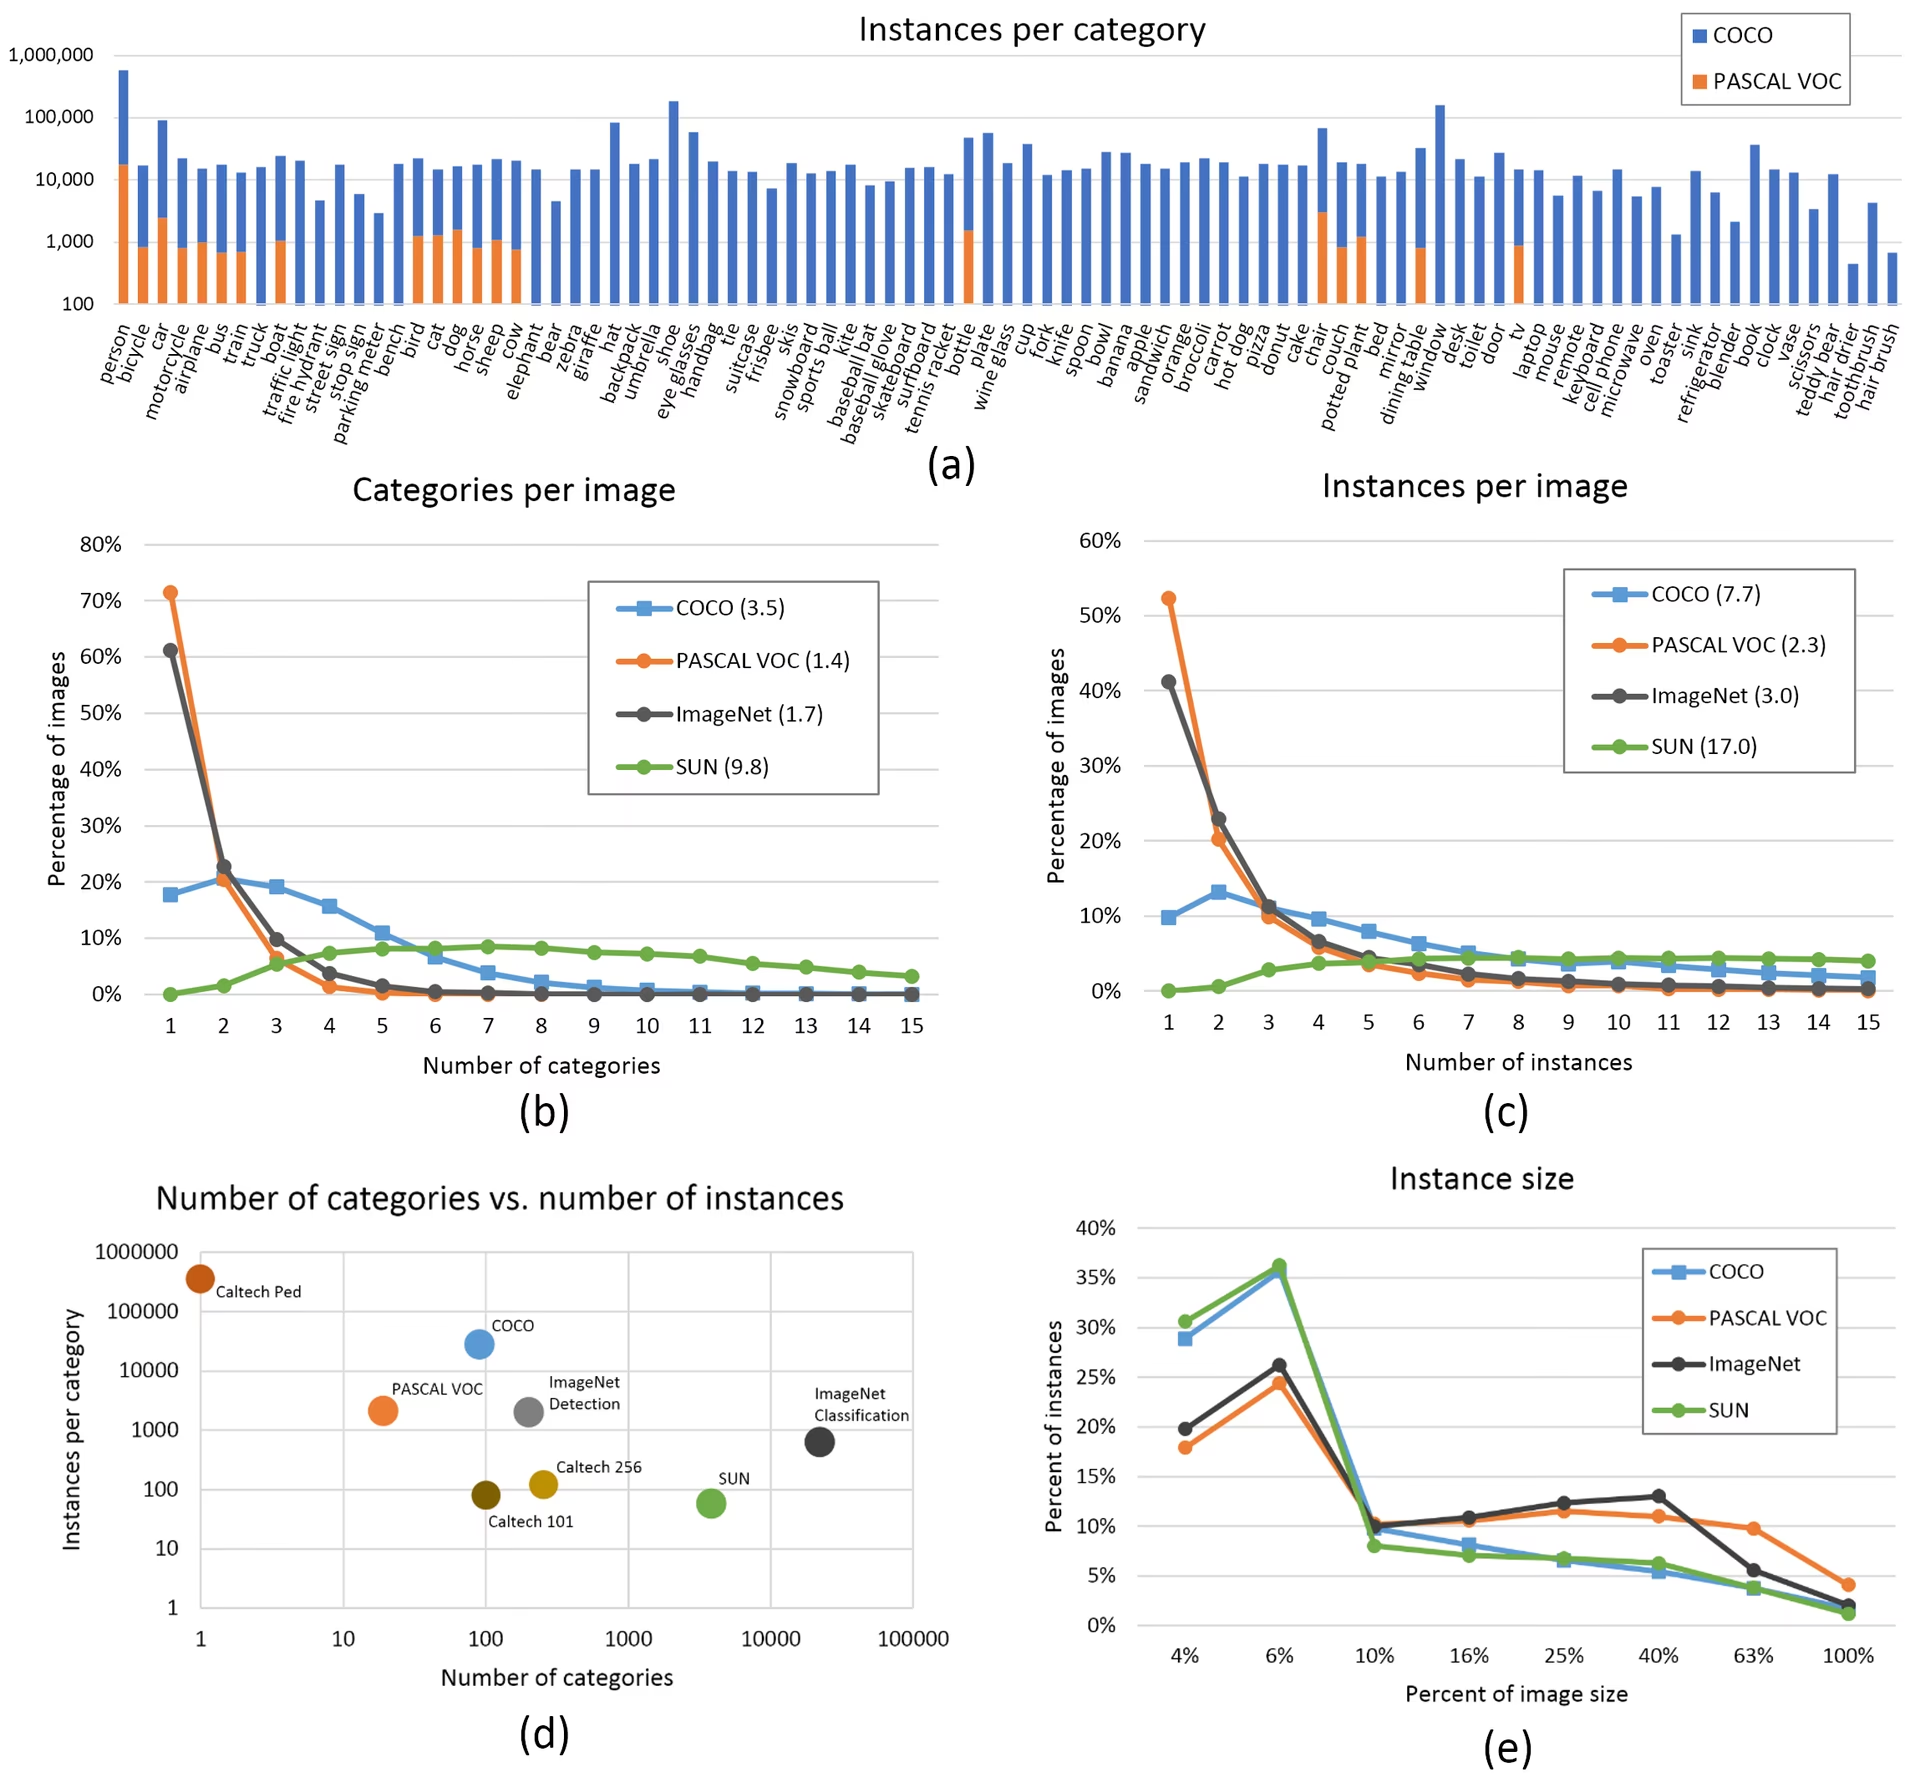
- Imagens por classe. Recomendamos ≥ 1500 imagens por classe
- Instâncias por classe. Recomendamos ≥ 10000 instâncias (objetos rotulados) por classe
- Variedade de imagens. As imagens devem ser representativas do ambiente de implantação. Para casos de uso no mundo real, recomendamos imagens de diferentes horários do dia, estações do ano, condições climáticas, condições de iluminação, ângulos e fontes (extraídas da internet, coletadas localmente, de diferentes câmeras) etc.
- Consistência dos rótulos. Todas as instâncias de todas as classes em todas as imagens devem ser rotuladas. A rotulagem parcial não funciona.
- Precisão dos rótulos. Os rótulos devem delimitar cada objeto com precisão. Não deve haver espaço entre um objeto e sua caixa delimitadora. Nenhum objeto pode ficar sem rótulo.
- Critérios para a divisão entre treinamento e validação. Garanta que as imagens de validação e teste nunca apareçam no conjunto de treinamento, para evitar métricas excessivamente otimistas. Mantenha distribuições de classes semelhantes entre as divisões.
- Verificação das etiquetas. Consulta os
train_batch*.jpgmosaicos no início do treino para verificar se as etiquetas parecem corretas. - Imagens de fundo. Imagens de fundo são imagens sem objetos que são adicionadas ao conjunto de dados para reduzir os falsos positivos (FP). Recomendamos que cerca de 0-10% das imagens sejam de fundo para ajudar a reduzir os FPs (o COCO tem 1000 imagens de fundo como referência, 1% do total). Não são necessários rótulos para as imagens de fundo.
Seleção do modelo#
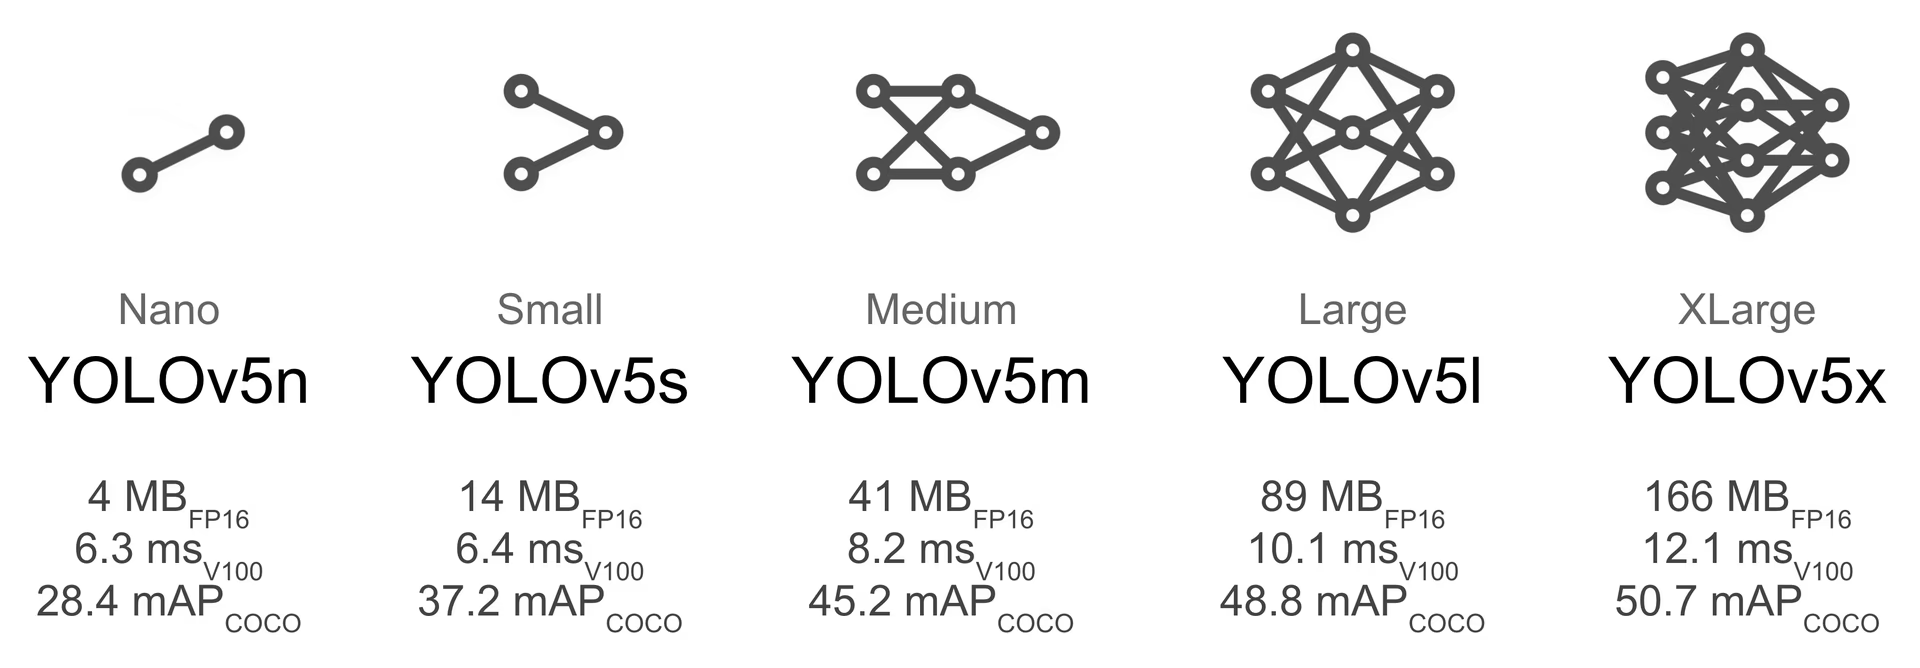
Modelos maiores, como YOLOv5x e YOLOv5x6, produzem melhores resultados em quase todos os casos, mas têm mais parâmetros, exigem mais memória CUDA para o treino e são mais lentos a executar. Para implementações móveis, recomendamos YOLOv5s/m; para implementações na nuvem, recomendamos YOLOv5l/x.
-
Começar com pesos pré-treinados. Recomendado para conjuntos de dados pequenos a médios (por exemplo, VOC, VisDrone, GlobalWheat). Indica o nome do modelo no argumento
--weights. Os modelos são transferidos automaticamente da versão mais recente do YOLOv5.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Começar do zero. Recomendado para conjuntos de dados grandes (por exemplo, COCO, Objects365, OIv6). Indica a arquitetura do modelo YAML pretendida, juntamente com um argumento
--weights ''vazio:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Configurações de treinamento#
Antes de modificar qualquer coisa, primeiro treine com as configurações padrão para estabelecer uma linha de base de desempenho. A lista completa das configurações de train.py está disponível no analisador de argumentos de train.py.
- Épocas. Começa com 300 épocas. Se ocorrer sobreajuste demasiado cedo, podes reduzir o número de épocas. Se não ocorrer sobreajuste após 300 épocas, treina durante mais tempo, por exemplo, 600 ou 1200 épocas.
- Tamanho da imagem. COCO é treinado com a resolução nativa
--img 640, embora, devido ao elevado número de objetos pequenos no conjunto de dados, possa beneficiar de treino com resoluções superiores, como--img 1280. Se houver muitos objetos pequenos, os conjuntos de dados personalizados beneficiarão de treino com resolução nativa ou superior. Os melhores resultados de inferência são obtidos com o mesmo--imgutilizado no treino; por exemplo, se treinares com--img 1280, também deves testar e detetar com--img 1280. - Tamanho do lote. Use o maior
--batch-sizeque seu hardware permitir. Lotes pequenos produzem estatísticas ruins de normalização em lote e devem ser evitados. Você pode usar--batch-size -1para selecionar automaticamente o tamanho de lote ideal para sua GPU. - Taxa de aprendizado. A programação padrão da taxa de aprendizado funciona bem na maioria dos casos. Para uma convergência mais rápida, você pode tentar usar a flag
--cos-lrpara ativar a programação da taxa de aprendizado cosseno, que reduz gradualmente a taxa de aprendizado seguindo uma curva cosseno ao longo das épocas. - Aumento de dados. O YOLOv5 inclui várias técnicas de aumento de dados, como mosaico, que combina várias imagens de treinamento. Ajuste a intensidade do aumento de dados por meio do hiperparâmetro
mosaicno arquivo--hyppara ajudar a estabilizar o treinamento. - Hiperparâmetros. Os hiperparâmetros padrão estão em hyp.scratch-low.yaml. Recomendamos que você treine primeiro com os hiperparâmetros padrão antes de pensar em modificá-los. Em geral, aumentar os hiperparâmetros de aumento de dados reduz e retarda o sobreajuste, permitindo treinamentos mais longos e um mAP final mais alto. Reduzir os hiperparâmetros de ganho dos componentes de perda, como
hyp['obj'], ajudará a reduzir o sobreajuste nesses componentes específicos da perda. Para otimizar esses hiperparâmetros automaticamente, consulte nosso Tutorial de evolução de hiperparâmetros. - Treinamento com precisão mista. O YOLOv5 ativa automaticamente a precisão mista automática (AMP) quando detecta uma GPU compatível, acelerando o treinamento e reduzindo o uso de memória sem comprometer a precisão do modelo.
- Treino com várias GPUs. Se tiveres várias GPUs, inicia o treino DistributedDataParallel com
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3, o que pode reduzir significativamente o tempo de treino. - Parada antecipada. Use
--patience 50para interromper o treinamento se as métricas de validação não melhorarem por 50 épocas, economizando tempo e evitando o sobreajuste.
Técnicas avançadas de otimização#
- Aprendizado por transferência. Para conjuntos de dados especializados, comece com pesos pré-treinados e, opcionalmente, congele camadas com
--freezepara adaptar o modelo à sua tarefa específica. - Poda do modelo. Depois do treino, considera podar o teu modelo para anular pesos redundantes com pouca perda de precisão e, em seguida, implementá-lo com um runtime compatível com esparsidade para obter ganhos de velocidade.
- Ensemble de modelos. Para aplicações críticas, treina vários modelos com configurações diferentes e combina as respetivas previsões para melhorar a precisão.
- Aumento de dados em tempo de teste. Ativa TTA durante a inferência com
--augmentpara melhorar a precisão das previsões, combinando previsões de versões invertidas e redimensionadas da imagem de entrada.
Leitura adicional#
Se quiseres saber mais, um bom ponto de partida é A Recipe for Training Neural Networks, de Karpathy, que apresenta ideias de treino aplicáveis a todos os domínios de ML.
Boa sorte e avise-nos se tiver mais alguma dúvida.
Perguntas frequentes#
Seu modelo pode estar sobreajustando se a perda de treinamento continuar diminuindo enquanto a perda de validação começar a aumentar. Monitore o mAP de validação — se ele estabilizar ou diminuir enquanto a perda de treinamento continuar melhorando, isso é um sinal de sobreajuste. As soluções incluem adicionar mais dados de treinamento, aumentar o aumento de dados ou aplicar técnicas de regularização.
O tamanho de lote ideal depende da memória da sua GPU. Em geral, lotes maiores oferecem estatísticas melhores de normalização em lote e mais estabilidade no treinamento. Use o maior tamanho de lote que seu hardware consegue processar sem ficar sem memória. Você pode usar
--batch-size -1para determinar automaticamente o tamanho de lote ideal para sua configuração.Para acelerar o treinamento, tente: usar várias GPUs com DDP, armazenar seu conjunto de dados em cache com
--cachee otimizar o tamanho do lote (a precisão mista é ativada automaticamente em GPUs compatíveis). Considere também usar uma variante menor do modelo, como YOLOv5s, se a precisão absoluta não for essencial.
Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.